B-tree & B+tree — Disk fanout, vì sao DB không dùng AVL/RB
MySQL và Postgres dùng B-tree/B+tree, không phải Red-Black. Disk seek thay đổi mọi tính toán: fanout cao giảm height, leaf chain cho range scan.
TL;DR: B-tree và B+tree giải quyết một vấn đề mà RB tree không làm được: tìm kiếm trên disk. Mỗi node B+tree chứa hàng trăm key (fanout cao), nên height giảm từ tối đa 60 (RB tree) xuống 3–4 cho 1 tỷ record, tức thời gian disk seek trên HDD giảm từ cỡ 600ms xuống cỡ 40ms. B+tree khác B-tree ở chỗ toàn bộ dữ liệu nằm ở leaf node và các leaf được nối thành linked list, nên range query chỉ cần quét tuần tự thay vì phải quay ngược lên cây. MySQL InnoDB dùng clustered B+tree: leaf của primary key chứa luôn dữ liệu của dòng (row); leaf của secondary index chỉ chứa primary key, nên phải tra hai lần (double lookup).
Red-Black tree ở bài 06 có height tối đa 2 * log₂(n): với 1 tỷ record là 60 bước so sánh, hoàn toàn ổn trong RAM. Nhưng MySQL InnoDB và Postgres không dùng RB tree cho index, vì disk seek (đầu đọc phải di chuyển tới đúng vị trí trên đĩa). Một lần đọc từ HDD mất cỡ 10ms. Nếu mỗi node của RB tree nằm trên một disk page riêng thì 60 node là 60 disk seek, tức cỡ 600ms chỉ để đọc một record. Với 1000 query/giây, database quá tải ngay.
Cách giải: thay vì cây cao với node nhỏ, dùng cây thấp với node rất lớn, mỗi node chứa hàng trăm key và height chỉ còn 3–4. Đó là B-tree (Bayer và McCreight, báo cáo nội bộ ở Boeing năm 1970, công bố trên Acta Informatica năm 1972) và biến thể phổ biến hơn của nó là B+tree.
Bài này giải thích fanout, leaf chain, cơ chế search/insert, và vì sao InnoDB chọn B+tree.
1. Hình dung: Tủ tài liệu nhiều ngăn
Hình dung bạn cần tìm hồ sơ nhân viên trong một kho lưu trữ thật. Có hai kiểu tủ:
Kiểu RB tree: mỗi ngăn tủ chỉ chứa đúng 2 ngăn con. Để tìm một hồ sơ, bạn mở ngăn này, đóng lại, bước sang ngăn khác, cứ thế tới 60 lần, mỗi lần đều tốn thời gian đi lại.
Kiểu B-tree: mỗi ngăn tủ chứa 100 folder mục lục. Mở một ngăn, đọc lướt 100 nhãn (không cần đi lại), chọn đúng folder rồi đi thẳng tới ngăn tiếp theo. Chỉ mất 3–4 lần mở tủ thay vì 60.
| Tủ tài liệu | B-tree / RB tree |
|---|---|
| Mở/đóng ngăn tủ | Disk seek (đắt) |
| Đọc nhãn trong ngăn | So sánh key trong RAM (rẻ) |
| Tủ RB: mỗi ngăn 2 folder | RB tree: mỗi node 2 children |
| Tủ B: mỗi ngăn 100 folder | B-tree: mỗi node 100–500 children |
| Ít lần mở tủ hơn | Ít disk seek hơn |
| Đọc lướt nhiều nhãn cùng lúc | Các key trong node vừa một disk page, đọc một lần |
B-tree sinh ra cho disk: giảm số lần I/O (số node phải đọc) bằng cách nhét thật nhiều key vào một node. So sánh key trong RAM sau khi nạp một node là rẻ, disk seek mới là nút cổ chai.
2. Disk vs RAM, con số thực
Trước khi vào cấu trúc B-tree, hãy xem vì sao disk seek đắt đến vậy:
Độ trễ thực tế (xấp xỉ):
  L1 cache:   1 ns
  L2 cache:   4 ns
  RAM:      100 ns
  SSD:  100.000 ns  (0.1 ms)
  HDD: 10.000.000 ns  (10 ms)

So sánh:
  1 HDD seek = 100.000 lần truy cập RAM
  1 HDD seek = 10.000.000 lần truy cập L1 cache
  1 SSD seek = 1.000 lần truy cập RAM
Hệ quả trực tiếp: truy cập 60 node riêng lẻ trên HDD mất cỡ 600ms, dù mỗi node nhỏ đến đâu. Đọc node lớn chứa 500 key thì chỉ cần 3–4 seek, tổng 30–40ms: chênh lệch cỡ 15 lần chỉ nhờ đổi cấu trúc dữ liệu. Đây là tính trong trường hợp không node nào nằm sẵn trong RAM; thực tế database giữ các tầng trên của cây trong bộ nhớ đệm (buffer pool), nên số lần đọc đĩa thật còn ít hơn nữa.
Ý nghĩa cho thiết kế: khi dữ liệu nằm trên disk, mục tiêu là giảm số node phải đọc (số disk seek), không phải giảm số phép so sánh. So sánh 500 key trong RAM sau một lần đọc disk rẻ hơn nhiều so với thêm một lần disk seek.
Cùng tinh thần "hằng số rất quan trọng khi chạm phần cứng thật" còn xuất hiện ở bài Memory và cache locality của khoá Thuật toán Căn bản, đáng đọc để thấy cache CPU cũng chi phối thiết kế giống như disk.
3. B-tree, định nghĩa và fanout
B-tree bậc m (order m) là cây cân bằng nhiều nhánh (multi-way balanced tree) với các đặc điểm sau:
- Mỗi node (trừ root) có ít nhất
⌈m/2⌉children (tức ít nhất⌈m/2⌉ - 1key) và tối đamchildren (tức tối đam - 1key). - Một node với
kkey có đúngk + 1children. - Mọi leaf node nằm cùng độ sâu (cây cân bằng về chiều cao).
- Key trong mỗi node được sắp xếp tăng dần.
Fanout là số children mà mỗi node có thể có, và đây là con số quan trọng nhất. Với order m = 500 (fanout 500), height của B-tree chứa 1 tỷ record là:
n = 1.000.000.000

height = log_500(n) = log(10^9) / log(500) = 9 / 2,699 ≈ 3,33

=> Height 4 đủ cho 500^4 = 62,5 tỷ record.

Số disk seek mỗi query: 4
Tổng thời gian (HDD): 4 × 10ms = 40ms
Tổng thời gian (SSD): 4 × 0,1ms = 0,4ms
So với RB tree trên disk: 60 seek × 10ms = 600ms. B-tree với fanout 500: 4 seek × 10ms = 40ms, nhanh hơn 15 lần.
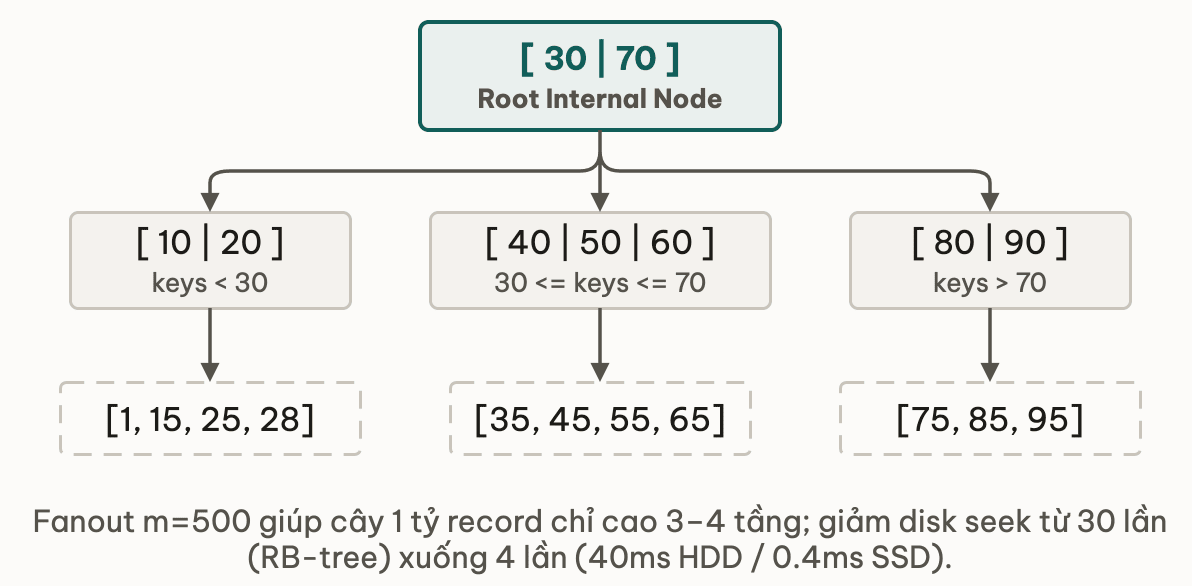
Trong node [30 | 70], key 30 và 70 chia thành 3 vùng: child trái chứa key nhỏ hơn 30, child giữa chứa key từ 30 đến 70, child phải chứa key lớn hơn 70. Đây là BST property mở rộng cho nhiều nhánh.
Thử ngẫmvới order m=500 và 1 tỷ record, height chỉ cần 4. Nếu order giảm còn 10, height phải tăng lên bao nhiêu để vẫn chứa được ngần ấy record?
4. B-tree vs B+tree, khác biệt quan trọng
B+tree là biến thể được database dùng phổ biến hơn. Khác biệt cốt lõi:
| Khía cạnh | B-tree | B+tree |
|---|---|---|
| Vị trí lưu data | Cả internal node và leaf | Chỉ leaf node |
| Internal node chứa | Keys + values + children pointer | Keys + children pointer (không có value) |
| Leaf node chain | Không có | Có — doubly linked list nối các leaf |
| Range scan | Phải quay ngược lên cây | Quét tuần tự trên leaf chain, O(k) |
| Point query | O(log_m n) | O(log_m n) — như nhau |
| Fanout của internal node | Thấp hơn (phải chứa value) | Cao hơn (chỉ có key + pointer) |
| Ứng dụng | Ít gặp ở database (ví dụ BTreeMap của Rust) | MySQL InnoDB, MongoDB WiredTiger, NTFS; Postgres dùng biến thể gần B+tree |
Vì sao fanout của B+tree cao hơn? Internal node của B+tree chỉ chứa key và pointer, không chứa value (dữ liệu của dòng). Một node thường vừa một disk page (InnoDB mặc định 16KB, PostgreSQL 8KB). Không phải chứa value thì internal node nhét được nhiều key hơn, fanout lớn hơn, cây thấp hơn, ít disk seek hơn.
Cứ hình dung một disk page 16KB là một tờ giấy khổ cố định. Nếu mỗi dòng mục lục chỉ gồm key và pointer (khoảng 16 byte), tờ giấy ghi được cỡ một nghìn dòng. Nếu mỗi dòng phải kèm cả dữ liệu 100 byte thì chỉ ghi được hơn một trăm dòng. Công thức dưới đây chỉ là phép chia 16384 cho kích thước một dòng.
B-tree internal node (page 16KB, key 8 byte, value 100 byte, pointer 8 byte):
  (8 + 100 + 8) * m + 8 <= 16384
  => m <= 141  (fanout khoảng 141)

B+tree internal node (page 16KB, key 8 byte, pointer 8 byte):
  (8 + 8) * m + 8 <= 16384
  => m <= 1023  (fanout khoảng 1023)

So sánh height (10^9 record):
  B-tree:  log_141(10^9) ≈ 4,19  => 5 tầng
  B+tree:  log_1023(10^9) ≈ 3,0  => 3 tầng key, cộng tầng leaf chứa dòng
5. B+tree mechanics, cách hoạt động
5.1 Cấu trúc internal node và leaf node
B+tree internal node:
  [ ptr0 | key1 | ptr1 | key2 | ptr2 | ... | key_m | ptr_m ]
  -- key1..key_m: navigation key (chỉ để tìm đường, không phải data thật)
  -- ptr0..ptr_m: pointer đến node con

B+tree leaf node:
  [ key1 | val1 | key2 | val2 | ... | key_k | val_k | next_leaf_ptr ]
  -- key1..key_k: actual key
  -- val1..val_k: actual value (row data hoặc row pointer)
  -- next_leaf_ptr: pointer đến leaf kế tiếp (leaf chain)
Toàn bộ dữ liệu nằm ở leaf. Internal node chỉ là "bản đồ" để dẫn xuống đúng leaf.
5.2 Point query: tìm id = 350
Point query — tìm id = 350:

Bước 1: đọc root [100 | 300 | 600]
        350 > 300 và 350 < 600 → đi xuống child[2]

Bước 2: đọc internal node [300|350|400|500]
        350 >= 300 → tìm thấy 350 → lấy leaf pointer

Bước 3: đọc leaf node
        tìm thấy (350, row_data)

Tổng: 3 disk read
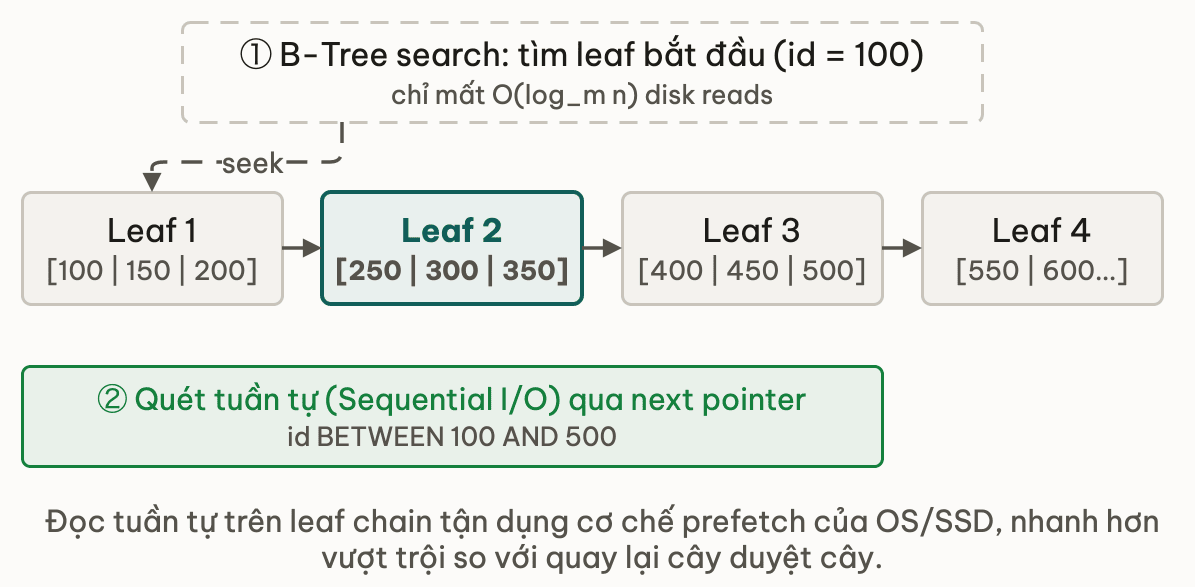
5.3 Range query: tìm id từ 100 đến 500
Đây là lúc leaf chain phát huy tác dụng:
Range query — tìm id BETWEEN 100 AND 500:

Bước 1: đi xuống tree → tìm leaf chứa id=100  (3 disk read)
Bước 2: đọc row data id=100
Bước 3: theo next_leaf_ptr → leaf kế tiếp  (1 disk read, tuần tự)
Bước 4: đọc các row 150, 200, 250...
Bước 5: theo next_leaf_ptr → leaf kế tiếp  (1 disk read, tuần tự)
Bước 6: tiếp tục cho đến khi id vượt 500. Dừng.
Đọc tuần tự trên leaf chain là cách nhanh nhất có thể về I/O: hệ điều hành và disk có thể đọc trước (prefetch) các page liền nhau. Ngược lại B-tree không có leaf chain, range query phải quay ngược lên internal node rồi đi xuống nhánh khác, tốn nhiều disk seek ngẫu nhiên hơn.
HDD: đầu đọc phải di chuyển vật lý đến track cần đọc. Đọc tuần tự là đọc liên tiếp các sector kề nhau, không cần dời đầu đọc, throughput gần bằng tốc độ quay tối đa của đĩa. Đọc ngẫu nhiên thì mỗi lần đọc lại phải seek mới.
SSD: không có đầu đọc cơ học, nhưng đọc tuần tự vẫn thường nhanh hơn nhờ prefetch và read-ahead. Chênh lệch ít hơn HDD nhiều.
6. Insert vào B+tree, intuition
6.1 Case đơn giản: leaf còn slot
Leaf hiện tại: [100 | 200 | 300 | _]   (mỗi leaf chứa tối đa 4 key, còn 1 slot trống)
Insert 250:
Kết quả:       [100 | 200 | 250 | 300]  (insert có thứ tự, xong)
Time: O(log_m n) Space: O(1)
6.2 Case leaf đầy: split
Leaf hiện tại: [100 | 200 | 300 | 400]  (đầy: đã đủ 4 key)
Insert 350:
  Bước 1: tách leaf thành hai:
     trái:  [100 | 200 | 300]
     phải:  [350 | 400]
  Bước 2: đẩy một bản sao của key 300 LÊN parent làm separator key
  Bước 3: cập nhật leaf chain: trái.next -> phải

Trước split:
  parent: [... | 500 | ...]
  leaf:   [100|200|300|400]

Sau split:
  parent: [... | 300 | 500 | ...]   <- 300 được chèn làm separator
           /          |          \
  leaf: [100|200|300]  [350|400]  [500+...]
6.3 Recursive split lên parent
Nếu parent cũng đầy sau khi nhận key mới từ split, parent split tương tự: chia đôi, đẩy median lên grandparent. Cây lớn lên từ root: root chỉ split khi đầy, tạo ra một root mới và height tăng thêm 1.
Bước 0 - root đầy:
  Root: [10 | 30 | 50 | 70]  (đầy)

Bước 1 - insert 40, leaf split, đẩy 40 lên root:
  Root sẽ thành: [10 | 30 | 40 | 50 | 70]  (tràn!)

Bước 2 - root split:
  Root mới:  [40]
             /  \
           [10|30]  [50|70]
Time: O(log_m n) amortized Space: O(m) cho split
Tần suất split: trung bình cứ khoảng m/2 lần insert thì có một lần split (m là order). Với m = 500, khoảng 250 insert mới có 1 split, chi phí phụ nhỏ.
Thử ngẫmtrung bình cứ 250 insert mới có 1 lần split node. Nếu ứng dụng insert theo từng đợt (10.000 record dồn trong 1 giây rồi im lặng), số lần split có còn rải đều theo thời gian không?
7. Các bẫy thường gặp
Bẫy 1: Nhầm B-tree với binary tree
Tên "B-tree" không phải viết tắt của "Binary tree". B-tree là cây nhiều nhánh (mỗi node có tới hàng trăm children). Chữ "B" có thể là "Balanced", "Bayer" (tên tác giả) hoặc "Boeing"; ngay cả Bayer và McCreight cũng không giải thích rõ. Nhưng chắc chắn không phải "Binary".
Binary tree:  mỗi node tối đa 2 children  -> height O(log_2 n) ≈ 30 cho 10^9
B-tree:       mỗi node tối đa m children  -> height O(log_m n) ≈ 4  cho 10^9

Không liên quan nhau ngoài việc đều là tree.
Bẫy 2: Index column có cardinality thấp
Index trên cột chỉ có vài giá trị (ví dụ status có 3 giá trị, mỗi giá trị khớp 3 triệu dòng) thường vô dụng: lookup xong vẫn phải lấy hàng triệu dòng bằng I/O ngẫu nhiên, trong khi quét tuần tự cả bảng còn nhanh hơn. Planner sẽ tự chọn quét bảng, nhưng index vẫn làm mỗi INSERT/UPDATE chậm thêm. Chi tiết ở section 8.
Bẫy 3: Composite index column order sai
Index (country, city) và (city, country) là hai index khác nhau hoàn toàn:
Index: (country, city)
B+tree sắp xếp theo: concat(country, city)
  "UK_Cambridge", "UK_London", "US_Boston", "US_Cambridge", "VN_Hanoi" ...

DÙNG được index (country, city):
  tìm WHERE country = 'VN'                         -- prefix match -> OK
  tìm WHERE country = 'VN' AND city = 'Hanoi'      -- OK

KHÔNG dùng được index (country, city):
  tìm WHERE city = 'Cambridge'    -- bỏ qua leftmost column -> thường full scan
Hình dung: leaf chain của B+tree được sắp theo (country, city) nối liền nhau. Query WHERE city = 'Cambridge' phải tìm Cambridge rải rác khắp nơi trong chain (một ở UK, một ở US), không range scan được nên thường đành full scan. Một số phiên bản mới (MySQL 8.0.13 trở lên, PostgreSQL 18) có "skip scan" xử lý được vài trường hợp, nhưng đừng dựa vào đó khi thiết kế index.
8. Cardinality và selectivity
Cardinality là số giá trị khác nhau của một column (user_id rất cao, status chỉ 3–5, country_code cỡ 100–200). Selectivity là tỉ lệ số dòng khớp trên tổng số dòng của một điều kiện lọc: user_id = 123 trên 10 triệu dòng là 0,0000001, rất chọn lọc nên index cực hợp; status = 'pending' khớp 4 triệu dòng là 0,4, quá nhiều để index có lợi.
Query trả về dưới vài phần trăm số dòng thì index thường có lợi; trả về nhiều hơn (cỡ 5–10% trở lên, tuỳ phần cứng và cách lưu dòng) thì planner thường chọn quét toàn bảng vì đọc ngẫu nhiên từng dòng qua index chậm hơn. Ngưỡng này không cố định, hãy dùng EXPLAIN ANALYZE để xem planner chọn gì.
Thử ngẫmvới cột boolean is_deleted chỉ 2% dòng là true, truy vấn WHERE is_deleted = true nằm ở phía nào của ngưỡng đó?
9. Ứng dụng trong các hệ thống thực tế
MySQL InnoDB, clustered B+tree theo primary key: dữ liệu của dòng được lưu thẳng trong leaf node của primary key index. Đây gọi là "clustered index": bản thân bảng chính là cây B+tree. Secondary index (index trên các column khác) có leaf chứa giá trị primary key chứ không chứa dữ liệu dòng. Kết quả: tra bằng secondary index phải đi 2 lần qua cây B+tree (một lần để tìm primary key, một lần để lấy dữ liệu dòng), gọi là "double lookup" hay "bookmark lookup".
InnoDB secondary index lookup trên cột email (chưa tính bộ nhớ đệm):
  Bước 1: duyệt B+tree của idx_email -> tìm primary key (user_id = 12345)
  Bước 2: duyệt B+tree của PRIMARY -> tìm row data tại leaf
  = 2 lần disk seek so với primary key lookup
PostgreSQL B-tree: PostgreSQL dùng B-tree nhưng heap (nơi lưu dòng) và index tách biệt nhau. Leaf của index chứa (key, ctid), trong đó ctid là vị trí vật lý của tuple trong heap file. Mặc định không clustered. Có thể dùng lệnh CLUSTER để sắp xếp lại heap theo index một lần, nhưng thứ tự đó không tự được giữ về sau.
MongoDB WiredTiger: storage engine mặc định, lưu collection và index bằng cây kiểu B-tree. Khác InnoDB, secondary index trỏ về RecordId nội bộ của dòng chứ không phải primary key (trừ clustered collection ở bản mới).
Filesystem: NTFS dùng B+tree cho index thư mục, và HFS+ dùng một biến thể của B+tree cho catalog file.
LSM tree, lựa chọn cho workload ghi nhiều: Cassandra, RocksDB, LevelDB dùng LSM tree (Log-Structured Merge tree) thay vì B+tree. LSM tree tối ưu cho ghi tuần tự (write-ahead log + memtable + SSTable) và đánh đổi bằng tốc độ đọc. B+tree tốt hơn cho OLTP đọc ghi lẫn lộn. Khoá SQL & Database, bài LSM-tree & SSTable đi sâu vào memtable/SSTable/compaction (size-tiered vs leveled) và ba loại amplification.
10. Học tiếp ở khoá SQL
Muốn thấy B+tree giúp tối ưu query thật ra sao: Tại sao cần index, B-tree internals (page split, fill factor, UUID v4 làm tăng write amplification) và Composite index ordering (quy tắc leftmost prefix).
11. Đào sâu
Paper gốc:
- Bayer & McCreight, "Organization and Maintenance of Large Ordered Indexes", Acta Informatica, 1972 (bản báo cáo đầu tiên ở Boeing là năm 1970). Bài báo định nghĩa B-tree gốc, chứng minh giới hạn height và phân tích chi phí split/merge.
Sách kinh điển:
- Introduction to Algorithms (CLRS), 4th Edition, Chapter 18: B-Trees. Có chứng minh chặt chẽ, pseudocode insert/delete/search và phân tích độ phức tạp.
- Designing Data-Intensive Applications (DDIA), Martin Kleppmann, Chapter 3: Storage and Retrieval. Phân tích thực tế về đánh đổi giữa B+tree và LSM tree, trong bối cảnh database production.
Database internals:
- MySQL InnoDB documentation, "InnoDB On-Disk Structures: Clustered and Secondary Indexes". Giải thích clustered index và secondary index trong InnoDB.
- PostgreSQL B-tree implementation:
src/backend/access/nbtree/trong PostgreSQL source.nbtinsert.clo insert/split,nbtsearch.clo search.
Bài liên quan trong khoá học:
- Cây tự cân bằng: nền tảng cây trong bộ nhớ RAM.
- Case Study MySQL & Redis: B+Tree trong InnoDB.
- B-Tree vs LSM-Tree: nguyên lý lưu trữ và index database.
12. Tóm tắt
Checklist khi gặp chuyện index trong thực tế:
- Cây nằm trên disk thì hãy đếm số page phải đọc, đừng đếm số phép so sánh.
- Query lọc theo khoảng (
BETWEEN,ORDER BY ... LIMIT) hợp B+tree nhờ leaf chain. - Với InnoDB, secondary index phải đi hai lần (index rồi primary key); covering index tránh được lượt thứ hai.
- Index cột có ít giá trị khác nhau (cardinality thấp) thường vô dụng mà còn tốn chi phí ghi.
- Composite index
(country, city)chỉ giúp query cócountryở đầu. Workload ghi nhiều thì cân nhắc LSM tree (Cassandra, RocksDB).
13. Tự kiểm tra
- Q1Vì sao database không dùng Red-Black tree cho index dù RB tree có height O(log n) và search rất nhanh trong RAM?
- Q2B+tree fanout 100, 1 tỷ record thì cây cần height bao nhiêu? Tính chi tiết.
- Q3Leaf chain của B+tree giúp range query thế nào so với B-tree không có leaf chain?
- Q4MySQL InnoDB clustered index: vì sao tra bằng secondary index tốn gấp đôi so với tra bằng primary key?
- Q5Composite index (country, city): vì sao query WHERE city = 'Cambridge' thường không dùng được index này?
- Q6Vì sao index column có cardinality thấp lại tệ? Cho ví dụ cụ thể.
Bài tiếp theo: Trie, autocomplete, IP lookup, dictionary
Self-balancing tree — AVL vs Red-Black và lý do TreeMap chọn RB
Bài tiếpTrie — Autocomplete, IP routing, và prefix-friendly dictionary
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này