BST — Insert, search, delete và tại sao skewed BST là O(n)
Insert sorted sequence vào BST biến cây thành linked list, operation rớt O(n). Insert/search/delete BST với pseudocode đầy đủ và lý do cần balanced BST.
TL;DR: BST (Binary Search Tree) đảm bảo: left subtree chứa mọi giá trị nhỏ hơn node hiện tại, right subtree chứa mọi giá trị lớn hơn, và quy tắc này đúng đệ quy ở mọi node. Hệ quả: in-order traversal cho ra dãy đã sắp xếp; search/insert/delete đều tốn O(chiều cao cây). Vấn đề cốt lõi: với input đã sắp xếp (timestamp tăng, auto-increment ID), cây "ngả hẳn một phía", height = n và mọi thao tác thoái hoá về O(n). Input ngẫu nhiên cho height kỳ vọng O(log n), nhưng dữ liệu production hiếm khi ngẫu nhiên. Cách xử lý: dùng self-balancing BST (cây tự cân bằng, xem bài 06 về AVL và Red-Black tree).
Tutorial BST dạy "search O(log n)", và benchmark nhỏ với 1000 phần tử random xác nhận đúng vậy. Dev ship lên production. Tuần sau, team nạp dữ liệu theo thứ tự timestamp tăng dần, tức insert 1, 2, 3, ..., N vào BST. Cây bỗng "ngả phải" hoàn toàn: mỗi node chỉ có right child. Search trên 500.000 phần tử từ khoảng 19 bước rơi xuống 500.000 bước. Hệ thống chậm dần, không exception, không warning, chỉ có latency tăng.
Bài này dạy insert/search/delete trên BST (kể cả delete bằng in-order successor, case khó nhất), rồi giải thích vì sao input đã sắp xếp phá hỏng BST.
1. Hình dung: Cây phả hệ chia trái/phải
Hình dung một cây phả hệ đặc biệt: mỗi người trong cây có tối đa hai người con: con bên trái luôn có tên đứng trước (theo thứ tự alphabet), con bên phải luôn có tên đứng sau. Tổ tiên ở gốc. Muốn tìm một người, bạn bắt đầu từ gốc, so tên cần tìm với người hiện tại, rẽ trái nếu nhỏ hơn, rẽ phải nếu lớn hơn, và lặp lại cho đến khi gặp.
Nếu cây "cân đối", mỗi bước bỏ đi một nửa số nhánh còn lại, bạn tìm ra người cần tìm trong O(log n) bước. Còn nếu cây "ngả hẳn sang phải" (toàn là right child), tìm người cuối cùng phải đi qua tất cả, y như duyệt linked list O(n).
| Cây phả hệ | BST |
|---|---|
| Tổ tiên ở gốc | Root node |
| Con trái có tên nhỏ hơn | Left subtree: tất cả giá trị nhỏ hơn node hiện tại |
| Con phải có tên lớn hơn | Right subtree: tất cả giá trị lớn hơn node hiện tại |
| Rẽ trái/phải để thu hẹp tìm kiếm | So sánh rồi chọn nhánh → O(log n) trung bình |
| Cây ngả toàn một phía | Skewed BST → mọi thao tác O(n) |
| Đọc tên theo thứ tự in-order | In-order traversal → dãy đã sắp xếp |
BST = cây phả hệ có thứ tự: trái nhỏ hơn, phải lớn hơn. In-order traversal = đọc theo thứ tự tăng dần. Skewed = cây biến thành một danh sách.
2. BST property và cấu trúc node
Định nghĩa BST property: với mỗi node n, mọi node trong left subtree có giá trị nhỏ hơn n.value, và mọi node trong right subtree có giá trị lớn hơn n.value. Quy tắc này đúng đệ quy cho mọi node trong cây, không chỉ node gốc và các con trực tiếp.
Hệ quả quan trọng: in-order traversal (left → root → right) của một BST hợp lệ luôn cho ra dãy tăng dần. Đây là cách dễ nhất để kiểm tra một BST có đúng không: in-order phải tăng dần.
-- BST node: lưu giá trị + con trái + con phải
BST node:
    value
    left  <- BST node hoặc null
    right <- BST node hoặc null
Ví dụ BST hợp lệ sau khi insert sequence 5, 3, 8, 1, 4, 7, 9:
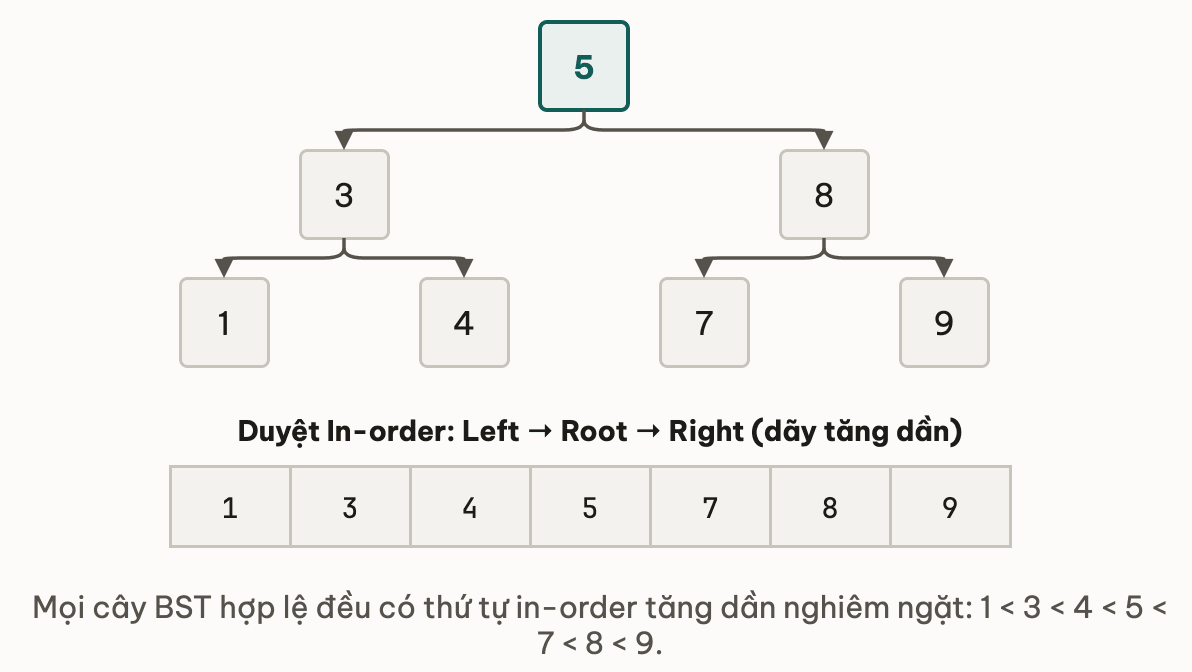
In-order traversal: 1, 3, 4, 5, 7, 8, 9, đúng là dãy tăng dần.
3. Insert (đệ quy)
Insert đi từ root xuống leaf, dựa vào BST property để chọn nhánh trái hay phải, cho đến khi gặp null: đó là chỗ đặt node mới. Hàm bên dưới tự gọi lại chính nó cho cây con; nếu kiểu viết này còn lạ, ôn lại ở Hàm trước khi đọc tiếp.
-- Insert value vào BST có root là 'root'.
-- Trả về root mới (cần khi cây rỗng).
-- Duplicate: bỏ qua (có thể đổi thành đếm hoặc ghi đè theo use case).
insert(root, value):
    if root = null: return new BST node với value    -- tìm thấy vị trí insert

    if value < root.value:
        root.left  <- insert(root.left, value)    -- đi trái
    else if value > root.value:
        root.right <- insert(root.right, value)   -- đi phải
    -- value = root.value: duplicate -- bỏ qua; convention tuỳ use case
    return root
Time: O(chiều cao cây) Space: O(chiều cao cây) -- do call stack đệ quy
Trace insert sequence 5, 3, 8, 1, 4, 7, 9 từng bước:
Insert 5: root = null -> Node(5)
        5

Insert 3: 3 < 5 -> đi trái, left=null -> Node(3)
        5
       /
      3

Insert 8: 8 > 5 -> đi phải, right=null -> Node(8)
        5
       / \
      3   8

Insert 1: 1 < 5 -> trái; 1 < 3 -> trái -> Node(1)
Insert 4: 4 < 5 -> trái; 4 > 3 -> phải -> Node(4)
Insert 7: 7 > 5 -> phải; 7 < 8 -> trái -> Node(7)
Insert 9: 9 > 5 -> phải; 9 > 8 -> phải -> Node(9)

        5
       / \
      3   8
     / \ / \
    1  4 7  9
Insert đệ quy có độ sâu bằng chiều cao cây. Với skewed BST 1 triệu node, độ sâu là 1 triệu, tràn stack. Bản iterative (dùng vòng lặp) tránh được chuyện này; vì sao mỗi lần gọi ăn một khung stack, xem Recursion và call stack.
-- Iterative insert -- không đệ quy, an toàn trên deep tree
insertIterative(root, value):
    newNode <- BST node với value
    if root = null: return newNode

    current <- root
    while true:
        if value < current.value:
            if current.left = null:
                current.left <- newNode
                break
            current <- current.left
        else if value > current.value:
            if current.right = null:
                current.right <- newNode
                break
            current <- current.right
        else:
            break   -- duplicate: bỏ qua
    return root
Time: O(chiều cao cây) Space: O(1)
4. Search
Search dùng BST property để đi thẳng xuống đúng nhánh, không cần duyệt cả cây. Đây là bản iterative (không tốn chi phí đệ quy):
-- Search value trong BST.
-- Trả về node nếu tìm thấy, null nếu không có.
-- Trung bình O(log n) cho cây cân đối, O(n) cho cây skewed.
search(root, value):
    while root != null:
        if value = root.value: return root      -- tìm thấy
        if value < root.value: root <- root.left
        else: root <- root.right
    return null   -- không tìm thấy
Time: O(chiều cao cây) Space: O(1)
Complexity:
- Balanced BST (height ≈ log n): O(log n), mỗi bước bỏ một nửa cây.
- Skewed BST (height = n): O(n), phải đi qua mọi node theo một đường thẳng.
So với binary search trên array (bài 04): cùng O(log n) trung bình, nhưng BST còn insert/delete hiệu quả, thứ mà array đã sắp xếp không làm được.
Thử ngẫmBST search cùng O(log n) trung bình như binary search trên mảng, lại thêm insert/delete hiệu quả. Đổi lại, BST phải trả giá gì mà mảng đã sắp xếp không phải trả?
5. Delete (3 cases)
Delete là thao tác phức tạp nhất của BST vì phải giữ BST property sau khi xoá. Có 3 trường hợp, tuỳ node cần xoá có bao nhiêu con.
Case 1: Leaf node (không có con): xoá thẳng, đặt tham chiếu của node cha về null.
        5                   5
       / \      xóa 1      / \
      3   8    -------->  3   8
     / \                   \
    1   4                   4
Case 2: 1 con: bỏ qua node cần xoá, nối node cha trực tiếp với con duy nhất.
        5                   5
       / \      xóa 3      / \
      3   8    -------->  1   8
     /
    1
Case 3: 2 con: không xoá thẳng được vì phải giữ BST property cho cả hai nhánh. Cách làm: tìm in-order successor (node nhỏ nhất trong right subtree), chép giá trị của nó vào node cần xoá, rồi xoá chính successor đó (luôn rơi vào case 1 hoặc 2 vì successor không có left child).
        5                   6
       / \      xóa 5      / \
      3   8    -------->  3   8
     / \ /                / \ /
    1  4 6               1  4 7
          \
           7
In-order successor của 5 là 6 (nhỏ nhất trong right subtree {8, 6, 7}). Chép 6 vào root, rồi xoá node 6 khỏi right subtree; node 6 chỉ có right child 7 nên đây là case 2.
-- Delete value từ BST.
-- Trả về root mới (cần nếu root bị xóa).
delete(root, value):
    if root = null: return null

    if value < root.value:
        root.left  <- delete(root.left, value)    -- tìm về phía trái
    else if value > root.value:
        root.right <- delete(root.right, value)   -- tìm về phía phải
    else:
        -- Tìm thấy node cần xóa -- xử lý 3 case:

        -- Case 1: leaf node (không có con) -- cả left và right đều null
        -- Case 2a: chỉ có right child
        if root.left = null: return root.right

        -- Case 2b: chỉ có left child
        if root.right = null: return root.left

        -- Case 3: hai con
        -- Thay bằng in-order successor (node nhỏ nhất trong right subtree)
        succ          <- minNode(root.right)
        root.value    <- succ.value               -- copy giá trị của successor
        root.right    <- delete(root.right, succ.value)   -- xóa successor
    return root

-- Tìm node nhỏ nhất trong subtree (node ngoài cùng bên trái).
minNode(n):
    while n.left != null: n <- n.left
    return n
Time: O(chiều cao cây) Space: O(chiều cao cây) -- do call stack đệ quy
Vì sao in-order successor đúng? In-order successor là node nhỏ nhất trong right subtree, nên lớn hơn mọi node trong left subtree và nhỏ hơn mọi node còn lại trong right subtree. Thay node cần xoá bằng successor thì BST property vẫn giữ: left subtree (mọi giá trị nhỏ hơn giá trị cũ) vẫn nhỏ hơn successor, và phần right subtree còn lại (mọi giá trị lớn hơn successor) vẫn lớn hơn successor.
Có thể dùng in-order predecessor (node lớn nhất trong left subtree) thay cho successor, BST property vẫn giữ. Chọn successor hay predecessor thường là quy ước của từng cài đặt. Một số balanced BST dùng xen kẽ hai cách để cây cân bằng hơn.
6. Skewed BST, linked list ẩn núp
Insert sorted sequence: 1, 2, 3, 4, 5:
Insert 1: root = Node(1)
1

Insert 2: 2 > 1 -> đi phải
1
 \
  2

Insert 3: 3 > 1 -> phải; 3 > 2 -> phải
1
 \
  2
   \
    3

Insert 4, 5: tiếp tục đi phải...
1
 \
  2
   \
    3
     \
      4
       \
        5
Mọi node chỉ có right child, cây "ngả phải" hoàn toàn. Height = n, nên search, insert, delete đều O(n).
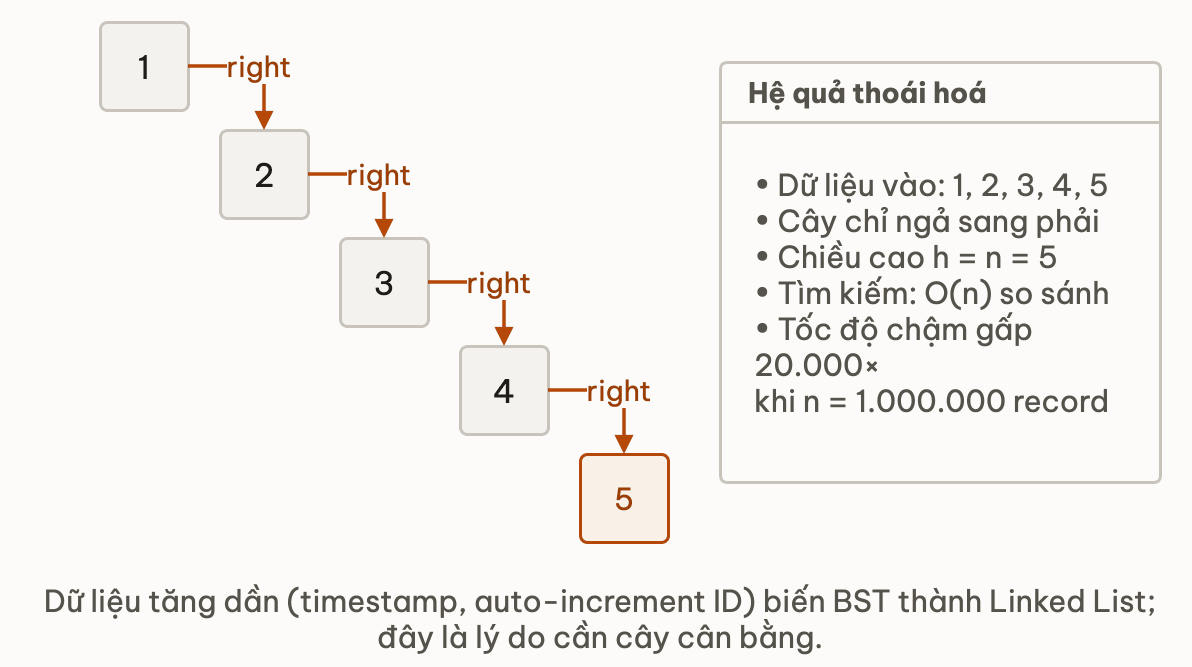
Insert sorted descending: 5, 4, 3, 2, 1 → ngả trái, tương tự.
Insert dãy ngẫu nhiên: height kỳ vọng O(log n). Thử với n = 1000 phần tử random thường ra height cỡ 20 đến 23 (khoảng 2 log₂ n). Với input đã sắp xếp: height = n = 1000.
Rủi ro ở production: dữ liệu thật thường không ngẫu nhiên. Timestamp tăng dần, auto-increment ID, file import đã sắp xếp: tất cả đều là input đã sắp xếp đối với BST ngây thơ. Benchmark bằng dữ liệu random sẽ không bắt được lỗi này.
n = 1_000_000:
  Random insert:  height ≈ 50    -> search cỡ 50 bước so sánh
  Sorted insert:  height = 1_000_000 -> search 1_000_000 bước so sánh
  Tốc độ chênh lệch: cỡ 20,000 lần
Thử ngẫmchênh lệch cỡ 20.000 lần ở trên đến từ random insert so với sorted insert cùng 1 triệu phần tử. Một bộ benchmark chỉ test với data random có đủ để loại trừ nguy cơ này không?
7. Các bẫy thường gặp
Bẫy 1: Skewed BST dưới sorted/sequential input
Benchmark thường dùng dữ liệu random nên cây cân đối, O(log n), pass. Production dùng dữ liệu từ DB query có sắp xếp tăng dần nên cây bị skew, O(n).
-- NGUY HIỂM: insert timestamp theo thứ tự tăng dần
timestamps <- lấy từ DB với ORDER BY created_at ASC
for each ts trong timestamps:
    root <- insert(root, ts)   -- tất cả đi vào right subtree -> O(n) tree

-- GIẢM THIỂU: shuffle trước (nếu thứ tự không quan trọng), hoặc dùng balanced BST
shuffle(timestamps)   -- phá vỡ thứ tự sorted
for each ts trong timestamps:
    root <- insert(root, ts)
-- TỐT HƠN: dùng TreeMap (Red-Black tree) -- luôn O(log n) bất kể thứ tự insert
Nếu dữ liệu có quy luật tăng dần (timestamp, ID tăng đơn điệu), hãy dùng balanced BST (TreeMap/TreeSet) thay vì BST ngây thơ. Bài 06 giải thích cách AVL và Red-Black tree giữ cân bằng sau mỗi insert/delete.
Bẫy 2: Mutable comparable key
Sau khi insert một object vào BST theo một giá trị so sánh, nếu giá trị đó đổi thì BST property bị phá, object "lạc" sang sai nhánh và search không tìm ra.
-- NGUY HIỂM: key có thể đổi sau khi insert
Event:
    priority: int    -- có thể thay đổi!
    compare(other): so sánh theo priority

e <- Event(priority=5)
root <- insert(root, e)      -- insert tại đúng vị trí cho priority=5
e.priority <- 10             -- BST structure giờ không hợp lệ!
search(root, e)              -- có thể không tìm thấy e dù nó đang trong cây
Giống bẫy mutable key trong Map (bài 01). Cách làm tốt: dùng key bất biến, hoặc ít nhất đừng đổi field dùng để so sánh sau khi đã insert.
Bẫy 3: Recursion depth trên skewed tree gây stack overflow
Insert 1 triệu node đã sắp xếp thì height = 1 triệu, nên insert, search, delete đệ quy cần call stack sâu 1 triệu và tràn stack (stack mặc định của một thread JVM thường cỡ 1MB).
-- NGUY HIỂM: 1M sorted inserts -> recursion depth 1M -> stack overflow
for i <- 0 đến 999_999:
    root <- insert(root, i)   -- recursive insert, depth = i
Cách sửa: dùng bản iterative (section 3), hoặc tốt hơn là dùng balanced BST để tránh skew ngay từ đầu.
8. Các ordered operation của BST
TreeMap và TreeSet trong Java cài đặt bằng Red-Black tree (cách dùng TreeMap bên cạnh HashMap xem ở Map và Set) một dạng balanced BST tự cân bằng sau mỗi insert/delete. Bài 06 sẽ đi sâu vào rotation và recoloring. Ở đây hãy chú ý các thao tác theo thứ tự mà Map thông thường (HashMap) không làm được:
-- BST hỗ trợ các thao tác theo thứ tự mà hash map không làm được:
BST ordered operations:
    findMin()          -- node nhỏ nhất: đi mãi sang trái -> O(log n)
    findMax()          -- node lớn nhất: đi mãi sang phải -> O(log n)
    ceilingKey(k)      -- key nhỏ nhất >= k (lower bound trên tree) -> O(log n)
    floorKey(k)        -- key lớn nhất <= k -> O(log n)
    higherKey(k)       -- key nhỏ nhất > k (upper bound trên tree) -> O(log n)
    subMap(a, b)       -- tất cả key trong [a, b) -> O(log n + k)
    inorderTraversal() -- duyệt theo thứ tự tăng dần -> O(n)
So sánh với Map thông thường (hash-based):
| Tình huống | Dùng | Lý do |
|---|---|---|
| Chỉ cần contains/add/remove nhanh, không cần thứ tự | Hash Map | O(1) trung bình, chi phí phụ thấp |
| Cần duyệt theo thứ tự đã sắp xếp | BST (TreeMap) | In-order traversal cho sẵn |
Cần range query (tìm mọi phần tử trong [a, b]) | BST (TreeMap) | subMap(a, b) O(log n + k) |
| Cần tìm "key gần nhất" (ceiling/floor) | BST (TreeMap) | ceiling(), floor() O(log n) |
| Dữ liệu tăng dần, sợ cây bị skew | BST tự cân bằng | Red-Black tree tự cân bằng |
Hash map lookup O(1) nhưng không có khái niệm "key gần nhất" hay range scan, muốn làm phải duyệt toàn bộ. Khi cần các thao tác theo thứ tự, BST là lựa chọn đúng dù O(log n) chậm hơn O(1).
Thử ngẫmtrong bảng trên, nhu cầu "tìm key gần nhất" chỉ BST đáp ứng được, hash map thì không. Một cache đang dùng hash map mà cần thêm tính năng đó thì nên đổi cấu trúc, hay giữ nguyên và tự quét?
9. Ứng dụng thực tế
Leaderboard top-K: giữ top 100 người chơi theo điểm. BST tự cân bằng luôn có thứ tự sẵn: findMax() cho người điểm cao nhất, range query cho top-K, thêm người chơi mới và tìm thứ hạng đều O(log n).
Database index (B+tree): index của database không dùng BST mà dùng B+tree, bản mở rộng cho ổ đĩa với hàng trăm key mỗi node thay vì 2 (bài 07). BST là bước đệm để hiểu nó.
Lịch lập sự kiện và "gần nhất": cần biết sự kiện kế tiếp sau thời điểm t hay phòng trống gần nhất. ceilingKey/floorKey của TreeMap trả lời trong O(log n); hash map phải quét toàn bộ.
10. Liên hệ các bài khác
Bài 04 là cùng tư duy "bỏ một nửa" trên mảng; bài 06 chữa bệnh skew bằng tự cân bằng; bài 07 mở rộng BST cho ổ đĩa.
11. Đào sâu
- Introduction to Algorithms (CLRS), 4th Edition, Chapter 12 (Binary Search Trees): insert/delete và chứng minh height kỳ vọng O(log n) cho BST dựng từ hoán vị ngẫu nhiên. Chapter 13: Red-Black trees.
- Effective Java, 3rd Edition, Item 14: "Consider implementing Comparable", contract của
compareTo.
Bài liên quan trong khoá học:
- Binary Search: bất biến tìm kiếm nhị phân.
- Cây tự cân bằng (AVL & Red-Black): chống thoái hoá về O(n).
12. Tóm tắt
Checklist khi đụng đến BST:
- Nhớ ba trường hợp delete (lá, một con, hai con) và rằng successor của trường hợp hai con luôn rơi vào trường hợp 1 hoặc 2.
- Mọi thao tác tốn O(chiều cao), nên hỏi ngay: dữ liệu có đến theo thứ tự không?
- Dữ liệu tăng dần (timestamp, ID) thì đừng dùng BST thường; dùng
TreeMaphoặcTreeSet. - Chọn BST thay hash map khi cần thứ tự: range query, duyệt có sắp xếp, tìm key gần nhất.
- Key phải bất biến, và cây có thể sâu thì viết bản iterative.
13. Tự kiểm tra
- Q1BST property là gì? Hệ quả về in-order traversal như thế nào?
- Q2Insert dãy 1, 2, 3, ..., n tạo ra cây skewed. Vì sao chỉ skew khi input đã sắp xếp còn random thì không?
- Q3Delete node có 2 con: chọn in-order successor hay predecessor, khác nhau thực tế ở đâu?
- Q4Skewed BST trên dữ liệu thực tế (sắp theo timestamp): production xử lý thế nào?
- Q5Hash map O(1) so với BST O(log n): khi nào chọn BST dù chậm hơn?
- Q6Độ sâu đệ quy trên skewed BST gây tràn stack, có những cách thay thế nào?
Bài tiếp theo: Self-balancing trees, AVL vs Red-Black
Binary search — Invariant, lower/upper bound và search-on-answer
Bài tiếpSelf-balancing tree — AVL vs Red-Black và lý do TreeMap chọn RB
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này