Bloom filter — Probabilistic membership, tiết kiệm RAM
Cassandra, RocksDB dùng Bloom filter để tránh đọc đĩa thừa. Giải thích bit array, k hash function, công thức false positive rate và trick Kirsch-Mitzenmacher.
TL;DR: Bloom filter là một bit array kích thước m đi kèm k hash function. add(x) bật k bit lên 1; mightContain(x) kiểm tra k bit đó: tất cả bằng 1 thì trả lời "maybe yes" (có thể có), chỉ cần một bit bằng 0 thì "definitely not" (chắc chắn không). Filter không bao giờ có false negative (đã add thì luôn trả true), chỉ có false positive (báo có dù thực ra không). Với 1 triệu key và tỉ lệ false positive (FP rate) 1%, chỉ cần khoảng 1,2MB, chưa bằng một phần hai mươi của một HashSet<String> cùng cỡ. Trick Kirsch-Mitzenmacher g_i = h1 + i × h2 cho phép tạo ra k index từ chỉ 2 hash function mà FP rate lý thuyết vẫn như cũ. Hai bẫy lớn: không delete được (bit dùng chung giữa nhiều element) và filter bão hoà khi insert vượt n dự kiến.
Một Cassandra cluster lưu 100 triệu record trên mỗi node, phân tán qua hàng trăm SSTable file trên disk. Mỗi read query phải kiểm tra N SSTable để tìm row. Mỗi lần kiểm tra là một lần đọc đĩa cỡ 1ms, nên với 100 SSTable, chỉ để biết row có tồn tại hay không đã mất cỡ 100ms. Với workload đọc nhiều, đây là thủ phạm làm latency tăng vọt.
Cassandra giải quyết bằng cách đặt một Bloom filter trên mỗi SSTable. Với FP 1%, filter chỉ tốn cỡ 1,2 byte mỗi key, nên 100 triệu key cần khoảng 120MB, giữ được trong RAM. Trước khi đụng tới disk, query hỏi filter trước. Filter trả lời theo hai cách: "definitely not" (key này chắc chắn không có trong file này, bỏ qua hẳn) hoặc "maybe yes" (có thể có, phải kiểm tra disk). "Maybe yes" đôi khi sai (false positive) nhưng "definitely not" thì không bao giờ sai (không có false negative). Kết quả: với FP 1%, khoảng 99% lượt đọc SSTable thừa được bỏ qua.
Bài này giải thích cơ chế, công thức FP rate, trick tạo k hash từ 2 hash (Kirsch-Mitzenmacher) và các biến thể.
1. Hình dung: Bảng tick check-in
Hình dung một bảng gồm 100 ô vuông đánh số 0–99, ban đầu toàn trắng. Khi khách check-in, nhân viên tô đen 3 ô (k=3), được chọn từ tên khách qua 3 công thức hash khác nhau. "Alice" → tô ô 7, 42, 83. "Bob" → tô ô 12, 42, 71.
Để kiểm tra "X đã đến chưa?", tính ra 3 ô của X rồi nhìn 3 ô đó. Nếu có 1 ô trắng thì "chắc chắn X chưa đến" (X mà đã check-in thì ô đó đã đen rồi). Nếu cả 3 đều đen thì "có thể X đã đến", nhưng cũng có thể 3 ô đó do các khách khác tô (false positive: X chưa đến mà ô đã bị người khác tô).
| Bảng check-in | Bloom filter |
|---|---|
| 100 ô vuông | Bit array kích thước m |
| Tô 3 ô theo tên khách | k hash function → set k bit |
| Ô trắng = "chắc chắn chưa" | Bit 0 = "definitely not" |
| Cả 3 đen = "có thể đã đến" | Tất cả k bit = 1 → "maybe yes" |
| Ô bị tô bởi người khác | False positive |
| Bảng nhiều ô hơn | Tỉ lệ false positive thấp hơn |
Bloom filter chỉ sai theo một hướng: false positive (báo "có" khi thực ra "không"). Không bao giờ có false negative (đã add thì mightContain luôn trả true). Nhờ vậy dùng nó để bỏ qua lượt đọc disk là an toàn.
2. Cấu trúc và thuật toán
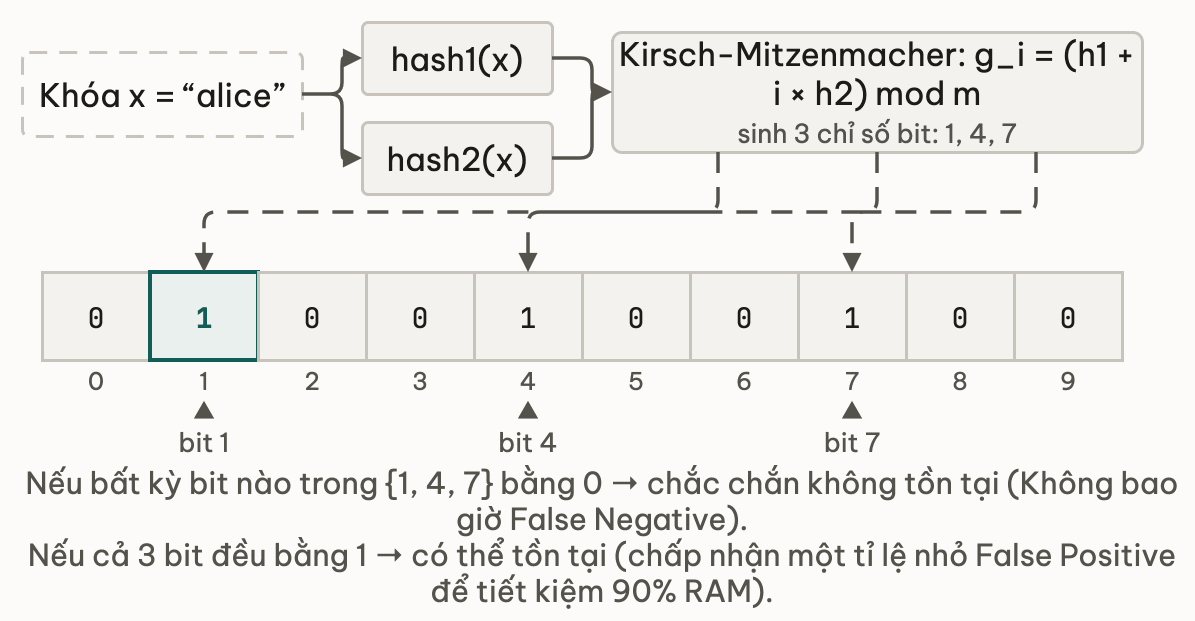
Bloom filter gồm hai thứ: một bit array kích thước m (ban đầu toàn 0), và k hash function độc lập, mỗi cái biến key thành một index trong khoảng [0, m).
-- Thêm phần tử x vào Bloom filter
add(x):
    h1 <- hash1(x)
    h2 <- hash2(x)
    -- Kirsch-Mitzenmacher: tạo k index từ 2 hash function
    for i <- 0 đến k-1:
        idx <- (h1 + i * h2) mod m
        bits[idx] <- 1               -- set bit tại vị trí idx

Time: O(k)  Space: O(1)
-- Kiểm tra phần tử x có thể có trong filter không
mightContain(x):
    h1 <- hash1(x)
    h2 <- hash2(x)
    for i <- 0 đến k-1:
        idx <- (h1 + i * h2) mod m
        if bits[idx] = 0:
            return false             -- chắc chắn không có (definitely not)
    return true                      -- có thể có (maybe yes)

Time: O(k)  Space: O(1)
Lưu ý quan trọng: phép mod phải cho kết quả luôn nằm trong [0, m). Hãy cẩn thận khi h1 + i*h2 bị tràn số hoặc âm (tuỳ ngôn ngữ), và dùng floorMod hoặc hàm tương đương trong ngôn ngữ bạn dùng.
3. Math, False positive rate
Sau khi insert n element vào filter kích thước m với k hash function:
Xác suất 1 bit cụ thể vẫn = 0 sau n lần insert:
Mỗi lần insert, mỗi hash function bật 1 trong m bit một cách ngẫu nhiên. Xác suất một bit cụ thể không bị một hash bật là (m - 1) / m = 1 - 1/m. Sau k×n lần hash (n element, mỗi element k hash), xác suất bit đó vẫn bằng 0 là:
P(bit = 0) = (1 - 1/m)^(k×n) ≈ e^(-kn/m)

-- Xấp xỉ dùng: (1 - 1/m)^m ≈ e^(-1) khi m lớn
False positive rate (cả k bit đều bằng 1 dù key chưa được add):
FP = (1 - e^(-kn/m))^k
Ví dụ nhỏ cho dễ hình dung: m = 10 bit, k = 2, mới add 1 phần tử nên 2 bit đang bật. Một key lạ trúng cả 2 bit đó với xác suất cỡ (2/10)² = 4%; công thức cho (1 - e^(-2/10))² ≈ 3,3% (lệch nhẹ vì hai hash của phần tử có thể trùng bit).
k tối ưu khi m và n đã cố định:
k_tối_ưu = (m/n) × ln(2) ≈ (m/n) × 0,693

Khi dùng k tối ưu: FP rate = (1/2)^k  -- giảm mũ theo k
Số liệu thực tế (tính theo công thức):
| n (keys) | FP target | m (bits) | m (bytes) | k |
|---|---|---|---|---|
| 1.000.000 | 1% | 9,6M bit | 1,2MB | 7 |
| 1.000.000 | 0,1% | 14,4M bit | 1,8MB | 10 |
| 1.000.000 | 0,01% | 19,2M bit | 2,4MB | 13 |
So với HashSet: 1 triệu String trong HashSet tốn hàng chục MB (ngay cả ước lượng tối thiểu 32 byte mỗi entry cũng đã là 32MB, thực tế thường hơn do object String, mảng byte và entry của bảng băm). Bloom filter với 1% FP chỉ cần 1,2MB, nhỏ hơn cỡ 27 lần so với mốc 32MB đó. Đó là lý do Cassandra nhét được Bloom filter của mỗi SSTable vào RAM.
Thử ngẫm1% FP với 1 triệu key chỉ tốn 1,2MB so với cỡ 32MB trở lên của HashSet. Nếu hạ mục tiêu FP xuống 0,01% như trong bảng trên (2,4MB), khoản tiết kiệm đó còn giữ được bao nhiêu?
4. Trick 2 hash, Kirsch-Mitzenmacher
Vấn đề thực tế: cần k hash function độc lập, với k thường từ 7 đến 13. Cài và chạy 7–13 hash function riêng biệt thì tốn kém.
Trick: chỉ cần 2 hash function h1 và h2, rồi tạo ra k hàm bằng công thức:
g_i(x) = h1(x) + i × h2(x) (i = 0, 1, ..., k-1)
Kirsch & Mitzenmacher (2008) chứng minh cách này đạt FP rate tiệm cận bằng FP rate của k hash function độc lập thật sự (khi m đủ lớn thì hai con số gần như trùng nhau). Nghĩa là FP rate không phải trả thêm giá đáng kể so với lý thuyết k hash độc lập.
Trong thực tế:
- Google Guava
BloomFilterdùng đúng trick này với MurmurHash3 128-bit, tách thành hai nửa 64-bit làm h1 và h2. - Cassandra cũng dùng murmur3 128-bit và cách kết hợp tương tự.
5. Các bẫy thường gặp
Bẫy 1: Không thể xóa phần tử
Các bit được nhiều element dùng chung, nên không thể xoá một element mà không ảnh hưởng element khác.
Ví dụ:
  "Alice" set bit 7, 42, 83
  "Bob"   set bit 12, 42, 71

Muốn "xoá Alice" bằng cách xoá các bit 7, 42, 83:
  -> bit 42 bị clear
  -> mightContain("Bob") kiểm tra bit 12, 42, 71
  -> bit 42 = 0 -> trả về false  -- SAI! Bob vẫn còn trong filter
Cách sửa: dùng Counting Bloom filter, trong đó mỗi slot là một bộ đếm (counter) 4-bit thay vì 1 bit. add tăng counter, remove giảm counter. Counter lớn hơn 0 tương đương bit = 1. Đánh đổi: bộ nhớ tăng 4 lần, và counter 4-bit có thể bị tràn nếu một slot bị tăng quá 15 lần.
Bẫy 2: False positive rate tăng khi filter bão hoà
Bloom filter không tự resize. Khi insert nhiều hơn n element đã dự kiến, số bit được bật tăng lên và tỉ lệ false positive tăng mạnh. Khi mọi bit trong array đều bằng 1, filter trả true cho mọi query, hoàn toàn vô dụng.
Cách sửa: tính kích thước đúng với n dự kiến ngay từ đầu. Nếu không biết trước n, dùng Scalable Bloom filter (Almeida et al. 2007): nối nhiều filter thành một chuỗi, filter sau lớn hơn và có mục tiêu FP chặt hơn. Khi filter hiện tại đầy thì tạo filter mới nối vào chuỗi. Query kiểm tra tất cả filter trong chuỗi.
Bẫy 3: Dùng hash mật mã vì nghĩ "an toàn hơn"
SHA-256 hay SHA-1 chậm hơn không cần thiết cho Bloom filter: hash mật mã thường chậm hơn hash không mật mã cỡ một bậc độ lớn, và k lần hash thì nhân lên.
Cách sửa: dùng hash nhanh không dành cho mật mã: MurmurHash3 (Cassandra, Guava), FarmHash (Google) hoặc xxHash (RocksDB). Các hash này không cần tính chất mật mã (chống collision, chống suy ngược), chỉ cần phân bố đều. Với key ngắn, MurmurHash3 128-bit chỉ cỡ chục nanosecond.
Thử ngẫmfilter bão hoà khi insert vượt n dự kiến, còn Counting Bloom tốn gấp 4 lần bộ nhớ để hỗ trợ delete. Một hệ thống vừa cần delete vừa không biết trước n nên chọn biến thể nào?
6. Variants
Counting Bloom filter và Scalable Bloom filter là hai cách chữa hai bẫy ở trên (xoá được; không cần biết trước n). Thêm một lựa chọn thay thế: Cuckoo filter lưu một fingerprint ngắn của mỗi key trong bảng hash, mỗi key có hai bucket ứng viên. Nó hỗ trợ delete tự nhiên và, theo paper gốc, tiết kiệm bộ nhớ hơn Bloom khi mục tiêu FP thấp hơn khoảng 3%.
7. Ứng dụng trong hệ thống thực tế
Bloom filter của SSTable trong Cassandra: ví dụ kinh điển. Cassandra dùng LSM tree: ghi vào MemTable (RAM), rồi flush thành SSTable trên disk. Đọc phải kiểm tra MemTable và các SSTable. Bloom filter trên mỗi SSTable trả lời "key này có trong file này không?", và "definitely not" thì bỏ qua hẳn file đó. FP rate chỉnh theo từng table bằng bloom_filter_fp_chance (giá trị mặc định tuỳ phiên bản và compaction strategy).
RocksDB, HBase, LevelDB: cùng mô hình LSM nên đều hỗ trợ Bloom filter (bật bằng cấu hình). RocksDB cho chỉnh bits-per-key, 10 bit/key cho khoảng 1% FP. Nhờ vậy LSM tree bù được phần lớn chi phí đọc nhiều file.
Safe Browsing của trình duyệt: ý tưởng là giữ cục bộ một cấu trúc nhỏ chứa hash của URL độc hại, "definitely not" thì cho vào ngay, chỉ khi "maybe yes" mới hỏi server. Chrome ở các bản đầu dùng Bloom filter cho việc này; các bản sau chuyển sang danh sách hash prefix nén, cùng tinh thần.
CDN: Akamai dùng Bloom filter để chỉ cache một object khi nó được request lần thứ hai, vì một phần lớn object chỉ được request đúng một lần ("one-hit wonders"); filter nhớ những URL đã thấy một lần (Maggs & Sitaraman, 2015).
8. Đào sâu
Paper gốc:
- Burton Bloom (1970), "Space/Time Trade-offs in Hash Coding with Allowable Errors" (Communications of the ACM). Bài báo gốc định nghĩa Bloom filter, rất ngắn và dễ đọc.
- Kirsch & Mitzenmacher (2008), "Less Hashing, Same Performance: Building a Better Bloom Filter". Chứng minh trick
g_i = h1 + i*h2đủ tốt về lý thuyết, nền của nhiều bản cài đặt hiện đại. - Almeida et al. (2007), "Scalable Bloom Filters". Mô tả kỹ thuật nối các filter con để insert không bị giới hạn bởi n.
Source thực tế:
- Cassandra
BloomFilter.java: murmur3 với trick 2 hash. - Google Guava
BloomFilterAPI, bản cài đặt chuẩn vớicreate(Funnel, long, double)(funnel, số insert dự kiến, FP rate). Guava tự tính m và k tối ưu. - Fan et al. (2014), "Cuckoo Filter: Practically Better Than Bloom" nếu muốn đọc về lựa chọn thay thế hỗ trợ delete.
Bài liên quan trong khoá học:
- Hash Function: cơ chế k hàm băm độc lập.
- HyperLogLog: cấu trúc xác suất ước lượng cardinality.
- Count-Min Sketch: cấu trúc xác suất ước lượng tần suất.
Đọc thêm: Count-min sketch — khoá Thuật toán ứng dụng giới thiệu "anh em" của Bloom filter: cùng cơ chế k hash function trên một mảng bit/counter, nhưng đếm tần suất thay vì chỉ trả lời có/không.
9. Tóm tắt
Checklist khi định dùng Bloom filter:
- Chỉ dùng khi chấp nhận false positive nhưng không chấp nhận false negative (ví dụ bỏ qua một lần đọc disk).
- Tính m và k từ n và FP rate mong muốn; 1% với 1 triệu key cần khoảng 1,2MB.
- Cần delete thì dùng counting Bloom hoặc cuckoo filter; số phần tử vượt n dự kiến thì dùng Scalable Bloom hoặc dựng lại filter.
- Dùng hash không dành cho mật mã như MurmurHash3 hoặc xxHash; tạo k index từ hai hash (Kirsch-Mitzenmacher).
- Gặp ở Cassandra, HBase, RocksDB, Chrome Safe Browsing và CDN cache.
10. Tự kiểm tra
- Q1Bloom filter trả 'definitely not' hoặc 'maybe yes', chỉ sai theo một hướng (false positive). Vì sao không thể có false negative?
- Q21 triệu key với FP rate 1% thì cần m và k bằng bao nhiêu? Tính theo công thức.
- Q3Vì sao k tối ưu bằng (m/n) × ln(2)? Trực giác đằng sau là gì?
- Q4Vì sao Bloom filter không hỗ trợ delete? Counting Bloom giải quyết thế nào và đánh đổi là gì?
- Q5Vì sao trick 2 hash g_i(x) = h1 + i×h2 gần tốt bằng k hash function độc lập? Có vấn đề gì không?
- Q6Cassandra dùng Bloom filter cùng LSM tree thay vì B+tree. Workload nào khiến Bloom filter đặc biệt hữu ích? Workload nào kém hơn?
Bài tiếp theo: Mini-challenge: Trie + autocomplete top-K
Trie — Autocomplete, IP routing, và prefix-friendly dictionary
Bài tiếpMini-challenge — Autocomplete top-K với Trie + frequency
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này