Binary search — Invariant, lower/upper bound và search-on-answer
Binary search dễ sai ở overflow, off-by-one và lặp vô hạn. Dùng invariant [lo, hi) để viết lower bound, upper bound và search-on-answer đúng ngay từ đầu.
TL;DR: Binary search tìm điểm chuyển tiếp (transition point) trên một không gian monotonic (đơn điệu: chỉ đổi chiều một lần). Không gian đó không nhất thiết là sorted array, mà là bất kỳ thứ gì có predicate dạng [F F F T T T]. Dùng convention half-open [lo, hi) với mid = lo + (hi-lo)/2 thì tránh được ba lỗi kinh điển: overflow, off-by-one và infinite loop. Lower bound (predicate >=) trả về vị trí đầu tiên của target; upper bound (predicate >) trả về vị trí ngay sau target cuối cùng, hai hàm chỉ khác một ký tự so sánh. Search-on-answer đem binary search áp lên không gian câu trả lời (các con số): O(N log(hi-lo)) thay vì brute force O(N * hi).
Binary search giải thích xong trong 5 phút, nhưng viết đúng thì khó đến bất ngờ. Jon Bentley kể trong Programming Pearls rằng khi giao bài này cho lập trình viên chuyên nghiệp, khoảng 90% tìm ra bug trong bản của mình. Năm lỗi hay gặp: mid = (lo+hi)/2 gây overflow, off-by-one ở điều kiện lặp, lặp vô hạn khi lo == hi - 1, nhầm lower bound với upper bound, và xử lý sai khi có duplicate. Chính lỗi overflow từng nằm trong Arrays.binarySearch của JDK hơn chục năm cho đến khi Joshua Bloch nêu ra năm 2006.
Bài này dạy binary search bằng invariant (bất biến: một điều luôn đúng ở đầu mỗi vòng lặp). Nắm đúng invariant thì các biến thể viết được nhanh mà ít dính bug.
1. Hình dung: Tra từ điển giấy
Bạn mở từ điển giấy tìm từ "serendipity". Thay vì lật từng trang từ đầu, bạn mở thẳng ra giữa và thấy chữ "M". "S" đứng sau "M" nên bạn lật về phía sau. Lần sau mở ra chữ "R", lại lật tiếp về sau. Rồi tới "T", phải lật lùi. Mỗi lần bạn bỏ đi một nửa số trang còn lại, và sau khoảng 20 bước bạn tìm ra "serendipity" trong 500 nghìn từ.
Cách này chạy được vì từ điển đã sắp xếp theo alphabet. Đó cũng là điều kiện tiên quyết của binary search: dữ liệu phải monotonic, tức có một ngưỡng tách phần "không thoả mãn" với phần "thoả mãn".
| Từ điển giấy | Binary search |
|---|---|
| 500 nghìn trang được sắp theo alphabet | Array hoặc không gian tìm kiếm có thứ tự |
| Mở trang giữa, so sánh chữ cái | Xét phần tử ở giữa (mid) |
| Bỏ nửa trái hoặc nửa phải | Thu hẹp [lo, hi) về [lo, mid) hoặc [mid+1, hi) |
| Mỗi bước chia đôi số trang còn lại | Mỗi bước tốn O(1), tổng O(log n) bước |
| Từ điển phải sắp theo alphabet | Predicate phải monotonic: toàn false rồi toàn true |
Binary search = tra từ điển. Điều kiện: dữ liệu có thứ tự. Cơ chế: mỗi bước bỏ một nửa. Kết quả: log n bước thay vì n bước.
2. Prerequisite, Monotonic predicate
Binary search không đòi hỏi sorted array. Yêu cầu thật sự là monotonic predicate: tồn tại một điểm tách sao cho mọi phần tử bên trái cho false, mọi phần tử bên phải (kể cả chính điểm tách) cho true. Không có phần tử true nào đứng trước một phần tử false.
Không gian predicate: [F F F F F T T T T T]
                                 ^
                             điểm chuyển tiếp -- đây là thứ binary search tìm
Hai ví dụ:
Ví dụ 1: Sorted array tìm target:
Array [2, 5, 8, 12, 16, 23, 38], tìm 12. Predicate P(i) = arr[i] >= 12.
Giá trị predicate: [F F F T T T T]
                          ^
                     index 3 = first T = vị trí của 12
Ví dụ 2: Search-on-answer (không phải sorted array):
"Capacity tối thiểu để ship hết hàng trong D ngày." Predicate P(c) = canShip(capacity=c, days=D). Predicate này monotonic vì capacity càng lớn thì cần càng ít ngày, nên càng dễ thoả.
Predicate trên không gian capacity: [F F F F T T T T]
                                              ^
                                      capacity tối thiểu hợp lệ
Điểm mấu chốt: binary search tìm điểm chuyển tiếp, chỗ predicate đổi từ false sang true. Sorted array chỉ là trường hợp riêng khi predicate là arr[i] >= target.
3. Implementation chuẩn, Invariant-driven
Invariant ta chọn: "câu trả lời luôn nằm trong [lo, hi)", với lo được tính (inclusive), hi không được tính (exclusive).
Vì sao half-open [lo, hi) tốt hơn [lo, hi]?
- Khởi tạo tự nhiên:
lo = 0; hi = nlà cả array. - Điều kiện lặp
while lo < hidừng khilo == hi, đúng một điểm, không cần kiểm tra thêm. - Không bị infinite loop khi
lo == hi - 1(lỗi của[lo, hi]nếu viếtlo = mid).
-- Tìm chỉ số đầu tiên i mà predicate(i) là true.
-- Tiền đề: predicate là monotonic -- toàn false rồi toàn true.
-- Hậu đề: trả về lo == hi == chỉ số true đầu tiên.
--          Trả về n nếu không có phần tử nào thoả predicate.
lowerBound(A, target):
    lo <- 0
    hi <- A.length        -- half-open: [lo, hi)

    while lo < hi:
        mid <- lo + (hi - lo) / 2    -- tránh overflow (lo+hi) / 2

        if A[mid] >= target:
            hi <- mid                -- mid có thể là đáp án, giữ lại trong khoảng
        else:
            lo <- mid + 1            -- mid chắc chắn không phải đáp án

    return lo    -- lo == hi == điểm chuyển tiếp
Time: O(log n) Space: O(1)
3.1 Thử sức: Sắp xếp các bước cài đặt lowerBound
Trước khi đi tiếp, hãy thử ghép lại các dòng lệnh của thuật toán lowerBound theo bất biến nửa mở [lo, hi):
Đưa từng dòng vào khung lời giải rồi xếp cho đúng thứ tự. Kho có thể chứa dòng thừa.
Kho dòng (12)
lo = midhi = mid - 1lo = mid + 1mid = lo + (hi - lo) // 2hi = midmid = (lo + hi) // 2return loelse:while lo < hi:lo = 0hi = A.lengthif A[mid] >= target:
Lời giải của bạn (0/9)
Chưa có dòng nào. Bấm “Đưa vào” ở trên.
Gợi ý: Bất biến [lo, hi): mid vẫn có thể là đáp án thì giữ lại (hi = mid), mid bị loại thì bỏ hẳn (lo = mid + 1). Dùng lo + (hi - lo) // 2 để tránh tràn số int.
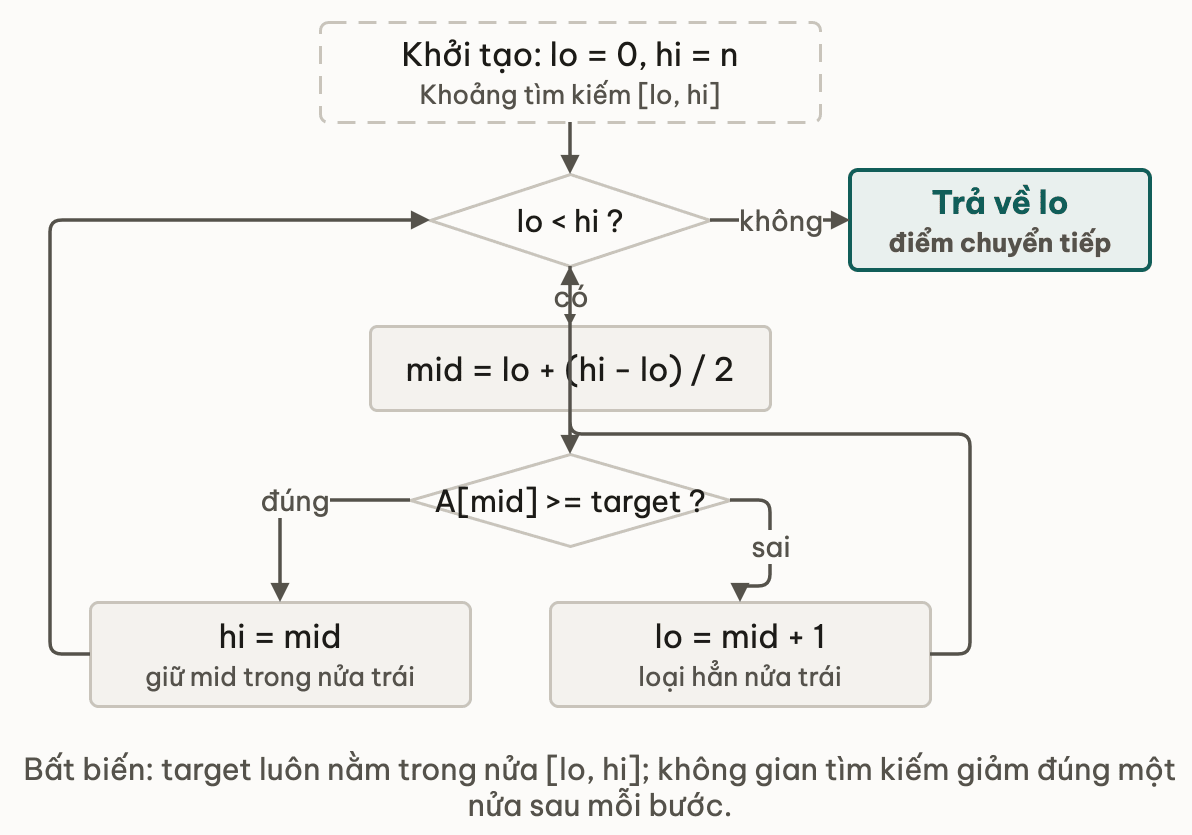
Trace qua ví dụ: A = [2, 5, 8, 12, 16, 23, 38], target = 12.
lo=0, hi=7:  mid=3, A[3]=12 >= 12  -> hi=3
lo=0, hi=3:  mid=1, A[1]=5  < 12   -> lo=2
lo=2, hi=3:  mid=2, A[2]=8  < 12   -> lo=3
lo=3, hi=3:  vòng lặp kết thúc (lo == hi)
return 3   -- A[3] = 12, đúng
Vì sao invariant đảm bảo kết quả đúng? Mỗi bước giảm hi - lo ít nhất 1:
- Predicate true tại
mid:hi = mid. Vìmid < hinênhigiảm, khoảng thu hẹp. - Predicate false tại
mid:lo = mid + 1. Vìmid >= lonênlotăng, khoảng thu hẹp.
Khi lo == hi, vòng lặp dừng. lo chính là điểm chuyển tiếp: mọi index trước lo là false, mọi index từ lo trở đi là true. Điều kiện dừng lo < hi chính là điều kiện của vòng while; nếu chưa chắc vì sao vòng lặp phải kết thúc, ôn lại ở Vòng lặp while.
Thử ngẫmbản trace trên tìm target trong mảng 7 phần tử mất 3 bước. Mảng có 7 triệu phần tử thì số bước tăng gấp triệu lần hay chỉ nhích thêm vài bước?
4. 5 lỗi kinh điển và cách phòng
4.1 Overflow trong (lo + hi) / 2
Với lo = 1_000_000_000 và hi = 2_000_000_000, phép lo + hi = 3_000_000_000 vượt giới hạn số nguyên 32-bit (MAX = 2_147_483_647), kết quả thành số âm và index sai.
-- WRONG: overflow khi lo + hi > giới hạn int 32-bit
mid <- (lo + hi) / 2

-- CORRECT: không bao giờ overflow
mid <- lo + (hi - lo) / 2
-- Vì hi >= lo, (hi - lo) không âm và tối đa là MAX_INT
Lỗi này nằm trong JDK Arrays.binarySearch từ cuối thập niên 1990 đến khi Joshua Bloch nêu ra năm 2006 (bài viết "Nearly All Binary Searches and Mergesorts Are Broken").
4.2 Off-by-one trong loop condition
Convention [lo, hi) (half-open) và [lo, hi] (closed) cần điều kiện lặp khác nhau:
-- Convention [lo, hi) -- half-open, KHUYẾN NGHỊ
while lo < hi: ...
-- Vòng lặp kết thúc khi lo == hi -- đúng một ứng viên

-- Convention [lo, hi] -- closed
while lo <= hi: ...
-- Vòng lặp kết thúc khi lo > hi -- khoảng rỗng
Trộn hai convention trong cùng một hàm là nguồn gốc của off-by-one. Chọn một convention và dùng nhất quán. Các input biên (mảng rỗng, một phần tử, target nhỏ hơn hay lớn hơn mọi phần tử) là nơi bug ẩn; cách nghĩ về chúng nằm ở Edge case.
4.3 Infinite loop khi lo == hi - 1
Lỗi này rất phổ biến khi dùng khoảng đóng [lo, hi] nhưng lại viết lo = mid thay vì lo = mid + 1. Hãy thử phát hiện lỗi trong đoạn code dưới đây:
while (lo <= hi) {
  int mid = lo + (hi - lo) / 2;
  if (predicate(mid)) {
      hi = mid - 1;
  } else {
      lo = mid; // <-- Thử bấm để xem hệ quả
  }
}Với convention nửa mở [lo, hi) và lo = mid + 1, lỗi này hoàn toàn bị triệt tiêu vì mid luôn nhỏ hơn hi và mid + 1 luôn kéo lo tiến về phía trước.
4.4 Lower bound vs upper bound
Hai hàm chỉ khác nhau ở một ký tự so sánh:
-- Lower bound: chỉ số đầu tiên i mà A[i] >= target
-- = lần xuất hiện đầu tiên của target (hoặc insertion point nếu không có)
lowerBound(A, target):
    lo <- 0;  hi <- A.length
    while lo < hi:
        mid <- lo + (hi - lo) / 2
        if A[mid] >= target: hi <- mid     -- predicate: >=
        else: lo <- mid + 1
    return lo

-- Upper bound: chỉ số đầu tiên i mà A[i] > target
-- = một vị trí sau lần xuất hiện cuối cùng của target
upperBound(A, target):
    lo <- 0;  hi <- A.length
    while lo < hi:
        mid <- lo + (hi - lo) / 2
        if A[mid] > target: hi <- mid      -- predicate: > (chỉ khác đây!)
        else: lo <- mid + 1
    return lo
Time: O(log n) Space: O(1)
Với array [1, 2, 2, 2, 3] và target = 2:
lowerBoundtrả về 1 (index đầu tiên có giá trị bằng 2).upperBoundtrả về 4 (index đầu tiên có giá trị lớn hơn 2).- Số lần xuất hiện của 2:
upperBound - lowerBound = 4 - 1 = 3.
4.5 Duplicate handling
Binary search kiểu ngây thơ trả về một index bất kỳ trong dãy giá trị trùng, không đảm bảo là đầu tiên hay cuối cùng. Cần vị trí chính xác thì làm như sau:
-- Tìm lần xuất hiện đầu tiên của target -- dùng lowerBound, sau đó verify
findFirst(A, target):
    pos <- lowerBound(A, target)
    if pos < A.length AND A[pos] = target: return pos
    return -1   -- không tìm thấy

-- Tìm lần xuất hiện cuối cùng của target -- dùng upperBound - 1, sau đó verify
findLast(A, target):
    pos <- upperBound(A, target) - 1
    if pos >= 0 AND A[pos] = target: return pos
    return -1   -- không tìm thấy
Time: O(log n) Space: O(1)
Thử ngẫmfindFirst/findLast ở trên đều dựa vào lowerBound/upperBound viết cho một mảng có sẵn. Nếu không gian tìm kiếm không phải mảng mà là một khoảng số nguyên, invariant [lo, hi) còn dùng được không?
5. Search-on-answer pattern
5.1 Ý tưởng
Thay vì binary search trên array có sẵn, ta binary search trên không gian câu trả lời. Cách này dùng được khi:
- Câu trả lời là một số nằm trong khoảng
[lo, hi]xác định được. - Có hàm
predicate(x)kiểm tra "x có phải câu trả lời hợp lệ không?" - Predicate là monotonic:
xhợp lệ thì mọiy > xcũng hợp lệ (hoặc ngược lại).
5.2 Bài kinh điển, Capacity tối thiểu để ship hàng trong D ngày
Đề bài: Cho mảng weights gồm n gói hàng và số ngày days. Hàng được chở theo đúng thứ tự trong mảng. Tìm capacity tối thiểu của tàu để chở hết trong days ngày.
Tính monotonic: capacity càng lớn thì cần càng ít ngày, nên nếu capacity c đủ thì c+1 cũng đủ. Vậy predicate P(c) = canShip(c, days) là monotonic.
-- Kiểm tra nếu capacity cho phép ship hết trong days ngày.
canShip(weights, capacity, days):
    daysNeeded  <- 1
    currentLoad <- 0

    for each weight trong weights:
        if currentLoad + weight > capacity:
            daysNeeded  <- daysNeeded + 1    -- bắt đầu ngày mới
            currentLoad <- 0
        currentLoad <- currentLoad + weight

    return daysNeeded <= days

-- Time: O(n) -- một lượt qua mảng

-- Tìm capacity tối thiểu để ship hết hàng trong days ngày.
shipWithinDays(weights, days):
    lo <- max(weights)       -- capacity ít nhất bằng gói nặng nhất
    hi <- sum(weights)       -- tối đa ship hết trong một ngày

    -- Binary search: tìm capacity nhỏ nhất mà canShip trả về true
    while lo < hi:
        mid <- lo + (hi - lo) / 2
        if canShip(weights, mid, days):
            hi <- mid              -- mid đủ, thử nhỏ hơn
        else:
            lo <- mid + 1          -- mid quá nhỏ, cần lớn hơn

    return lo    -- capacity tối thiểu hợp lệ

-- Time: O(n * log(sum - max))  Space: O(1)
Ví dụ: weights = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10], days = 5 → kết quả 15 (ngày 1: 1 đến 5, ngày 2: 6 và 7, ngày 3: 8, ngày 4: 9, ngày 5: 10; capacity 14 thì phải cần 6 ngày).
Complexity: canShip là O(n). Binary search chạy O(log(sum - max)) lần. Tổng: O(n * log(sum)). Với n = 500, sum cỡ 50000 thì chỉ khoảng 500 * 17 = 8500 phép tính, so với brute force O(n * sum) = 25_000_000.
Các bài cùng dạng:
- Koko Eating Bananas, minimum eating speed.
- Split Array Largest Sum, minimum largest sum.
- Minimize Max Distance to Gas Station.
6. Bẫy bổ sung
Bẫy 1: Float binary search và convergence
Với binary search trên số thực, vòng lặp while lo < hi có thể không dừng vì độ chính xác của float:
-- WRONG: có thể không dừng do độ chính xác của float
lo <- 0.0;  hi <- 1e9
while lo < hi:          -- lo và hi có thể không bằng nhau chính xác
    mid <- (lo + hi) / 2.0
    ...

-- BETTER: số lần lặp cố định
-- Mỗi lần lặp khoảng giảm một nửa; sau vài chục lần lo, hi đã sát nhau
-- tới giới hạn độ chính xác của float, nên 100 lần là dư
lo <- 0.0;  hi <- 1e9
for iter <- 0 đến 99:
    mid <- (lo + hi) / 2.0
    if predicate(mid): hi <- mid
    else: lo <- mid
-- lo ≈ hi ≈ đáp án, với độ chính xác tối đa mà float cho phép

-- ALTERNATIVE: dừng khi khoảng đủ nhỏ (chọn epsilon cẩn thận)
while hi - lo > 1e-9:
    mid <- (lo + hi) / 2.0
    if predicate(mid): hi <- mid
    else: lo <- mid
Lặp cố định 100 lần an toàn hơn kiểm tra epsilon: khỏi đoán trước epsilon, và không lo vòng lặp không dừng khi epsilon quá nhỏ so với độ lớn của lo/hi.
Bẫy 2: Sorted descending array
Binary search trên array giảm dần phải đảo predicate:
-- Array giảm dần: A[mid] <= target (không phải >=)
lowerBoundDesc(A, target):
    lo <- 0;  hi <- A.length
    while lo < hi:
        mid <- lo + (hi - lo) / 2
        if A[mid] <= target: hi <- mid     -- flipped: <= thay vì >=
        else: lo <- mid + 1
    return lo
Viết vội rất dễ quên, nên hãy luôn kiểm tra array đang tăng hay giảm dần trước khi chọn predicate.
Bẫy 3: Predicate có side effect hoặc chậm
Binary search gọi predicate O(log n) lần, nên predicate có side effect (ghi DB, đổi state) hoặc tốn kém (gọi network, quét toàn bộ) sẽ nhân chi phí lên:
-- PROBLEMATIC: predicate tốn kém bị gọi O(log n) lần
while lo < hi:
    mid <- lo + (hi - lo) / 2
    if expensiveNetworkCheck(mid): hi <- mid   -- gọi ~30 lần cho n=10^9
    else: lo <- mid + 1
Trước khi dùng binary search, hãy chắc predicate là pure function (không side effect) và đủ nhanh để nhân với O(log n) vẫn chấp nhận được.
Thử ngẫmpredicate gọi network ở trên bị gọi khoảng 30 lần cho n = 10^9. Nếu API đó giới hạn 10 request/giây, một lần binary search mất tối thiểu bao lâu?
7. Ứng dụng thực tế
Git bisect: git bisect good/bad chạy binary search trên lịch sử commit để tìm commit gây regression. Predicate là "build/test có pass tại commit này không?"; 1000 commit chỉ cần khoảng 10 bước kiểm tra. Đây là search-on-answer với không gian là các commit xếp theo thời gian.
Lập kế hoạch capacity: "cần tối thiểu bao nhiêu instance để giữ p99 latency dưới 200ms". P(n) = canHandle(n instances, traffic, latency dưới 200ms) monotonic vì nhiều instance hơn thì latency thấp hơn, nên binary search trên [1, maxInstances] ra số instance nhỏ nhất đủ dùng.
B+tree index và math library: mỗi node B+tree là một sorted array nhỏ (thường vài trăm key) nên tìm trong node là binary search (bài 07). Căn bậc hai cũng cài được bằng binary search với predicate y*y >= x, dù thực tế thư viện dùng lệnh sqrt của CPU hoặc Newton-Raphson.
8. Đào sâu
Sách và bài viết kinh điển:
- The Art of Computer Programming, Vol. 3, Knuth, Chapter 6.2.1 (Binary search): phân tích toán học, số phép so sánh kỳ vọng, và chứng minh tính đúng đắn bằng loop invariant.
- "Extra, Extra — Read All About It: Nearly All Binary Searches and Mergesorts Are Broken", Joshua Bloch (2006): bài viết chỉ ra lỗi overflow trong JDK
Arrays.binarySearch. Ngắn, đọc trong 10 phút, và đã thay đổi cách cả ngành viết binary search.
Luyện tập: các bài LeetCode gắn tag "Binary Search", chia theo pattern: basic, lower/upper bound, search-on-answer, rotated array, 2D matrix.
Bài liên quan trong khoá học:
- Binary Search Tree: biến mảng tìm kiếm thành cấu trúc cây động.
- Độ phức tạp O(log n): phân đôi không gian tìm kiếm.
9. Tóm tắt
Checklist thực chiến trước khi viết hoặc review một vòng binary search:
| Hạng mục | Quy tắc vàng | Lỗi nếu vi phạm |
|---|---|---|
| Điều kiện áp dụng | Không gian vị từ phải đơn điệu: [F...F T...T] | Trả về đáp án sai khi mảng chưa sắp xếp hoặc hàm predicate đổi chiều thất thường. |
| Bất biến khoảng | Nửa mở [lo, hi): điều kiện lặp while lo < hi | [lo, hi] lẫn lộn với [lo, hi) sinh ra lỗi off-by-one hoặc lặp vô hạn khi còn 2 phần tử. |
| Tính chỉ số giữa | Luôn dùng lo + (hi - lo) / 2 | (lo + hi) / 2 gây tràn số nguyên 32-bit khi tổng vượt quá 2,14 tỷ. |
| Thu hẹp khoảng | hi = mid (giữ mid) và lo = mid + 1 (bỏ mid) | Bỏ sót đáp án tại vị trí mid hoặc kẹt lặp vĩnh viễn. |
| Số thực (Float) | Lặp cố định 60–100 vòng | while (hi - lo > epsilon) bị treo vĩnh viễn do giới hạn biểu diễn của số chấm động. |
10. Tự kiểm tra
- Q1Vì sao lo + (hi - lo) / 2 an toàn hơn (lo + hi) / 2? Trường hợp nào gây overflow?
- Q2Lower bound và upper bound chỉ khác 1 ký tự ở đâu? Cho ví dụ với array có duplicate.
- Q3Binary search có cần sorted array không? Cho 1 ví dụ không phải sorted array nhưng vẫn dùng được.
- Q4Với search-on-answer, tính monotonic cần đảm bảo điều gì? Nếu không monotonic thì sao?
- Q5Binary search trên số thực: vì sao lặp một số lần cố định thay vì kiểm tra hội tụ (while hi - lo > epsilon)?
- Q6Cho đoạn code:
while (lo <= hi) { mid = lo+(hi-lo)/2; if (check(mid)) lo = mid; else hi = mid-1; }, bug gì?
Bài tiếp theo: BST, insert/search/delete + balance
Open addressing — Probing, Robin Hood và vì sao Java chọn chaining
Bài tiếpBST — Insert, search, delete và tại sao skewed BST là O(n)
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Ôn phỏng vấn
Bài này trả lời được các câu phỏng vấn sau — tự trả lời thử trước khi mở đáp án.
Thảo luận & góp ý
Hỏi đáp về bài này