Open addressing — Probing, Robin Hood và vì sao Java chọn chaining
Python dict, Go map, Rust HashMap dùng open addressing; Java chọn chaining. Giải thích probing, Robin Hood hashing, tombstone và lý do thiết kế.
TL;DR: Open addressing đặt mọi entry trong một array duy nhất, không có node object, không có pointer ra ngoài. Khi collision xảy ra, thuật toán "probe" (thăm dò) sang ô kế tiếp theo một quy tắc: linear (bước cố định bằng 1), quadratic (bước nhảy tăng dần: 1, 2, 3...), hoặc double hashing (bước nhảy lấy từ hash function thứ hai). Khi delete không được gán null thẳng tay mà phải dùng tombstone (dấu "ô này từng có entry") để không làm đứt probe chain. Java HashMap giữ chaining, còn Python, Rust (và Go từ 1.24) dùng open addressing vì cache locality tốt hơn.
Bài 01 — Hash function đã giải thích cơ chế định vị bucket và hashCode/equals contract. Java HashMap dùng separate chaining: mỗi bucket là một linked list (treeify khi chain dài quá 8 và table từ 64 bucket). Nhưng mở source của Python dict, Go map hay Rust HashMap ra, bạn sẽ thấy kiến trúc khác hẳn: không có Node object, không có next pointer. Mọi entry nằm thẳng trong một array duy nhất.
Đây là open addressing: gặp collision thì "probe" sang ô kế tiếp theo một quy tắc nhất định, thay vì nối entry ra ngoài.
1. Hình dung: Bãi đậu xe có quy tắc
Hình dung một bãi đậu xe có 16 ô đánh số 0 đến 15. Mỗi xe có một ô "được chỉ định" dựa trên biển số (hash function). Ô đó đã có xe khác (collision) thì tài xế phải tìm ô trống khác, và quy tắc tìm ô trống chính là probing strategy.
- Linear probing: ô 5 đã có xe → thử ô 6, 7, 8... tuần tự đến khi có ô trống.
- Quadratic probing: ô 5 đã có xe → thử ô 6, rồi ô 8, ô 11, ô 15... bước nhảy tăng dần (1, 2, 3, 4).
- Double hashing: ô 5 đã có xe → bước nhảy do hash function thứ hai quyết định, không cố định.
- Robin Hood: khi một xe đã phải đi xa ô chỉ định của nó hơn xe đang đậu trong ô đó, hai xe đổi chỗ cho nhau để cân bằng quãng đường.
| Bãi đậu xe | Open addressing |
|---|---|
| Ô đậu xe | Slot trong bucket array |
| Biển số → ô được chỉ định | Hash function → index ban đầu |
| Ô đã có xe → tìm ô khác | Collision → probe tiếp |
| Quy tắc tìm ô trống | Probing strategy (linear / quadratic / double) |
| Bãi đầy 70%, phải mở rộng | Load factor cao → resize |
| Ô bỏ trống nhưng có biển "vẫn đi qua đây" | Tombstone marker khi delete |
Open addressing = mọi xe nằm trong cùng một bãi. Probing = quy tắc tìm ô trống khi ô chỉ định đã bị chiếm. Chaining = mỗi ô có thêm một khu riêng bên ngoài để đậu xe dồn ra.
2. Open addressing là gì
Trong separate chaining (Java HashMap), mỗi bucket trỏ tới một linked list bên ngoài. Trong open addressing, không có pointer, không có node object, mọi key và value nằm thẳng trong bucket array:
-- Skeleton: open addressing hash map
OpenAddressMap:
    keys[capacity]      -- mảng key, null = trống
    values[capacity]    -- mảng value tương ứng
    size: int
    capacity: int

-- Khi put(key, value):
--   1. idx <- hash(key) mod capacity
--   2. Nếu keys[idx] = null hoặc keys[idx] = key → ghi vào đó
--   3. Nếu slot đã có key khác (collision) → probe sang slot tiếp theo
--   4. Lặp đến khi tìm được slot trống hoặc tìm lại đúng key
Yêu cầu bắt buộc: load factor phải dưới 1 và luôn còn ít nhất một slot trống, nếu không probe loop chạy vô hạn. Thực tế người ta giữ load factor dưới 0.7 để probe chain không quá dài.
Lợi thế so với chaining: chỉ cần một array, thay vì một array cộng N node object nằm rải rác trong heap. Các entry nằm kề nhau trong bộ nhớ nên một lần CPU nạp cache line có thể mang theo nhiều entry liên tiếp, và cache miss ít hơn.
3. Linear probing
Công thức: index = (hash + i) mod capacity, với i = 0, 1, 2, ...
Thử index ban đầu, rồi index+1, index+2... Hết array thì quay về đầu (modulo). Vòng while trong code chạy đến khi gặp ô chưa từng dùng; nếu chưa chắc điều kiện dừng của vòng lặp, ôn lại ở Vòng lặp while.
LinearProbingMap:
    keys[capacity]
    values[capacity]
    tombstone[capacity]   -- đánh dấu slot đã xóa nhưng probe phải đi qua
    size: int
    capacity: int

    baseIndex(key):
        return (hash(key) AND 0x7FFFFFFF) mod capacity

    get(key):
        i <- baseIndex(key)
        while keys[i] != null OR tombstone[i]:
            if keys[i] != null AND keys[i] = key: return values[i]
            i <- (i + 1) mod capacity
        return null

    put(key, value):
        if size >= capacity * 0.7: resize()
        i <- baseIndex(key)
        firstTombstone <- -1
        -- Duyệt toàn bộ probe chain; tombstone KHÔNG phải điểm dừng.
        -- Chỉ dừng tại slot chưa từng dùng (keys[i]=null VÀ !tombstone[i]).
        while keys[i] != null OR tombstone[i]:
            if keys[i] != null AND keys[i] = key:
                values[i] <- value    -- cập nhật key đã có
                return
            if keys[i] = null AND firstTombstone = -1:
                firstTombstone <- i   -- nhớ slot tombstone đầu tiên để tái dùng
            i <- (i + 1) mod capacity
        -- Key chưa có. Tái dùng tombstone nếu có, nếu không dùng slot trống này.
        target <- firstTombstone nếu firstTombstone != -1 else i
        keys[target]      <- key
        values[target]    <- value
        tombstone[target] <- false
        size              <- size + 1
Time: O(1) amortized Space: O(capacity)
Minh họa linear probing, thêm 4 key có hash 2, 2, 3, 2 (cố ý collision). Nếu chưa quen đọc bảng trace theo từng bước, ôn ở Bảng trace:
Sau put("a", hash=2):
  [0]-  [1]-  [2]"a"  [3]-  ...

Sau put("b", hash=2): -- slot 2 occupied, probe sang slot 3
  [0]-  [1]-  [2]"a"  [3]"b"  ...

Sau put("c", hash=3): -- slot 3 occupied, probe sang slot 4
  [0]-  [1]-  [2]"a"  [3]"b"  [4]"c"  ...

Sau put("d", hash=2): -- slots 2,3,4 đều chiếm, probe sang slot 5
  [0]-  [1]-  [2]"a"  [3]"b"  [4]"c"  [5]"d"  ...
Các entry "a", "b", "c", "d" dồn thành một cluster (cụm) liên tiếp. Đây là primary clustering: entry có hash khác (hash=3 của "c") cũng bị kéo vào cụm, và cụm cứ dài thêm.
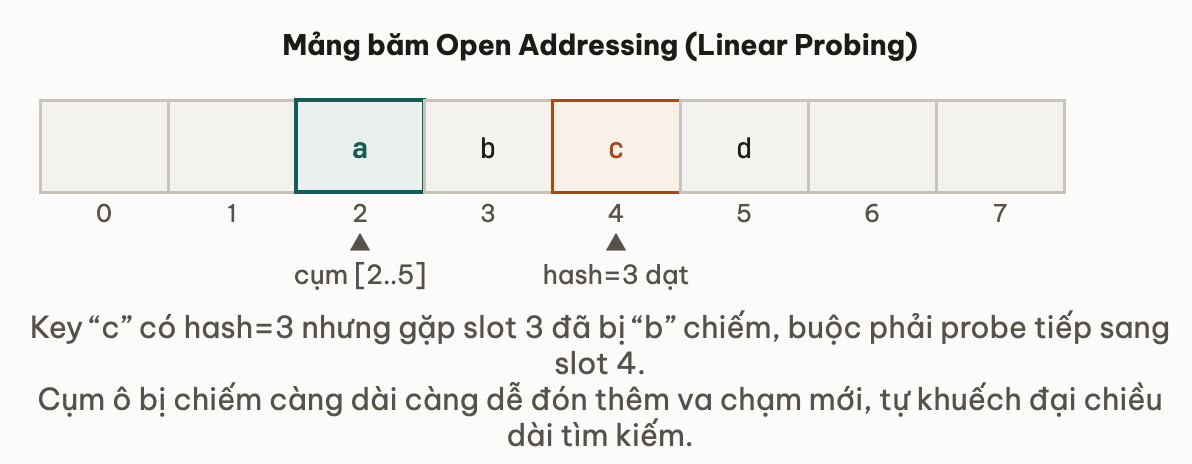
Ưu điểm: truy cập bộ nhớ tuần tự nên CPU prefetch (nạp trước) hoạt động tốt, cache hit rate cao.
Nhược điểm: primary clustering, các entry dồn thành một dải dài. Cụm tự khuếch đại: ô trống nằm cạnh cụm luôn bị chiếm trước, nên cụm nối dài thêm.
Thử ngẫmở ví dụ trên, key hash=3 của "c" bị kéo vào cùng cluster với các key hash=2, dù hash gốc khác nhau. Nếu số key trùng hash tăng gấp đôi thì cụm này lan xa tới đâu?
4. Quadratic probing
Công thức: index = (hash + i*(i+1)/2) mod capacity (dạng triangular)
Thay vì bước cố định bằng 1, bước nhảy tăng dần: thử hash, hash+1, hash+3, hash+6, hash+10... (cộng dồn 1, 2, 3, 4, tức số tam giác).
-- Quadratic probing: bước nhảy tăng theo bình phương
probe(baseHash, i):
    return (baseHash + i*(i+1)/2) mod capacity

get(key):
    base <- baseIndex(key)
    for i <- 0 đến capacity-1:
        idx <- probe(base, i)
        if keys[idx] = null AND NOT tombstone[idx]: return null
        if keys[idx] != null AND keys[idx] = key: return values[idx]
    return null
Time: O(1) amortized Space: O(capacity)
Ưu điểm: tránh primary clustering: entry có hash khác nhau đi theo probe path khác nhau, không dồn thành cụm liên tiếp.
Nhược điểm: secondary clustering: hai key có cùng hash ban đầu đi theo cùng một probe path nên vẫn dồn vào nhau. Nhẹ hơn primary clustering, nhưng vẫn đáng ngại khi hash function tệ.
Yêu cầu: để bản triangular này chắc chắn probe qua mọi slot (không bỏ sót), capacity phải là lũy thừa của 2.
5. Double hashing
Công thức: index = (hash1(key) + i * hash2(key)) mod capacity
Bước nhảy của mỗi key được tính từ một hash function thứ hai. Hai key cùng hash1 nhưng khác hash2 sẽ đi theo hai path hoàn toàn khác nhau.
-- Double hashing: hai hàm băm độc lập
hash1(key):
    return (hash(key) AND 0x7FFFFFFF) mod capacity

hash2(key):
    h <- hash(key) AND 0x7FFFFFFF
    return 1 + (h mod (capacity - 1))   -- luôn trong [1, capacity-1]

probe(key, i):
    return (hash1(key) + i * hash2(key)) mod capacity
Time: O(1) amortized Space: O(capacity)
Ưu điểm: phá được cả primary lẫn secondary clustering. Probe path của mỗi key phụ thuộc vào cả hai hash function, nên rải đều nhất trong ba strategy.
Nhược điểm: phức tạp hơn, cần hai hash function chất lượng tốt. Bước nhảy không tuần tự nên cache miss nhiều hơn linear probing, và CPU tốn thêm một lần tính hash.
Bảng so sánh 3 strategy:
| Strategy | Cluster | Cache locality | Độ phức tạp | Đảm bảo probe hết các slot |
|---|---|---|---|---|
| Linear probing | Primary cluster nặng | Tốt nhất (tuần tự) | Đơn giản | Luôn đảm bảo |
| Quadratic probing | Secondary cluster nhẹ | Trung bình | Trung bình | Cần capacity là lũy thừa của 2 |
| Double hashing | Hầu như không cluster | Kém (nhảy lung tung) | Phức tạp nhất | Cần capacity nguyên tố |
6. Tombstone, vì sao cần khi delete
Delete trong open addressing không thể chỉ gán slot thành null, vì làm vậy đứt probe chain:
Table sau một số put:
  [0]-  [1]"x"(h=1)  [2]"y"(h=1)  [3]"z"(h=1)  [4]-

get("z"): bắt đầu slot 1, probe 1→2→3, tìm thấy. OK.

Naive delete "y": set keys[2] = null
  [0]-  [1]"x"(h=1)  [2]NULL  [3]"z"(h=1)  [4]-

get("z") sau delete: bắt đầu slot 1 → probe sang slot 2 → null → DỪNG
  Kết quả: return null  <<< FALSE MISS -- "z" vẫn ở slot 3!
Xoá "y" để lại một lỗ hổng ở slot 2. Khi tìm "z", probe gặp null ở slot 2 thì dừng, không bao giờ tới được slot 3 nơi "z" đang nằm.
Tombstone (bia mộ) là cách giải quyết: thay vì xoá hẳn, đánh dấu slot là "đã xoá nhưng probe phải đi tiếp qua đây":
Delete "y" với tombstone: set tombstone[2] = true, keys[2] = null
  [0]-  [1]"x"(h=1)  [2]TOMB  [3]"z"(h=1)  [4]-

get("z") sau tombstone delete:
  bắt đầu slot 1 → slot 2 có tombstone → tiếp tục probe → slot 3 tìm thấy "z"
  Kết quả: trả về giá trị của "z". Đúng!
remove(key):
    i <- baseIndex(key)
    while keys[i] != null OR tombstone[i]:
        if keys[i] != null AND keys[i] = key:
            keys[i]      <- null
            tombstone[i] <- true   -- đánh dấu tombstone, không phải null thông thường
            size         <- size - 1
            return
        i <- (i + 1) mod capacity
    -- key không tìm thấy
Time: O(1) amortized Space: O(1)
Trade-off của tombstone:
get()phải đi xuyên qua slot tombstone, không dừng sớm được, nên chậm dần khi tombstone nhiều lên.put()có thể tái dùng slot tombstone, nhưng phải đi hết probe chain trước để chắc key chưa tồn tại.- Sau nhiều lần delete/insert, tombstone tích tụ, nên cần rehash định kỳ: tạo array mới, chép lại các entry còn sống (bỏ tombstone) rồi phân bố lại.
Gán slot thành null thẳng khi delete gây false miss (tìm không ra dù key vẫn còn) cho mọi key nằm sau lỗ hổng đó. Luôn dùng tombstone hoặc backward shift deletion.
7. Robin Hood hashing
Ý tưởng: mỗi entry ghi lại displacement, tức số bước probe đã đi từ vị trí hash ban đầu. Khi insert một entry mới, nếu entry mới đã đi nhiều bước hơn entry đang ngồi ở slot đó thì hai entry đổi chỗ: entry mới chiếm slot, entry cũ phải probe tiếp.
Entry đã đi xa nhất thì được ưu tiên giành slot, entry đang nằm gần chỗ gốc phải nhường và đi tiếp. Đó là lý do có tên Robin Hood: lấy của người "giàu" (ít phải đi) chia cho người "nghèo" (đã đi rất xa).
-- Robin Hood linear probing: mỗi slot lưu thêm displacement
RobinHoodMap:
    keys[capacity]
    values[capacity]
    displacement[capacity]   -- số bước probe của entry đang ngồi ở slot đó
                             -- -1 = slot trống
    size: int
    capacity: int

    put(key, value):
        if size >= capacity * 0.7: resize()
        idx      <- (hash(key) AND 0x7FFFFFFF) mod capacity
        dist     <- 0
        curKey   <- key
        curVal   <- value

        while true:
            if displacement[idx] = -1:
                -- slot trống: đặt entry vào đây
                keys[idx]         <- curKey
                values[idx]       <- curVal
                displacement[idx] <- dist
                size              <- size + 1
                return
            -- Robin Hood swap: nếu entry hiện tại có displacement nhỏ hơn, đổi chỗ
            if displacement[idx] < dist:
                hoán đổi (keys[idx], curKey)
                hoán đổi (values[idx], curVal)
                hoán đổi (displacement[idx], dist)
            idx  <- (idx + 1) mod capacity
            dist <- dist + 1
Time: O(1) amortized Space: O(capacity)
Kết quả: phương sai (độ chênh lệch) của probe length giảm đáng kể. Không còn cảnh entry này bị đẩy rất xa trong khi entry kia nằm sát vị trí ban đầu, probe length đều hơn.
Đánh đổi:
- Code phức tạp hơn, nhất là delete (cần backward shift hoặc tombstone cải tiến).
- Mỗi slot cần thêm một field
displacement, tức tốn thêm bộ nhớ cho mỗi entry. - Lookup có thể dừng sớm: nếu
displacement[i] < expected_displacementthì key không thể nằm xa hơn, trả về "không tìm thấy" ngay.
Ai đang dùng: HashMap của Rust std từng dùng Robin Hood cho đến trước Rust 1.36 (2019), khi chuyển sang hashbrown (SwissTable) với SIMD group probing, xem section 11. CPython dict không dùng Robin Hood mà dùng perturbation probing, cũng ở section 11.
Thử ngẫmRobin Hood làm probe length đều hơn bằng cách hoán đổi entry ngay lúc insert. Chi phí hoán đổi đó trả trước ở put(), hay dồn về sau ở get()?
8. Các bẫy thường gặp
Bẫy 1: Load factor quá cao
Open addressing mà load factor vượt 0.7 thì probe chain dài ra rất nhanh, get() và put() thoái hoá dần về O(n).
-- BUG: không resize khi load factor vượt ngưỡng
-- Sau khi thêm 14+ entry vào array 16 slot (87% full):
--   tìm một key không có trong bảng tốn trung bình cỡ 30 lần probe
--   (công thức Knuth, linear probing, alpha = 0.875)

-- CORRECT: resize khi vượt 0.7
put(key, value):
    if size >= capacity * 0.7: resize()
    ...
Separate chaining chịu được load factor cao hơn (Java HashMap mặc định 0.75) vì collision ở bucket A không ảnh hưởng bucket khác. Open addressing thì collision ở A làm chậm luôn B, C, D nằm kề.
Bẫy 2: Quên xử lý tombstone
Gán keys[i] <- null khi xoá (gọi là remove_broken) làm mọi key nằm sau slot đó trong probe chain biến mất khỏi get(); cách đúng là tombstone ở section 6.
Bẫy 3: Hash function tệ với linear probing
Linear probing rất nhạy với chất lượng hash function: hash tệ tạo primary cluster khiến put, get, remove thành O(n) dù load factor thấp (cực đoan nhất là mọi key cùng hash 0). Quadratic probing và double hashing chịu hash tệ tốt hơn vì probe path đa dạng hơn, nhưng không probing strategy nào cứu nổi một hash function trả cùng một giá trị cho mọi key.
9. Chaining vs open addressing
| Khía cạnh | Separate chaining | Open addressing |
|---|---|---|
| Cách bố trí bộ nhớ | Array + N node object rải rác trong heap | Một array duy nhất |
| Cache locality | Đuổi theo pointer gây cache miss | Quét tuần tự, hợp với cache |
| Load factor tối đa thực tế | 0.75 – 1.0 | 0.5 – 0.7 |
| Delete | Đơn giản (unlink node) | Phức tạp (tombstone hoặc backward shift) |
| Worst case một bucket | Treeify → O(log n) (Java 8) | Cluster → O(n) |
| Chi phí bộ nhớ phụ | Cao (Node object: hash + key + value + next) | Thấp (chỉ key + value, tuỳ cách cài đặt thêm displacement) |
| Dùng trong | Java HashMap, LinkedHashMap | Python dict, Go map, Rust HashMap |
Khi nào open addressing tốt hơn: key nhỏ (int, pointer), dữ liệu cỡ vừa, cần lookup hợp với cache, hoặc chi phí bộ nhớ của Node là vấn đề.
Khi nào chaining tốt hơn: key lớn (object phức tạp), delete thường xuyên, load factor có thể cao, hoặc cần kế thừa từ hash map (kiểu LinkedHashMap).
Thử ngẫmtrong bảng trên, load factor tối đa thực tế của open addressing chỉ 0.5–0.7, còn chaining tới 1.0. Một hệ thống cần tiết kiệm RAM tối đa nên nghiêng về cấu trúc nào?
10. Vì sao Java chọn chaining
Chaining không "tốt hơn" về kỹ thuật. Các lý do dưới đây là suy luận từ thiết kế, không phải tuyên bố chính thức của đội JDK:
1. Thiết kế từ năm 1998 (Java 1.2): cache locality hồi đó khó là ưu tiên của một thư viện collection, và linked list đơn giản để cài đặt.
2. LinkedHashMap extends HashMap: chaining cho phép thêm before/after pointer thẳng vào class Node để giữ thứ tự insert. Với open addressing thì phải giữ một linked list riêng bên ngoài.
3. Giữ nguyên về sau: Java 8 (2014) thêm treeify để chặn collision tấn công, giữ worst case ở O(log n); open addressing không có cách tương đương gọn. Đổi cấu trúc nội bộ cũng đụng tới các view entrySet(), keySet() và code đang dựa vào hành vi của HashMap.
11. Open addressing trong thực tế
Python dict (CPython): open addressing với probe sequence có perturbation: i = (5*i + perturb + 1) mod capacity, với perturb = hash ban đầu và shift phải dần mỗi bước. perturb trộn bit cao của hash vào dãy probe nên các key trùng bit thấp vẫn tách đường. Load factor tối đa của CPython dict là 2/3.
Go map: đến Go 1.23, mỗi "bucket" chứa 8 slot kèm mảng tophash (8 bit cao của hash), so tophash trước rồi mới so key, và bucket đầy thì nối thêm overflow bucket (lai giữa chaining và open addressing). Từ Go 1.24, map chuyển sang SwissTable giống Rust.
Rust HashMap — SwissTable: SwissTable do Google công bố năm 2017 (Abseil); Rust std dùng bản hashbrown của nó từ Rust 1.36 (2019). Mỗi slot có một "control byte" lưu 7 bit của hash (H2) hoặc giá trị đặc biệt "empty"/"deleted". Khi lookup, một nhóm control byte (thường 16 byte trên x86 với SSE2) được so cùng lúc bằng một SIMD instruction, nên kiểm tra cả nhóm slot chỉ trong vài lệnh.
12. Đào sâu
- The Art of Computer Programming, Vol. 3, Knuth, Chapter 6.4 (Hashing): expected probe length cho linear, quadratic, double hashing.
- Pedro Celis, 1986, luận án "Robin Hood Hashing" (University of Waterloo): bài gốc của Robin Hood.
- Google Abseil, design notes của SwissTable:
https://abseil.io/about/design/swisstables. - CPython
Objects/dictobject.c(perturb, compact dict) và cratehashbrown(nền củastd::collections::HashMap).
Liên hệ các bài khác
Bài 01: Hash function quyết định chất lượng probing; HashMap internals (khoá Java) cho thấy phía chaining, load factor 0.75 và treeify.
Bài liên quan trong khoá học:
- Hash Function: phân bố đều và hiệu ứng tuyết lở.
- Cache Locality: lý do Open Addressing nhanh hơn Chaining trên CPU.
13. Tóm tắt
Checklist khi chọn hoặc tự viết hash table:
- Giữ load factor dưới khoảng 0.7 với open addressing, và resize trước khi bảng đầy chứ đừng chờ đến khi probe đã dài.
- Chọn linear probing khi cần cache locality và hash function đủ trộn; chuyển sang double hashing nếu thấy cluster.
- Delete bằng tombstone, đừng gán
null(làm đứt probe chain), và rehash định kỳ khi tombstone tích tụ. - Java giữ chaining vì lý do lịch sử và
LinkedHashMap; Python, Rust (Go từ 1.24) chọn open addressing vì cache locality. - Muốn probe length đều nhất thì cân nhắc Robin Hood hashing để giảm chênh lệch độ dài probe.
14. Tự kiểm tra
- Q1Linear probing, quadratic probing và double hashing: mỗi cái giải quyết vấn đề gì của cái trước? Đánh đổi là gì?
- Q2Khi delete trong open addressing, tombstone giải quyết vấn đề gì? Khi nào cần rehash để dọn tombstone?
- Q3Robin Hood hashing cải thiện metric nào của hash table so với linear probing thông thường?
- Q4Vì sao Python, Go, Rust chọn open addressing còn Java giữ chaining? Lý do kỹ thuật và lý do lịch sử khác nhau thế nào?
- Q5Với open addressing, load factor 0.5, 0.7 và 0.9 kéo theo hệ quả gì về probe length và bộ nhớ?
- Q6Hash function tệ tạo cụm, chaining và open addressing đều xuống cấp, nhưng khác nhau thế nào về mức độ và cơ chế?
Bài tiếp theo: Binary search, invariant, lower/upper bound, search-on-answer
Hash function — Uniform, avalanche, và hashCode/equals contract
Bài tiếpBinary search — Invariant, lower/upper bound và search-on-answer
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Ôn phỏng vấn
Bài này trả lời được các câu phỏng vấn sau — tự trả lời thử trước khi mở đáp án.
Thảo luận & góp ý
Hỏi đáp về bài này