Module 1 — Tìm kiếm nhanh: tổng quan
Hashing, binary search, BST, cây cân bằng, B-tree, trie, bloom filter — bộ cấu trúc dữ liệu cốt lõi của mọi database, cache, search engine.
TL;DR: Module 1 trang bị 7 cấu trúc tìm kiếm mà mọi hệ thống production dùng hàng ngày. Bắt đầu từ hash function, nền tảng của HashMap, cache key, distributed shard, rồi leo qua open addressing, binary search, BST, cây cân bằng AVL/RB, B-tree/B+tree, trie và bloom filter. Mỗi bài giải thích cơ chế bên dưới, rồi phân tích khi nào cấu trúc đó thắng, khi nào thua. Kết thúc bằng case study thật: vì sao MySQL chọn B+tree, và Redis resize bảng thế nào mà không chặn các lệnh khác.
Vì sao module này tồn tại
Mỗi lần bạn gọi map.get(key), trình duyệt kiểm tra URL trong blacklist, autocomplete gợi ý từ khoá, hay MySQL chạy SELECT * FROM orders WHERE id = 42, một cấu trúc tìm kiếm đang chạy bên dưới. Chọn sai cấu trúc không chỉ làm chậm: độ phức tạp có thể nhảy từ O(1) lên O(n) trên tập dữ liệu hàng triệu phần tử.
Vấn đề là hầu hết tài liệu dừng ở API: "dùng HashMap cho O(1), dùng TreeMap cho sorted". Module này đi xuống tầng cơ chế: hash function cần phân bố đều (uniform distribution) và hiệu ứng tuyết lở (avalanche effect) để làm gì, vì sao open addressing nhanh hơn chaining trên CPU hiện đại dù cùng O(1) trung bình, bất biến của binary search vận hành ra sao, và vì sao B+tree cần leaf linked list cho range query còn hash table thì không.
Hiểu cơ chế giúp bạn làm được 3 việc mà chỉ biết API thì không làm nổi:
- Chẩn đoán điểm nghẽn hiệu năng: HashMap chậm không phải vì O(1) sai mà vì load factor 0.95 làm chain dài ra.
- Chọn đúng cấu trúc khi thiết kế: trie cho prefix search, bloom filter cho membership check mà tiết kiệm RAM, B+tree cho disk index.
- Đọc hiểu source và documentation của database, cache, search engine, vì chúng đều dùng các cấu trúc này.
Phần HashMap nội tạng JDK: chaining chi tiết, treeify threshold, resize 2x, ConcurrentHashMap (khoá theo từng bucket), nằm ở khoá Java Internals vì nó gắn chặt với Java bytecode và JVM. Module này dạy tư tưởng thuật toán không gắn với ngôn ngữ nào; nếu bạn học Java thì đọc thêm Java Internals, HashMap internals để thấy các khái niệm trong module này tương ứng với JDK source ra sao.
Sau module này bạn sẽ
- Implement hashing với chaining và open addressing, phân tích load factor ảnh hưởng đến probe length và khi nào nên resize.
- Compare các cây tìm kiếm, BST, cây cân bằng (AVL/RB), B-tree, trie, theo trường hợp dùng, workload và ràng buộc bộ nhớ.
- Explain binary search cùng bất biến của nó, và bloom filter cùng đánh đổi giữa tỉ lệ false positive và RAM.
- Design index cho hệ thống thật: B+tree của database, skiplist của Redis, trie của autocomplete engine.
Bản đồ module
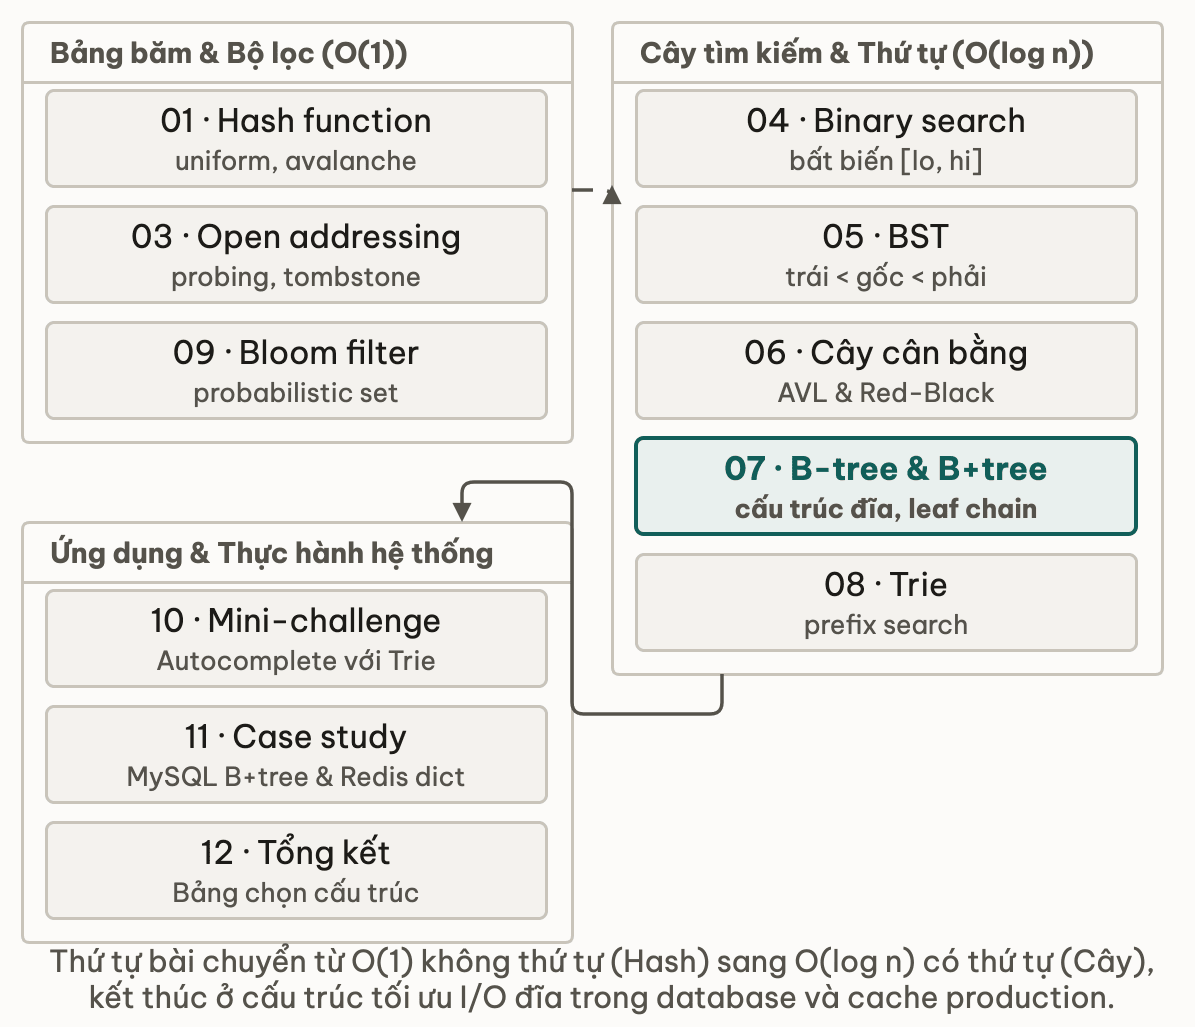
(Bài 02, HashMap internals JDK, nằm ở khoá Java Internals; link mềm ở bài 01 cuối trang.)
Lộ trình module
Thứ tự bài được thiết kế theo nguyên tắc "xây từ nền, mỗi bài mở khoá bài sau":
Bài 01: Hash function là điểm khởi đầu: phân bố đều (uniform distribution) và hiệu ứng tuyết lở (avalanche effect, đổi 1 bit đầu vào thì gần một nửa bit đầu ra đổi theo) là hai tính chất cốt lõi mà mọi cấu trúc dựa trên hash đều cần. Không hiểu hash function thì bạn không giải thích được vì sao HashMap thoái hoá hay open addressing chạy được.
Bài 03: Open addressing tiếp ngay sau chaining: thay vì linked list, ghi entry trực tiếp vào array bằng probing. Nhanh hơn trên CPU hiện đại nhờ cache locality (các phần tử nằm sát nhau nên cache nạp được cả cụm), nhưng bạn cần hiểu tombstone và clustering để khỏi vấp bẫy.
Bài 04: Binary search là bước chuyển sang cấu trúc dạng cây: mảng đã sắp xếp cùng bất biến (loop invariant: điều luôn đúng ở đầu mỗi vòng lặp). Tư tưởng "phân đôi không gian tìm kiếm" sẽ xuất hiện lại trong BST và B-tree.
Bài 05: BST xây cây tìm kiếm từ nền: mỗi node là một binary search. Bài này cũng giải thích vì sao BST chưa đủ: cây mất cân bằng thì worst case thành O(n), và đó là lý do có bài tiếp theo.
Bài 06: Cây cân bằng (AVL, Red-Black tree) giải quyết vấn đề của BST: rotation (xoay cây) để giữ chiều cao O(log n) dù chèn và xoá theo thứ tự nào. Bài giải thích khi nào dùng AVL (đọc nhiều) và khi nào dùng Red-Black (ghi nhiều).
Bài 07: B-tree & B+tree mở rộng cây ra disk: fanout lớn (1000+) giảm height xuống 3-4 cho 100 triệu row, leaf linked list cho range scan. Đây là cấu trúc đằng sau index của MySQL InnoDB.
Bài 08: Trie là cây chuyên biệt cho string key: mỗi cạnh là một ký tự, các string cùng prefix dùng chung một đường đi. Dùng trong autocomplete, IP routing table, dictionary.
Bài 09: Bloom filter là cấu trúc xác suất (probabilistic): một bit array cùng k hash function, không bao giờ có false negative, còn false positive thì kiểm soát được. 1 triệu key chỉ cần 1.2MB. Dùng trong Cassandra, RocksDB, HBase.
Bài 10: Mini-challenge áp dụng trie vào autocomplete thật: implement prefix search với frequency ranking.
Bài 11: Case study kết nối lý thuyết vào production: vì sao MySQL InnoDB chọn B+tree, Redis resize bảng mà không chặn thế nào. Đọc source thật để hiểu quyết định thiết kế.
Bài 12: Tổng kết gom cheat sheet, glossary và self-assessment.
Yêu cầu trước khi bắt đầu
- Đã học khoá Thuật toán Căn bản: Nền tảng (Big-O, đệ quy) và Cấu trúc tuyến tính (array, linked list, stack, queue, heap).
- Hiểu khái niệm pointer/reference và cách linked list hoạt động, BST và trie đều dùng node chứa con trỏ tới node con.
- Không yêu cầu ngôn ngữ cụ thể, pseudocode trong module này không gắn với ngôn ngữ nào.
- Module đọc rất nhiều bảng trace và vòng lặp. Nếu chưa chắc, ôn nhanh Bảng trace (cách lần từng bước một đoạn code) và Vòng lặp while (vì sao vòng lặp dừng).
Time budget
| Bài | Chủ đề | Thời lượng |
|---|---|---|
| 00 | Tổng quan (bài này) | ~8 phút |
| 01 | Hash function: uniform, avalanche | ~16 phút |
| 03 | Open addressing: probing, tombstone | ~20 phút |
| 04 | Binary search: bất biến | ~16 phút |
| 05 | BST: insert, delete, traversal | ~18 phút |
| 06 | Cây cân bằng: AVL, Red-Black | ~19 phút |
| 07 | B-tree & B+tree: disk index | ~18 phút |
| 08 | Trie: prefix search | ~15 phút |
| 09 | Bloom filter: kiểm tra membership xác suất | ~15 phút |
| 10 | Mini-challenge: trie autocomplete | ~30 phút |
| 11 | Case study: MySQL & Redis | ~23 phút |
| 12 | Tổng kết & cheat sheet | ~13 phút |
| Tổng | ~3,5 giờ |
Cách học module này hiệu quả
- Vẽ sơ đồ tay. BST, AVL rotation, B-tree split, tất cả đều cần hình dung ra được. Hãy vẽ tay từng bước insert và delete trước khi đọc pseudocode, vì não xử lý thao tác trên cây tốt hơn nhiều khi có hình.
- Hỏi "khi nào cái này thua?". Cấu trúc nào cũng có worst case: BST thoái hoá về O(n), bloom filter không delete được, trie tốn RAM khi alphabet lớn. Biết giới hạn quan trọng hơn biết ưu điểm.
- Liên hệ ngay vào công cụ bạn đang dùng. HashMap trong Java/Python/Go, index trong MySQL/PostgreSQL,
KEYStrong Redis, autocomplete trong IDE, tất cả đều dùng cấu trúc trong module này. Mỗi khi gặp một tool mới, hỏi "cấu trúc nào đằng sau đó?". - Module 2 (Sắp xếp) xây trực tiếp trên module này. Heap sort dùng heap từ khoá Thuật toán Căn bản. Counting sort dùng một mảng đếm, cùng tư tưởng với hash. Radix sort dùng tư tưởng trie. Nắm vững Module 1 thì Module 2 sẽ đi nhanh hơn nhiều.
Bài tiếp theo: Hash function
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này