Trie — Autocomplete, IP routing, và prefix-friendly dictionary
Trie biến prefix query thành O(L) độc lập với số từ — HashMap phải scan O(n×L). Bài dạy trie, Patricia/Radix tree và ứng dụng từ autocomplete đến IP routing.
TL;DR: Trie (đọc như "try") là cây mà mỗi node đại diện cho một ký tự, và đường đi từ root đến một node chính là một prefix. Tìm prefix chỉ là đi theo đường đó, tốn O(L) và hoàn toàn không phụ thuộc n (số từ đã lưu), trong khi HashMap phải quét toàn bộ O(n×L). Hai bẫy lớn nhất: dùng mảng [26] khi alphabet có dấu (Unicode), và quên kiểm tra isEnd sau walk nên nhầm "node trung gian" với "từ hợp lệ". Patricia/Radix tree nén các chuỗi node chỉ có một con thành một nhãn trên cạnh (edge label), được dùng trong bảng định tuyến IP (BSD), Redis, Ethereum.
Bạn cần build autocomplete cho 1 triệu tên sản phẩm. Người dùng gõ "ca", hệ thống phải trả về mọi từ bắt đầu bằng "ca" trong vòng vài millisecond.
Với HashMap: không tìm prefix được. Bạn phải quét cả 1 triệu key, kiểm tra từng cái xem có bắt đầu bằng "ca" không, O(n × L), rất tệ. Với TreeMap: subMap("ca", "cb") lấy được khoảng prefix, nhưng mỗi lần so sánh vẫn phải so cả chuỗi.
Câu trả lời là Trie (đọc như "try"): cây mà mỗi node đại diện cho một ký tự, và đường từ root xuống là các ký tự của một từ. Tìm prefix là đi theo các ký tự, tốn O(L) với L là độ dài prefix, hoàn toàn không phụ thuộc n (số từ đã lưu).
Bài này dạy trie cơ bản, biến thể nén (Patricia/Radix tree), top-K autocomplete và đánh đổi giữa bộ nhớ và tốc độ lookup.
1. Hình dung: Bản đồ chữ
Hình dung một mê cung có các ngã rẽ dán nhãn chữ cái. Từ điểm xuất phát (root), bạn đi theo từng ký tự của từ cần tìm: muốn tìm "car" thì rẽ "c", rồi "a", rồi "r". Tới nơi là bạn đã thấy "car".
Điều hay là mọi từ bắt đầu bằng "ca" đều đi qua cùng ngã rẽ "c" rồi "a". Muốn liệt kê hết các từ bắt đầu bằng "ca"? Đi tới giao lộ "ca", rồi khám phá các nhánh con từ đó: rẽ "r" ra "car", rẽ "t" ra "cat", rẽ "n" ra "can". Không cần quét cả dictionary.
| Bản đồ chữ | Trie |
|---|---|
| Điểm xuất phát | Root node |
| Ngã rẽ dán nhãn "c", "a", "r" | Node với character key |
| Đường đi từ root đến đích | Path = một từ |
| Giao lộ chung "ca" | Prefix node được chia sẻ |
| Khám phá nhánh từ giao lộ "ca" | DFS subtree để liệt kê các từ khớp prefix |
| Biển "điểm dừng, từ kết thúc ở đây" | isEnd = true trên node |
Trie hợp với prefix query vì các từ cùng prefix dùng chung đường đi. Càng nhiều từ chung prefix thì càng tiết kiệm bộ nhớ, khác với HashMap lưu mỗi key riêng rẽ.
2. Cấu trúc trie cơ bản
Mỗi node trong trie cần hai thứ: một map từ ký tự sang node con, và một cờ (flag) cho biết node này có phải điểm kết thúc của một từ không.
Cấu trúc node:
  TrieNode:
    children: Map<ký_tự, TrieNode>   -- map từ ký tự sang node con
    isEnd: boolean                   -- true nếu node này kết thúc một từ hợp lệ

  -- Khởi tạo: children rỗng, isEnd = false
Đánh đổi giữa Map<ký_tự, Node> và mảng [26]:
| Cách lưu children | Lookup | Bộ nhớ | Phù hợp khi |
|---|---|---|---|
Mảng [26] | O(1), rất nhanh | 26 pointer mỗi node, lãng phí nếu node thưa | Chỉ a-z, trie dày đặc |
HashMap<ký_tự, Node> | O(1) amortized | Chỉ cấp phát khi có child thực sự | Alphabet rộng, trie thưa |
TreeMap<ký_tự, Node> | O(log k), k = số children | Như HashMap nhưng có thứ tự | Cần duyệt children theo thứ tự |
Với Unicode (65k+ ký tự), mảng [65536] tốn khoảng 256 đến 512KB mỗi node (tham chiếu 4 hay 8 byte), không thể dùng được. Alphabet rộng thì dùng HashMap.
3. Insert, Search, và startsWith
-- Insert từ vào trie
insert(root, word):
    node <- root
    for each ký_tự c trong word:
        if c không trong node.children:
            node.children[c] <- TrieNode mới
        node <- node.children[c]
    node.isEnd <- true              -- đánh dấu cuối từ

Time: O(L)  Space: O(L) cho các node mới trên path
-- Tìm kiếm chính xác từ trong trie
search(root, word):
    node <- walk(root, word)
    -- phải đến được node VÀ node đó phải là điểm kết thúc từ
    return node != null và node.isEnd = true

Time: O(L)  Space: O(1)
-- Kiểm tra prefix có tồn tại không
startsWith(root, prefix):
    -- chỉ cần đến được node prefix -- không cần kiểm tra isEnd
    return walk(root, prefix) != null

Time: O(L)  Space: O(1)
-- Đi xuống trie theo từng ký tự của s
-- Trả về node đến được, hoặc null nếu path không tồn tại
walk(root, s):
    node <- root
    for each ký_tự c trong s:
        if c không trong node.children:
            return null
        node <- node.children[c]
    return node
Sơ đồ trie sau khi insert ["car", "cart", "cat", "can", "dog"]:
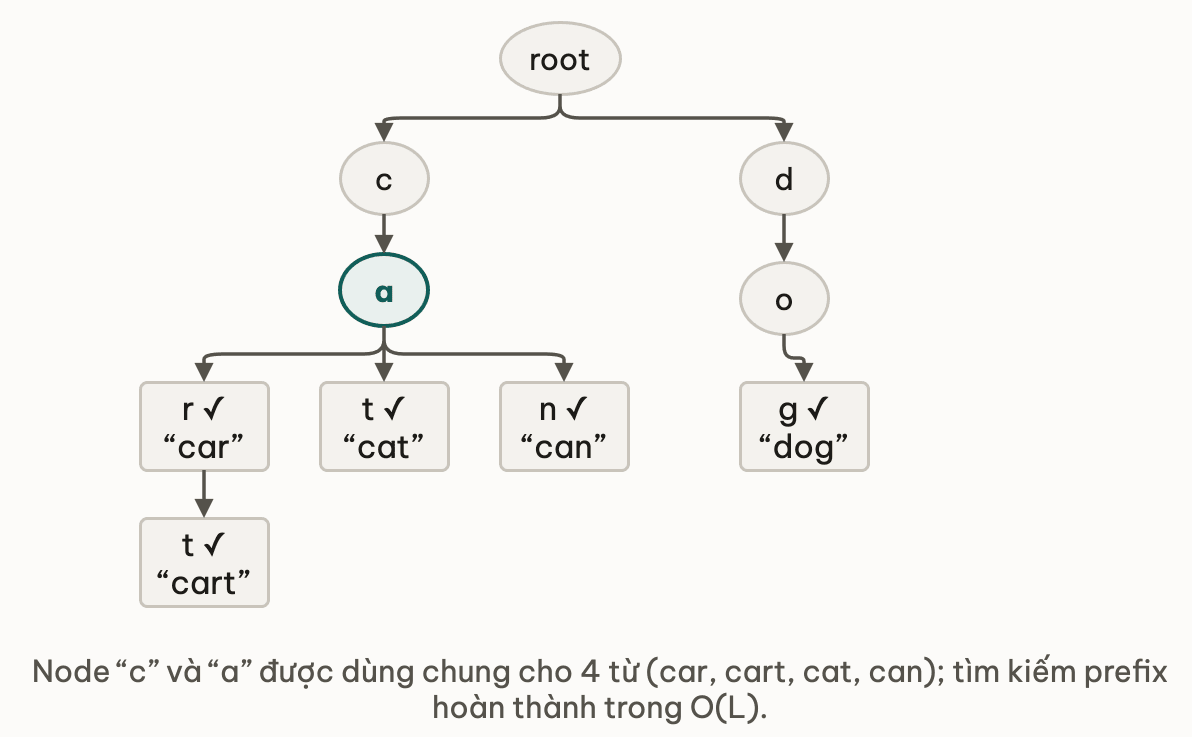
Node "c" và "a" được "car", "cart", "cat", "can" dùng chung. Đây là lợi thế bộ nhớ của trie: prefix chung chỉ lưu một lần.
4. Độ phức tạp
| Thao tác | Time | Space |
|---|---|---|
| Insert | O(L) — L là độ dài từ | O(L) cho các node mới trên path |
| Search | O(L) | — |
| startsWith | O(L) | — |
| Delete | O(L), đặt isEnd = false, dọn node thừa là tuỳ chọn | — |
| Liệt kê tất cả từ có prefix | O(L + số node của subtree dưới prefix) | — |
Điểm quan trọng nhất: độ phức tạp thời gian hoàn toàn không phụ thuộc n (số từ đã insert). Dù trie có 10 hay 10 triệu từ, search "cart" cũng chỉ đi qua đúng 4 node. Với prefix query, HashMap và TreeMap không sánh được điểm này.
Chi phí bộ nhớ: worst case O(N × L) với N là số từ và L là độ dài trung bình, khi không có prefix nào chung. Với từ điển thực tế (nhiều prefix chung) thì tiết kiệm hơn hẳn. Trường hợp tệ nhất cho trie là nhiều từ ngắn không giống nhau chút nào.
Thử ngẫmthời gian của trie không phụ thuộc n, nhưng bộ nhớ vẫn O(N × L) ở worst case. Một tập toàn UUID ngẫu nhiên, không chung prefix, có được lợi gì từ trie so với HashMap không?
5. Memory optimization, Patricia / Radix tree
Trie cơ bản có một điểm yếu: những chuỗi node chỉ có một con (single-child chain) rất lãng phí. Hãy xem trie của ["interest", "interesting", "internal"]:
root
└── i
    └── n
        └── t
            └── e
                └── r               <- chain không có nhánh: i-n-t-e-r
                    ├── e
                    │   └── s
                    │       └── t [isEnd]  ("interest")
                    │           └── i
                    │               └── n
                    │                   └── g [isEnd]  ("interesting")
                    └── n
                        └── a
                            └── l [isEnd]  ("internal")
Chuỗi i→n→t→e→r không rẽ nhánh nào, 5 node chỉ để lưu prefix "inter". Patricia tree (còn gọi là Radix tree) nén chuỗi này thành một cạnh duy nhất có nhãn "inter":
root
└── "inter"
    ├── "est" [isEnd]   ("interest")
    │   └── "ing" [isEnd]  ("interesting")
    └── "nal" [isEnd]   ("internal")
Thay vì 14 node, chỉ cần 4 node (không tính root) cộng các nhãn trên cạnh. Lookup vẫn O(L) nhưng phức tạp hơn: khi đi theo một cạnh, phải so phần đầu của chuỗi tìm kiếm với nhãn của cạnh, và xử lý trường hợp khớp một phần (partial match) để biết nên rẽ tiếp hay dừng.
Trie nén được dùng ở: bảng định tuyến IP (BSD dùng radix/Patricia tree, Linux dùng biến thể LC-trie) để tìm prefix khớp dài nhất, Redis (thư viện rax cho Streams), và state của Ethereum (Merkle Patricia trie).
Thử ngẫmPatricia tree nén 14 node xuống còn 4 cho ba từ "interest/interesting/internal". Với một bộ từ toàn từ ngắn 2-3 ký tự, không chung prefix, phép nén này còn tiết kiệm được gì không?
6. Bài kinh điển, Top-K Autocomplete
Khi làm ô tìm kiếm, bạn không chỉ cần khớp prefix mà còn phải trả về K từ phổ biến nhất theo prefix đó.
Cách 1: tính sẵn top-K ở mỗi node:
Mỗi node lưu sẵn danh sách K từ phổ biến nhất trong subtree của nó. Khi insert một từ kèm tần suất (frequency), cập nhật danh sách top-K dọc đường từ root xuống node cuối.
AutocompleteNode:
    children: Map<ký_tự, AutocompleteNode>
    isEnd: boolean
    topK: List<String>   -- K từ phổ biến nhất có thể đến được từ node này
- Lookup: O(L), đi xuống node prefix rồi trả về ngay
node.topK. - Insert: O(L × K), cập nhật top-K tại mỗi node trên đường đi (L node, mỗi node sắp xếp K phần tử).
- Đánh đổi: query nhanh, nhưng insert chậm hơn và tốn bộ nhớ (mỗi node lưu K chuỗi).
Cách 2: DFS lúc query + heap:
Chỉ lưu tần suất tại node kết thúc từ (isEnd = true). Khi query, DFS toàn bộ subtree từ node prefix, dùng min-heap cỡ K để giữ top-K. Hàm dfsCollect tự gọi lại chính nó trên từng node con; nếu kiểu đệ quy này còn lạ, ôn lại ở Hàm.
topKWithPrefix(root, prefix, k):
    node <- walk(root, prefix)
    if node = null: return []

    heap <- MinHeap(capacity=k, key=frequency)  -- loại phần tử có freq thấp nhất khi đầy
    dfsCollect(node, heap, k)
    return heap.toList()

Time: O(L + matches × log K)  Space: O(k)
- Lookup: O(L + matches × log K), DFS qua subtree.
- Insert: O(L), đơn giản hơn cách 1.
- Đánh đổi: query chậm hơn khi subtree lớn, nhưng insert và bộ nhớ nhẹ hơn.
Chọn cách nào? Cách 1 hợp khi query rất nhiều và bộ từ vựng ít đổi (autocomplete của search engine). Cách 2 hợp khi bộ từ vựng thay đổi thường xuyên hoặc K lớn.
Thử ngẫmcách 1 tốn O(L×K) mỗi insert để cập nhật top-K toàn đường đi; cách 2 chỉ tốn O(L). Một search engine có lượng đọc gấp 1000 lần lượng ghi nên nghiêng về cách nào?
7. Các bẫy thường gặp
Bẫy 1: Unicode alphabet và mảng cố định kích thước
Mảng 26 phần tử chỉ an toàn cho input ASCII a-z. Với Unicode (tiếng Việt, tiếng Nhật, emoji), riêng BMP đã có tới 65.536 code point (và emoji nằm ngoài BMP, nên khoá của map nên là code point chứ không phải một char UTF-16):
-- SAI: nổ khi gặp ký tự ngoài a-z (Latin có dấu, CJK, emoji)
TrieNode:
    children: mảng[26]    -- chỉ dành cho a-z!
    isEnd: boolean

-- ĐÚNG: xử lý được mọi ký tự Unicode
TrieNode:
    children: HashMap<ký_tự, TrieNode>
    isEnd: boolean
Mảng 65.536 phần tử mỗi node là 65.536 pointer × 8 byte = 512KB mỗi node. Với trie 10.000 node, riêng mảng children đã tốn 5GB, không dùng nổi.
Bẫy 2: Quên kiểm tra isEnd
Trie chứa ["car", "card"]: khi search "car", walk("car") trả về node "r" khác null, nhưng chưa chắc "car" là từ hợp lệ nếu không kiểm tra isEnd.
-- SAI: trả về true dù "car" chưa từng được insert
search(root, word):
    return walk(root, word) != null    -- chỉ kiểm tra path tồn tại!

-- ĐÚNG: phải kiểm tra cả isEnd
search(root, word):
    node <- walk(root, word)
    return node != null và node.isEnd = true
Trie chứa ["card"]: walk("car") trả về node "r" với isEnd = false. Đây chỉ là "điểm trung gian" trên đường tới "card", không phải một từ riêng. Chỉ có node.isEnd mới phân biệt được hai trường hợp.
Bẫy 3: Delete leak (memory rò rỉ)
Nếu delete chỉ đặt isEnd = false, các node không còn dùng trên nhánh đó vẫn nằm lại trong bộ nhớ:
-- CHƯA ĐẦY ĐỦ: node rỗng bị rò rỉ
delete(root, word):
    node <- walk(root, word)
    if node != null:
        node.isEnd <- false    -- node và các node cha vẫn còn trong bộ nhớ!
Cách xử lý đúng: sau khi đặt isEnd = false, dọn từ dưới lên bằng cách xoá các node không còn children và không phải isEnd. Cần thêm đệ quy hoặc stack, phức tạp hơn và chỉ đáng làm khi delete thường xuyên. Với nhiều ứng dụng (search index chủ yếu để đọc), bỏ qua bước dọn cũng chấp nhận được.
8. Ứng dụng trong các hệ thống thực tế
IP routing (longest prefix match): gói tin tới với IP đích, router cần route khớp prefix dài nhất (192.168.1.0/24 cụ thể hơn 192.168.0.0/16). Hash table không hỗ trợ prefix query. Trie theo từng bit của địa chỉ (BSD dùng Patricia/radix tree, Linux dùng LC-trie trong net/ipv4/fib_trie.c) tốn tối đa 32 bước cho IPv4, 128 cho IPv6, không phụ thuộc kích thước bảng định tuyến.
Aho-Corasick (bài riêng ở khoá Thuật toán ứng dụng) dựng trie từ tất cả pattern, thêm "fail link" (như failure function của KMP) để tìm nhiều pattern cùng lúc trong O(text_length + matches). Ý tưởng này nằm sau việc tìm nhiều chuỗi cố định của các công cụ như grep -F và các bộ quét như ClamAV.
Spell checker / autocorrect có thể duyệt trie cùng một máy trạng thái theo dõi edit distance (số phép sửa tối thiểu), chỉ đi vào nhánh còn nằm trong ngưỡng, thay vì tính edit distance với từng từ trong từ điển (O(n × L)). Lucene dùng Levenshtein automaton cho fuzzy query theo hướng này.
Search suggest box thường dựng trên tập query hàng đầu bằng trie hoặc cấu trúc tương tự: mỗi lần gõ phím là một lần đi theo prefix rồi liệt kê subtree.
9. Đào sâu
- The Art of Computer Programming (Knuth), Vol. 3, Section 6.3: Digital Searching, phân tích gốc về trie.
- Morrison (1968), "PATRICIA, Practical Algorithm To Retrieve Information Coded In Alphanumeric": bài báo gốc của Patricia tree.
- Aho & Corasick (1975), "Efficient String Matching: An Aid to Bibliographic Search": tìm nhiều pattern qua trie cộng fail link.
- Linux
net/ipv4/fib_trie.c: LC-trie cho bảng định tuyến IPv4.
Bài liên quan trong khoá học:
- Mini-challenge Trie Autocomplete: ứng dụng gợi ý từ khoá.
- Aho-Corasick: ghép Trie với KMP để tìm kiếm đa mẫu.
10. Tóm tắt
Checklist khi dùng trie:
- Chọn cách lưu children theo alphabet: mảng
[26]cho chữ thường,HashMapcho Unicode. - Nhớ
isEndđể phân biệt "chỉ đi ngang qua" với "từ kết thúc ở đây", và khi xoá thì dọn node thừa để khỏi rò bộ nhớ. - Bộ nhớ là điểm yếu (tệ nhất O(N × L)); nén bằng Patricia/radix tree khi có nhiều chuỗi node chỉ một nhánh.
- Top-K autocomplete: nếu đọc nhiều hơn ghi thì lưu sẵn top-K ở mỗi node, còn không thì DFS kèm heap.
- Trie còn xuất hiện ở IP longest prefix match, DNS, spell checker và Aho-Corasick.
11. Tự kiểm tra
- Q1Search trong trie là O(L), không phụ thuộc n, vì sao? HashMap search O(1) cũng không phụ thuộc n, vậy sao trie lại tốt hơn cho prefix query?
- Q2Nên chọn HashMap hay mảng [26] làm children cho trie xử lý tên sản phẩm tiếng Việt?
- Q3Patricia/Radix tree giải quyết vấn đề gì của trie cơ bản? Đánh đổi là gì?
- Q4Trie chứa các từ ["a", "ab", "abc"]. Gọi search("ab") thì walk trả về node nào? isEnd ở node đó là gì? Kết quả ra sao?
- Q5Bộ nhớ của trie tệ nhất ở trường hợp nào? Tốt nhất ở trường hợp nào?
- Q6IP routing dùng trie nén (Patricia, LC-trie), vì sao tốt hơn hash table cho longest prefix match (tìm prefix khớp dài nhất)?
Bài tiếp theo: Bloom filter, probabilistic, false positive math
B-tree & B+tree — Disk fanout, vì sao DB không dùng AVL/RB
Bài tiếpBloom filter — Probabilistic membership, tiết kiệm RAM
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này