Case Study: MySQL InnoDB B+tree index + Redis dict incremental rehash
MySQL và Redis cùng giải bài tìm key nhanh nhưng chọn cấu trúc khác nhau. InnoDB B+tree clustered index và Redis incremental rehash — lý do thiết kế.
TL;DR: MySQL InnoDB chọn B+tree vì dữ liệu nằm trên disk và cần range query: leaf chain cho phép quét khoảng tuần tự O(k), fanout 1000 kéo height xuống 3–4 cho 100 triệu row. Redis chọn hash table vì dữ liệu nằm trong RAM và chỉ cần point query O(1), nhưng phải giải bài toán resize mà không chặn các command khác trên event loop đơn luồng (single-threaded). Redis dùng incremental rehash: giữ 2 hash table cùng lúc, mỗi command chuyển thêm một ít bucket sang bảng mới, thay vì chặn cỡ vài trăm ms để chuyển 1 triệu entry một lượt. Cùng bài toán "tìm key nhanh" nhưng ràng buộc khác nhau nên cấu trúc tối ưu hoàn toàn khác nhau.
Các bài trước trong module đã đi qua hash table (bài 01 và 03), self-balancing tree (bài 06), và B+tree (bài 07). Tất cả đều giải cùng một vấn đề cốt lõi: tìm key trong tập dữ liệu lớn nhanh nhất có thể.
Vậy vì sao MySQL InnoDB, một trong những database được dùng nhiều nhất, chọn B+tree cho index lưu trên disk, còn Redis, key-value store trong RAM rất phổ biến, chọn hash table với incremental rehash? Câu trả lời không nằm ở chuyện thuật toán nào tốt hơn, mà ở workload khác nhau: MySQL sống trên disk và cần range query; Redis sống trong RAM và chỉ cần point query.
Bài này đi sâu vào clustered index B+tree của InnoDB và incremental rehash với 2 bảng của Redis dict, để thấy vì sao mỗi quyết định đúng trong hoàn cảnh của nó.
1. Thông tin dự án A: MySQL InnoDB
Project: MySQL InnoDB (storage engine mặc định từ MySQL 5.5+)
Version: MySQL 8.0 (đã hoặc sắp hết vòng đời hỗ trợ khi bài này được cập nhật; hành vi dưới đây dùng chung cho 8.4 LTS)
Source: https://github.com/mysql/mysql-server/tree/8.0/storage/innobase/btr/
License: GPL v2
InnoDB là storage engine mặc định của MySQL từ phiên bản 5.5. Trước đó là MyISAM, không có transaction, không có row-level lock, và index chỉ là pointer trỏ đến heap. InnoDB thay MyISAM với ACID transaction, row-level locking và clustered index, thiết kế quan trọng nhất mà bài này sẽ phân tích.
2. InnoDB B+tree clustered index, không phải pointer thông thường
Bài 07 đã giải thích B+tree: internal node chứa key để điều hướng, leaf node chứa dữ liệu. Nhưng InnoDB làm một điều khác căn bản so với hầu hết bản cài đặt khác: clustered index.
2.1 Clustered vs non-clustered
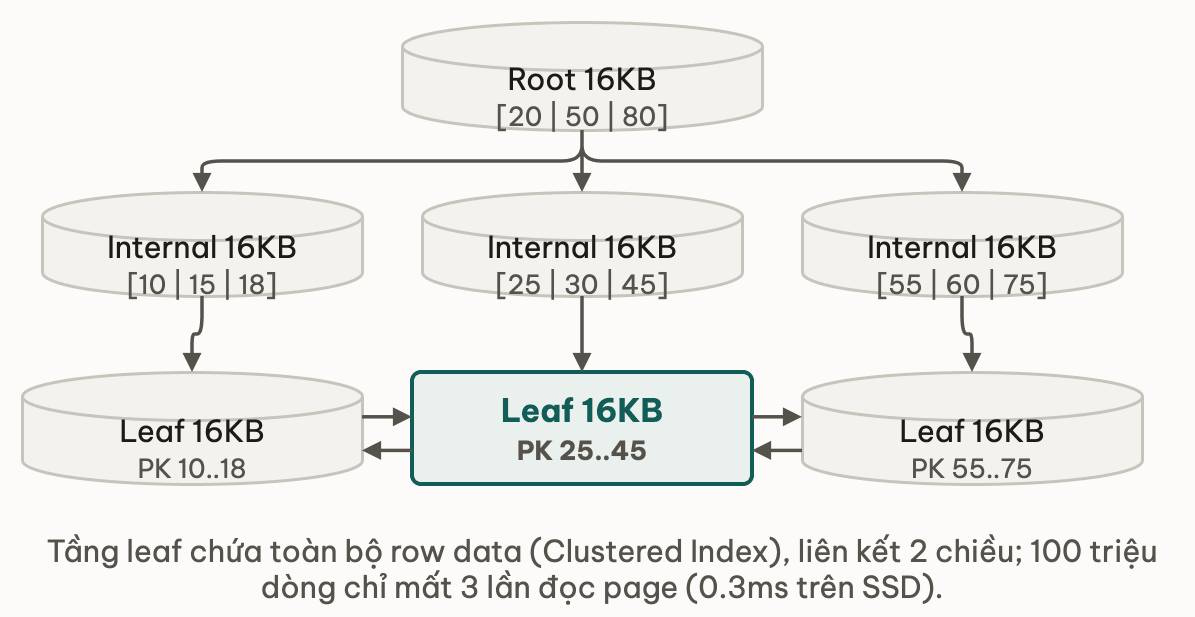
Clustered index (index primary key của InnoDB): leaf node chứa toàn bộ dữ liệu của dòng, không phải pointer trỏ đến dòng mà là chính dòng đó. Query theo primary key chỉ cần đi xuống cây một lần, lấy luôn dữ liệu tại leaf.
Secondary index (index không phải primary key của InnoDB): leaf node chứa giá trị primary key, không phải dữ liệu dòng, cũng không phải pointer vật lý. Query theo secondary index cần hai bước: (1) đi xuống B+tree của secondary index để tìm giá trị primary key, (2) đi lại B+tree của primary key để lấy dòng. Đây là double lookup.
InnoDB Clustered Index (PRIMARY KEY):

                     [20 | 50 | 80]          -- internal node
                    /    |    |    \
          [10|15|18] [25|30|45] [55|60|75] [85|90|95]  -- leaf node
          [row data] [row data] [row data]  [row data]  -- ca dong nam o day!

InnoDB Secondary Index (INDEX trên cột email):

                   [[email protected] | [email protected]]      -- internal node
                  /          |          \
        [a@...|b@...]   [c@...|m@...]   [n@...|z@...]  -- leaf node
        [pk=5 | pk=12]  [pk=3 | pk=22]  [pk=8 | pk=30] -- chi chua primary key

Secondary index lookup:
  Bước 1: duyệt secondary tree -> tìm pk=12
  Bước 2: duyệt primary tree   -> fetch full row tại pk=12
Hệ quả quan trọng: thứ tự của primary key mang tính chiến lược. Nếu primary key tăng đơn điệu (AUTO_INCREMENT kiểu số nguyên), insert luôn rơi vào cuối leaf node cuối cùng nên page split rất ít. Nếu primary key ngẫu nhiên (UUID v4), mỗi insert rơi vào một vị trí ngẫu nhiên trong cây, page split xảy ra khắp nơi và độ phân mảnh (fragmentation) tích tụ dần.
2.2 Fanout và height
Page của InnoDB mặc định là 16KB. Với primary key kiểu số nguyên (8 byte), một internal node chứa được cỡ 1000 key. Tầng leaf thì chứa dòng dữ liệu, nên số dòng mỗi leaf tuỳ kích thước dòng. Với dòng cỡ 100 byte (khoảng 150 dòng mỗi leaf):
Fanout ≈ 1000 (xấp xỉ cho int PK, page 16KB); ~150 dòng mỗi leaf

Height 1 (root là leaf):  ~150 dòng
Height 2: 1.000 × 150           = 150.000 dòng
Height 3: 1.000 × 1.000 × 150   = 150.000.000 dòng
Height 4: 1.000^3 × 150         = 150 tỷ dòng

Cho 100 triệu dòng: 100.000.000 / 150 ≈ 670.000 leaf page
  log_1000(670.000) ≈ 1,94 -> cần 2 tầng internal phía trên leaf
  => Height 3 (root, 1 tầng internal, leaf) -> 3 lần đọc page để lấy 1 dòng qua primary key.
Dòng to hơn thì tầng leaf chứa ít dòng hơn nên cây cao hơn: dòng 1KB (cỡ 15 dòng mỗi leaf) thì height 3 chỉ chứa cỡ 15 triệu dòng, 100 triệu dòng cần height 4.
Ba lần đọc trên SSD (mỗi lần cỡ 0,1ms) là cỡ 0,3ms. Buffer pool cache sẵn các internal node hay được truy cập, nên thực tế thường chỉ còn 1–2 lần đọc đĩa sau khi cache đã "nóng" (warm cache).
3. InnoDB page structure, B+tree trên disk
InnoDB không đọc/ghi từng byte, đơn vị làm việc là page 16KB. Mỗi page là một node trong B+tree.
InnoDB Page (16KB):
+------------------+
|  Page Header     |  file header 38 byte (page number, prev/next sibling) + page header (level, số record)
|  (infimum rec)   |  pseudo-record: lower bound sentinel
|  (supremum rec)  |  pseudo-record: upper bound sentinel
+------------------+
|                  |
|   User Records   |  actual key-value pair, sắp xếp tăng dần
|                  |
+------------------+
|   Free Space     |  khoảng trống ở giữa, bị thu hẹp dần khi thêm record
+------------------+
|  Page Directory  |  sparse index: pointer đến mỗi 4-8 record
|  (slot array)    |  để binary search trong page
+------------------+
|  File Trailer    |  checksum để phát hiện corruption
+------------------+
Page directory là một sparse index (index thưa) nằm trong page: thay vì duyệt tuần tự 500 record trong page, InnoDB dùng page directory để binary search xuống còn 4–8 record rồi mới quét tuần tự. Tổng cộng: binary search qua các page (tốn disk IO) cộng binary search trong page (trong RAM).
Buffer pool cache các page trong RAM. Với server chuyên dụng cho database, người ta thường đặt innodb_buffer_pool_size ở khoảng 50 đến 75% RAM (tài liệu MySQL gợi ý tới 80% cho máy chuyên dụng). Server 64GB RAM thì buffer pool cỡ 40 đến 45GB, cache được hàng triệu page, đưa disk IO về gần 0 cho phần dữ liệu hay dùng (working set).
Đoạn pseudocode sau mô phỏng logic trong btr/btr0sea.cc, phần adaptive hash search của InnoDB:
-- InnoDB adaptive hash search (don gian hoa tu btr0sea.cc)
-- Tinh so field can cho hash search dua tren thong tin hash hien tai.
btr_search_get_n_fields(n_fields, n_bytes):
    return n_fields + (if n_bytes > 0 then 1 else 0)
4. Production gotcha MySQL
4.1 Composite index, thứ tự column quan trọng
INDEX(a, b) là B+tree sắp xếp theo (a, b). Query WHERE a = 1 AND b = 2 dùng được index. Query WHERE b = 2 thì không, vì thiếu prefix a nên không dùng được leftmost prefix (cột ngoài cùng bên trái) của index.
-- Bang: orders(id, customer_id, status, created_at)
-- Index: INDEX idx_cust_status (customer_id, status)

-- Dung duoc index (ca hai column, leftmost prefix)
SELECT * FROM orders WHERE customer_id = 42 AND status = 'pending';

-- Dung duoc index (chi leftmost prefix)
SELECT * FROM orders WHERE customer_id = 42;

-- KHONG dung duoc index (bo qua leftmost column)
SELECT * FROM orders WHERE status = 'pending';
Cột đặt ở đầu nên là cột hay xuất hiện trong WHERE với so sánh bằng; selectivity cao (nhiều giá trị khác nhau) là một tiêu chí, nhưng pattern truy vấn thật mới quyết định. Một số bản MySQL 8.0 mới (từ 8.0.13) có skip scan cho vài trường hợp thiếu leftmost prefix, nhưng đừng dựa vào đó.
4.2 Low cardinality column, index vô dụng
INDEX(gender) với 3 giá trị khác nhau (M, F, X) trên bảng 10 triệu dòng: mỗi giá trị trỏ đến khoảng 3 triệu dòng. Query optimizer của MySQL thấy quét toàn bộ bảng còn rẻ hơn dùng index, vì khi phải lấy nhiều dòng thì đọc liền mạch trên heap tốt hơn tra B+tree ngẫu nhiên.
4.3 InnoDB Adaptive Hash Index
InnoDB tự xây một hash index trên các page được truy cập thường xuyên, biến point query O(log n) thành O(1) khi kiểu truy cập đủ đều. Mức tăng tốc tuỳ workload và giá trị mặc định của innodb_adaptive_hash_index tuỳ phiên bản MySQL; khi kiểu truy cập không đều hoặc nhiều core tranh chấp latch, chi phí duy trì nó có thể lớn hơn lợi ích. Hãy đo rồi quyết định bật hay tắt.
4.4 UUID v4 PK và page split storm
UUID v4 là số ngẫu nhiên 128-bit. Dùng UUID v4 làm primary key thì mỗi insert rơi vào vị trí ngẫu nhiên trong B+tree, và page split xảy ra khắp nơi.
AUTO_INCREMENT insert (tuần tự):
  [1][2][3][4][5]...[N] -> luôn append vào leaf cuối -> split tối thiểu

UUID v4 insert (ngẫu nhiên):
  [7f3b...][2a1c...][8e4d...] -> vị trí ngẫu nhiên -> split thường xuyên giữa page
  Mỗi split: InnoDB cấp phát page mới, chuyển nửa số record sang -> tốn kém
  Sau 1M insert: cây bị phân mảnh, nhiều page chỉ đầy một nửa, lãng phí không gian
Cách xử lý: dùng UUID v7 (RFC 9562, bắt đầu bằng timestamp tăng dần) hoặc AUTO_INCREMENT BIGINT. UUID v7 mở đầu bằng timestamp mili giây nên insert gần như tuần tự, giảm hẳn số lần split.
Thử ngẫmUUID v4 làm PK khiến split rải khắp cây; UUID v7 gần như tuần tự nên gom split về cuối leaf chain. Nếu nhiều thread cùng insert UUID v7 song song, thứ tự gần như tuần tự đó còn giữ được không?
5. Thông tin dự án B: Redis dict
Project: Redis (in-memory data structure store)
Version: Redis 7.0+
Source: https://github.com/redis/redis/blob/7.4/src/dict.c
License: RSALv2/SSPL (Redis 7.4 đến 7.x), BSD-3 (phiên bản cũ hơn); từ Redis 8 có thêm tuỳ chọn AGPLv3
Redis là key-value store trong RAM, vòng lặp xử lý command chính chạy trên một thread duy nhất (single-threaded). Mọi GET, SET, DEL đều thực thi trên thread đó (từ Redis 6 có thêm I/O thread cho đọc/ghi socket, nhưng việc thực thi command vẫn đơn luồng). Đây là quyết định thiết kế có chủ ý để khỏi tốn chi phí lock và đảm bảo atomicity. Hệ quả: bất kỳ thao tác nào chiếm thread chính đều làm cả Redis đứng lại.
6. Redis dict structure, 2-table design
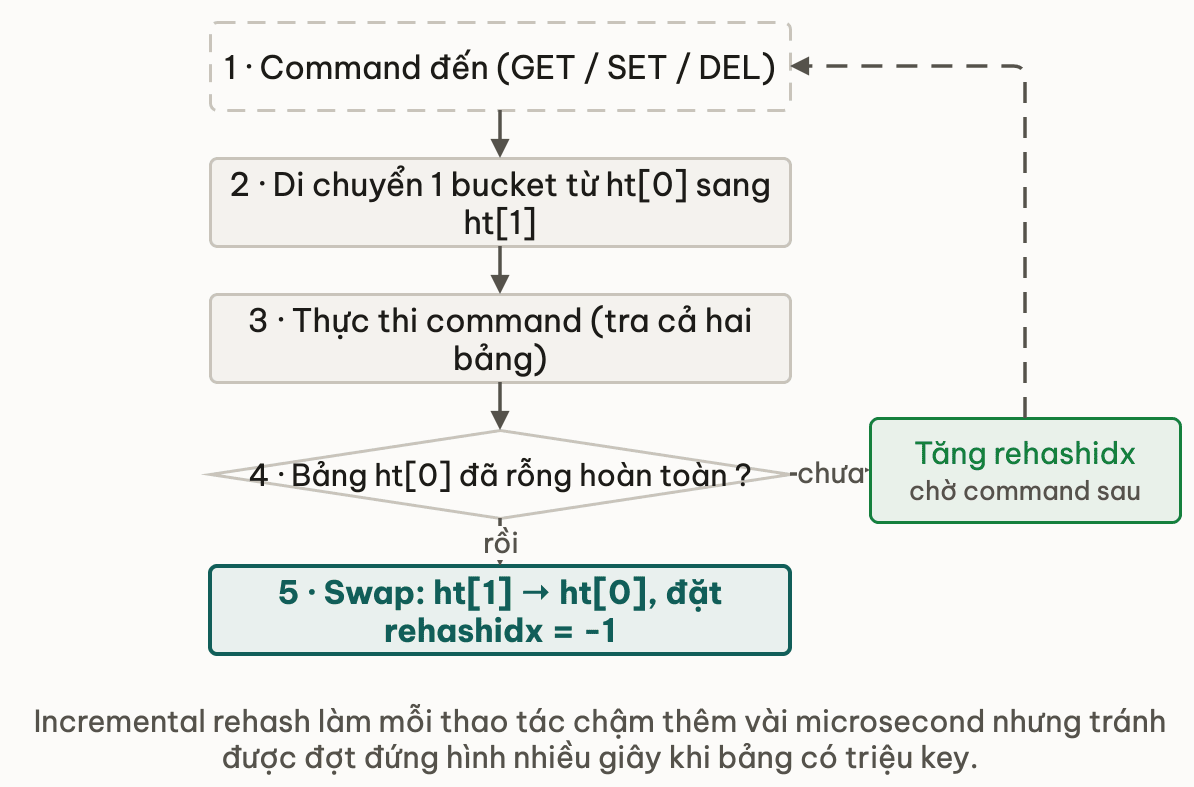
Redis dict không phải một hash table đơn giản. Nó có hai hash table ht[0] và ht[1] để phục vụ incremental rehash:
-- Cau truc dict (don gian hoa tu Redis src/dict.h)
dict:
    type: dictType
    ht_table[2]: mảng hai hash table
    ht_used[2]: số entry trong mỗi table
    rehashidx: long                     -- -1 neu khong rehash, nguoc lai la bucket tiep theo can chuyen
Trạng thái ổn định: chỉ ht[0] hoạt động, ht[1] là null. rehashidx = -1.
Khi cần resize (số entry chạm số bucket, tức load factor khoảng 1; hoặc bảng thưa quá mức thì thu nhỏ): ht[1] được cấp phát với capacity mới (nở thì thường gấp đôi), rehashidx = 0, và incremental rehash bắt đầu. Lúc có tiến trình con đang fork để lưu RDB/AOF, Redis nâng ngưỡng nở lên cao hơn để tránh copy-on-write tốn bộ nhớ.
rehashidx là bộ đếm tiến độ: chỉ bucket tiếp theo cần chuyển từ ht[0] sang ht[1]. Redis không chuyển một lượt mà chuyển dần, mỗi lần vài bucket.
Redis dict -- trang thai on dinh:

  ht[0]: [bucket_0] -> [entry: "user:1" -> "Alice"]
         [bucket_1] -> [entry: "product:5" -> "Laptop"] -> [entry: "product:9" -> "Phone"]
         [bucket_2] -> null
         ...
  ht[1]: null
  rehashidx: -1

Redis dict -- trong qua trinh rehash (ht[0] size 4 -> ht[1] size 8):

  ht[0]: [bucket_0] -> null  (đã chuyển)
         [bucket_1] -> null  (đã chuyển)
         [bucket_2] -> [entry: "foo" -> "bar"]    <- chưa chuyển
         [bucket_3] -> [entry: "baz" -> "qux"]    <- chưa chuyển
  ht[1]: [bucket_0] -> [entry: "user:1" -> "Alice"]   <- đã chuyển
         [bucket_1] -> [entry: "product:5" -> "Laptop"]
         ... 8 bucket tổng...
  rehashidx: 2   <- bucket tiếp theo cần chuyển
7. Vì sao Redis cần incremental rehash
Vòng lặp command của Redis chạy đơn luồng. Nếu resize hash table theo cách thông thường (rehash chặn hết mọi việc):
Thời gian    Sự kiện
t=0          SET command đến
t=0.001      kích hoạt resize: cấp phát bảng mới, bắt đầu chuyển 1M entry
t=0.001      ... đang chuyển ... đang chuyển ... (cỡ vài trăm ms bị chặn)
t=0.500      toàn bộ 1M entry đã chuyển xong, resize xong
t=0.500      command tiếp theo được xử lý (trễ cỡ nửa giây)
Đứng hình cỡ nửa giây trên một Redis instance production kéo theo:
- Client timeout (nhiều hệ thống đặt vài trăm ms), lỗi lan thành chuỗi
- Replication lag, replica bị lệch so với master
- Cảnh báo monitoring dồn dập
- Toàn bộ throughput về 0 trong khoảng thời gian đó
Cách giải: incremental rehash. Chia 1 lần chuyển 1M entry thành rất nhiều bước nhỏ: mỗi thao tác trên dict (GET, SET...) chuyển thêm 1 bucket, và hàm chạy nền định kỳ của Redis (serverCron) chuyển thêm trong khoảng 1ms mỗi lượt. Mỗi command chỉ chậm thêm chút ít, không có lần nào đứng hình.
-- Incremental rehash (don gian hoa tu Redis src/dict.c -- dictRehash())
-- Lam n buoc rehash tang dan.
-- Tra ve 1 neu con dang rehash, 0 neu xong.
dictRehash(d, n):
    empty_visits <- n * 10    -- so bucket rong toi da duoc phep di qua

    if d không đang rehash: return 0

    while n > 0 và d.ht_used[0] != 0:
        -- bo qua bucket rong, nhung gioi han so lan lap
        while d.ht_table[0][d.rehashidx] = null:
            d.rehashidx <- d.rehashidx + 1
            empty_visits <- empty_visits - 1
            if empty_visits = 0: return 1

        -- chuyen toan bo entry trong bucket hien tai
        de <- d.ht_table[0][d.rehashidx]
        while de != null:
            nextde <- de.next
            -- tinh lai hash theo kich thuoc table moi
            h <- hash(de.key) mod d.ht_size[1]
            de.next <- d.ht_table[1][h]
            d.ht_table[1][h] <- de
            d.ht_used[0] <- d.ht_used[0] - 1
            d.ht_used[1] <- d.ht_used[1] + 1
            de <- nextde

        d.ht_table[0][d.rehashidx] <- null
        d.rehashidx <- d.rehashidx + 1
        n <- n - 1

    -- kiem tra rehash xong chua
    if d.ht_used[0] = 0:
        -- hoan doi: ht[1] thanh ht[0], reset ht[1]
        free(d.ht_table[0])
        d.ht_table[0] <- d.ht_table[1]
        d.ht_used[0] <- d.ht_used[1]
        d.ht_table[1] <- null
        d.ht_used[1] <- 0
        d.rehashidx <- -1
        return 0
    return 1

Time mỗi bước: O(bucket_size)  Space: O(1) cho mỗi bước
Khi đang rehash, lookup phải xét cả 2 table: dict GET tìm trong ht[0] trước, không thấy thì tìm tiếp trong ht[1]. Nhờ vậy không bỏ sót cả key đã chuyển sang ht[1] lẫn key chưa chuyển còn ở ht[0].
-- GET khi dang rehash: xet ca hai table
dictFind(d, key):
    if d rỗng: return null
    if d đang rehash: làm 1 bước rehash    -- moi lan truy cap gop 1 buoc

    for table <- 0 đến 1:
        h <- hash(key) mod d.ht_size[table]
        he <- d.ht_table[table][h]
        while he != null:
            if he.key = key: return he
            he <- he.next
        if d không đang rehash: break    -- khong rehash thi chi can xet ht[0]
    return null

Time: O(1) amortized  Space: O(1)
Thử ngẫmincremental rehash làm mỗi command chậm thêm chút ít để tránh một đợt đứng hình dài. Đánh đổi này có còn đáng khi tốc độ command cực cao (triệu request/giây)?
8. Bảng so sánh quyết định MySQL vs Redis
| Khía cạnh | MySQL InnoDB | Redis dict |
|---|---|---|
| Nơi lưu | Disk + buffer pool (RAM cache) | Chỉ RAM |
| Workload | Lẫn lộn: point query + range query | Chỉ point query (không có range) |
| Cấu trúc chọn | B+tree (page 16KB, leaf chain) | Hash table + chaining |
| Lý do chọn | Range scan qua leaf linked list; fanout cao để ít IO nhất | O(1) point query; không cần range |
| Mối lo về chi phí resize | Thấp (ALTER TABLE online hoặc dựng lại offline) | Cao (đơn luồng: chặn là đứng hình hoàn toàn) |
| Cách resize | Dựng lại một lượt | Incremental rehash (N bước mỗi thao tác) |
| Thứ tự key | Có thứ tự (tính chất của B+tree) | Không có thứ tự (hash table) |
| Mô hình bộ nhớ | Trên disk, đệm theo page | Trong RAM, truy cập qua pointer trực tiếp |
Điều cốt lõi: cùng bài toán "tìm key" nhưng ràng buộc hoàn toàn khác. InnoDB sống trên disk nên giảm disk IO là ưu tiên, dẫn đến B+tree fanout 1000 cùng leaf chain cho range scan. Redis chạy đơn luồng trong RAM nên resize chặn thread là điều không thể chấp nhận, dẫn đến hash table O(1) cộng incremental rehash để khỏi đứng hình.
9. Production gotcha Redis
9.1 Big key và rehash stall trên RDB save
Big key (ví dụ một Hash có 10 triệu field) làm các lệnh O(N) như HGETALL chiếm thread chính lâu, và DEL một big key cũng chặn thread chính trong lúc giải phóng bộ nhớ: dùng UNLINK (Redis 4.0+) để giải phóng ở thread nền. Dict bên trong của một big key khi nở gấp đôi cũng phải cấp phát một mảng bucket lớn, đúng kiểu stall mà incremental rehash sinh ra để tránh, chỉ là chưa tránh hết được phần cấp phát.
Hãy theo dõi kích thước key định kỳ:
# Scan for big keys
redis-cli --bigkeys

# Or inspect a specific key
redis-cli OBJECT ENCODING mykey
redis-cli HLEN myhashkey   # number of fields in the Hash
Nếu Hash key vượt vài triệu field, hãy chia thành nhiều key nhỏ: user:1000:profile, user:1000:settings, ... thay vì một key user:1000 chứa tất cả.
9.2 SLOWLOG để bắt các thao tác chậm
Redis SLOWLOG ghi lại các command chạy lâu hơn một ngưỡng (mặc định 10ms):
# Threshold 10ms (value in microseconds)
redis-cli CONFIG SET slowlog-log-slower-than 10000
redis-cli SLOWLOG GET 10   # last 10 entries
Khi Redis chậm, đừng đoán: đặt giả thuyết (big key? KEYS *? rehash?) rồi dùng SLOWLOG để kiểm từng giả thuyết, đúng cách ở bài Sửa bằng giả thuyết. Các nguyên nhân phổ biến khiến thao tác chậm:
- Big key và việc cấp phát bảng mới lớn: khi dict của một key rất lớn nở ra, việc cấp phát mảng bucket mới có thể gây một khoảng khựng ngắn, dù từng bước rehash sau đó rất nhẹ.
- Thao tác trên big key:
SMEMBERStrên Set 100k member,LRANGE key 0 -1trên List 500k element. KEYS *quét theo pattern: O(N) trên toàn database, không bao giờ dùng ở production, hãy thay bằngSCANvới cursor.
9.3 maxmemory-policy và liên kết sang Module 2
maxmemory-policy của Redis quyết định cách loại bỏ (evict) key khi RAM đầy:
allkeys-lru: loại key lâu rồi chưa được dùng nhất (LRU)allkeys-lfu: loại key được dùng ít lần nhất (LFU)volatile-ttl: loại key có TTL ngắn nhất (sắp hết hạn nhất)
LRU cổ điển dùng một doubly linked list kết hợp dict, như ở mini-challenge LRU cache. Redis không làm đúng vậy: nó dùng LRU xấp xỉ, lấy mẫu vài key (maxmemory-samples, mặc định 5) rồi loại key lâu chưa dùng nhất trong mẫu, vì danh sách chính xác tốn thêm con trỏ cho mỗi key.
Thử ngẫmcả LRU và LFU ở trên đều cần thêm một dấu thời gian hoặc bộ đếm phụ cho mỗi key. Chi phí ghi sổ đó cộng dồn vào command nào, GET, SET hay cả hai?
10. Dùng ở đâu trong thực tế
PostgreSQL, heap + B-tree, khác với InnoDB clustered
PostgreSQL dùng heap storage: các dòng nằm trong heap file chứ không nằm trong leaf của B-tree. B-tree index của PostgreSQL lưu heap tuple ID (TID), tức pointer vật lý (page_number, slot) trỏ đến dòng trong heap.
Hệ quả: mọi index thứ cấp của PostgreSQL đều là non-clustered. Query qua index thường cần thêm một lần đọc heap ngẫu nhiên sau khi lấy TID (trừ index-only scan khi visibility map cho phép), trong khi primary key clustered của InnoDB chỉ cần 1 lượt đi xuống.
PostgreSQL 11+ có thêm INCLUDE index (covering index): lưu thêm các column vào leaf node để khỏi phải đọc heap:
-- PostgreSQL covering index: query dung id + email khong can doc heap
CREATE INDEX idx_user_cover ON users (id) INCLUDE (email, name);
-- Query: SELECT email, name FROM users WHERE id = 42
-- -> duyet B-tree -> toi leaf co san email + name -> xong, khong can doc heap
MongoDB / WiredTiger, document B-tree
MongoDB dùng storage engine WiredTiger, lưu dữ liệu bằng cây kiểu B-tree và khoá ở mức document. Mặc định collection được khoá theo RecordId nội bộ, _id là một index riêng; secondary index trỏ về RecordId, khác với InnoDB trỏ về primary key (collection "clustered" theo _id chỉ có ở bản mới và là tuỳ chọn).
DynamoDB, partition key + sort key B-tree
DynamoDB dùng hash của partition key để định tuyến đến partition server. Bên trong mỗi partition là một B-tree sắp theo sort key để phục vụ range query. Kết hợp lại: tìm partition O(1) (hash) cộng range query O(log n) trong partition (B-tree). Đây là mô hình lai giữa hai nửa của bài này: hash để chia việc, cây có thứ tự để quét khoảng.
etcd / Consul, B-tree trên Raft
etcd lưu dữ liệu trong bbolt (cây B+tree, key-value có thứ tự). Mọi thao tác ghi đi qua Raft consensus (đồng thuận phân tán) trước khi được ghi xuống. Nhờ có thứ tự, etcd làm được RANGE query (liệt kê key theo prefix), thứ thiết yếu cho Kubernetes. Consul thì khác: trạng thái trong bộ nhớ dùng immutable radix tree (trie nén, như bài 08) qua thư viện go-memdb.
11. Đào sâu: tài liệu gốc
MySQL InnoDB:
- MySQL 8.0 Reference — Chapter 17: InnoDB Storage Engine, clustered index, secondary index, buffer pool, adaptive hash index. Mục "Clustered and Secondary Indexes" là phần nên đọc đầu tiên.
- High Performance MySQL, 4th Edition (Silvia Botros, Jeremy Tinley): chương về indexing, covering index, selectivity.
- InnoDB source, btr0btr.cc, logic insert, split, merge của B+tree. Hàm
btr_page_split_and_insertcho thấy chi tiết của page split.
Redis:
- Redis source, src/dict.c, logic incremental rehash:
dictRehash(),dictFind()khi đang rehash, và hàm rehash chạy nền (tên hàm đổi theo phiên bản). - Redis internals documentation, tối ưu bộ nhớ, bigkeys, theo dõi latency.
Sách nền tảng:
- Designing Data-Intensive Applications — Martin Kleppmann, Chapter 3, Storage and Retrieval: B-tree so với LSM-tree, write amplification, read amplification. Góc nhìn rộng nhất về thiết kế storage engine.
Trong khóa học: bài 01, bài 03, bài 07; Mini-challenge LRU cache; khoá SQL: B-tree internals, Tại sao cần index.
12. Tóm tắt
Mang đi dùng:
- Chọn primary key tăng dần (
AUTO_INCREMENThoặc UUID v7) cho InnoDB. UUID v4 làm page split liên tục, và mọi secondary index đều phải tra hai lần (index rồi đến primary key). - Một page 16KB cho fanout cỡ 1000, nên 100 triệu row (dòng cỡ 100 byte) chỉ cần 3 lần đọc page; buffer pool giữ phần nóng trong RAM.
- Redis giữ hai bảng
ht[0]vàht[1], mỗi command chuyển thêm vài bucket (rehashidxghi tiến độ), nên không bao giờ đứng hình cả trăm mili giây. Khi đang rehash, lookup phải xét cả hai bảng. - Gặp bài toán mới, hãy hỏi trước: dữ liệu nằm trên disk hay RAM, có cần range query không, có chạy đơn luồng không.
- Cạm bẫy production: UUID v4 PK, thứ tự cột composite index, index cột cardinality thấp (MySQL); big key và
KEYS *(Redis).
13. Tự kiểm tra
- Q1InnoDB clustered index so với PostgreSQL heap + B-tree: khi query qua secondary index, số lần IO ngẫu nhiên khác nhau thế nào? Giải thích cơ chế.
- Q2Vì sao UUID v4 làm primary key gây page split hàng loạt (page split storm)? UUID v7 giải quyết thế nào?
- Q3Incremental rehash giúp Redis tránh đứng hình thế nào? Vì sao việc Redis chạy đơn luồng khiến resize thành vấn đề nghiêm trọng?
- Q4Page InnoDB 16KB, fanout khoảng 1000 với key số nguyên, dòng cỡ 100 byte (khoảng 150 dòng mỗi leaf). Tính height cần cho bảng 100 triệu dòng. Nếu buffer pool cache toàn bộ internal node thì còn bao nhiêu lần đọc đĩa để lấy 1 dòng?
- Q5Redis SLOWLOG ghi lại các command chậm. Kể 3 nguyên nhân phổ biến nhất khiến Redis production chạy chậm.
- Q6Một service mới có workload '100k point query/giây, 0 range query'. Chọn MySQL B+tree hay store dựa trên hash table như Redis? Lý do kỹ thuật là gì?
Bài tiếp theo: Module 1, Tổng kết & cheat sheet
Mini-challenge — Autocomplete top-K với Trie + frequency
Bài tiếpModule 1 — Tổng kết & cheat sheet
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này