Module 1 — Tổng kết & cheat sheet
Recap tìm kiếm nhanh: bảng so sánh 7 cấu trúc, glossary, 5 pitfall lớn nhất, self-assessment 4 outcomes và tài liệu mở rộng.
TL;DR: Module 1 trang bị 7 cấu trúc tìm kiếm từ hash table đến trie và bloom filter, mỗi cái hợp với một ràng buộc khác nhau. Đây là trang để bookmark: bảng so sánh thời gian/không gian, glossary 20 thuật ngữ, 5 bẫy lớn nhất và phần tự đánh giá 4 mục tiêu. Nếu bạn cài được hash table với open addressing, giải thích được vì sao MySQL chọn B+tree còn Redis chọn hash table, và thiết kế được bloom filter với tỉ lệ false positive cho trước, bạn đã sẵn sàng cho Module 2, Sắp xếp & thứ tự.
Đã đi qua những gì
Bạn bắt đầu từ bài 00, Tổng quan module: tìm kiếm nhanh không phải một cấu trúc duy nhất, mỗi ràng buộc (disk hay RAM, point query hay range query, khớp chính xác hay theo prefix) dẫn đến một cấu trúc tối ưu khác.
Bài 01 mổ xẻ hash function: uniform distribution (output rải đều các bucket, không dồn vào một chỗ) và avalanche effect (đổi 1 bit input thì khoảng 50% bit output đổi, key gần nhau không dồn cụm). Về hashCode/equals contract: vi phạm thì HashMap lookup hỏng mà không có exception nào.
Bài 03 đi vào open addressing: thay vì linked list, ghi thẳng vào array bằng probing. Linear probing hợp với cache nhưng dễ dồn cụm (clustering). Quadratic probing và double hashing giảm dồn cụm. Tombstone giúp delete mà không làm đứt probe chain. Python dict và Rust HashMap đều dùng open addressing nhờ cache locality trên CPU hiện đại.
Bài 04 giải thích binary search và bất biến của nó: target luôn nằm trong đoạn đang xét [lo, hi). Lower bound và upper bound chỉ khác nhau một dấu so sánh, cùng bất biến [lo, hi); giữ nhất quán bất biến đó (và tính mid = lo + (hi - lo) / 2) là cách tránh infinite loop, off-by-one và overflow.
Bài 05 xây BST từ nền: mỗi node thoả BST property, left subtree toàn nhỏ hơn, right subtree toàn lớn hơn. Insert O(chiều cao), trung bình O(log n); delete phức tạp hơn khi node có hai con (thay bằng in-order successor). Worst case là O(n) khi insert dữ liệu đã sắp xếp, và đó là lý do trực tiếp có cây cân bằng.
Bài 06 giải thích cây cân bằng: AVL và Red-Black tree dùng rotation để giữ height O(log n). AVL cân bằng chặt (hai bên chênh nhau tối đa 1 tầng), lookup nhanh hơn nên hợp workload đọc nhiều. Red-Black cân bằng lỏng hơn (nhiều ràng buộc về màu), insert/delete ít rotation hơn nên hợp workload ghi nhiều. Java TreeMap và C++ std::map dùng Red-Black.
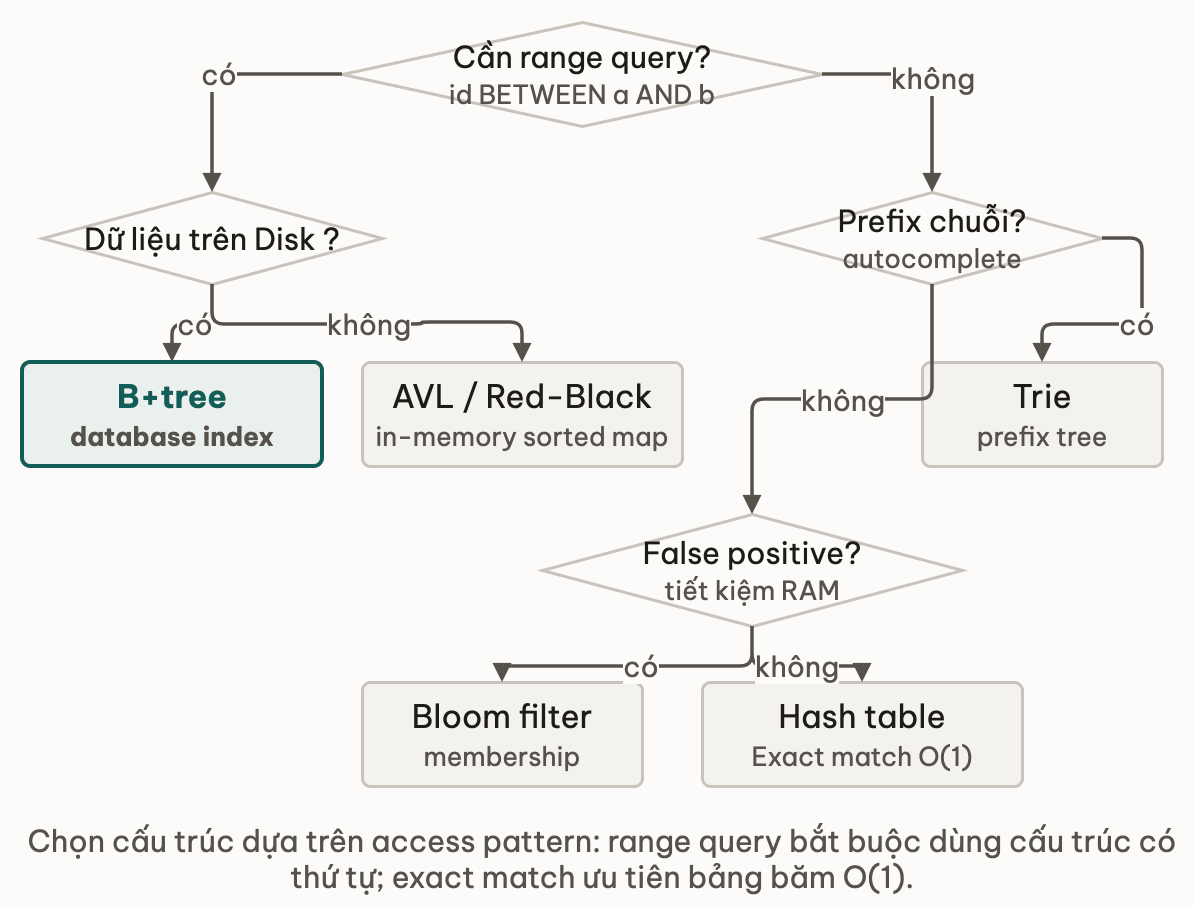
Bài 07 mở rộng ra B-tree và B+tree cho disk: node vừa một page (16KB ở InnoDB), fanout cỡ 1000 với key số nguyên, height 3-4 cho 100 triệu dòng. B+tree thêm leaf linked list để range scan tuần tự O(k). Clustered index của InnoDB lưu cả dòng tại leaf, nên tra bằng primary key chỉ cần 1 lượt đi xuống cây.
Bài 08 giải thích trie: cây chuyên cho key dạng chuỗi, mỗi cạnh là một ký tự, các string cùng prefix dùng chung một đường đi. Insert/lookup/prefix search đều O(L) với L là độ dài key, không phụ thuộc kích thước tập dữ liệu. Dùng trong autocomplete, bảng định tuyến IP (trie nén như Patricia, LC-trie), kiểm tra chính tả.
Bài 09 trình bày bloom filter: bit array kích thước m đi kèm k hash function. add(x) bật k bit; mightContain(x) kiểm tra k bit. Không có false negative, còn false positive thì kiểm soát được. Trick Kirsch-Mitzenmacher g_i = h1 + i × h2 cho phép chỉ dùng 2 hash function. 1 triệu key với FP rate 1% chỉ cần khoảng 1,2MB.
Bài 10 áp dụng trie vào mini-challenge: autocomplete xếp hạng theo frequency, prefix search O(L) và lấy top-k bằng priority queue.
Bài 11 nối lý thuyết với production: MySQL InnoDB chọn B+tree vì dữ liệu nằm trên disk và cần range query, leaf chain phục vụ range scan, fanout cỡ 1000 giảm IO. Redis chọn hash table vì dữ liệu trong RAM và chỉ có point query, incremental rehash giúp event loop đơn luồng không bị chặn: giữ 2 table cùng lúc, mỗi command chuyển vài bucket.
Cheat sheet
Bảng so sánh 7 cấu trúc
| Cấu trúc | Lookup | Insert | Delete | Không gian | Range query | Prefix query | Dùng khi |
|---|---|---|---|---|---|---|---|
| Hash table (chaining) | O(1) avg | O(1) avg | O(1) avg | O(n) | Không | Không | Key-value, cache, set membership |
| Hash table (open addr) | O(1) avg | O(1) avg | O(1) avg* | O(n) | Không | Không | Như trên, cache-friendly hơn |
| Binary search (sorted arr) | O(log n) | O(n) | O(n) | O(n) | O(log n + k) | Không | Read-only hoặc hiếm write |
| BST | O(log n) avg | O(log n) avg | O(log n) avg | O(n) | O(log n + k) | Không | Prototype; production dùng balanced |
| Cây cân bằng (AVL/RB) | O(log n) | O(log n) | O(log n) | O(n) | O(log n + k) | Không | Sorted map/set, read-write mixed |
| B+tree | O(log n) | O(log n) | O(log n) | O(n) | O(log n + k) | Không | Disk index, database |
| Trie | O(L) | O(L) | O(L) | O(N×L) | Không | O(L + k) | String key, autocomplete, IP routing |
| Bloom filter | O(k) | O(k) | Không hỗ trợ | O(m bits) | Không | Không | Probabilistic membership, tiết kiệm RAM |
*O(1) amortized với tombstone; thực tế cần resize khi load factor cao.
L = độ dài key, N = số key, m = kích thước bit array, k = số hash function.
Quy tắc chọn cấu trúc
Hash table, công thức load factor
load factor α = n / m        -- n: số entry, m: số bucket

Chaining:
  Probe length trung bình = 1 + α/2
  α = 0.75: probe ≈ 1.375 (HashMap Java default resize tại đây)
  α = 0.95: probe ≈ 1.475 (chaining chịu α cao khá tốt)

Open addressing (linear probing), lookup tìm THẤY key:
  Probe length trung bình = 1/2 × (1 + 1/(1 - α))
  α = 0.5: probe ≈ 1.5
  α = 0.75: probe ≈ 2.5
  α = 0.9: probe ≈ 5.5   -- thoái hoá nhanh, resize trước 0.8
  (lookup KHÔNG tìm thấy tệ hơn nhiều: 1/2 × (1 + 1/(1 - α)^2), α = 0.9 cỡ 50)
Bloom filter, công thức tham số
Cho n key cần insert, FP rate p mong muốn:

m (số bit) = -n × ln(p) / (ln 2)^2     -- ≈ -1.44 × n × log2(p)
k (số hash) = (m/n) × ln 2             -- ≈ 0.693 × m/n

Ví dụ: n = 1.000.000, p = 0.01 (1%)
  m = -1.000.000 × ln(0.01) / (ln 2)^2 ≈ 9.585.059 bit ≈ 1.2 MB
  k = (9.585.059 / 1.000.000) × ln 2 ≈ 6.64 → dùng k = 7
B+tree, fanout và height
Fanout f ≈ page_size / (key_size + pointer_size)
InnoDB: page 16KB, int key 8B → f cỡ 1000

Số leaf page L = N / (số dòng mỗi leaf);  height h = 1 + ceil(log_f(L))   (1 là tầng leaf)

Ví dụ dòng cỡ 100 byte (cỡ 150 dòng mỗi leaf):
  N = 1 triệu:   L ≈ 6.700     → h = 3
  N = 100 triệu: L ≈ 670.000   → h = 3  (buffer pool giữ internal node → cỡ 1 lần đọc đĩa thật)
  N = 1 tỷ:      L ≈ 6,7 triệu → h = 4
Từ điển module
| Thuật ngữ | Định nghĩa 1 câu |
|---|---|
| Hash function | Hàm biến key bất kỳ thành một số nguyên trong khoảng cố định để xác định bucket. |
| Uniform distribution | Tính chất của hash function: với input ngẫu nhiên, output rải đều trên mọi bucket. |
| Avalanche effect | Tính chất của hash function: đổi 1 bit input thì khoảng 50% bit output đổi. |
| Load factor | Tỉ lệ số entry trên số bucket (α = n/m), quyết định khi nào phải resize và probe length dài hay ngắn. |
| Chaining | Xử lý collision bằng linked list: mỗi bucket là một danh sách các entry có cùng hash. |
| Open addressing | Xử lý collision bằng probing: ghi entry vào ô trống kế tiếp trong array. |
| Probe sequence | Dãy vị trí được thử lần lượt trong open addressing khi bucket đầu tiên đã bị chiếm. |
| Tombstone | Dấu đánh dấu ô đã delete trong open addressing để không làm đứt probe chain. |
| Binary search | Thuật toán tìm trên mảng đã sắp xếp bằng cách liên tục chia đôi phạm vi tìm. |
| Loop invariant | Điều luôn đúng ở đầu mỗi vòng lặp, là công cụ để chứng minh binary search chạy đúng. |
| BST property | Với mỗi node x: toàn bộ left subtree có key nhỏ hơn x, toàn bộ right subtree có key lớn hơn x. |
| In-order traversal | Duyệt BST theo thứ tự left-root-right, cho ra dãy key tăng dần. |
| Rotation | Thao tác nền tảng của cây cân bằng: xoay trái hoặc phải để giảm height mà không phá BST property. |
| AVL tree | Cây cân bằng bắt buộc chiều cao hai subtree của mỗi node chênh nhau tối đa 1. |
| Red-Black tree | Cây cân bằng với 5 quy tắc về màu, đảm bảo height tối đa gấp đôi chiều cao của cây cân bằng hoàn hảo. |
| B-tree | Cây nhiều nhánh (fanout lớn) tự cân bằng, thiết kế cho disk: mỗi node chứa nhiều key nên height thấp. |
| B+tree | Biến thể của B-tree: internal node chỉ chứa key để điều hướng, leaf node chứa dữ liệu và được nối bằng linked list để range scan. |
| Clustered index | Index mà leaf node chứa toàn bộ dữ liệu của dòng; primary key của InnoDB là clustered index. |
| Trie | Cây chuyên cho key dạng chuỗi: mỗi cạnh là một ký tự, prefix chung dùng chung một đường đi. |
| Bloom filter | Cấu trúc xác suất (probabilistic): bit array cùng k hash function, không có false negative, false positive thì kiểm soát được. |
| False positive | Bloom filter trả "maybe yes" cho key chưa từng add; tỉ lệ này kiểm soát được qua tham số m và k. |
| Incremental rehash | Kỹ thuật của Redis: resize hash table dần qua nhiều command thay vì một lượt chặn hết mọi việc. |
Các bẫy thường gặp
Bẫy 1: Load factor quá cao trong open addressing. Chaining chịu được load factor 0.9+ khá tốt (chain dài ra nhưng vẫn chạy). Open addressing mà load factor vượt 0.8 thì probe length tăng phi tuyến: linear probing ở α = 0.9 trung bình phải thử 5.5 lần khi key có mặt, và cỡ 50 lần khi key không có. Hãy resize trước khi vượt 0.75 (chaining) hoặc 0.7 (open addressing).
Bẫy 2: Xoá trong open addressing bằng cách xoá trực tiếp. Xoá entry mà không để lại tombstone sẽ làm đứt probe chain: các entry phía sau vẫn còn nhưng lookup dừng sớm và báo "không tìm thấy" sai. Luôn thay entry đã xoá bằng tombstone, hoặc dùng Robin Hood hashing với backward shift deletion.
Bẫy 3: Off-by-one trong binary search.
while left < right hay while left <= right? mid = (left + right) / 2 hay mid = left + (right - left) / 2? Viết sai thì gây infinite loop hoặc bỏ sót phần tử cuối. Mỗi biến thể (lower bound, upper bound, exact) cần điều kiện lặp và cách cập nhật left/right nhất quán với bất biến đã chọn. Hãy viết ra bất biến trước khi code.
Bẫy 4: Dùng bloom filter khi cần delete. Bloom filter chuẩn không hỗ trợ delete: xoá một bit có thể xoá luôn bit của entry khác dùng chung vị trí đó. Nếu cần delete, dùng counting bloom filter (thay mỗi bit bằng một counter) hoặc cuckoo filter. Còn nếu dùng bloom filter chuẩn mà insert vượt n dự kiến ban đầu thì FP rate tăng vọt ngoài dự tính.
Bẫy 5: Dùng UUID v4 làm primary key trong B+tree.
UUID v4 hoàn toàn ngẫu nhiên: mỗi insert rơi vào vị trí ngẫu nhiên trong B+tree, gây page split liên tục. Sau 1 triệu insert, cây bị phân mảnh, nhiều page chỉ đầy một nửa, lượng ghi (write amplification) tăng cao. Hãy dùng UUID v7 (bắt đầu bằng timestamp tăng dần, RFC 9562) hoặc AUTO_INCREMENT BIGINT để insert gần như tuần tự, ít page split nhất.
Tự kiểm tra
Bạn đã đạt module này nếu trả lời được:
- Implement được hash table với chaining và open addressing, giải thích vì sao load factor ảnh hưởng đến probe length và khi nào nên resize.
- Nếu chưa: đọc lại bài 01, Hash function (mục uniform distribution, avalanche) và bài 03, Open addressing (mục linear probing, tombstone).
- So sánh được BST, cây cân bằng (AVL/RB), B-tree và trie theo trường hợp dùng, giải thích vì sao mỗi cái thắng trong hoàn cảnh của nó.
- Nếu chưa: đọc lại bài 05, BST, bài 06, Cây cân bằng, bài 07, B-tree, bài 08, Trie.
- Giải thích được binary search cùng bất biến của nó, và bloom filter cùng đánh đổi false-positive, tính được m và k cho FP rate cho trước.
- Nếu chưa: đọc lại bài 04, Binary search (mục loop invariant) và bài 09, Bloom filter (mục công thức tham số).
- Thiết kế được index cho hệ thống thật, giải thích vì sao MySQL InnoDB dùng B+tree và Redis dùng hash table với incremental rehash.
- Nếu chưa: đọc lại bài 11, Case study MySQL & Redis (mục clustered index, incremental rehash).
Bài tiếp theo
Module 1 cho bạn bộ cấu trúc tìm kiếm cốt lõi và cách biết cấu trúc nào hợp bài toán nào. Module 2, Sắp xếp & thứ tự đi vào bài toán thứ hai: sắp xếp dữ liệu hiệu quả. Merge sort, quick sort, heap sort, counting sort, radix sort, mỗi thuật toán hợp một ràng buộc khác nhau (in-place hay stable, dùng phép so sánh hay không, disk hay RAM). Nắm vững Module 1 (đặc biệt heap từ Thuật toán Căn bản, Module 2, và BST/cây cân bằng từ Module 1) sẽ giúp bạn học Module 2 nhanh hơn nhiều.
Bài tiếp theo: Module 2, Sắp xếp & thứ tự: tổng quan
Tài liệu mở rộng
- Sách: Introduction to Algorithms, 4th Edition (CLRS) — Cormen, Leiserson, Rivest, Stein. Chapters 11 (Hash Tables), 12-13 (BST & Red-Black Tree), 18 (B-Trees). Phân tích toán học chặt chẽ nhất, có chứng minh cho mọi khẳng định về độ phức tạp.
- Sách: Algorithms, 4th Edition, Robert Sedgewick & Kevin Wayne (Princeton). Phần 3 (Searching): BST, Red-Black BST, hash table kèm hình động minh hoạ. Trang sách algs4.cs.princeton.edu có code và slide miễn phí.
- Paper: Less Hashing, Same Performance: Building a Better Bloom Filter, Kirsch & Mitzenmacher (2008). Chứng minh trick
g_i = h1 + i × h2cho cùng FP rate (tiệm cận) với chỉ 2 hash function, nền của nhiều bản cài đặt hiện đại. - Source: Redis src/dict.c —
dictRehash(),dictFind()trong rehash phase. Code thật ngắn và dễ đọc, minh hoạ trực tiếp incremental rehash. - Source: MySQL InnoDB btr0btr.cc — B+tree insert, page split, merge logic. Hàm
btr_page_split_and_insertcho thấy chi tiết page split xảy ra khi nào và như thế nào. - Blog: Bill Mill, "Bloom Filters by Example", demo tương tác, đổi m và k để thấy FP rate thay đổi ngay.
Case Study: MySQL InnoDB B+tree index + Redis dict incremental rehash
Bài tiếp Sắp xếp & thứ tựSắp xếp & thứ tự: tổng quan module
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này