Sắp xếp & thứ tự: tổng kết và cheat sheet
Tổng kết module sắp xếp: bảng so sánh time, space, stability của 9 thuật toán, glossary, 5 bẫy thực tế và 4 câu tự kiểm tra khớp learning outcomes.
TL;DR: Module này đi từ cận dưới Ω(n log n) của comparison sort, qua tự cài Merge, Quick và Heap sort, tới external merge sort cho dữ liệu vượt RAM và đọc source TimSort cùng Redis ZSET. Trang này là cheat sheet để bookmark: bảng so sánh 9 thuật toán, glossary 15 thuật ngữ, 5 bẫy thực tế và 4 câu tự kiểm tra.
Đã đi qua những gì
Từ tổng quan module, bạn đã học:
- Sort landscape: 5 thuộc tính phân loại (stable, in-place, adaptive, online, comparison-based) và chứng minh cận dưới
Ω(n log n)bằng cây quyết định. - Quadratic sorts: Insertion sort chạy O(n) khi dữ liệu gần như đã sắp xếp nên TimSort dùng nó cho đoạn ngắn; Selection sort ít swap nhất; Bubble sort chỉ để học.
- Merge sort:
O(n log n)ở mọi trường hợp và stable, đổi lại tốn buffer O(n); k-way merge là nền của external sort. - Quick sort: trung bình
O(n log n)với hằng số nhỏ nhờ tận dụng cache; worst case O(n²) tránh bằng pivot ngẫu nhiên hoặc median-of-three. - Heap sort: heap, build-heap O(n), heapsort in-place
O(n log n)nhưng chậm hơn Quick sort vì cache miss. - Counting, Radix, Bucket sort: vượt qua
Ω(n log n)bằng cách dùng thông tin về key, đổi lại phải biết trước cấu trúc của key. - Skip list: tập có thứ tự dựa trên xác suất, search và insert O(log n) kỳ vọng, không cần phép xoay.
- Mini-challenge External merge sort: sort file vượt RAM bằng chunk và min-heap.
- Case study TimSort và Redis ZSET: cách nhận ra run, galloping, merge stack; ZSET ghép skip list với dict.
Cheat sheet
Bảng so sánh 9 thuật toán sắp xếp
| Algorithm | Best | Average | Worst | Space | Stable | Ghi chú |
|---|---|---|---|---|---|---|
| Insertion sort | O(n) | O(n²) | O(n²) | O(1) | Có | Nhanh khi dữ liệu gần như đã sắp xếp; là viên gạch của TimSort |
| Selection sort | O(n²) | O(n²) | O(n²) | O(1) | Không | Số lần swap ít nhất, ít dùng |
| Bubble sort | O(n) | O(n²) | O(n²) | O(1) | Có | Chỉ có giá trị để dạy |
| Merge sort | O(n log n) | O(n log n) | O(n log n) | O(n) | Có | Worst case được đảm bảo; stable; tốt cho linked list |
| Quick sort | O(n log n) | O(n log n) | O(n²) | O(log n) | Không | Nhanh nhất trong thực tế; tránh worst case bằng pivot ngẫu nhiên |
| Heap sort | O(n log n) | O(n log n) | O(n log n) | O(1) | Không | In-place, worst case được đảm bảo; tận dụng cache kém |
| Counting sort | O(n+k) | O(n+k) | O(n+k) | O(n+k) | Có | Chỉ cho số nguyên có khoảng giá trị k nhỏ |
| Radix sort | O(n×d) | O(n×d) | O(n×d) | O(n+k) | Có | d = số chữ số, k = cơ số; cho số nguyên/chuỗi có nhiều chữ số |
| Bucket sort | O(n) | O(n) | O(n²) | O(n) | Có* | Dữ liệu phân bố đều; worst case khi key dồn cụm |
*Bucket sort stable khi dùng stable sort bên trong mỗi bucket.
Quy tắc chọn algorithm
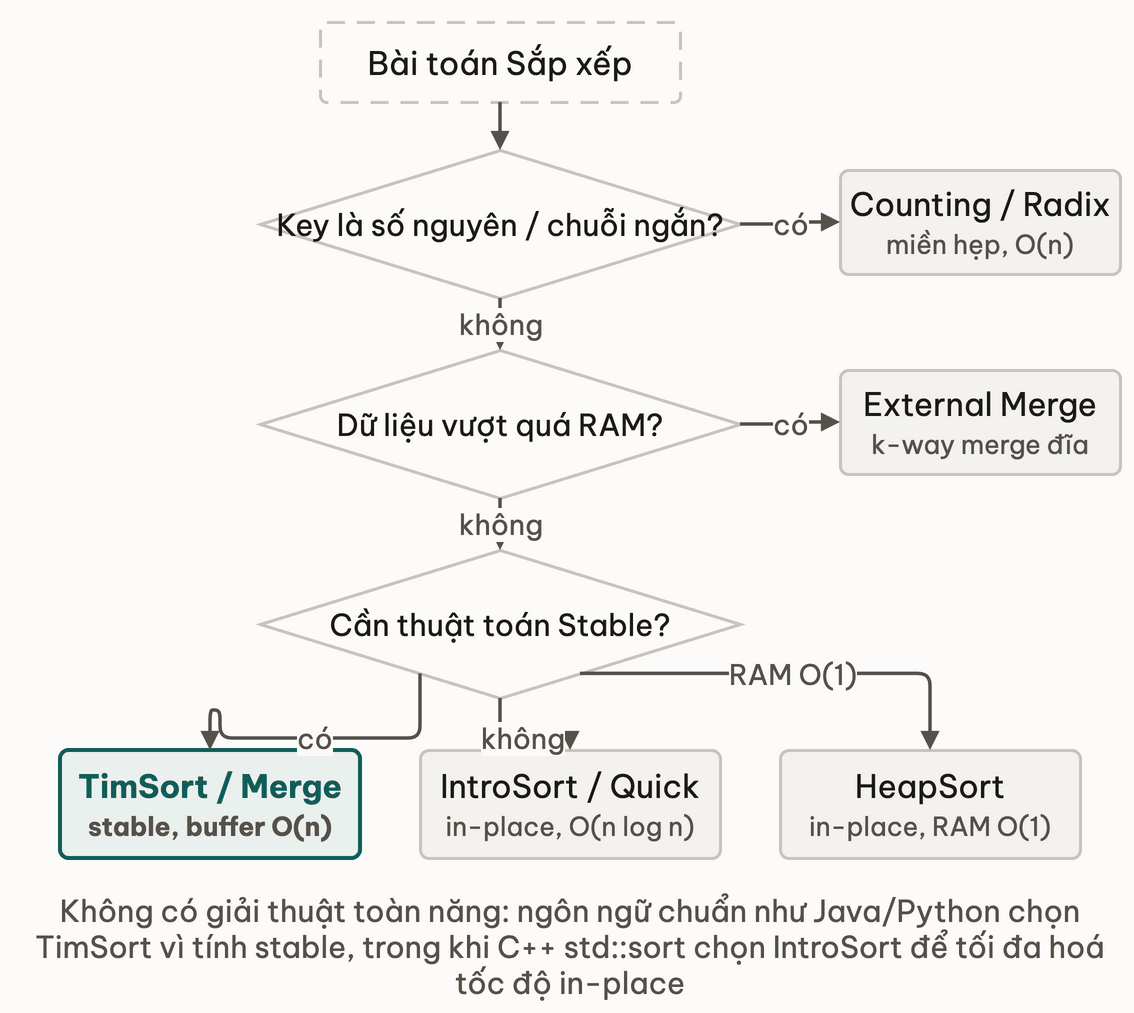
External merge sort: skeleton
function externalMergeSort(inputFile, outputFile, chunkSize):
    -- Pha 1: Tạo sorted run
    chunks <- []
    while inputFile không hết:
        data <- đọc chunkSize phần tử vào RAM
        sort(data)                         -- sort trong RAM bằng thuật toán bất kỳ
        chunkFile <- ghi data ra file tạm
        chunks.append(chunkFile)

    -- Pha 2: k-way merge
    H <- MinHeap                           -- mỗi entry: (giá trị, chunk_index)
    for each chunk trong chunks:
        H.push((chunk.readNext(), chunk))  -- lấy phần tử đầu mỗi chunk
    while H không rỗng:
        (val, chunk) <- H.pop()
        ghi val ra outputFile
        if chunk còn phần tử:
            H.push((chunk.readNext(), chunk))

// Time: O(n log n)  Space: O(k) RAM cho heap, n/k cho mỗi chunk buffer
Glossary module
| Thuật ngữ | Định nghĩa 1 câu |
|---|---|
| Comparison sort | Thuật toán sort chỉ dùng phép so sánh a < b để sắp xếp, nên bị chặn dưới ở Ω(n log n). |
| Non-comparison sort | Thuật toán sort dùng thông tin về cấu trúc của key (khoảng giá trị, chữ số), có thể đạt O(n). |
| Stable sort | Thuật toán giữ nguyên thứ tự tương đối của các phần tử bằng nhau. |
| In-place sort | Thuật toán chỉ dùng O(1) hoặc O(log n) bộ nhớ phụ ngoài mảng đầu vào. |
| Adaptive sort | Thuật toán chạy nhanh hơn khi đầu vào đã gần như đã sắp xếp (ví dụ Insertion sort chạy O(n) trong trường hợp đó). |
Cận dưới Ω(n log n) | Mọi comparison sort cần ít nhất Ω(n log n) phép so sánh, chứng minh bằng cây quyết định có n! lá. |
| Run | Đoạn liên tiếp đã sắp xếp (tăng dần hoặc giảm dần) trong input; TimSort tận dụng các run để chạy nhanh hơn. |
| Galloping mode | Kỹ thuật của TimSort: khi một run áp đảo hẳn trong lúc merge, chuyển sang tìm kiếm nhị phân để bỏ qua nhiều phần tử một lúc. |
| Heapify | Biến một mảng thành binary heap hợp lệ: O(n) nếu làm từ dưới lên, O(n log n) nếu insert từng phần tử. |
| Pivot | Phần tử được chọn làm mốc chia trong partition của Quick sort; sau partition, pivot nằm đúng vị trí cuối cùng. |
| Partition (Lomuto) | Cách partition dùng hai con trỏ i và j, swap phần tử j về phía trái khi A[j] <= pivot. |
| Partition (Hoare) | Cách partition gốc của Hoare: hai con trỏ chạy từ hai đầu vào giữa, ít swap hơn Lomuto. |
| k-way merge | Merge k dãy đã sắp xếp cùng lúc bằng min-heap, tốn O(n log k); là lõi của external merge sort. |
| Skip list | Cấu trúc dữ liệu dựa trên xác suất: nhiều tầng linked list, tầng cao bỏ qua nhiều node hơn, O(log n) trung bình. |
| TimSort | Thuật toán lai (Insertion sort cộng Merge sort) của Tim Peters: tận dụng run, galloping merge và merge stack invariant, stable O(n log n). |
Bẫy thường gặp
Bẫy 1: Dùng Counting sort khi k quá lớn.
Counting sort O(n+k) hiệu quả khi k (khoảng giá trị của key) nhỏ so với n. Nếu sort 1000 số nguyên trong khoảng [0, 10^9], mảng đếm cần 10^9 ô, tốn 4GB RAM. Quy tắc: dùng Counting sort khi k = O(n). Nếu k lớn, chuyển sang Radix sort (chia key thành các chữ số nhỏ hơn).
Bẫy 2: Quick sort với input sorted hoặc nearly-sorted.
Quick sort ngây thơ (pivot là phần tử đầu) trên mảng đã sắp xếp cho worst case O(n²): mỗi lần partition chia thành 0 và n-1 phần tử. Tình huống này gặp nhiều khi sort file log đã có timestamp tăng dần. Cách sửa: pivot ngẫu nhiên hoặc median-of-three. Arrays.sort(int[]) của Java dùng Dual-Pivot Quicksort kèm lấy mẫu pivot và nhánh heap sort khi đệ quy suy biến.
Bẫy 3: Nhầm stable sort với in-place sort. Heap sort in-place nhưng không stable. Merge sort stable nhưng không in-place (cần buffer O(n)). Quick sort không stable (swap có thể đảo thứ tự các phần tử bằng nhau) và cũng không hẳn in-place (đệ quy tốn O(log n) stack). Khi sort object theo nhiều key lần lượt (sort theo ngày, rồi sort theo tên), cần stable sort để giữ thứ tự ngày trong cùng nhóm tên.
Bẫy 4: External merge sort không kiểm soát số file descriptor. Nếu k-way merge mở quá nhiều chunk file cùng lúc, giới hạn file descriptor của hệ điều hành (mặc định 1024 trên Linux) sẽ báo lỗi. Cách sửa: giới hạn số chunk mỗi lần merge (ví dụ k=256), rồi merge nhiều vòng cho đến khi còn 1 file. Đây là k-way merge nhiều tầng, độ phức tạp vẫn O(n log n).
Bẫy 5: Dùng Java Arrays.sort(Integer[]) cho khối lượng dữ liệu toàn số nguyên thuỷ.
Arrays.sort(Integer[]) dùng TimSort, stable nhưng mỗi phần tử là một object nên tốn bộ nhớ và truy cập rải rác hơn. Arrays.sort(int[]) dùng Dual-Pivot Quicksort trực tiếp trên kiểu nguyên thuỷ, thường nhanh hơn rõ rệt khi n lớn. Nếu thật sự cần stable sort trên giá trị nguyên thuỷ, bạn phải boxing hoặc tự cài Merge sort.
Tự kiểm tra
Bạn đã đạt module này nếu trả lời được:
- So sánh được ít nhất 5 thuật toán sắp xếp theo time / space / stability, và giải thích khi nào chọn Quick sort thay Merge sort, khi nào Counting sort vượt cả hai.
- Nếu chưa: đọc lại bài 01 (sort landscape, bảng so sánh) và bài 06 (counting/radix/bucket).
- Giải thích được cận dưới
Ω(n log n)của comparison sort bằng cây quyết định, và chỉ ra điều kiện để non-comparison sort vượt qua giới hạn đó.- Nếu chưa: đọc lại bài 01 (mục 3, cận dưới bằng cây quyết định).
- Cài được merge sort và quick sort bằng pseudocode, ghi rõ best / average / worst case và giải thích nguyên nhân của worst case.
- Nếu chưa: đọc lại bài 03 (merge sort) và bài 04 (quick sort, mục partition + worst case).
- Thiết kế được external merge sort cho file vượt RAM: mô tả hai pha (tạo sorted run rồi k-way merge) và giải thích vì sao TimSort tốt hơn Merge sort thuần trên dữ liệu thực tế.
- Nếu chưa: làm lại bài 08 (mini-challenge) và đọc bài 09 (TimSort run detection + galloping).
Bài tiếp theo
Bạn đã có nền vững về sắp xếp, từ lý thuyết Ω(n log n) tới case study production. Module tiếp theo, Đường đi & quan hệ, mở ra một chiều khác: dữ liệu không còn là dãy tuyến tính mà là mạng lưới quan hệ. Bạn sẽ gặp BFS/DFS, Dijkstra, Bellman-Ford, Kruskal/Prim và topological sort, những thuật toán nằm trong routing, build system và recommendation engine. Dijkstra dùng lại đúng PriorityQueue và heap bạn vừa học.
Bài tiếp theo: Đường đi & quan hệ: tổng quan
Tài liệu mở rộng
- Sách: Introduction to Algorithms (CLRS), Chapters 6 (Heapsort), 7 (Quicksort), 8 (Sorting in Linear Time). Chapter 8.1 là bản chứng minh chặt chẽ nhất của cận dưới comparison sort.
- Sách: Algorithm Design của Kleinberg & Tardos. Chapter 5 (Divide and Conquer) phân tích công thức truy hồi của Merge sort rất rõ.
- Source code: OpenJDK TimSort.java — đọc song song với bài 09, chú ý method
mergeCollapse()là chỗ cài đặt invariant của merge stack. - Paper: Tim Peters — listsort.txt, tài liệu gốc của Tim Peters mô tả thiết kế TimSort cho Python. Dài nhưng rất dễ đọc.
- Source code: Redis t_zset.c — bản cài đặt ZSET, tìm hàm
zslInsert,zslGetRankđể xem trườngspanđược dùng thế nào. - Blog: Sorting Algorithms Visualized — hoạt hình từng bước cho mọi thuật toán trong module, tốt để kiểm tra trực giác của bạn.
TimSort & Redis ZSET — sort thắng ở production
Bài tiếp Đường đi & quan hệ — Graph algorithmsModule Đồ thị: BFS, DFS, Dijkstra, MST
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này