Merge sort — Divide & conquer, stable, foundation cho external sort
Sort 100GB log trên 16GB RAM cần Merge sort — luôn O(n log n), stable, nền tảng external sort và TimSort. Chứng minh T(n)=2T(n/2)+O(n) qua recursion tree, k-way merge.
TL;DR: Merge sort là ví dụ mẫu của divide & conquer: chia đôi, sort từng nửa bằng đệ quy, rồi merge 2 nửa đã sắp xếp. Công thức truy hồi T(n) = 2T(n/2) + n giải ra O(n log n) bằng recursion tree: mỗi tầng trong log₂ n tầng tốn đúng n phép tính. Best = average = worst = O(n log n); Merge sort không adaptive (TimSort mới là bản adaptive). Nó stable vì bước merge ưu tiên nửa trái khi hai phần tử bằng nhau. Đánh đổi chính: cần buffer phụ O(n), tức không in-place. Merge sort là nền của external merge sort (sort 100GB trên 16GB RAM), TimSort (mặc định của Java/Python) và k-way merge trong Lucene.
Cần sort 100GB log file trên máy chỉ có 16GB RAM. Quick sort không làm nổi vì không thể nạp cả 100GB vào RAM để partition. Merge sort giải quyết bằng cách chia file thành các chunk vừa RAM (ví dụ 8GB mỗi chunk), sort từng chunk trong RAM, rồi merge tất cả chunk đã sắp xếp lại với nhau. Đó là external sort, kỹ thuật các database và Hadoop dùng khi dữ liệu vượt RAM (PostgreSQL chuyển sang nó khi vượt work_mem).
Bài này dạy merge sort từ công thức truy hồi T(n) = 2T(n/2) + O(n): chứng minh O(n log n) bằng recursion tree, pseudocode đầy đủ có dùng lại buffer, và nền tảng cho external merge sort (bài 08).
1. Hình dung: Sắp 100 quân bài chia 4 người
Hình dung bạn có 100 quân bài xáo trộn và 4 người bạn sẵn sàng giúp.
Bước 1: chia đều 25 quân cho mỗi người. Cả 4 người sắp phần của mình song song, không ai phụ thuộc ai.
Bước 2: khi cả 4 xong, mỗi người xếp 25 quân đã sắp xếp của mình thành một cọc riêng. Bạn nhìn đỉnh của 4 cọc, chọn quân nhỏ nhất, lấy ra và đặt vào cọc kết quả. Người vừa mất quân đó lật quân tiếp theo lên. Lặp lại cho đến khi cả 4 cọc hết.
Kết quả: 100 quân đã sắp xếp mà không ai phải cầm cả 100 quân cùng lúc.
| Sắp bài với 4 người | Merge sort |
|---|---|
| Chia 100 quân thành 4 phần 25 | Divide: chia mảng thành các mảng con |
| Mỗi người sắp phần của mình | Conquer: sort đệ quy từng nửa |
| So đỉnh 4 cọc, lấy quân nhỏ nhất | Merge: ghép 2 nửa đã sắp xếp thành 1 |
| Cọc kết quả luôn đã sắp xếp sau mỗi bước | Bất biến (invariant, điều luôn đúng sau mỗi bước): kết quả merge luôn đã sắp xếp |
| Chỉ cần nhìn đỉnh mỗi cọc | Merge chỉ so sánh phần tử hiện tại của mỗi nửa |
Divide & conquer là chia nhỏ đến khi bài toán quá đơn giản, giải từng phần, rồi ghép lại. Merge sort là ví dụ điển hình nhất: chia đôi, sort từng nửa, merge 2 nửa đã sắp xếp.
2. Divide & conquer recipe
Merge sort là ví dụ mẫu của divide & conquer. Công thức chung gồm 3 bước:
Divide: chia input thành các bài toán con nhỏ hơn, không chồng lên nhau. Merge sort chia mảng đôi tại điểm giữa.
Conquer: giải từng bài toán con bằng đệ quy (hàm tự gọi lại chính nó; nếu còn lạ, ôn ở hàm rồi xem recursion và call stack). Điểm dừng (base case) là khi bài toán con đủ nhỏ: mảng 1 phần tử thì đã sắp xếp sẵn.
Combine: ghép kết quả của các bài toán con thành kết quả cho bài toán gốc. Merge sort merge 2 nửa đã sắp xếp thành 1 mảng đã sắp xếp.
Công thức truy hồi (recurrence) tổng quát cho divide & conquer:
T(n) = a × T(n/b) + f(n)
-- a = số bài toán con
-- b = hệ số chia nhỏ
-- f(n) = công việc ở bước combine
Với Merge sort: a = 2 (chia làm 2 nửa), b = 2 (mỗi nửa cỡ n/2), f(n) = O(n) (bước merge quét qua toàn bộ phần tử). Suy ra:
T(n) = 2T(n/2) + O(n)
3. Complexity: recursion tree proof
Để giải T(n) = 2T(n/2) + n, hãy vẽ recursion tree rồi đếm công việc ở mỗi tầng:
Level 0:  [  n  ]                        work = n
           /    \
Level 1: [n/2] [n/2]                     work = n/2 + n/2 = n
         / \   / \
Level 2:[n/4][n/4][n/4][n/4]             work = 4 × n/4 = n
         ...
Level k: 2^k nodes, mỗi node work n/2^k  work = 2^k × n/2^k = n
         ...
Level log₂n: n nodes, mỗi node work 1    work = n
Mỗi tầng tốn đúng n phép tính. Số tầng là log₂ n (vì chia đôi liên tục đến khi còn 1 phần tử). Tổng:
T(n) = n × log₂n = O(n log n)
Best = average = worst = O(n log n). Merge sort không adaptive: dù input đã sắp xếp xuôi hay ngược, nó vẫn chia đôi và merge đủ log n tầng. Quick sort cũng O(n log n) ở trường hợp trung bình, nhưng worst case là O(n²) khi chọn pivot xấu.
Space: buffer O(n) cho bước merge, cộng thêm O(log n) cho recursion stack. Merge sort không in-place, đây là chỗ đánh đổi so với Quick sort.
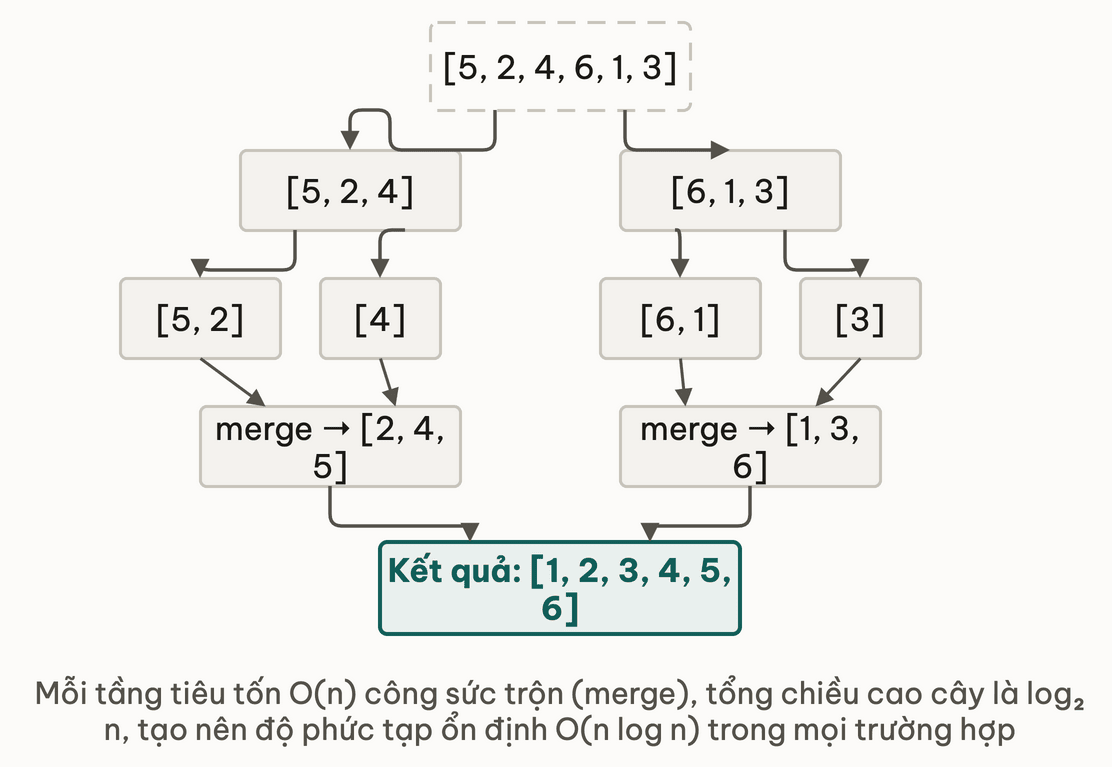
Thử ngẫmcây recursion ở trên có log n tầng, mỗi tầng tốn O(n) để merge, nhân lại ra O(n log n). Với mảng gần như đã sắp xếp sẵn, tầng nào trong cây đó rút ngắn lại được?
4. Pseudocode đầy đủ
4.1 Top-down đệ quy
MergeSort(A):
    if A.length < 2: return
    buf <- mảng phụ kích thước A.length  -- cấp phát 1 lần, dùng lại
    Sort(A, buf, 0, A.length - 1)

Sort(A, buf, lo, hi):
    if lo >= hi: return
    mid <- lo + (hi - lo) / 2            -- tránh overflow: KHÔNG dùng (lo + hi) / 2
    Sort(A, buf, lo, mid)
    Sort(A, buf, mid + 1, hi)
    Merge(A, buf, lo, mid, hi)

Merge(A, buf, lo, mid, hi):
    -- sao chép đoạn [lo..hi] sang buf để đọc từ buf trong khi ghi vào A
    for k <- lo đến hi: buf[k] <- A[k]

    i <- lo; j <- mid + 1; k <- lo
    while i <= mid và j <= hi:
        if buf[i] <= buf[j]:             -- <= giữ STABLE sort
            A[k] <- buf[i]; i <- i + 1
        else:
            A[k] <- buf[j]; j <- j + 1
        k <- k + 1
    while i <= mid:                      -- sao chép phần còn lại của nửa trái
        A[k] <- buf[i]; i <- i + 1; k <- k + 1
    -- nửa phải đã ở đúng vị trí trong A, không cần copy
Time: O(n log n) Space: O(n)
Lưu ý <= trong merge: nó giữ sort ở trạng thái stable. Khi buf[i] == buf[j], ưu tiên lấy phần tử từ nửa trái (đứng trước trong input gốc). Đổi <= thành < vẫn sort đúng nhưng phá stability.
Lưu ý mid = lo + (hi - lo) / 2: tránh tràn số nguyên (integer overflow) khi lo + hi vượt giới hạn của kiểu số nguyên. Binary search cũng dính đúng bẫy này.
4.2 Trace ví dụ: sort [5, 2, 4, 6, 1, 3]
Đọc trace từng dòng, tay cầm bút. Nếu chưa quen theo dõi trạng thái từng bước, ôn lại bảng trace.
Ban đầu:   [5, 2, 4, 6, 1, 3]

Divide:
  trái:    [5, 2, 4]   phải: [6, 1, 3]

  chia nửa trái:
    [5, 2]    [4]
    [5] [2]

  Sort nửa trái:
    merge([5],[2])     -> [2, 5]
    merge([2,5],[4])   -> [2, 4, 5]

  chia nửa phải:
    [6, 1]    [3]
    [6] [1]

  Sort nửa phải:
    merge([6],[1])     -> [1, 6]
    merge([1,6],[3])   -> [1, 3, 6]

merge cuối ([2,4,5],[1,3,6]):
  so 2 vs 1  -> lấy 1  -> [1]
  so 2 vs 3  -> lấy 2  -> [1,2]
  so 4 vs 3  -> lấy 3  -> [1,2,3]
  so 4 vs 6  -> lấy 4  -> [1,2,3,4]
  so 5 vs 6  -> lấy 5  -> [1,2,3,4,5]
  nửa trái hết -> lấy 6  -> [1,2,3,4,5,6]
4.3 Bottom-up iterative
MergeSortBottomUp(A):
    n <- A.length
    buf <- mảng phụ kích thước n
    -- width = kích thước mảng con hiện tại: 1, 2, 4, 8, ...
    width <- 1
    while width < n:
        lo <- 0
        while lo < n - width:
            mid <- lo + width - 1
            hi  <- min(lo + 2*width - 1, n - 1)
            Merge(A, buf, lo, mid, hi)   -- cùng Merge() như trên
            lo <- lo + 2 * width
        width <- width * 2
Time: O(n log n) Space: O(n)
Bottom-up dùng vòng lặp nên không cần recursion stack: nó merge từng cặp phần tử đơn lẻ, rồi từng cặp đoạn 2, đoạn 4, v.v. Cách truy cập bộ nhớ hơi khác: bottom-up đọc tuần tự hơn nên đôi khi tận dụng cache tốt hơn.
Thử ngẫmbottom-up không đụng tới recursion stack, chỉ nhân đôi width mỗi vòng. Với mảng 10 triệu phần tử, bản đệ quy ở 4.1 sâu khoảng bao nhiêu tầng, và có đáng lo về stack không?
5. Stable sort: cơ chế và ý nghĩa
Merge sort stable nhờ điều kiện <= trong bước merge: khi hai phần tử bằng nhau (buf[i] == buf[j]), code chọn buf[i] từ nửa trái trước. Nửa trái chứa các phần tử đứng trước trong input gốc, nên thứ tự tương đối được giữ nguyên.
Tại sao sort mảng object mặc định dùng một biến thể của merge sort (TimSort)?
Sort object nhận object bất kỳ kèm Comparator. Comparator chỉ biết "A nhỏ hơn B hay không", nó không phân biệt được hai object "bằng nhau" nhưng là hai thực thể khác nhau. Stability đảm bảo rằng khi sort theo key phụ, thứ tự theo key chính trong cùng nhóm vẫn được giữ.
-- Ví dụ: sort employees theo salary, rồi theo department
-- Mục tiêu: trong cùng department, giữ thứ tự salary từ bước 1

-- Bước 1: sort theo salary (stable)
-- [Alice:50k:Eng, Bob:30k:HR, Carol:50k:HR, Dave:30k:Eng]
-- -> [Bob:30k:HR, Dave:30k:Eng, Alice:50k:Eng, Carol:50k:HR]

-- Bước 2: sort theo department bằng STABLE sort
-- -> [Dave:30k:Eng, Alice:50k:Eng, Bob:30k:HR, Carol:50k:HR]
-- Trong Eng: Dave(30k) trước Alice(50k) -- giữ đúng thứ tự salary ✓
-- Trong HR: Bob(30k) trước Carol(50k)   -- giữ đúng thứ tự salary ✓
6. K-way merge: generalize cho external sort
2-way merge (merge 2 danh sách đã sắp xếp) là trường hợp riêng của k-way merge (merge k danh sách đã sắp xếp cùng lúc).
KWayMerge(sortedLists[0..k-1]):
    -- MinHeap lưu (giá_trị, chỉ_số_list, vị_trí_trong_list)
    H <- MinHeap rỗng
    result <- []

    -- nạp phần tử đầu tiên từ mỗi list
    for i <- 0 đến k-1:
        if sortedLists[i] không rỗng:
            H.push((sortedLists[i][0], i, 0))

    while H không rỗng:
        (val, listIdx, pos) <- H.pop()    -- lấy giá trị nhỏ nhất
        result.append(val)
        -- đẩy phần tử tiếp theo từ cùng list
        if pos + 1 < sortedLists[listIdx].length:
            nextVal <- sortedLists[listIdx][pos + 1]
            H.push((nextVal, listIdx, pos + 1))

    return result
Time: O(n log k) Space: O(k)
Mỗi pop/push trên MinHeap tốn O(log k). Tổng n phần tử trên k list nên là O(n log k). Khi k nhỏ so với n (ví dụ k = 100 chunk, n = 100 triệu bản ghi), O(n log k) gần như O(n).
External sort pattern:
ExternalSort(file_100GB, RAM_16GB):
    -- Bước 1: chia thành k chunk vừa RAM
    chunks <- []
    for each chunk 8GB trong file:
        load chunk vào RAM
        sort chunk bằng in-memory sort
        ghi chunk đã sorted ra disk
        chunks.append(chunk_file)

    -- Bước 2: k-way merge từ k file sorted
    KWayMerge(chunks) -> output_file  -- chỉ cần k buffer nhỏ, không load toàn bộ
RAM đỉnh: một chunk (8GB) cộng k buffer nhỏ để đọc từng file. Với k = 13 chunk 8GB, sort xong 100GB trên máy 16GB RAM.
Bài mini-challenge External merge sort cài đầy đủ external merge sort.
Thử ngẫmRAM đỉnh ở trên chỉ tốn một chunk 8GB cộng k buffer nhỏ, không phải cả 100GB. Máy chỉ còn 8GB RAM thay vì 16GB thì số chunk k phải đổi thế nào để công thức này còn chạy?
7. Bẫy thường gặp
Bẫy 1: Merge trực tiếp trên array gốc làm hỏng data
-- BUG: đọc và ghi cùng array trong khi merge
Merge_BUG(A, lo, mid, hi):
    i <- lo; j <- mid + 1; k <- lo
    while i <= mid và j <= hi:
        if A[i] <= A[j]:
            k <- k + 1; i <- i + 1    -- A[lo..k] là output, đang ghi đè A[i]
        else:
            A[k] <- A[j]              -- A[i] có thể đã bị ghi đè!
            k <- k + 1; j <- j + 1
    -- kết quả sai vì A[i] đã bị ghi đè trước khi đọc
Khi A[k] được ghi lên vị trí k nằm trong vùng nửa trái (lo..mid), con trỏ i sau đó có thể đọc lại vị trí đó và nhận giá trị sai. Cách sửa: sao chép lo..hi sang buffer trước, rồi merge từ buffer vào A.
Bẫy 2: Quên <= hoặc tính mid bằng (lo + hi) / 2
Hai bẫy này đã nói ở mục 4.1: đổi <= thành < vẫn sort đúng nhưng mất stability, còn (lo + hi) / 2 có thể tràn số khi lo + hi vượt giới hạn kiểu số nguyên (ví dụ lo = 1 tỷ, hi = 1,5 tỷ với int), làm mid âm và gây lỗi index. Viết lo + (hi - lo) / 2.
8. Stable sort cho mảng số nguyên nguyên thủy
Sort mảng số nguyên nguyên thuỷ dùng Dual-Pivot Quicksort, non-stable, và điều đó ổn vì hai số nguyên bằng nhau hoàn toàn như nhau. Nếu cần sort stable (ví dụ sort mảng index theo giá trị của một mảng khác), cách vòng là boxing sang Integer[] hoặc sort mảng index bằng Comparator để dùng TimSort. Đánh đổi: object tốn gấp vài lần bộ nhớ (10 triệu phần tử từ cỡ 40MB lên vài trăm MB, tuỳ JVM).
9. Ứng dụng thực tế
TimSort — merge variant cho Java và Python:
Sort mảng object mặc định dùng TimSort, một biến thể của Merge sort kết hợp Insertion sort cho run ngắn (dưới minrun, cỡ vài chục phần tử) và galloping mode khi một run áp đảo. Nó stable, worst case O(n log n) được đảm bảo, và tận dụng được dữ liệu đã sắp xếp một phần. Bài Case study TimSort và Redis ZSET đi sâu vào TimSort.
External merge sort — PostgreSQL work_mem:
Khi ORDER BY vượt work_mem (mặc định 4MB), Postgres chia thành các sorted run trên disk rồi k-way merge, đúng mô hình ở mục 6.
Lucene segment merge và Spark shuffle: Lucene gộp các segment nhỏ (mỗi segment là danh sách term đã sắp xếp) thành segment lớn bằng k-way merge, đúng cấu trúc của external merge sort ở quy mô search index. Spark cũng sort từng partition rồi merge các partition đã sắp xếp khi reducer lấy dữ liệu.
10. Đào sâu
- The Art of Computer Programming, Vol. 3 (Knuth), mục 5.2.4 (Sorting by Merging).
- Introduction to Algorithms (CLRS), mục 2.3: chứng minh T(n) = 2T(n/2) + Θ(n) bằng recursion tree.
- Tim Peters, bản mô tả TimSort (
Objects/listsort.txttrong CPython): vì sao merge sort là nền và Insertion sort bổ trợ. - Recursion và call stack, mini-challenge External merge sort, Case study TimSort và Redis ZSET.
Bài liên quan trong khoá học:
- External Merge Sort: sắp xếp file 10GB với RAM 1GB.
- External Sort trên dữ liệu lớn: kỹ thuật k-way merge.
11. Tóm tắt
Checklist khi dùng hoặc tự viết Merge sort:
- Cấp buffer phụ O(n) một lần ở ngoài, đừng cấp trong mỗi lần đệ quy.
- Tính
mid = low + (high - low) / 2để khỏi tràn số. - Dùng
<=khi so sánh phần tử hai nửa để giữ stability. - Dữ liệu vượt RAM thì chia chunk, sort từng chunk, rồi k-way merge bằng heap: O(n log k).
- Cần stable sort cho số nguyên nguyên thuỷ thì phải boxing sang object, tức chấp nhận tốn thêm bộ nhớ.
12. Tự kiểm tra
- Q1Công thức truy hồi T(n) = 2T(n/2) + n giải ra O(n log n). Chứng minh bằng recursion tree như thế nào?
- Q2Vì sao merge sort luôn O(n log n) trong mọi trường hợp (best = worst), trong khi Quick sort có worst case O(n²)?
- Q3Đổi <= thành < trong bước merge ảnh hưởng gì đến kết quả?
- Q4Merge sort bottom-up dùng vòng lặp và top-down dùng đệ quy. Khi nào nên chọn cái nào?
- Q5K-way merge dùng MinHeap. Độ phức tạp O(n log k) đến từ đâu?
- Q6Sort mảng số nguyên nguyên thuỷ không stable. Cách vòng trong production là gì và đánh đổi ra sao?
Bài tiếp theo: Quick sort — pivot, partition, Dual-Pivot trong JDK
Quadratic sorts — Bubble, Selection, Insertion sort
Bài tiếpQuick sort — Pivot, partition, và Dual-Pivot trong JDK
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này