Quick sort — Pivot, partition, và Dual-Pivot trong JDK
Quick sort thường nhanh hơn Merge sort trên random data nhờ cache locality. Partition Lomuto vs Hoare, Dual-Pivot Quicksort (Java 7+), adversarial input khiến O(n²).
TL;DR: Quick sort thường nhanh hơn Merge sort trên dữ liệu ngẫu nhiên dù cùng O(n log n) trung bình, nhờ ba thứ: tận dụng cache tốt (partition quét tuần tự), không cấp phát buffer, và vòng lặp trong đơn giản nên JIT biên dịch tốt. Cơ chế cốt lõi là partition: chọn pivot, sắp xếp lại sao cho mọi phần tử bên trái nhỏ hơn pivot và bên phải lớn hơn, pivot về đúng vị trí vĩnh viễn. Hoare partition ít swap hơn Lomuto khoảng 3 lần nên nhiều cài đặt production dùng biến thể hai con trỏ như nó. Worst case O(n²) xảy ra khi pivot luôn là min/max; JDK lấy mẫu 5 phần tử để chọn pivot và chuyển sang Heap sort khi đệ quy suy biến (kiểu Introsort). Quick sort non-stable, nên không hợp với chuỗi sort nhiều key.
Trên mảng 1 triệu số nguyên ngẫu nhiên, sort kiểu Quick sort thường nhanh hơn Merge sort một khoảng đáng kể (cỡ vài chục phần trăm, tuỳ máy) dù cả hai cùng độ phức tạp O(n log n) trung bình. Điều đó có vẻ mâu thuẫn: cùng Big-O, sao kết quả đo được lại khác nhau?
Câu trả lời nằm ở ba yếu tố mà Big-O không thể hiện: cache locality (Quick sort đọc bộ nhớ tuần tự hơn nên tận dụng cache tốt hơn), không cấp phát buffer (không cần buffer phụ O(n) như Merge sort), và vòng lặp trong đơn giản (vòng lặp partition ngắn, JIT biên dịch ra mã máy rất gọn). Đổi lại, Quick sort có worst case O(n²) khi gặp adversarial input (dữ liệu cố tình dựng để làm nó chậm), và kẻ xấu hoàn toàn có thể khai thác điều đó.
Bài này dạy cơ chế partition, các cách chọn pivot, bản cải tiến Dual-Pivot của Vladimir Yaroslavskiy đang chạy trong JDK, và lý do Quick sort thắng ở kiểu nguyên thuỷ nhưng thua TimSort ở object.
1. Hình dung: Sắp bài bằng "chọn một quân làm mốc"
Hình dung bạn có 10 quân bài xáo trộn, cần sắp theo thứ tự.
Cách Quick sort: chọn một quân làm mốc (pivot). Chia phần còn lại thành hai nhóm: nhỏ hơn pivot thì sang trái, lớn hơn pivot thì sang phải. Pivot lúc này nằm ở đúng vị trí cuối cùng của nó và không bao giờ phải di chuyển lại. Lặp lại cho nhóm trái và nhóm phải.
| Sắp bài bằng mốc | Quick sort |
|---|---|
| Chọn 1 quân làm mốc | Chọn pivot |
| Quân nhỏ hơn sang trái mốc | Partition: phần tử nhỏ hơn pivot về bên trái |
| Quân lớn hơn sang phải mốc | Partition: phần tử lớn hơn pivot về bên phải |
| Mốc ở vị trí đúng, không di chuyển nữa | Pivot đã ở vị trí cuối cùng sau partition |
| Lặp lại cho nhóm trái và nhóm phải | Đệ quy trên nửa trái và nửa phải |
Partition là tìm vị trí đúng cho pivot và tách mảng thành hai phần. Sau mỗi lần partition, ít nhất 1 phần tử (chính là pivot) đã ở vị trí đúng vĩnh viễn.
2. Partition mechanics: Lomuto vs Hoare
Partition là bước cốt lõi của Quick sort: với mảng A[lo..hi], chọn pivot rồi sắp xếp lại sao cho mọi phần tử nhỏ hơn pivot đứng trước pivot, mọi phần tử lớn hơn đứng sau.
2.1 Lomuto partition (đơn giản, dễ hiểu)
Partition cần hoán đổi hai phần tử liên tục, và hoán đổi cần một biến tạm (nếu chưa nhớ tại sao, ôn lại mini-challenge hoán đổi).
LomutoPartition(A, lo, hi):
    pivot <- A[hi]              -- pivot là phần tử cuối
    i <- lo - 1                 -- i = ranh giới: mọi phần tử tại/trước i đều <= pivot
    for j <- lo đến hi-1:
        if A[j] <= pivot:
            i <- i + 1
            swap A[i] và A[j]
    -- đặt pivot vào vị trí đúng
    swap A[i+1] và A[hi]
    return i + 1                -- chỉ số của pivot
Time: O(n) Space: O(1)
Trace với [4, 2, 7, 1, 5] (pivot = 5, i bắt đầu ở -1):
| j | A[j] | A[j] ≤ 5? | i sau đó | Mảng |
|---|---|---|---|---|
| 0 | 4 | có | 0 | 4 2 7 1 5 |
| 1 | 2 | có | 1 | 4 2 7 1 5 |
| 2 | 7 | không | 1 | 4 2 7 1 5 |
| 3 | 1 | có, swap A[2] và A[3] | 2 | 4 2 1 7 5 |
| xong | swap A[3] và A[hi] | 4 2 1 5 7, trả về 3 |
Sau khi LomutoPartition trả về p: A[lo..p-1] đều nhỏ hơn hoặc bằng A[p], và A[p+1..hi] đều lớn hơn A[p]. Pivot A[p] ở vị trí đúng vĩnh viễn.
2.2 Hoare partition (hiệu quả hơn, nhiều cài đặt production dùng)
HoarePartition(A, lo, hi):
    pivot <- A[lo + (hi - lo) / 2]    -- phần tử giữa làm pivot
    i <- lo - 1
    j <- hi + 1
    while true:
        repeat i <- i + 1 until A[i] >= pivot    -- tiến i cho đến khi A[i] >= pivot
        repeat j <- j - 1 until A[j] <= pivot    -- lùi j cho đến khi A[j] <= pivot
        if i >= j: return j                       -- hai con trỏ gặp nhau -- xong
        swap A[i] và A[j]
Time: O(n) Space: O(1)
Hoare partition trả về chỉ số j. Khác với Lomuto, A[j] không nhất thiết là pivot. Điều luôn đúng (invariant): mọi phần tử trong A[lo..j] đều nhỏ hơn hoặc bằng mọi phần tử trong A[j+1..hi].
Vì sao Hoare nhanh hơn Lomuto?
Trên dữ liệu ngẫu nhiên, Lomuto swap nhiều hơn Hoare khoảng 3 lần. Hoare dùng hai con trỏ chạy từ hai đầu vào giữa, nên mỗi phần tử chỉ bị quét một lần và swap ít nhất có thể. Nhiều cài đặt sort trong production dùng Hoare hoặc một biến thể hai con trỏ của nó.
| Tiêu chí | Lomuto | Hoare |
|---|---|---|
| Số swap trung bình | ~n/2 | ~n/6 |
| Độ phức tạp của code | Đơn giản, dễ debug | Phức tạp hơn một chút |
| Giá trị trả về | phần tử tại chỉ số trả về là pivot | phần tử tại chỉ số trả về không nhất thiết là pivot |
| Dùng trong production | Hiếm | Phổ biến hơn (biến thể hai con trỏ) |
3. Pseudocode đầy đủ: Quick sort với Hoare
QuickSort(A):
    QuickSort_helper(A, 0, A.length - 1)

QuickSort_helper(A, lo, hi):
    if lo < hi:
        p <- HoarePartition(A, lo, hi)
        QuickSort_helper(A, lo, p)        -- lưu ý: p, không phải p-1 (Hoare invariant)
        QuickSort_helper(A, p + 1, hi)
Time: O(n log n) average, O(n²) worst Space: O(log n) recursion stack
Chỗ dễ sai nhất là biên: Lomuto đệ quy p-1 và p+1, còn Hoare đệ quy p và p+1. Chép nhầm giữa hai kiểu là lỗi off-by-one kinh điển; thói quen soát biên có ở edge case.
3.1 Trace ví dụ: [3, 1, 4, 1, 5, 9, 2, 6]
Ban đầu: [3, 1, 4, 1, 5, 9, 2, 6]  lo=0 hi=7
pivot = A[3] = 1

Hoare scan:
  i tiến phải: A[0]=3 >= 1, dừng tại i=0
  j lùi trái:  A[7]=6 > 1, A[6]=2 > 1, A[5]=9 > 1,
               A[4]=5 > 1, A[3]=1 = 1, dừng tại j=3
  i < j: swap A[0] và A[3] -> [1, 1, 4, 3, 5, 9, 2, 6]
  i tiến phải: A[1]=1 = 1, dừng tại i=1
  j lùi trái:  A[2]=4 > 1, A[1]=1 = 1, dừng tại j=1
  i >= j: return j=1

Đệ quy trái:  QuickSort([1, 1, ...], 0, 1)  -> đã sorted
Đệ quy phải: QuickSort([..., 4, 3, 5, 9, 2, 6], 2, 7)
  pivot = A[4] = 5
  ... (tiếp tục partition)

Kết quả cuối: [1, 1, 2, 3, 4, 5, 6, 9]
4. Pivot strategies: chọn quân nào làm mốc
Cách chọn pivot quyết định chất lượng partition: pivot tốt chia mảng thành hai nửa gần bằng nhau, cây đệ quy cân bằng và ra O(n log n). Pivot xấu chia 1:n-1 mỗi lần, độ sâu đệ quy là n và ra O(n²).
4.1 First hoặc last element
pivot <- A[lo] -- hoặc A[hi]
Đơn giản nhất. Nhưng với input đã sắp xếp tăng dần (hoặc giảm dần), mỗi lần partition luôn tạo một nhóm rỗng và một nhóm n-1 phần tử, ra O(n²). Đây là worst case kinh điển.
4.2 Random pivot
mid <- lo + random(hi - lo + 1)   -- chỉ số ngẫu nhiên trong [lo, hi]
swap A[mid] và A[hi]
pivot <- A[hi]
-- rồi dùng Lomuto style với A[hi] làm pivot
Chọn ngẫu nhiên cho kỳ vọng O(n log n) bất kể thứ tự input. Kẻ dựng input xấu không biết trước pivot sẽ là gì nên không thể tạo ra worst case.
4.3 Median-of-three
mid <- lo + (hi - lo) / 2
-- sắp xếp A[lo], A[mid], A[hi] theo thứ tự tăng dần
if A[lo] > A[mid]: swap A[lo] và A[mid]
if A[lo] > A[hi]:  swap A[lo] và A[hi]
if A[mid] > A[hi]: swap A[mid] và A[hi]
pivot <- A[mid]    -- median của 3 phần tử
Lấy median của A[lo], A[mid], A[hi] làm pivot. Cách này tốt hơn hẳn việc lấy phần tử đầu/cuối: input đã sắp xếp không còn là worst case nữa, và không cần bộ sinh số ngẫu nhiên.
4.4 Lấy mẫu nhiều điểm: Tukey ninther và cách của JDK
Chọn nhiều điểm mẫu rồi lấy median làm pivot cho kết quả ổn định hơn. Tukey ninther (dùng trong Bentley & McIlroy 1993) lấy 9 mẫu, chia 3 nhóm 3 phần tử, lấy median mỗi nhóm rồi median của 3 median đó.
-- Tukey ninther (rút gọn):
-- median(a0,a1,a2) -> m0
-- median(a3,a4,a5) -> m1
-- median(a6,a7,a8) -> m2
-- pivot <- median(m0, m1, m2)
Dual-Pivot Quicksort của JDK (xác nhận ở JDK 21) không dùng ninther mà lấy 5 phần tử cách đều quanh tâm mảng, sắp xếp 5 phần tử đó rồi chọn 2 pivot từ chúng. Ý tưởng chung giống nhau: mẫu rải đều thì khó bị input có sẵn thứ tự đánh lừa.
Thử ngẫmlấy mẫu rải đều nên pivot gần như không rơi vào worst case với dữ liệu thật. Với mảng đã sort ngược hoàn toàn, pivot "phần tử đầu" ở 4.1 rơi vào trường hợp nào?
5. Worst case O(n²) và adversarial input
Khi pivot luôn là phần tử nhỏ nhất (hoặc lớn nhất), partition chia [0, n-1] thay vì [n/2, n/2]:
Kích thước partition: n, n-1, n-2, ..., 1
Số phép so sánh:      n + (n-1) + ... + 1 = n(n+1)/2 = O(n²)
Input làm hỏng pivot là phần tử đầu:
- Đã sắp xếp tăng dần:
[1, 2, 3, 4, 5]→ pivot = 1 mỗi lần, chia 0:n-1. - Đã sắp xếp giảm dần:
[5, 4, 3, 2, 1]→ pivot = 5 mỗi lần, chia n-1:0.
Tấn công thật: DoS qua sort trên production:
Nếu kẻ tấn công biết cách chọn pivot (ví dụ luôn lấy phần tử đầu), họ có thể dựng input để ép O(n²), khiến server mất hàng phút để sort thay vì vài mili giây. McIlroy 1999 ("A Killer Adversary for Quicksort") mô tả cách sinh input xấu cho bất kỳ cách chọn pivot nào.
Cách JDK phòng thủ: Dual-Pivot Quicksort lấy mẫu 5 phần tử để chọn pivot, và (ở các bản JDK gần đây như 21) có đoạn nhận ra trường hợp suy biến: khi độ sâu đệ quy vượt ngưỡng thì chuyển sang Heap sort, cùng ý tưởng với Introsort, nên worst case vẫn O(n log n).
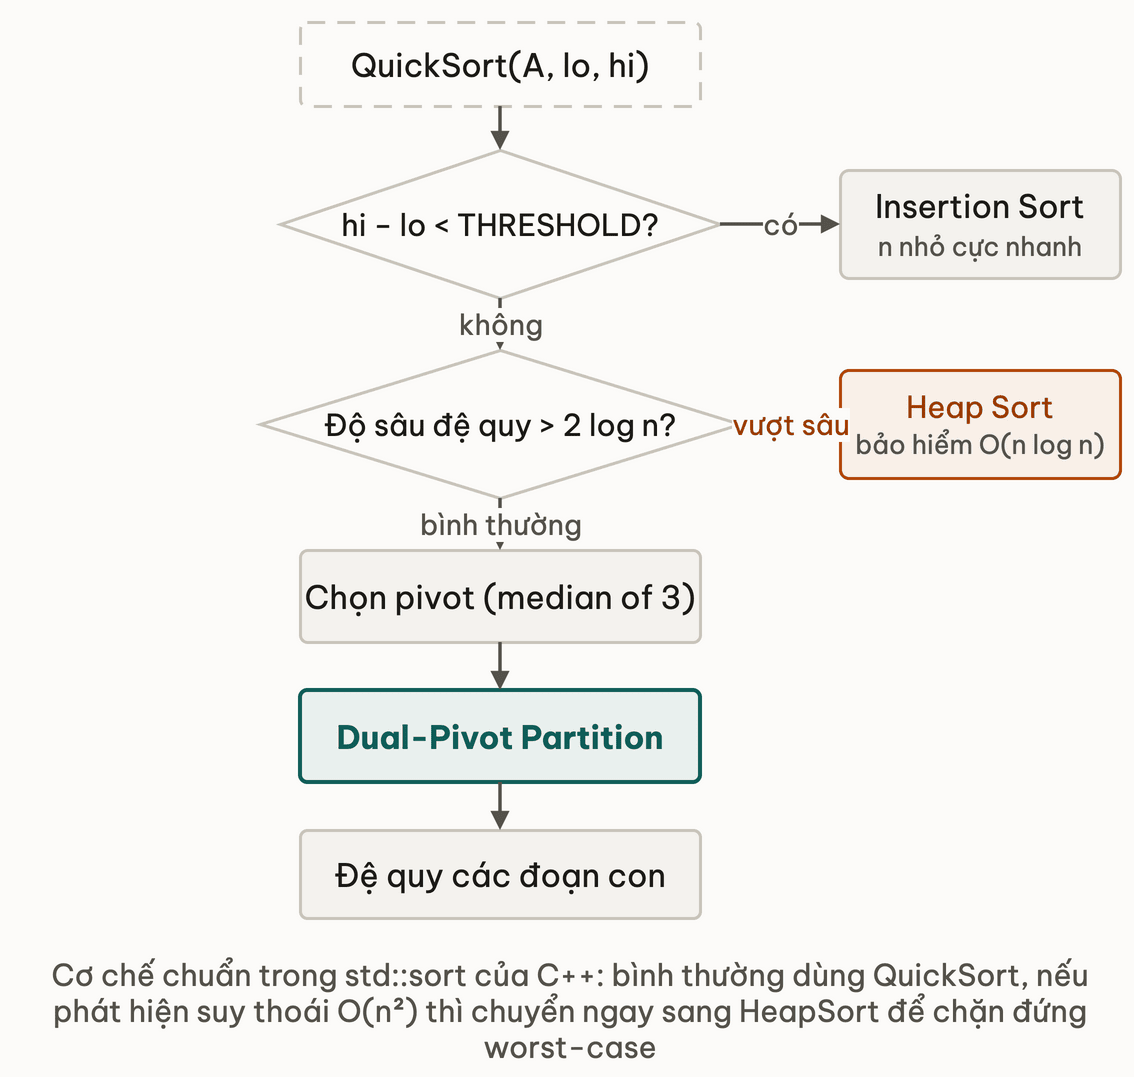
Với pivot là phần tử đầu và input đã sắp xếp, độ sâu đệ quy là n. Mảng 100.000 phần tử cần 100.000 stack frame, dẫn đến stack overflow. JDK tránh bằng cách lấy mẫu pivot cộng nhánh Heap sort khi đệ quy quá sâu. Bản Quick sort tự viết kiểu ngây thơ không có lớp phòng thủ này.
6. Dual-Pivot Quicksort (Java 7+)
Vladimir Yaroslavskiy đề xuất năm 2009: thay vì 1 pivot, dùng 2 pivot p1 ≤ p2 và chia mảng thành 3 vùng:
[ phần tử < p1 | p1 <= x <= p2 | phần tử > p2 ]
     vùng trái      vùng giữa       vùng phải
DualPivotPartition(A, lo, hi):
    -- đảm bảo A[lo] <= A[hi]
    if A[lo] > A[hi]: swap A[lo] và A[hi]
    p1 <- A[lo]; p2 <- A[hi]

    lt <- lo + 1    -- ranh giới: A[lo+1..lt-1] < p1
    gt <- hi - 1    -- ranh giới: A[gt+1..hi-1] > p2
    k  <- lo + 1    -- con trỏ scan hiện tại

    while k <= gt:
        if A[k] < p1:
            swap A[k] và A[lt]; lt <- lt + 1; k <- k + 1
        else if A[k] > p2:
            swap A[k] và A[gt]; gt <- gt - 1
            -- k không tăng vì A[gt] mới chưa được kiểm tra
        else:
            k <- k + 1

    -- đặt pivot vào đúng vị trí
    lt <- lt - 1; gt <- gt + 1
    swap A[lo] và A[lt]
    swap A[hi] và A[gt]

    -- đệ quy 3 vùng
    DualPivotSort(A, lo, lt - 1)
    DualPivotSort(A, lt + 1, gt - 1)
    DualPivotSort(A, gt + 1, hi)
Time: O(n log n) average Space: O(log n)
Vì sao nhanh hơn?
Với 1 pivot, mỗi lần partition tạo 2 bài toán con, mỗi cái cỡ n/2. Với 2 pivot, tạo 3 bài toán con, mỗi cái cỡ n/3. Cây đệ quy thấp hơn (độ sâu cỡ log₃ n thay vì log₂ n).
Ngoài ra, partition 3 vùng xử lý tốt hơn input có nhiều phần tử trùng nhau: vùng giữa nhanh chóng lớn lên và không cần đệ quy thêm.
OpenJDK đưa nó vào Java 7 sau khi benchmark cho thấy nhanh hơn bản 1 pivot. Lưu ý lợi thế thực tế đến chủ yếu từ việc truy cập bộ nhớ hiệu quả hơn và ít phép so sánh hơn một chút; đừng hiểu là số lần swap giảm mạnh.
Thử ngẫmpartition 3 vùng với 2 pivot tạo 3 bài toán con cỡ n/3 thay vì n/2. Với mảng toàn phần tử giống hệt nhau, vùng giữa lớn cỡ nào và điều đó rút ngắn được gì?
7. Quick sort properties
| Thuộc tính | Giá trị | Ghi chú |
|---|---|---|
| Time — best | O(n log n) | Pivot luôn chia đều |
| Time — average | O(n log n) | Kỳ vọng khi chọn pivot ngẫu nhiên |
| Time — worst | O(n²) | Pivot luôn là min/max |
| Space | O(log n) | Recursion stack, trường hợp trung bình |
| Stable | Không | Swap trong partition có thể đổi chỗ các phần tử bằng nhau |
| In-place | Có | Không cần buffer O(n) như Merge sort |
| Adaptive | Không (bản kinh điển) | JDK 21 có thêm bước nhận ra run cho mảng đủ lớn, nhưng đó là phần thêm vào, không phải bản chất của Quick sort |
8. Bẫy thường gặp
Bẫy 1: Stack overflow trên adversarial input
Pivot cố định ở đầu mảng cộng input đã sắp xếp cho độ sâu đệ quy n (xem hộp cảnh báo ở mục 5). Cách sửa: pivot median-of-three hoặc ngẫu nhiên, hoặc đệ quy trên nửa nhỏ rồi lặp trên nửa lớn để độ sâu stack chỉ còn O(log n).
Bẫy 2: Quick sort không stable, sort theo hai khoá sẽ hỏng
Sort theo lương rồi sort theo tên bằng Quick sort thì thứ tự lương trong cùng tên không còn được giữ. Cần stable sort (Merge sort, TimSort) ở bước sau, như đã phân tích ở Sorting landscape.
Bẫy 3: Quên switch sang Insertion sort cho subarray nhỏ
-- NHANH: switch sang Insertion sort khi subarray nhỏ
THRESHOLD <- 47   -- ví dụ; JDK 7 đến 13 dùng 47, JDK 21 dùng 44 và 65 cho hai chế độ

QuickSort_FAST(A, lo, hi):
    if hi - lo < THRESHOLD:
        InsertionSort(A, lo, hi)   -- Insertion sort thắng với n nhỏ
        return
    p <- HoarePartition(A, lo, hi)
    QuickSort_FAST(A, lo, p)
    QuickSort_FAST(A, p + 1, hi)
Time: O(n log n) Space: O(log n)
Ngưỡng cụ thể đổi theo bản JDK (JDK 7 đến 13 dùng hằng 47; ở JDK 21 có hằng 44 cho insertion sort và 65 cho mixed insertion sort). Với đoạn con dưới ngưỡng, Insertion sort nhanh hơn Quick sort vì chi phí phụ của việc gọi hàm và khởi tạo partition lớn hơn lợi ích của O(n log n). Bài Quadratic sorts giải thích vì sao Insertion sort adaptive và nhanh khi n nhỏ.
Thử ngẫmTHRESHOLD = 47 (con số minh hoạ) nghĩa là dưới ngưỡng đó, chi phí gọi hàm ăn hết lợi thế O(n log n). Đổi THRESHOLD lên 200, phần tốc độ nào cải thiện và phần nào tệ đi?
9. Java standard library
-- Arrays.sort(primitive[]) -- Dual-Pivot Quicksort (Yaroslavskiy 2009, Java 7+)
-- Average: O(n log n). Non-stable. Insertion sort cho đoạn con còn vài chục phần tử.
-- JDK 21: có nhánh heap sort khi đệ quy quá sâu, và nhận run cho mảng đủ lớn.

-- Arrays.sort(Object[]) -- TimSort (Python 2002, Java 7)
-- Best: O(n), Average: O(n log n), Worst: O(n log n) guaranteed
-- Stable. Dùng merge buffer O(n).

-- Collections.sort(List) -- ủy quyền cho List.sort() -- TimSort
-- Stream.sorted() -- buffer tất cả phần tử, áp dụng TimSort, emit

-- Arrays.parallelSort(primitive[]) -- fork-join + Dual-Pivot
-- Mảng nhỏ (cỡ vài nghìn phần tử trở xuống) dùng sequential sort
Tóm lại cách chọn:
- Mảng kiểu nguyên thuỷ → Dual-Pivot Quicksort (nhanh, non-stable; stability không có nghĩa với kiểu nguyên thuỷ).
- Mảng object hoặc List → TimSort (stable, O(n log n) được đảm bảo).
parallelSort()→ Dual-Pivot chạy song song bằng fork-join, chỉ có lợi trên mảng đủ lớn (từ vài nghìn phần tử trở lên).
10. Ứng dụng thực tế
Database ORDER BY trong RAM: khi dữ liệu vừa trong work_mem, PostgreSQL sort tuple bằng Quick sort, kèm Insertion sort cho các đoạn con nhỏ. Khi dữ liệu vượt work_mem, nó chuyển sang external merge sort (xem mini-challenge External merge sort).
11. Đào sâu
- Bentley & McIlroy (1993), "Engineering a Sort Function", Software: Practice and Experience 23(11): median-of-three, Tukey ninther, ngưỡng chuyển sang sort đoạn nhỏ.
- Vladimir Yaroslavskiy (2009), "Dual-Pivot Quicksort": thuật toán được đưa vào Java 7.
- McIlroy (1999), "A Killer Adversary for Quicksort", Software: Practice and Experience 29(4): cách dựng input ép O(n²).
- Introduction to Algorithms (CLRS), chương 7; The Art of Computer Programming, Vol. 3 (Knuth), mục 5.2.2.
- Quadratic sorts (Insertion sort cho đoạn nhỏ) và Case study TimSort.
Bài liên quan trong khoá học:
- Merge Sort: so sánh tính ổn định (stable) và bộ nhớ phụ.
- Cache Locality: lý do QuickSort in-place chạy nhanh thực tế.
12. Tóm tắt
Checklist khi viết hoặc đánh giá Quick sort:
- Không chọn pivot cố định ở đầu hoặc cuối: input đã sắp xếp sẽ đẩy nó về O(n²). Dùng pivot ngẫu nhiên hoặc median-of-three.
- Đệ quy vào nửa nhỏ trước (hoặc lặp cho nửa lớn) để chặn stack overflow trên input xấu.
- Chuyển sang Insertion sort khi đoạn con chỉ còn vài chục phần tử; bản tự viết hay bỏ sót tối ưu này.
- Cần stable hoặc cần đảm bảo worst case thì không dùng Quick sort thuần; JDK chuyển sang Heap sort kiểu Introsort khi partition suy biến.
- Sort object theo nhiều key liên tiếp: dùng sort stable của thư viện (TimSort).
13. Tự kiểm tra
- Q1Quick sort có worst case O(n²) nhưng sort có sẵn của Java vẫn dùng một biến thể Quick sort. JDK phòng thủ thế nào trước adversarial input?
- Q2Lomuto partition và Hoare partition đều cho kết quả đúng nhưng Hoare nhanh hơn. Cơ chế nào tạo ra sự khác biệt?
- Q3Dual-Pivot Quicksort dùng 2 pivot tạo 3 vùng. Vì sao nó nhanh hơn bản 1 pivot tạo 2 vùng trên dữ liệu ngẫu nhiên?
- Q4Quick sort non-stable. Sort mảng số nguyên nguyên thuỷ bằng non-stable thì không sao, còn sort object lại phải stable. Vì sao kiểu nguyên thuỷ và object xử lý khác nhau?
- Q5JDK chuyển sang Insertion sort khi đoạn con chỉ còn vài chục phần tử (hằng 47 ở JDK 7 đến 13). Ngưỡng này đến từ đâu, và vì sao không phải 10 hay 100?
- Q6Cho pseudocode: sort(A); A[0] = -1; sort(A);. Lần sort thứ hai có hưởng lợi từ adaptive sort không? Vì sao?
Bài tiếp theo: Heap sort — binary heap, build-heap O(n), và top-K pattern
Merge sort — Divide & conquer, stable, foundation cho external sort
Bài tiếpBinary heap & Heapsort — Build-heap O(n) và priority queue backbone
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này