Binary heap & Heapsort — Build-heap O(n) và priority queue backbone
Heap là complete binary tree trong array; build-heap chạy O(n). Heapsort cho in-place O(n log n) guaranteed, nền tảng PriorityQueue và top-K pattern.
TL;DR: Binary heap là cây nhị phân đầy (complete binary tree) lưu trong mảng, không cần pointer: parent ở index (i-1)/2, con trái ở 2i+1, con phải ở 2i+2 (đánh số từ 0). Hai thao tác cốt lõi là sift-up (dùng cho insert, O(log n)) và sift-down (dùng cho extract-min và build-heap, O(log n)). Build-heap từ n phần tử bất kỳ chạy O(n), không phải O(n log n) như nhiều người nghĩ, vì một nửa số node là leaf nên tốn 0 bước, và tổng các bước hội tụ nhờ chuỗi cấp số nhân (geometric series). Heapsort = build max-heap O(n) + n lần extract-max O(log n) = O(n log n) ở mọi trường hợp, in-place, không stable. Trong thực tế nó thua Quick sort vì tận dụng cache kém, nhưng thắng khi cần O(1) bộ nhớ phụ và worst case O(n log n) được đảm bảo.
Bài Priority queue: giới thiệu đã dùng PriorityQueue để giải top-K qua API offer, poll, peek và nói qua sift-up, sift-down. Phần chứng minh buildHeap O(n) và heapsort được để dành cho bài này.
Câu hỏi cốt lõi: new PriorityQueue<>(collection) nhận một Collection n phần tử và dựng thành heap. Việc đó mất bao nhiêu thời gian? Nhiều junior trả lời "O(n log n)" vì nghĩ đó là n lần insert, mỗi lần O(log n). Đáp án đúng là O(n), và chứng minh vì sao là một trong những phân tích đẹp nhất trong thuật toán.
Bài này dạy cấu trúc heap, sift-up / sift-down, chứng minh build-heap O(n), pseudocode heapsort in-place, và nền tảng để hiểu Dijkstra cũng như indexed PQ khi cần decrease-key.
1. Hình dung: Tháp ưu tiên một chiều
Hình dung một tháp đèn tín hiệu xếp tầng: mỗi ô là một task với độ ưu tiên. Quy tắc duy nhất: ô trên luôn có ưu tiên cao hơn hoặc bằng ô dưới. Tháp luôn "đầy từ trái", không bao giờ có lỗ trống ở giữa.
Khi thêm task mới: đặt vào ô cuối cùng còn trống (tầng thấp nhất, trái nhất), rồi "đẩy lên" cho đến khi quy tắc được thoả. Khi lấy task ưu tiên cao nhất: lấy đỉnh tháp, đưa ô cuối lên thay, rồi "thả xuống" cho đến khi quy tắc được thoả.
| Tháp ưu tiên | Binary heap |
|---|---|
| Mỗi ô là một task | Mỗi node lưu một phần tử |
| Quy tắc: ô trên cao hơn hoặc bằng ô dưới | Heap property (tính chất heap): parent nhỏ hơn hoặc bằng cả hai con (min-heap) |
| Tháp đầy từ trái, không lỗ trống | Complete binary tree |
| Đặt vào cuối rồi đẩy lên | Insert = append + sift-up |
| Lấy đỉnh, đưa cuối lên thay, thả xuống | Extract-min = swap root với last + sift-down |
| Lưu tháp bằng mảng đánh số | Lưu cây trong mảng, tính vị trí bằng công thức index |
Heap không phải mảng đã sắp xếp: nó chỉ đảm bảo parent tốt hơn con. Root luôn là phần tử tốt nhất, còn thứ tự giữa các node anh em và giữa các tầng khác là tuỳ ý.
2. Cấu trúc binary heap
2.1 Complete binary tree và heap property
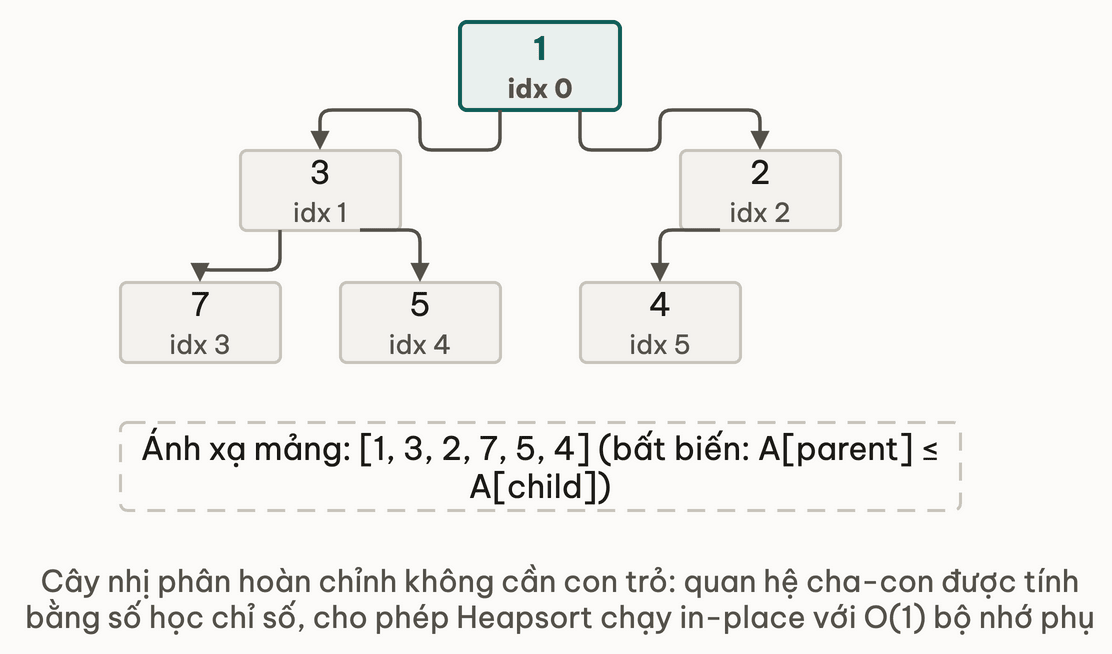
Complete binary tree: mọi tầng đều đầy trừ tầng cuối cùng. Tầng cuối được lấp từ trái sang phải, không bao giờ có lỗ trống bên trái mà lại có node bên phải.
Level 0:         1          -- root
Level 1:       3   2
Level 2:      7  5 4        -- level cuối, lấp từ trái
Heap property (min-heap): với mọi node i, giá trị của parent(i) nhỏ hơn hoặc bằng giá trị của i, nên root là phần tử nhỏ nhất của cả cây. Max-heap thì ngược lại.
2.2 Lưu trong array: index arithmetic
Vì complete binary tree không có lỗ trống, ta lưu thẳng vào mảng mà không cần pointer. Dùng cách đánh số từ 0 (chuẩn Java):
Mảng: [1, 3, 2, 7, 5, 4]
Index: 0  1  2  3  4  5

Ánh xạ cây (0-indexed):
  parent(i) = (i - 1) / 2
  left(i)   = 2 * i + 1
  right(i)  = 2 * i + 2

Kiểm tra: parent(3) = (3-1)/2 = 1  -> heap[1] = 3  (cha của 7)
          left(1)   = 2*1+1   = 3  -> heap[3] = 7  (con trái của 3)
          right(1)  = 2*1+2   = 4  -> heap[4] = 5  (con phải của 3)
Java PriorityQueue đánh số từ 0. Một số giáo trình (CLRS) đánh số từ 1 để công thức gọn hơn: parent = i/2, left = 2i, right = 2i+1. Hai cách tương đương, chỉ cần dùng nhất quán.
Mảng tận dụng cache tốt hơn cây liên kết: parent và con nằm gần nhau trong bộ nhớ, không phải đi theo pointer. Mỗi node cũng không tốn thêm chi phí phụ cho pointer. Đó là lý do heap dùng mảng thay vì cây pointer.
3. Sift-up và sift-down: hai operation cốt lõi
3.1 Sift-up (dùng cho insert)
Sau khi thêm phần tử mới vào cuối mảng, heap property có thể bị vi phạm tại node mới (nó có thể nhỏ hơn parent). Sift-up sửa bằng cách đổi chỗ với parent liên tục cho đến khi tính chất được khôi phục.
SiftUp(heap, i):
    while i > 0:
        parent <- (i - 1) / 2
        if heap[i] < heap[parent]:           -- min-heap: node nhỏ hơn parent thì đẩy lên
            swap heap[i] và heap[parent]
            i <- parent
        else:
            break                            -- heap property đã thỏa mãn, dừng

Insert(heap, value):
    heap[size] <- value
    SiftUp(heap, size)
    size <- size + 1
Time: O(log n) Space: O(1)
3.2 Sift-down (dùng cho extract-min và build-heap)
Sau khi lấy root (giá trị nhỏ nhất), đưa phần tử cuối cùng lên làm root rồi giảm size. Root mới có thể lớn hơn một hoặc cả hai con. Sift-down sửa bằng cách liên tục đổi chỗ với con nhỏ nhất cho đến khi tính chất được khôi phục.
SiftDown(heap, i, size):
    while true:
        left    <- 2 * i + 1
        right   <- 2 * i + 2
        smallest <- i

        if left < size và heap[left] < heap[smallest]:
            smallest <- left
        if right < size và heap[right] < heap[smallest]:
            smallest <- right

        if smallest = i: break              -- cả hai con >= i, heap property thỏa mãn

        swap heap[i] và heap[smallest]
        i <- smallest

ExtractMin(heap, size):
    min <- heap[0]
    size <- size - 1
    heap[0] <- heap[size]                  -- đưa phần tử cuối lên root
    SiftDown(heap, 0, size)                -- khôi phục heap property từ root
    return min
Time: O(log n) Space: O(1)
| Operation | Dùng | Hướng đi | Complexity |
|---|---|---|---|
| Sift-up | Insert | Từ leaf lên root | O(log n) |
| Sift-down | Extract-min, build-heap | Từ root xuống leaf | O(log n) |
Thử ngẫmExtractMin đưa phần tử cuối lên root rồi sift-down; Insert thêm vào cuối rồi sift-up. Một thao tác replace(old, new) cần gộp cả hai bước đó. Làm sao để vẫn chỉ tốn một lần O(log n)?
4. Build-heap: O(n) không phải O(n log n)
Cho mảng n phần tử bất kỳ, ta muốn biến nó thành min-heap. Có hai cách:
Cách ngây thơ: insert từng phần tử vào heap rỗng, sift-up mỗi lần.
-- Ngây thơ: n lần insert, mỗi lần O(log n) -> O(n log n) tổng
for each x trong A:
    Insert(heap, x)    -- append + sift-up
Time: O(n log n) Space: O(1)
Cách thông minh, build-heap O(n): sift-down từ node cuối cùng không phải leaf (index n/2 - 1) ngược về root.
BuildHeap(A):
    size <- A.length
    -- bắt đầu từ node cuối không phải leaf, sift-down về phía root
    for i <- A.length/2 - 1 xuống 0:
        SiftDown(A, i, size)
Time: O(n) Space: O(1)
Tại sao bắt đầu từ n/2 - 1? Vì các node từ n/2 đến n-1 là leaf, chúng đã là heap hợp lệ (cây một node luôn thoả heap property). Chỉ cần sift-down các node trong (internal node). Chọn sai biên ở đây (n/2 thay vì n/2 - 1) là lỗi off-by-one hay gặp; thói quen soát biên có ở edge case.
Trace với min-heap, mảng [5, 3, 8, 1, 4, 2] (n = 6, bắt đầu từ i = 6/2 - 1 = 2). Nếu chưa quen theo dõi từng bước, ôn lại bảng trace:
| i | Node | Đổi chỗ với | Mảng sau bước |
|---|---|---|---|
| 2 | 8 | con 2 | 5 3 2 1 4 8 |
| 1 | 3 | con 1 | 5 1 2 3 4 8 |
| 0 | 5 | con 1, rồi con 3 | 1 3 2 5 4 8 |
4.1 Chứng minh O(n): geometric series
Sift-down trên node ở chiều cao h (tính từ leaf lên) tốn tối đa O(h) bước. Trong cây n node:
- Số node ở chiều cao h tối đa bằng
ceil(n / 2^(h+1)) - Chiều cao tối đa của cây là
floor(log n)
Tổng công việc:
T(n) = SUM_{h=0}^{floor(log n)} ceil(n / 2^(h+1)) × O(h)
     = O(n) × SUM_{h=0}^{infinity} h / 2^h
     = O(n) × 2          -- geometric series: SUM h/2^h = 2
     = O(n)
Trực giác: một nửa số node là leaf (chiều cao 0), sift-down tốn 0 bước. Một phần tư node ở chiều cao 1, tốn tối đa 1 bước. Một phần tám ở chiều cao 2, tối đa 2 bước. Tổng hội tụ về O(n) vì các node ở trên cao (tốn nhiều bước) có số lượng giảm theo cấp số nhân.
Java PriorityQueue(Collection) gọi heapify() trong PriorityQueue.java, tức là build-heap O(n), không phải n lần insert O(n log n). Vì vậy khi khởi tạo từ Collection, hãy dùng constructor thay vì vòng lặp add.
Nhiều lập trình viên viết vòng lặp thêm từng phần tử vào PQ thay vì dùng constructor nhận collection. Kết quả là O(n log n) thay vì O(n). Trường hợp xấu (dữ liệu đến theo thứ tự làm mọi lần sift-up đi hết chiều cao) thì chênh lệch rõ; với dữ liệu ngẫu nhiên thì thực tế chênh nhỏ hơn, nhưng constructor vẫn đảm bảo O(n).
5. Heapsort: in-place O(n log n) guaranteed
Heapsort kết hợp build-heap với việc extract-max lặp đi lặp lại để sort tăng dần ngay trong mảng.
Mẹo: dùng max-heap để sort tăng dần. Lấy max ra, đặt vào cuối mảng (vị trí đúng vĩnh viễn), rồi lặp lại cho phần còn lại.
HeapSort(A):
    n <- A.length

    -- Giai đoạn 1: build max-heap tại chỗ
    -- (sort tăng dần cần max-heap để phần tử lớn nhất đi về cuối)
    for i <- n/2 - 1 xuống 0:
        SiftDownMax(A, i, n)

    -- Giai đoạn 2: lặp lấy max, đặt về cuối
    for i <- n-1 xuống 1:
        -- A[0] = max hiện tại; swap về vị trí i (vị trí sorted cuối cùng)
        swap A[0] và A[i]
        -- thu nhỏ heap 1 đơn vị (A[i] đã sorted), khôi phục max-heap cho A[0..i-1]
        SiftDownMax(A, 0, i)

SiftDownMax(A, i, size):
    while true:
        left    <- 2 * i + 1
        right   <- 2 * i + 2
        largest <- i

        if left < size và A[left] > A[largest]:   largest <- left
        if right < size và A[right] > A[largest]: largest <- right

        if largest = i: break

        swap A[i] và A[largest]
        i <- largest
Time: O(n log n) Space: O(1)
Trace ví dụ: [3, 1, 4, 1, 5, 9, 2, 6]
Giai đoạn 1 -- build max-heap:
  Ban đầu: [3, 1, 4, 1, 5, 9, 2, 6]
  Sau buildHeap: [9, 6, 4, 1, 5, 3, 2, 1]  -- max-heap: 9 ở root

Giai đoạn 2 -- lấy max lặp lại:
  i=7: swap A[0]=9 với A[7]=1 -> [1, 6, 4, 1, 5, 3, 2, | 9]
       SiftDownMax(0, 7)       -> [6, 5, 4, 1, 1, 3, 2, | 9]
  i=6: swap A[0]=6 với A[6]=2 -> [2, 5, 4, 1, 1, 3, | 6, 9]
       SiftDownMax(0, 6)       -> [5, 2, 4, 1, 1, 3, | 6, 9]
  ... (tiếp tục)
  Cuối cùng: [1, 1, 2, 3, 4, 5, 6, 9]  -- sorted tăng dần
5.1 Properties của heapsort
- In-place: chỉ tốn O(1) bộ nhớ phụ, sort ngay trên mảng gốc. Giai đoạn 2 dùng phần cuối mảng làm vùng đã sắp xếp thay cho buffer đầu ra.
- O(n log n) ở mọi trường hợp: best = average = worst. Build-heap O(n) cộng n lần sift-down O(log n) cho O(n log n), được đảm bảo.
- Không stable: swap trong sift-down có thể đổi chỗ các phần tử bằng nhau.
Thử ngẫmheapsort in-place và luôn O(n log n) ở mọi trường hợp, nhưng không stable. Sort một danh sách log theo timestamp rồi theo severity, heapsort ở bước hai còn giữ đúng thứ tự timestamp trong các severity bằng nhau không?
6. So sánh heapsort với Merge sort và Quick sort
| Algorithm | Best | Average | Worst | Space | Stable | Adaptive |
|---|---|---|---|---|---|---|
| Heapsort | n log n | n log n | n log n | O(1) | Không | Không |
| Quick sort | n log n | n log n | n² | O(log n) | Không | Không |
| Merge sort | n log n | n log n | n log n | O(n) | Có | Không |
Nhận xét thực tế: trên giấy tờ Heapsort rất hấp dẫn (worst case được đảm bảo, in-place), nhưng thực tế nó thường chậm hơn Quick sort trên dữ liệu ngẫu nhiên vì tận dụng cache kém. Sift-down nhảy đến index 2i+1, và trên mảng lớn khoảng cách đó vượt một cache line. Partition của Quick sort đọc bộ nhớ gần như tuần tự nên CPU đoán trước (prefetch) được.
Merge sort tuy dùng buffer O(n) nhưng đọc bộ nhớ rất tuần tự nên tận dụng cache tốt, thường nhanh hơn Heapsort trên dataset lớn.
Heapsort thắng khi: hệ thống nhúng (embedded) không đủ bộ nhớ cho buffer (không cấp phát nổi O(n) phụ), hoặc cần worst case O(n log n) được đảm bảo mà không dùng được bộ nhớ phụ O(n).
Introsort là Quick sort kèm một lưới an toàn: nếu độ sâu đệ quy vượt ngưỡng (dấu hiệu Quick sort đang suy biến), nó chuyển sang Heapsort để đảm bảo worst case O(n log n). Dual-Pivot Quicksort trong JDK 21 có nhánh chuyển sang heap sort kiểu này. Quick sort lo tốc độ trung bình, Heapsort lo worst case.
7. Bẫy thường gặp
Bẫy 1: Loop add thay constructor: O(n log n) thay O(n)
-- CHẬM: n × O(log n) = O(n log n)
-- thêm từng phần tử vào PQ rỗng bằng vòng lặp
for each x trong data:
    PQ.add(x)    -- mỗi add() là sift-up O(log n)

-- NHANH: O(n) -- constructor gọi heapify() bên trong
-- PriorityQueue(data)  -- build-heap O(n)
Vòng lặp add() là O(n log n) trong trường hợp xấu; constructor luôn O(n).
Bẫy 2: PriorityQueue iterator không trả về sorted order
-- SAI: for-each duyệt mảng bên trong theo thứ tự heap (KHÔNG sorted)
-- for each x trong PQ:
--     print x   -- có thể in: 1 3 8 5 -- heap order

-- ĐÚNG: poll() lặp lại để ra thứ tự sorted
-- while PQ không rỗng:
--     print PQ.poll()   -- in: 1 3 5 8
iterator() của PriorityQueue duyệt mảng bên trong theo thứ tự index, tức là thứ tự heap chứ không phải sorted. Bài Priority queue: giới thiệu cũng nhắc đúng bẫy này.
Bẫy 3: Heapsort thường thua Quick sort trên random data dù cùng Big-O
Lý do đã nói ở mục 6: sift-down nhảy tới index 2i+1 và 2i+2, với mảng lớn khoảng cách đó vượt một cache line (64 byte) nên cache miss nhiều, còn partition của Quick sort đọc tuần tự. Xem Memory và cache locality.
Thử ngẫmsift-down nhảy tới index 2i+1/2i+2, bước nhảy đó vượt cache line 64 byte và gây cache miss. Với một heap chỉ vài chục phần tử, vừa đủ trong một cache line, khoảng cách về tốc độ so với Quick sort còn giữ nguyên không?
8. Indexed PQ: khi cần decrease-key
PriorityQueue thường không hỗ trợ "cập nhật priority của phần tử đã có trong heap" theo O(log n), vì nó không biết phần tử đó đang ở index nào trong mảng bên trong.
Indexed PQ giải quyết bằng cách thêm một map từ key sang index:
-- Indexed MinHeap (rút gọn)
-- Duy trì: heap[] + positionOf[] (key -> index trong heap)

Swap(i, j):
    positionOf[heap[i]] <- j          -- cập nhật vị trí sau swap
    positionOf[heap[j]] <- i
    swap heap[i] và heap[j]

DecreaseKey(key, newPriority):
    idx <- positionOf[key]            -- tìm vị trí hiện tại của key
    heap[idx] <- newPriority          -- cập nhật giá trị
    SiftUp(idx)                       -- có thể cần đẩy lên
Time: O(log n) Space: O(n)
decrease-key quan trọng cho Dijkstra shortest path: khi tìm được đường ngắn hơn đến đỉnh v, cần giảm distance của v trong PQ. PQ thường không làm được việc này, nên phải insert lại với distance mới và chấp nhận các entry cũ còn sót lại (hoặc dùng Indexed PQ thật sự).
Bài Dijkstra cài đầy đủ với chiến lược PQ này.
9. Ứng dụng thực tế
Java PriorityQueue: min-heap trong mảng; PriorityQueue(Collection) gọi heapify() (build-heap O(n)), offer() gọi siftUp, poll() gọi siftDown. Xem Priority queue: giới thiệu.
Dijkstra shortest path (bài Dijkstra) dùng min-heap để chọn đỉnh có distance ước lượng nhỏ nhất ở mỗi bước relax (cập nhật lại distance qua một cạnh). Với đồ thị thưa, độ phức tạp là O((V+E) log V), nhanh hơn hẳn O(V²) khi không dùng PQ.
Linux CFS scheduler, vì sao dùng cây đỏ-đen thay heap: scheduler cần lấy task có virtual runtime nhỏ nhất, nhưng cũng cần xoá một task bất kỳ khi nó ngủ hoặc bị kill, và duyệt các task theo thứ tự. Heap lấy min nhanh nhưng xoá phần tử bất kỳ không có chỉ số sẵn thì tốn O(n); cây đỏ-đen xoá trong O(log n) và duyệt theo thứ tự tự nhiên. (Từ Linux 6.6 CFS được thay bằng EEVDF, vẫn dựa trên cây cân bằng.) Xem Self-balancing tree.
10. Đào sâu
- Introduction to Algorithms (CLRS), chương 6: mục 6.3 có chứng minh build-heap O(n) bằng geometric series.
- The Art of Computer Programming, Vol. 3 (Knuth), mục 5.2.3 (Sorting by Selection).
- J.W.J. Williams (1964), "Algorithm 232: Heapsort", Communications of the ACM.
- OpenJDK
PriorityQueue.java: đọcsiftUp(),siftDown(),heapify(). - Self-balancing tree và Dijkstra.
Bài liên quan trong khoá học:
- Priority Queue & Heap: cấu trúc cây nhị phân trên mảng.
- Thuật toán Dijkstra: tận dụng Min-Heap tìm đỉnh gần nhất.
11. Tóm tắt
Checklist khi dùng heap:
- Biết sẵn cả collection thì dùng
new PriorityQueue<>(collection)(build-heap O(n)), đừng gọiadd()trong vòng lặp (O(n log n)). - Muốn lấy phần tử theo thứ tự thì gọi
poll()lặp lại; duyệtPriorityQueuebằng iterator cho ra thứ tự heap, không phải thứ tự đã sắp xếp. - Top-K trên dữ liệu lớn: giữ heap kích thước K, O(n log k) thay vì sort toàn bộ.
- Cần
decrease-key(Dijkstra) thì dùng indexed priority queue, vìPriorityQueuecủa Java không có sẵn. - Cần sort in-place với worst case O(n log n) được đảm bảo thì dùng được Heapsort, nhưng nó thường chậm hơn Quick sort vì cache miss, và không stable.
12. Tự kiểm tra
- Q1Build-heap là O(n) chứ không phải O(n log n). Trực giác nào giải thích điều đó, và vì sao geometric series hội tụ?
- Q2Khi nào dùng sift-up, khi nào dùng sift-down? Có thể dùng sift-up để build-heap thay cho sift-down không?
- Q3Heapsort không stable. Đoạn nào trong heapsort phá stability?
- Q4Heap dùng mảng thay cho cây pointer. Công thức index của parent và các con là gì? Vì sao đánh số từ 0 và từ 1 cho công thức khác nhau?
- Q5Cho A = [3, 1, 4, 1, 5, 9, 2, 6]. Sau khi BuildHeap (max-heap), root là gì và mảng trông như thế nào?
- Q6Với scheduler của hệ điều hành, vì sao Linux CFS chọn cây đỏ-đen thay vì heap (PQ)?
Bài tiếp theo: Counting / Radix / Bucket sort — non-comparison O(n)
Quick sort — Pivot, partition, và Dual-Pivot trong JDK
Bài tiếpCounting / Radix / Bucket sort — Non-comparison O(n) khi key range nhỏ
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này