Mini-challenge — External merge sort: sort 10GB file với 1GB RAM
Implement ExternalSorter: chia file thành sorted chunk rồi k-way merge bằng min-heap — pattern Postgres ORDER BY, Lucene, Hadoop shuffle dùng khi data vượt RAM.
Production báo OOM (hết bộ nhớ): bạn nhận việc sort một file text 10GB, mỗi dòng một số nguyên, trên máy chỉ có 1GB RAM. Nạp cả file lên rồi gọi sort thì hết bộ nhớ ngay.
Database cũng gặp đúng vấn đề này: ORDER BY trên tập kết quả vượt work_mem trong PostgreSQL sẽ đẩy xuống disk thay vì crash, và cách làm bên dưới y hệt: chia dữ liệu thành các chunk vừa RAM, sort từng chunk, rồi k-way merge.
Bài này luyện cách làm external merge sort: chia file, sort từng chunk, rồi k-way merge. Làm xong, bạn sẽ hiểu thuật toán sort mà Postgres, Lucene và Hadoop dùng.
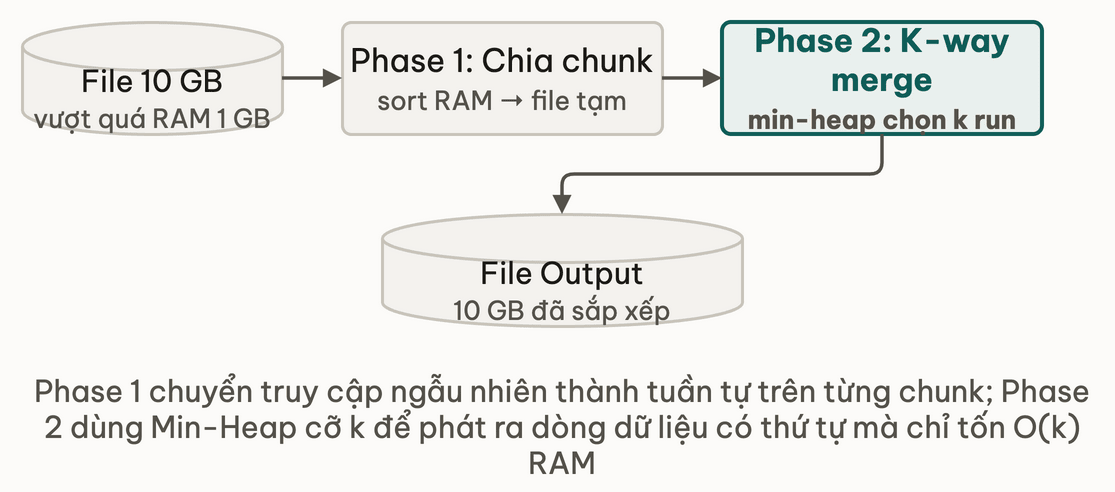
Yêu cầu bài toán
Viết class ExternalSorter với API sau:
sort(inputFile, outputFile, chunkSize): sort toàn bộ file thành file kết quả tăng dần.- Ràng buộc: bộ nhớ chỉ giữ tối đa
chunkSizesố nguyên cùng lúc (Phase 1) cộng một buffer nhỏ cho bước merge (Phase 2, tối đa k số nguyên với k = số chunk). - Kết quả: tăng dần, mỗi số nguyên một dòng.
Test scenario
Sinh input: 1 triệu số nguyên (giá trị dưới 10 triệu), mỗi dòng một số, file cỡ vài MB.
Sort với chunkSize = 100_000 (100 nghìn số mỗi chunk, tức 10 chunk).
Kiểm tra: output đã sắp xếp, số lượng và tổng giống input.
Starter code
Dưới đây là khung pseudocode mô tả API cần cài:
ExternalSorter.sort(inputFile, outputFile, chunkSize):
    -- Phase 1: chia input thành các chunk đã sắp xếp
    chunks <- splitAndSort(inputFile, chunkSize)

    -- Phase 2: k-way merge tất cả chunk vào output
    kWayMerge(chunks, outputFile)

    -- Dọn dẹp file tạm
    for each chunk trong chunks:
        delete(chunk)

splitAndSort(inputFile, chunkSize):
    -- TODO: tự cài
    return []

kWayMerge(chunks, outputFile):
    -- TODO: tự cài
Trước khi code, hãy làm tay với 9 số chia thành 3 chunk (cách làm này ở làm tay trước khi làm máy): sort từng chunk, rồi lặp lại việc so ba số đầu của ba chunk và lấy số nhỏ nhất. Sau đó dành 25-30 phút tự làm trước khi xem gợi ý.
Test harness (Java)
-- Sinh 1 triệu số nguyên ngẫu nhiên vào file input
input  <- tempFile("sort-input.txt")
output <- tempFile("sort-output.txt")

expectedSum <- 0
for i <- 0 đến 999_999:
    v <- Random.nextInt(10_000_000)
    expectedSum <- expectedSum + v
    writeLine(input, v)

-- Chạy sort
start <- currentTimeNanos()
ExternalSorter.sort(input, output, chunkSize=100_000)
ms <- (currentTimeNanos() - start) / 1_000_000
print("Sort done in " + ms + " ms")

-- Kiểm tra: đã sắp xếp + đủ số lượng + đúng tổng
count <- 0
actualSum <- 0
prev <- LONG_MIN
for each line trong output:
    v <- parseLong(line)
    if v < prev:
        throw "NOT SORTED at line " + count
    prev <- v
    actualSum <- actualSum + v
    count <- count + 1

assert count = 1_000_000
assert actualSum = expectedSum
print("PASS: sorted, count=1000000, sum verified")
Gợi ý
Đọc input từng dòng một, gom vào mảng kích thước chunkSize.
Khi mảng đầy: sort mảng, ghi ra file tạm, đặt index về 0.
Trường hợp biên: đọc hết file mà index vẫn lớn hơn 0 nghĩa là còn một chunk chưa đầy, chunk này cũng phải sort và ghi ra file tạm.
splitAndSort(inputFile, chunkSize):
    chunks <- []
    buffer[0..chunkSize-1] <- 0
    idx <- 0

    for each line trong inputFile:
        buffer[idx] <- parseInt(line)
        idx <- idx + 1
        if idx = chunkSize:
            chunks.append(writeSortedChunk(buffer, idx))
            idx <- 0

    if idx > 0:
        chunks.append(writeSortedChunk(buffer, idx))

    return chunks
Time: O(n log(chunkSize)) Space: O(chunkSize)
writeSortedChunk nhận buffer và len, sort đoạn buffer[0..len-1], rồi ghi từng số ra một dòng của file tạm.
Kết quả: danh sách các file tạm, mỗi file đã sắp xếp tăng dần.
Mở tất cả N file tạm (N reader).
Đọc số đầu tiên từ mỗi file, push vào min-heap dưới dạng (value, fileIndex).
Vòng lặp chính:
kWayMerge(chunks, outputFile):
    readers[0..N-1] <- mở từng chunk file
    heap <- MinHeap rỗng

    -- Nạp phần tử đầu tiên từ mỗi chunk
    for i <- 0 đến N-1:
        line <- readers[i].readLine()
        if line != null:
            heap.push((parseInt(line), i))

    -- Vòng lặp merge: luôn lấy giá trị nhỏ nhất toàn cục
    writer <- mở outputFile để ghi
    while heap không rỗng:
        (value, fileIdx) <- heap.pop()
        writer.writeLine(value)

        -- Đọc phần tử tiếp theo từ file vừa cho ra giá trị nhỏ nhất
        next <- readers[fileIdx].readLine()
        if next != null:
            heap.push((parseInt(next), fileIdx))

    đóng writer
    đóng tất cả readers
Time: O(n log k) Space: O(k), heap chỉ giữ tối đa k phần tử (k = số chunk)
Điểm quan trọng: heap chỉ giữ tối đa N số nguyên (N = số chunk), không phải toàn bộ dữ liệu. Bộ nhớ bị chặn bởi số file chứ không phụ thuộc kích thước file.
Tự động đóng file: dùng try-with-resources hoặc khối finally để mọi reader/writer đều được đóng, kể cả khi có exception.
Giới hạn file handle của hệ điều hành: N file được mở cùng lúc. Với 1M số nguyên và chunkSize 100k thì N = 10, không sao. Nhưng nếu file lớn hơn hoặc chunkSize nhỏ hơn, N có thể vượt nghìn. Mặc định ulimit -n trên Linux là 1024. Cách sửa: merge nhiều lượt (multi-pass), gộp 500 file thành 1, rồi merge tiếp ở cấp cao hơn.
File rỗng, file ít hơn một chunk, dòng trống: thử cả ba trường hợp; đây là loại edge case hay làm parseInt ném exception. Nếu code chạy nhưng kết quả sai, hãy đặt giả thuyết rồi kiểm từng giả thuyết một thay vì sửa bừa (sửa bằng giả thuyết).
Charset: đảm bảo encoding khi ghi và khi đọc giống nhau. Chỉ cần chú ý khi file input đến từ nguồn bên ngoài.
Lời giải
Pseudocode lời giải đầy đủ:
ExternalSorter.sort(input, output, chunkSize):
    chunks <- splitAndSort(input, chunkSize)
    kWayMerge(chunks, output)
    for each c trong chunks:
        deleteFile(c)

-- Phase 1: đọc input, chia chunk, sort, ghi ra file tạm
splitAndSort(input, chunkSize):
    chunks <- []
    buffer[0..chunkSize-1] <- 0
    idx <- 0

    for each line trong readLines(input):
        buffer[idx] <- parseInt(line)
        idx <- idx + 1
        if idx = chunkSize:
            chunks.append(writeSortedChunk(buffer, idx))
            idx <- 0

    if idx > 0:
        chunks.append(writeSortedChunk(buffer, idx))
    return chunks

-- Sort buffer[0..len-1] rồi ghi ra file tạm
writeSortedChunk(buffer, len):
    sorted <- copy(buffer, 0, len)
    Sort(sorted)                          -- sort trong RAM (O(len log len))
    chunk <- createTempFile("ext-sort-")
    for each v trong sorted:
        writeLine(chunk, v)
    return chunk

-- Phase 2: mở tất cả chunk, k-way merge vào output
kWayMerge(chunks, output):
    N <- length(chunks)
    readers[0..N-1] <- mở từng chunk để đọc
    heap <- MinHeap rỗng (so sánh theo value)

    -- Nạp phần tử đầu từ mỗi chunk
    for i <- 0 đến N-1:
        line <- readers[i].readLine()
        if line != null:
            heap.push((parseInt(line), i))

    writer <- mở output để ghi
    while heap không rỗng:
        (val, fileIdx) <- heap.pop()      -- lấy giá trị nhỏ nhất toàn cục
        writer.writeLine(val)
        next <- readers[fileIdx].readLine()
        if next != null:
            heap.push((parseInt(next), fileIdx))

    đóng writer
    đóng tất cả readers trong finally
Time: O(n log chunkSize) Phase 1 + O(n log k) Phase 2 Space: O(chunkSize + k)
Ý then chốt: vì sao bộ nhớ bị chặn:
Phase 1: chỉ giữ buffer[chunkSize], ví dụ 100k số nguyên là khoảng 400KB.
Phase 2: heap giữ tối đa N số nguyên (N = số chunk). Với 1M số nguyên và chunkSize 100k, N = 10. Min-heap chỉ có 10 phần tử dù file lớn đến đâu.
Bẫy thường gặp
Bẫy 1: Rò rỉ file handle (file handle leak): quên đóng reader trong finally.
-- BUG: exception trong kWayMerge làm bỏ qua lệnh đóng
kWayMerge(chunks, output):
    for i <- 0 đến N-1:
        readers[i] <- openFile(chunks[i])   -- mở file
    -- ... merge logic có thể throw ...
    for each r trong readers:
        r.close()   -- KHÔNG BAO GIỜ ĐẾN ĐÂY nếu có exception

-- ĐÚNG: dùng finally đảm bảo luôn đóng
kWayMerge(chunks, output):
    readers <- []
    try:
        for i <- 0 đến N-1:
            readers[i] <- openFile(chunks[i])
        -- ... merge logic ...
    finally:
        for each r trong readers:
            if r != null: r.close()
Với N lớn (nghìn chunk), mỗi reader mở 1 file descriptor. Khi có exception mà close không được gọi, các file descriptor bị rò rỉ dồn lại và dẫn đến lỗi hệ điều hành "Too many open files".
Bẫy 2: Charset encoding: đoán sai encoding của input file.
-- Luôn ghi rõ charset khi mở file
reader <- openFile(path, charset=UTF_8)
writer <- openFile(path, charset=UTF_8)
-- Tránh dùng charset mặc định của hệ điều hành (có thể thay đổi)
File tạo từ trình soạn thảo trên Windows có thể là UTF-16 kèm BOM, hoặc Windows-1252. Khi gặp ký tự lạ, parseInt ném exception chứ không báo lỗi encoding rõ ràng nên rất khó debug. Hãy chỉ định charset rõ ràng ngay từ đầu.
Bẫy 3: Quên flush writer: mất dữ liệu ở cuối file.
-- NGUY HIỂM: lệnh close thủ công có thể bị bỏ qua khi có exception
writer <- openFile(output)
-- ... ghi dữ liệu ...
writer.close()   -- gọi flush() bên trong, nhưng nếu exception xảy ra trước thì bỏ qua

-- AN TOÀN: try-with-resources đảm bảo flush và close luôn chạy
try writer <- openFile(output):
    -- ... ghi dữ liệu ...
-- tự flush và close ở đây, kể cả khi có exception
Ước lượng thô thời gian chạy
Đây là phép tính theo băng thông đĩa, không phải số đo thật. Với file 10GB, mỗi phase đọc 10GB và ghi 10GB, tức tổng cỡ 40GB I/O (một lượt chia chunk cộng một lượt merge; đúng mô hình external sort một lượt merge, mỗi phần tử bị đọc và ghi hai lần).
HDD tuần tự ~150 MB/s: 40GB / 150MB/s = khoảng 4-5 phút I/O
SSD tuần tự ~500 MB/s: 40GB / 500MB/s = khoảng 1-2 phút I/O
Cộng thêm CPU: parse text và sort từng chunk
Trên HDD, cả hai phase bị băng thông I/O chi phối; trên SSD thì Phase 1 dễ chuyển sang bị CPU chặn (parse text và sort). Tăng RAM để tăng chunkSize thì có ít chunk hơn, Phase 2 mở ít file hơn. Cho nhiều thread sort chunk song song thì phần CPU của Phase 1 nhanh hơn đáng kể.
Variant để tự thử
Biến thể 1 — Thay sort trong Phase 1 bằng Counting sort: Nếu biết khoảng giá trị (ví dụ 0 đến 9,999,999), Counting sort tốn O(n + range) thay vì O(n log n). Nhưng range 10M lớn gấp 100 lần n = 100k, nên mỗi chunk phải cấp mảng đếm khổng lồ và nhiều khả năng thua; hãy tự benchmark (xem bẫy range lớn).
Biến thể 2 — Merge nhiều lượt khi N vượt 1000:
Nếu chunkSize nhỏ và file lớn, N chunk có thể vượt ulimit -n. Cách sửa: mỗi lượt merge tối đa 500 file thành 1, lặp lại đến khi còn 1 file. Đây là cách sort trên Unix xử lý file khổng lồ.
Biến thể 3 — Nén file chunk: Ghi chunk qua nén (gzip). Đổi CPU lấy băng thông IO: file chunk nhỏ đi 3-5 lần, Phase 2 đọc ít byte hơn. Hiệu quả khi IO đĩa là nút thắt (HDD).
Biến thể 4 — Chạy song song bước chia chunk: Phase 1 sort từng chunk độc lập với nhau nên chạy song song được hoàn toàn. Dùng nhiều thread để sort cùng lúc. Phase 2 vẫn tuần tự (merge một lượt). Phase 1 nhanh lên gần tuyến tính theo số core.
Thử ngẫmbiến thể 4 giúp Phase 1 nhanh lên gần tuyến tính theo số core, nhưng Phase 2 vẫn tuần tự một lượt. Máy 32 core thì phase nào giờ trở thành nút thắt chính?
LeetCode liên quan
- 23. Merge k Sorted Lists — cùng kiểu k-way merge, nhưng dữ liệu nằm trong RAM thay vì trong file.
- 295. Find Median from Data Stream — xử lý luồng dữ liệu bằng heap.
- 692. Top K Frequent Words — top-K bằng min-heap (xem Heap sort).
Dùng ở đâu trong thực tế
PostgreSQL ORDER BY với work_mem: khi sort vượt work_mem (mặc định 4MB), Postgres dùng tuplesort: chia thành các sorted run trên disk rồi k-way merge ở cuối. Cùng cách làm của bài này, ở quy mô production.
Hadoop MapReduce shuffle phase: sau bước map, các record được sort theo key trước khi gửi đến reducer. Mỗi mapper sort partition của mình (Phase 1), reducer lấy về rồi k-way merge các partition đã sắp xếp (Phase 2). Đây là external sort phân tán.
Unix sort -S 1G huge_file.txt: cờ -S chỉ định kích thước buffer, tương đương chunkSize. Khi buffer đầy, sort ghi chunk ra file tạm, rồi k-way merge. GNU sort còn có --parallel cho Phase 1.
Đọc tiếp: Merge sort để học khái niệm k-way merge, và External sort ở khoá Thuật toán ứng dụng để xem thuật toán ngoài bộ nhớ ở quy mô lớn.
Điều bạn vừa làm được
- Hiểu external merge sort gồm hai phase: chia chunk và sort trong RAM, rồi k-way merge bằng min-heap.
- Hiểu vì sao min-heap ở Phase 2 chỉ giữ K số nguyên (K = số chunk), nên bộ nhớ bị chặn dù file lớn đến đâu.
- Biết ba bẫy: rò rỉ file handle khi không dùng finally, sai charset, quên flush writer.
- Nhận ra cách làm này là nền của PostgreSQL
tuplesort, Hadoop shuffle, Lucene segment merge và Unixsort. - Thấy các hướng tối ưu thực tế: tăng chunkSize (ít chunk, ít lượt merge), chạy song song Phase 1, nén chunk, merge nhiều lượt khi số chunk lớn.
Bài tiếp theo: Case Study: TimSort + Redis ZSET
Skip list — Probabilistic balanced, dễ implement hơn Red-Black tree
Bài tiếpTimSort & Redis ZSET — sort thắng ở production
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này