Skip list — Probabilistic balanced, dễ implement hơn Red-Black tree
Skip list đạt O(log n) kỳ vọng với code ngắn hơn nhiều so với Red-Black tree. Probabilistic analysis, pseudocode, so sánh RB tree, lý do Redis ZSET chọn skip list.
TL;DR: Skip list (William Pugh, 1990) là linked list nhiều tầng: tầng 0 (level 0) là linked list đã sắp xếp đầy đủ, mỗi tầng cao hơn lấy ngẫu nhiên khoảng 1/2 số node của tầng dưới. Search bắt đầu từ tầng cao nhất, đi xuống khi không tiến thêm được, đạt O(log n) kỳ vọng mà không cần phép xoay (rotation) hay điều kiện cân bằng (invariant) nào. Redis ZSET, LevelDB MemTable và Java ConcurrentSkipListMap đều dùng skip list vì code đơn giản hơn Red-Black tree rất nhiều, range scan tự nhiên qua level 0, và (với Java) dễ cài lock-free. Đánh đổi: worst case O(n) với xác suất cực thấp, và thường tốn thêm một ít bộ nhớ so với RB tree.
Bài Self-balancing tree đã dạy Red-Black tree: 5 điều kiện (invariant) về màu sắc, phép xoay (rotation) cần parent pointer, và chuỗi sửa lỗi (fixup) 3 trường hợp khi insert, 4 trường hợp khi delete. Các điều kiện phức tạp đến mức một lỗi nhỏ trong phép xoay có thể làm hỏng cả cây mà không crash ngay, chỉ trả kết quả sai.
Skip list (William Pugh, 1990) đạt O(log n) kỳ vọng cho search/insert/delete với phần lõi chỉ vài chục dòng code, không cần phép xoay hay điều kiện cân bằng nào. Redis ZSET, LevelDB MemTable và Java ConcurrentSkipListMap đều dùng nó. Bài này dạy cấu trúc skip list, phân tích xác suất, pseudocode, so sánh với RB tree, và lý do Redis chọn skip list cho ZSET.
1. Hình dung: Đường tàu nhiều tuyến
Hình dung một hệ thống tàu hỏa có nhiều tuyến chạy song song từ ga A đến ga Z.
Tàu chậm (level 0): ghé mọi ga — A, B, C, D, E, F, G, H, ..., Z. Tìm ga cần đến phải đi từng ga một, O(n).
Tàu nhanh (level 1): chỉ ghé ga lớn — A, C, E, G, I, ..., Z. Khoảng cách mỗi bước dài gấp đôi tàu chậm.
Tàu siêu tốc (level 2): chỉ ghé thành phố lớn — A, E, I, M, ..., Z. Mỗi bước dài gấp 4 lần tàu chậm.
Đi từ A đến Z: đi tàu siêu tốc đến gần Z, đổi sang tàu nhanh, cuối cùng đổi tàu chậm để về đúng ga. Tổng số bước là O(log n) thay vì O(n).
| Đường tàu | Skip list |
|---|---|
| Ga (node) | Node trong sorted linked list |
| Tàu chậm ghé mọi ga | Level 0: linked list đã sắp xếp đầy đủ |
| Tàu nhanh chỉ ghé ga lớn | Level 1: khoảng 1/2 số node |
| Tàu siêu tốc chỉ ghé thành phố | Level 2: khoảng 1/4 số node |
| Đi tàu nhanh rồi xuống tàu chậm | Search: bắt đầu từ level cao nhất, đi xuống dần |
| Chọn ngẫu nhiên ga nào thành "ga lớn" | Level của mỗi node chọn ngẫu nhiên |
Skip list là nhiều linked list chồng lên nhau, mỗi level "tốc hành" bỏ qua khoảng nửa số node. Tìm kiếm bắt đầu từ level cao nhất, đi xuống khi không tiến thêm được, tổng cộng O(log n) bước.
2. Cấu trúc skip list
Skip list là linked list nhiều tầng:
- Level 0: linked list đã sắp xếp đầy đủ, mọi node đều có mặt.
- Level 1: khoảng 1/2 số node của level 0, chọn ngẫu nhiên.
- Level 2: khoảng 1/2 số node của level 1, tức khoảng 1/4 toàn bộ.
- Tiếp tục cho đến
MAX_LEVEL.
Mỗi node có mảng forward[]: forward[i] trỏ đến node kế tiếp ở level i. Node header (node đánh dấu đầu, không chứa dữ liệu) có mặt ở mọi level và là điểm xuất phát của mọi search.
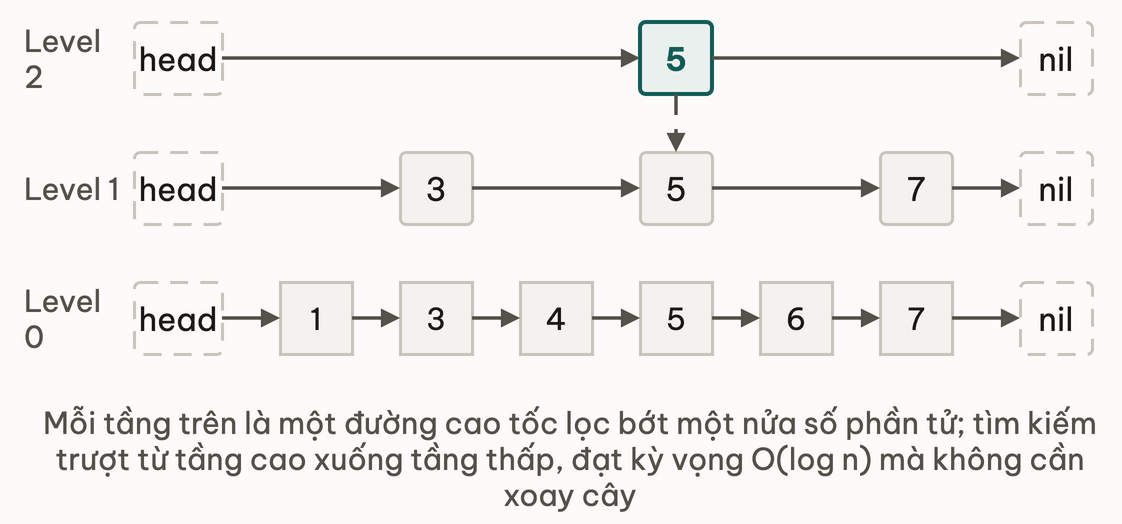
Sơ đồ skip list 3 tầng, 8 node (giá trị 1..8):

Level 2: header ---------------------------> [5] ---------------------> null
Level 1: header ------------> [3] --------> [5] --------> [7] -------> null
Level 0: header -> [1] -> [2] -> [3] -> [4] -> [5] -> [6] -> [7] -> [8] -> null
Node 5 có mặt ở cả 3 level, level cao nhất của nó là 2. Node 1, 2, 4, 6, 8 chỉ có ở level 0. Node 3, 7 có ở level 0 và 1.
Cấu trúc node:
Node:
    key      -- khoá để so sánh
    value    -- giá trị lưu trữ
    forward[0..level]  -- forward[i] = node kế tiếp tại level i
3. Search algorithm
Search đi từ level cao nhất xuống, và tiến về phía trước khi key kế tiếp nhỏ hơn target:
SkipListSearch(header, maxLevel, target):
    node <- header

    -- Bắt đầu từ level cao nhất, đi xuống dần
    for i <- maxLevel xuống 0:
        while node.forward[i] != null và node.forward[i].key < target:
            node <- node.forward[i]   -- tiến về phía trước ở level i
        -- node.forward[i].key >= target hoặc null: đi xuống level i-1

    -- Tiến thêm 1 bước ở level 0 rồi kiểm tra
    node <- node.forward[0]
    if node != null và node.key = target:
        return node.value
    return NOT_FOUND
Time: O(log n) kỳ vọng Space: O(1)
Trace ví dụ: tìm key 6 trong sơ đồ trên (cách đọc trace từng bước giống bảng trace; lưu ý search có hai vòng lặp lồng nhau, for đi xuống từng tầng và while đi ngang trong tầng, giống lặp lồng nhau):
Level 2: header -> [5]  (5 < 6, tiến)  -> null  (dừng, xuống level 1)
Level 1: [5]    -> [7]  (7 >= 6, dừng, xuống level 0)
Level 0: [5]    -> [6]  (6 == 6, tìm thấy!)
Chỉ cần 2 bước nhảy (header tới 5, rồi 5 tới 6) thay vì 6 bước nếu đi thẳng ở level 0.
Thử ngẫmtrace ở trên chỉ tốn 2 bước nhảy thay vì 6 nếu đi thẳng level 0, nhờ bắt đầu từ level cao nhất. Search một key không có trong list thì thuật toán dừng ở đâu và trả về gì?
4. Insert với probabilistic level
Insert gồm hai bước: (1) tìm vị trí insert và ghi lại update[], tức node đứng ngay trước vị trí insert ở mỗi level; (2) chọn level ngẫu nhiên cho node mới rồi nối nó vào list.
RandomLevel(P, MAX_LEVEL):
    -- Level chọn theo phân bố hình học (geometric)
    -- Xác suất level 0: (1-P), level 1: P*(1-P), level 2: P²*(1-P)...
    lvl <- 0
    while Random() < P và lvl < MAX_LEVEL:
        lvl <- lvl + 1
    return lvl
Time: O(1) expected Space: O(1)
SkipListInsert(header, level, key, value, P, MAX_LEVEL):
    -- Tìm update[i] = node cuối ở level i có key < key mới
    update[0..MAX_LEVEL] <- header
    node <- header

    for i <- level xuống 0:
        while node.forward[i] != null và node.forward[i].key < key:
            node <- node.forward[i]
        update[i] <- node

    -- Chọn level ngẫu nhiên cho node mới
    lvl <- RandomLevel(P, MAX_LEVEL)

    if lvl > level:
        -- Node mới đạt level chưa dùng -> gán header
        for i <- level+1 đến lvl:
            update[i] <- header
        level <- lvl

    -- Tạo node mới và nối vào list ở mỗi level
    newNode <- Node(key, value, lvl)
    for i <- 0 đến lvl:
        newNode.forward[i] <- update[i].forward[i]
        update[i].forward[i] <- newNode
Time: O(log n) kỳ vọng Space: O(1) kỳ vọng (cho node mới)
Ý then chốt: mỗi node nhận level theo phân bố hình học với tham số P. Với P = 0.5: xác suất level 0 là 50%, level 1 là 25%, level 2 là 12.5%... Số forward pointer trung bình của mỗi node là 1/(1-P) = 2. Không cần kiểm tra hay duy trì điều kiện cân bằng nào, tính ngẫu nhiên tự lo việc cân bằng.
5. Probabilistic analysis
Vì sao chọn level ngẫu nhiên lại đảm bảo O(log n)?
Số node ở mỗi level (kỳ vọng):
Level 0: n node           -- mọi node đều ở level 0
Level 1: n × P node       -- xác suất P = 0.5 => n/2 node
Level 2: n × P² node      -- => n/4 node
Level k: n × P^k node
Số level tối đa có ý nghĩa = log_(1/P)(n). Với P = 0.5 và n = 1,000,000: khoảng 20 level.
Số bước kỳ vọng ở mỗi level khi search:
- Ở mỗi level, trung bình đi về phía trước
1/Pbước thì gặp node quá lớn và phải xuống level dưới. - Số level phải đi qua:
log_(1/P)(n). - Tổng số bước kỳ vọng ≈
(1/P) × log_(1/P)(n)= O(log n).
Với P = 0.5: số bước kỳ vọng ≈ 2 × log₂(n). Với n = 1,000,000: khoảng 40 bước, cùng bậc với RB tree. Với P = 0.25 thì (1/P) × log_(1/P)(n) = 4 × log₄(n) = 2 × log₂(n): cùng hằng số dẫn đầu, nhưng ít pointer hơn (xem mục 8).
Worst case của skip list vẫn là O(n): có thể (dù cực kỳ hiếm) tất cả node đều chỉ có level 0. Nhưng xác suất xảy ra worst case giảm rất nhanh theo n, nên trong thực tế gần như không gặp. Red-Black tree đảm bảo O(log n), không dựa vào xác suất nào. Đó là chỗ đánh đổi cốt lõi.
6. Skip list vs Red-Black tree
| Tiêu chí | Skip list | Red-Black tree |
|---|---|---|
| Search | O(log n) kỳ vọng | O(log n) được đảm bảo |
| Insert | O(log n) kỳ vọng | O(log n) được đảm bảo |
| Delete | O(log n) kỳ vọng | O(log n) được đảm bảo |
| Độ dài code | Ngắn, không có phép xoay | Dài hơn nhiều: xoay và nhiều trường hợp sửa lỗi |
| Chạy đồng thời nhiều luồng | Dễ (lock-free khả thi) | Khó (cân bằng lại cần lock) |
| Range query | Tự nhiên (level 0 là linked list) | Duyệt in-order |
| Chi phí bộ nhớ phụ | Cao (trung bình 2 pointer/node với P=0.5) | Thấp hơn (2 pointer cố định) |
| Worst case | O(n) với xác suất rất thấp | O(log n) được đảm bảo |
Tính bộ nhớ cụ thể với n = 1,000,000 node (ước lượng thô, compressed OOPs):
- RB tree: mỗi entry gồm key, value, left, right, parent, màu và object header, cỡ 40 byte, tổng khoảng 40 MB.
- Skip list: mỗi node trung bình
1/(1-P) = 2forward pointer (P=0.5), cộng key, value, mảngforwardvà header, cỡ 48 byte, tổng khoảng 48 MB. Node level cao có nhiều pointer hơn và chi phí GC, nên thực tế cao hơn; hãy đo bằng JMH.
Thử ngẫmbảng trên đổi vài chục MB bộ nhớ thêm của skip list để được code ngắn hơn nhiều và chạy đồng thời dễ hơn. Service của bạn đang thiếu RAM hay thiếu người bảo trì code, đánh đổi nào đáng hơn?
7. Vì sao Redis ZSET chọn skip list
Redis Sorted Set (ZSET) dùng skip list thay vì RB tree. Theo bình luận của Salvatore Sanfilippo (tác giả Redis) trên Hacker News năm 2010, lý do xoay quanh ba điểm (diễn đạt lại, không trích nguyên văn):
Range query theo score rất phổ biến. ZRANGEBYSCORE min max là thao tác thường gặp trên ZSET. Với skip list, sau khi tìm được node đầu tiên trong khoảng, chỉ cần đi tiếp trên level 0, tốn O(k) với k là số phần tử trong khoảng, và truy cập bộ nhớ tuần tự trên danh sách liên kết không tệ hơn duyệt cây cân bằng.
Dễ cài đặt và dễ debug. Code skip list đơn giản hơn cây cân bằng đáng kể.
Bộ nhớ chỉnh được. Tham số P điều chỉnh số pointer trung bình trên mỗi node, nên đổi được bộ nhớ lấy tốc độ. Redis dùng ZSKIPLIST_P = 0.25 thay vì 0.5: trung bình 1/(1-0.25) ≈ 1.33 pointer/node, tiết kiệm bộ nhớ mà hằng số search vẫn cùng mức (4 × log₄(n) = 2 × log₂(n)).
Lưu ý: khả năng cài lock-free dễ hơn là lý do Java chọn skip list cho ConcurrentSkipListMap, không phải lý do của Redis (lệnh Redis chạy trên một luồng).
Bài Case study TimSort và Redis ZSET phân tích đầy đủ cách Redis cài ZSET, gồm cách kết hợp skip list với hash table để tra cứu theo member trong O(1) và theo score trong O(log n).
8. Bẫy thường gặp
Bẫy 1: Random source và adversarial input
-- BUG: seed cố định -> kẻ tấn công biết trước level của mọi node
RandomLevel_Vulnerable():
    seed <- 42   -- seed cố định, có thể đoán được
    lvl <- 0
    while PseudoRandom(seed) < P và lvl < MAX_LEVEL:
        lvl <- lvl + 1
    return lvl

-- ĐÚNG: dùng nguồn entropy hệ điều hành
RandomLevel_Safe():
    lvl <- 0
    while SecureRandom() < P và lvl < MAX_LEVEL:
        lvl <- lvl + 1
    return lvl
Trong production, nên dùng nguồn ngẫu nhiên không đoán được (random theo từng thread với seed lấy từ entropy của hệ điều hành, hoặc SecureRandom khi cần bảo mật cao). Nếu kẻ tấn công biết seed, họ có thể dựng input để mọi node đều nhận level 0, và cấu trúc thoái hoá thành linked list O(n).
Bẫy 2: Chọn P tuỳ tiện
Với P = 0.5, mỗi node có trung bình 2 forward pointer, search kỳ vọng 2 × log₂(n). Với P = 0.25: 1.33 pointer/node (bộ nhớ thấp hơn khoảng 33%) mà search kỳ vọng vẫn 4 × log₄(n) = 2 × log₂(n), nên 0.25 thường là lựa chọn tốt hơn. Với P = 0.75 thì tệ cả hai mặt: 4 pointer/node và search chậm hơn. Dù vậy, hãy benchmark thật nếu bộ nhớ là ràng buộc.
Bẫy 3: Không có deterministic worst case bound
Hệ thống real-time và ứng dụng nhạy với độ trễ thường cần đảm bảo worst case. O(log n) kỳ vọng của skip list dựa trên xác suất, nên trong thực tế với n nhỏ hoặc nguồn ngẫu nhiên bị lệch, bạn có thể gặp những lần chạy chậm bất thường.
-- Lựa chọn sai cho path yêu cầu latency cứng:
orderBook <- SkipList   -- O(log n) kỳ vọng, có thể có lần chậm bất thường

-- Lựa chọn an toàn hơn khi cần latency guarantee:
orderBook <- RedBlackTree   -- O(log n) được đảm bảo, không có lần chậm bất thường
Hệ thống có hạn chót cứng (giao dịch tài chính, hệ thống điều khiển) nên ưu tiên RB tree với O(log n) được đảm bảo, thay vì O(log n) kỳ vọng.
Thử ngẫmorder book yêu cầu độ trễ cứng nên chọn RB tree được đảm bảo thay vì skip list kỳ vọng. Redis ZSET vẫn chọn skip list; yêu cầu về độ trễ của hai hệ thống khác nhau ở chỗ nào?
9. Java standard library: ConcurrentSkipListMap
Java 6 đưa vào java.util.concurrent.ConcurrentSkipListMap, một skip list lock-free cài bằng CAS (Compare-And-Swap) trên forward pointer. Đây là SortedMap hợp với truy cập đồng thời, không bị tranh chấp lock như Collections.synchronizedMap(new TreeMap<>()).
Tình huống phù hợp: cache nhiều luồng truy cập cần range query (hết hạn theo timestamp, bảng xếp hạng theo score), thay cho Collections.synchronizedMap(new TreeMap<>()) để tránh lock toàn cục.
Trong bản cài đặt của OpenJDK, val và next đều là volatile, và việc cập nhật đi qua CAS thay vì khối synchronized. Khi insert, thuật toán dùng compareAndSet trên next để nối node mới mà không cần lock. Nếu CAS thất bại (có insert khác chen vào), nó thử lại; đây là lock-free (cả hệ thống luôn tiến triển), không phải wait-free.
10. Ứng dụng thực tế
Redis ZSET: kết hợp skip list với hash table. Hash table cho tra cứu theo member trong O(1), skip list cho tra cứu theo score và range scan trong O(log n). ZRANGEBYSCORE, ZRANK, ZADD đều O(log n). Mã nguồn: src/t_zset.c trong repo Redis.
LevelDB / RocksDB MemTable: skip list là cấu trúc chính trong RAM trước khi dữ liệu được flush xuống SSTable trên disk; mỗi lần ghi là một insert O(log n).
Lucene posting list: Lucene dùng skip pointer (dạng đơn giản hoá của skip list) để nhảy qua các đoạn posting khi gộp nhiều term, giảm chi phí query AND.
11. Đào sâu
Paper gốc:
- William Pugh (1990) — "Skip Lists: A Probabilistic Alternative to Balanced Trees", Communications of the ACM. Đọc để xem phân tích xác suất đầy đủ, chứng minh O(log n) kỳ vọng, và cách chọn P.
Source code thực tế: Redis src/t_zset.c (zslCreate, zslInsert, zslDelete, zslFirstInRange) và OpenJDK java.util.concurrent.ConcurrentSkipListMap (findPredecessor(), doPut(), doRemove()).
Bài liên quan trong khoá học:
- Cây tự cân bằng: so sánh Skip List với Red-Black Tree.
- Case Study Redis ZSET: vì sao Redis chọn Skip List thay vì Tree.
12. Tóm tắt
Checklist khi cân nhắc skip list:
- Cần tập có thứ tự, có range query và cập nhật liên tục, trong môi trường nhiều luồng:
ConcurrentSkipListMapđơn giản hơn việc tự khoá mộtTreeMap. - Dùng nguồn ngẫu nhiên không đoán được nếu dữ liệu đến từ bên ngoài, vì kẻ tấn công biết cách chọn level có thể làm skip list suy biến.
- Tính trước bộ nhớ: mỗi node có trung bình khoảng 1/(1-P) con trỏ; P = 0.25 là lựa chọn phổ biến.
- Có hạn chót độ trễ cứng thì chọn cây cân bằng (Red-Black), vì skip list chỉ đảm bảo O(log n) kỳ vọng, không đảm bảo worst case.
- Đọc
t_zset.ccủa Redis và MemTable của LevelDB để xem skip list chạy trong production.
13. Tự kiểm tra
- Q1Skip list đạt O(log n) kỳ vọng nhờ tính ngẫu nhiên, không có điều kiện cân bằng chắc chắn như RB tree. Đánh đổi cụ thể là gì? Khi nào tính ngẫu nhiên 'đủ tốt' và khi nào không?
- Q2Vì sao P = 0.5 là giá trị mặc định? Đổi sang P = 0.25 hay P = 0.75 thì ảnh hưởng gì đến bộ nhớ và tốc độ?
- Q3Redis ZSET chọn skip list thay vì RB tree. Lý do chính là gì và lý do nào quan trọng nhất?
- Q4Tính bộ nhớ tốn thêm của skip list so với RB tree với n = 1,000,000 node (key = Long, value = String ref). Giả sử P = 0.5, compressed OOPs bật.
- Q5ConcurrentSkipListMap lock-free dễ cài hơn một ConcurrentTreeMap (giả sử có tồn tại). Vì sao?
- Q6Hàm
randomLevel()bị thay thế bằng phiên bản luôn trả về 5. Hậu quả là gì?RandomLevel(): return 5 -- luôn trả về 5, không random
Bài tiếp theo: Mini-challenge: External merge sort
Counting / Radix / Bucket sort — Non-comparison O(n) khi key range nhỏ
Bài tiếpMini-challenge — External merge sort: sort 10GB file với 1GB RAM
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này