Quadratic sorts — Bubble, Selection, Insertion sort
So sánh Bubble, Selection, Insertion sort qua pseudocode và độ phức tạp, cùng lý do Insertion sort adaptive vẫn nằm trong sort của thư viện Java.
TL;DR: Ba quadratic sort (Bubble, Selection, Insertion) đều O(n²) trung bình, nhưng khác nhau rõ ở đặc tính thực tế. Bubble sort gần như không có lý do dùng trong production. Selection sort chỉ hơn ở chỗ swap đúng n-1 lần, còn lại không adaptive (không nhanh hơn khi dữ liệu đã gần sắp xếp) và không stable. Insertion sort stable, adaptive O(n+d) (d là số inversion, tức số cặp đứng sai thứ tự) và online (xử lý được dữ liệu đến từng phần tử), nên TimSort vẫn dùng nó cho đoạn ngắn dù O(n²) trên giấy. Khi n nhỏ, hằng số quan trọng hơn bậc.
Bubble sort là ví dụ sắp xếp đầu tiên trong hầu hết giáo trình đại học, và cũng là thứ đầu tiên bị gạch đỏ trong code review: O(n²), chậm, không có lý do dùng trong production. Câu chuyện thường kết thúc ở đó.
Nhưng mở DualPivotQuicksort.java trong OpenJDK, bạn vẫn gặp Insertion sort ngay trong code của Arrays.sort(int[]):
-- DualPivotQuicksort.java (OpenJDK, rút gọn):
-- mảng nhỏ thì dùng insertion sort, khỏi partition
if (size < INSERTION_SORT_THRESHOLD) insertionSort(a, low, high)
Tên và giá trị của hằng số này đổi theo bản JDK: JDK 7 đến 13 dùng một hằng 47, các bản gần đây tách thành vài ngưỡng cỡ vài chục phần tử. Điểm không đổi: mảng dưới ngưỡng thì JDK bỏ Dual-Pivot Quicksort và gọi Insertion sort. Còn Collections.sort và Arrays.sort(Object[]) dùng TimSort, một thuật toán khác, cũng gọi (binary) Insertion sort cho đoạn ngắn. Vì sao một thuật toán O(n²) lại nằm trong thư viện chuẩn của Java?
Bài này so sánh 3 quadratic sort bằng pseudocode, rồi giải thích vì sao Insertion sort adaptive vẫn có mặt trong thư viện production. Nếu cần nhắc lại cách Java so sánh hai phần tử, xem trước Comparator và Comparable.
1. Hình dung: ba cách sắp bài tay
Hình dung bạn có 10 quân bài xáo trộn, cần sắp theo thứ tự. Ba người bạn mỗi người dùng cách khác nhau:
Bubble — so từng cặp kế nhau, đổi chỗ nếu sai: Quét từ trái qua phải, so quân thứ i và i+1, sai thứ tự thì đổi chỗ. Sau một lượt, quân lớn nhất "nổi" lên cuối, như bong bóng nổi lên mặt nước. Quét lại, lần này bỏ qua vị trí cuối đã xong. Lặp cho đến khi không còn lần đổi nào.
Selection — tìm nhỏ nhất, đặt vào đầu: Lướt qua toàn bộ bài, chọn ra quân nhỏ nhất, đổi chỗ với quân ở vị trí đầu. Lúc này vị trí đầu đã xong. Lặp lại với phần còn lại, mỗi lần chọn quân nhỏ nhất trong phần chưa xử lý.
Insertion — cầm từng quân, đẩy vào chỗ đúng: Cầm quân thứ 2, đẩy vào vị trí đúng trong 2 quân đầu. Cầm quân thứ 3, đẩy vào chỗ đúng trong 3 quân đầu. Phần bên trái tay luôn đã sắp xếp, giống khi bạn cầm bài và xếp từng lá vào đúng chỗ.
| Sắp bài tay | Sorting algorithm | Điểm đặc trưng |
|---|---|---|
| So từng cặp kế nhau, swap nếu sai | Bubble sort | Quân lớn "nổi" lên cuối sau mỗi lượt |
| Tìm nhỏ nhất, đổi vào đầu | Selection sort | Luôn đúng n-1 lần đổi chỗ |
| Cầm từng quân, đẩy vào đúng vị trí | Insertion sort | Phần trái luôn đã sắp xếp, online |
Bubble là nổi lên, Selection là chọn nhỏ nhất, Insertion là chèn vào đúng chỗ. Chỉ Insertion xử lý được bài đến từng lá một: cầm thêm lá nào thì xếp vào ngay.
2. Bubble sort
BubbleSort(A):
    n <- A.length
    for i <- 0 đến n-2:
        swapped <- false
        for j <- 0 đến n-2-i:
            if A[j] > A[j+1]:
                swap A[j] và A[j+1]
                swapped <- true
        if not swapped: break     -- đã sắp xếp xong, thoát sớm
Time: O(n²) worst/average, O(n) best Space: O(1)
Dòng if not swapped: break giúp thuật toán dừng sớm: một lượt không có swap nào nghĩa là mảng đã sắp xếp xong.
Muốn tự kiểm từng lượt, hãy vẽ bảng trace (cột i, j, mảng sau mỗi lần so). Nếu chưa quen, ôn lại ở bảng trace. Với [5, 3, 1, 4, 2]:
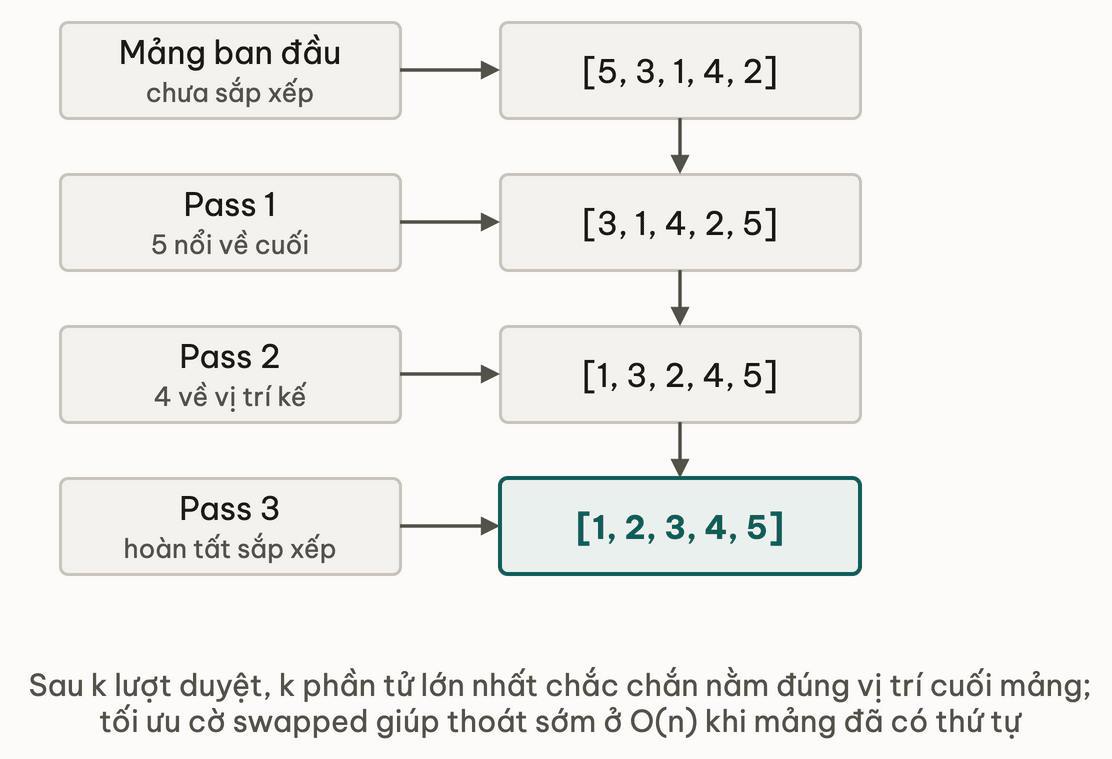
Phân tích. Best case là O(n): input đã sắp xếp thì lượt đầu không có swap nào, break ngay sau một lần quét. Worst case là O(n²): input sắp xếp ngược nên mỗi phần tử phải "nổi" qua gần hết mảng. Bubble sort stable vì khi hai phần tử bằng nhau (==) nó không swap, và adaptive nhờ thoát sớm, nhưng trên dữ liệu gần như đã sắp xếp nó vẫn chậm hơn Insertion sort. Trong production gần như không có lý do dùng nó; gặp trong code review thì thay bằng sort của thư viện.
3. Selection sort
SelectionSort(A):
    n <- A.length
    for i <- 0 đến n-2:
        minIdx <- i
        for j <- i+1 đến n-1:
            if A[j] < A[minIdx]: minIdx <- j
        swap A[i] và A[minIdx]    -- đặt phần tử nhỏ nhất vào vị trí i
Time: O(n²) mọi trường hợp Space: O(1)
Phân tích. Selection sort luôn O(n²) và không adaptive: dù input đã sắp xếp xuôi hay ngược, vòng trong vẫn quét hết phần còn lại để tìm min, không có chỗ nào thoát sớm. Nó cũng không stable, vì swap A[i] với A[minIdx] có thể nhảy qua một phần tử bằng nhau nằm giữa và làm đảo thứ tự tương đối của chúng.
Ưu điểm duy nhất là ít swap: đúng n-1 lần, không bao giờ nhiều hơn. Khi swap đắt (object lớn, ghi disk), đây là lợi thế thật, nhưng ngoài vài trường hợp embedded hoặc dữ liệu lớn thì hiếm khi đủ để chọn nó.
4. Insertion sort: adaptive winner
InsertionSort(A):
    for i <- 1 đến A.length-1:
        key <- A[i]
        j <- i - 1
        while j >= 0 và A[j] > key:   -- j >= 0 phải đứng TRƯỚC để tránh lỗi
            A[j+1] <- A[j]            -- shift phải, không swap
            j <- j - 1
        A[j+1] <- key
Time: O(n²) worst, O(n) best, O(n+d) với d = số inversion Space: O(1)
Trace với [5, 3, 1, 4, 2]. Sau mỗi lượt, phần bên trái vạch | luôn đã sắp xếp (đây là điều kiện bất biến của thuật toán):
| i | key | Số lần dịch | Mảng sau lượt |
|---|---|---|---|
| 1 | 3 | 1 | 3 5 | 1 4 2 |
| 2 | 1 | 2 | 1 3 5 | 4 2 |
| 3 | 4 | 1 | 1 3 4 5 | 2 |
| 4 | 2 | 3 | 1 2 3 4 5 |
Tổng số lần dịch là 1+2+1+3 = 7, đúng bằng số inversion của mảng gốc (7 cặp đứng sai thứ tự: (5,3), (5,1), (5,4), (5,2), (3,1), (3,2), (4,2)). Đó là lý do thời gian là O(n+d): mỗi lần dịch xoá đúng một inversion.
Cơ chế quan trọng: Insertion sort dịch (shift) phần tử sang phải thay vì swap từng cặp. Mỗi vòng lặp chỉ ghi A[j+1] = key một lần ở cuối, nên tốn ít lần ghi hơn Bubble sort.
Phân tích. Best case là O(n): input đã sắp xếp thì điều kiện A[j] > key sai ngay, chỉ còn vòng for ngoài. Worst case là O(n²): input sắp xếp ngược nên mỗi key phải dịch qua cả phần đã sắp xếp.
Lợi thế chính là adaptive, O(n + d) với d là số inversion (số cặp (i, j) có i nhỏ hơn j nhưng A[i] lớn hơn A[j]). Mảng gần như đã sắp xếp có d nhỏ nên thời gian gần O(n). Insertion sort còn stable, vì điều kiện A[j] > key là chặt (không có dấu bằng) nên hai phần tử bằng nhau không bị dịch qua nhau. Và nó online: dữ liệu đến từng phần tử một thì cứ chèn vào đúng chỗ trong phần đã sắp xếp.
Thử ngẫmInsertion sort chèn được từng phần tử ngay khi nó đến; Bubble và Selection cần có sẵn cả mảng. Đặc tính "online" này đổi được gì so với việc gom lại cả mẻ rồi sort lại?
5. Bảng so sánh và con số minh hoạ
| Algorithm | Best | Average | Worst | Space | Stable | Adaptive | Online |
|---|---|---|---|---|---|---|---|
| Bubble | n | n² | n² | 1 | yes | yes (early exit) | no |
| Selection | n² | n² | n² | 1 | no | no | no |
| Insertion | n | n² | n² | 1 | yes | yes | yes |
Về tốc độ, khi đo trên mảng ngẫu nhiên cỡ vài nghìn phần tử, thứ tự thường gặp là Insertion nhanh nhất trong ba thuật toán, rồi tới Selection, Bubble chậm nhất. Insertion thường nhanh hơn Bubble rõ rệt nhờ dịch thay vì swap và so sánh ít hơn (xem câu 2 ở phần tự kiểm tra). Còn sort có sẵn của thư viện, O(n log n), nhanh hơn cả ba hàng chục lần ở n cỡ chục nghìn. Con số tuyệt đối phụ thuộc máy, JIT và dữ liệu, nên hãy tự đo bằng JMH trên máy bạn thay vì tin một bảng số in sẵn.
Với n rất nhỏ (cỡ 16 phần tử) thì ngược lại: Insertion sort thường nhanh hơn cả sort tổng quát, vì sort tổng quát phải trả một khoản cố định cho việc chọn pivot, partition, đệ quy và gọi hàm. Insertion sort chạy thẳng một vòng lặp, không đệ quy, không cấp phát thêm bộ nhớ. Đó là lý do thư viện chuyển sang Insertion sort dưới một ngưỡng nhỏ: ở n nhỏ, hằng số quan trọng hơn bậc của Big-O.
6. Bẫy thường gặp
Bẫy 1: Selection sort không stable, nhưng dev cứ tưởng mọi sort đều stable
Swap A[i] với A[minIdx] của Selection sort có thể nhảy qua phần tử bằng nhau, nên nó không stable.
-- Ví dụ: sắp nhân viên [Alice:50k, Bob:50k, Carol:40k]
-- Bước 1 sort theo lương: đúng thứ tự Carol < Alice = Bob
-- Bước 2 sort theo phòng ban bằng Selection sort:
--   swap có thể đổi chỗ Alice và Bob (hai người cùng 50k)
--   => thứ tự lương trong cùng phòng ban: không xác định ✗

-- ĐÚNG: dùng stable sort ở bước 2 (Insertion sort, Merge sort, TimSort)
--   => trong cùng phòng ban, thứ tự lương từ bước 1 được bảo toàn ✓
Trước khi dùng bất kỳ sort nào cho việc sort nhiều key, hãy kiểm tra nó có stable không. Với Java, Collections.sort và List.sort trên object là stable (xem Comparator và Comparable), còn Arrays.sort(int[]) không cần stable vì hai số nguyên bằng nhau thì không phân biệt được.
Bẫy 2: Thứ tự điều kiện trong while loop của Insertion sort
-- BUG: ArrayIndexOutOfBoundsException khi j = -1
while A[j] > key và j >= 0:
    -- A[j] được evaluate khi j = -1 -> lỗi index

-- ĐÚNG: kiểm tra j >= 0 TRƯỚC (short-circuit)
while j >= 0 và A[j] > key:
    A[j+1] <- A[j]
    j <- j - 1
Đảo thứ tự thì A[j] bị đọc trước, và với j = -1 nó ném lỗi index out of bounds. Đây là lỗi biên kinh điển (off-by-one ở đầu mảng). Nếu muốn có thói quen soát biên trước khi code, xem edge case.
Thử ngẫmđảo thứ tự hai điều kiện trong vòng while gây lỗi index khi j=-1, dù mỗi điều kiện đều đúng khi đứng riêng. Thứ tự đánh giá boolean có phải lúc nào cũng vô hại như ta tưởng không?
7. Insertion sort variants
Binary Insertion sort: thay vì tìm vị trí chèn bằng quét tuần tự O(n), dùng tìm kiếm nhị phân O(log n). Tổng số phép so sánh giảm xuống O(n log n). Nhưng tổng thời gian vẫn O(n²), vì mỗi vòng vẫn phải dịch O(n) phần tử: chi phí nằm ở việc dịch chứ không phải ở việc so sánh.
BinaryInsertionSort(A):
    for i <- 1 đến A.length-1:
        key <- A[i]
        -- tìm vị trí chèn bằng binary search trong A[0..i-1]
        pos <- binarySearch(A, 0, i-1, key)
        -- shift A[pos..i-1] sang phải 1 vị trí
        for j <- i-1 xuống pos:
            A[j+1] <- A[j]
        A[pos] <- key
Time: O(n²) (shift vẫn O(n²)) Space: O(1)
Biến thể này có ích khi phép so sánh đắt (ví dụ so sánh object phức tạp), vì nó giảm số lần so sánh còn O(n log n). Với mảng, việc dịch phần tử vẫn là nút thắt nên lợi ích bị giới hạn. TimSort của Java dùng đúng biến thể này cho đoạn ngắn.
Shell sort: Insertion sort kèm dãy khoảng cách (gap). Sort các phần tử cách nhau gap bước, rồi giảm gap dần đến 1. Worst case từ O(n^1.5) đến O(n log² n) tuỳ dãy gap, tốt hơn O(n²) thuần. Hiếm dùng trong production hiện đại, nhưng đáng biết như một ý tưởng.
8. Vì sao TimSort vẫn dùng Insertion sort
Dữ liệu thật thường có cấu trúc chứ không ngẫu nhiên hoàn toàn: file log đã theo timestamp, transaction ID tăng dần, luồng sự kiện có thứ tự tự nhiên. TimSort tận dụng điều này như sau:
TimSort (rút gọn):
    runs <- []
    i <- 0
    while i < A.length:
        run <- detectRun(A, i)    -- tìm đoạn đã sắp xếp (tăng hoặc giảm)
        if run.length < minRunLength:
            extendByInsertionSort(A, run, minRunLength)  -- Insertion sort cho run ngắn
        runs.push(run)
        i <- run.end
    mergeRunsOptimally(runs)      -- merge theo chiến lược dựa trên stack
Time: O(n) cho input đã sắp xếp, O(n log n) worst case Space: O(n)
Insertion sort hợp với bước kéo dài run này vì ba lý do. Run ngắn (cỡ 16 đến 64 phần tử tuỳ cài đặt, gọi là minrun) nên n nhỏ và hằng số thấp thắng thế. Run thường gần như đã sắp xếp nên d nhỏ và Insertion sort chạy gần O(n). Cuối cùng nó không cần đệ quy hay cấp phát thêm nên chi phí phụ thấp nhất có thể. Bản của Java dùng binary Insertion sort ở bước này.
TimSort là thuật toán dành cho object (stable), khác với Dual-Pivot Quicksort dành cho int[]. Bài Case study TimSort và Redis ZSET đi sâu vào cách nhận ra run, galloping mode và quy tắc gộp run.
Thử ngẫmTimSort chỉ kéo dài run bằng Insertion sort khi run ngắn hơn minRunLength (cỡ vài chục). Nếu minrun bị chỉnh lên 500, tốc độ của TimSort trên dữ liệu ngẫu nhiên lớn thay đổi theo hướng nào?
9. Ứng dụng thực tế
Ngưỡng chuyển sang Insertion sort trong thư viện. Với int[], Arrays.sort dùng Dual-Pivot Quicksort và chuyển sang Insertion sort khi đoạn con chỉ còn vài chục phần tử (JDK 7 đến 13 dùng hằng 47; các bản gần đây tách thành vài ngưỡng cỡ đó, hãy đọc DualPivotQuicksort.java đúng bản JDK bạn dùng). Với object, Collections.sort và Arrays.sort(Object[]) dùng TimSort, kéo run ngắn bằng binary Insertion sort (minrun cỡ 16 đến 32 trong bản Java, 32 đến 64 trong bản CPython). Hai thuật toán khác nhau nhưng cùng một ý: đoạn nhỏ thì Insertion sort rẻ hơn.
-- Từ DualPivotQuicksort (rút gọn):
if đoạn con ngắn hơn ngưỡng:
    insertionSort(đoạn con)  -- nhanh hơn Quick sort ở đây
    return
-- ... tiếp tục dual-pivot partition
Sort dữ liệu đến liên tục (online). Insertion sort sort được dữ liệu khi nó đến từng phần: nhận sự kiện mới, chèn vào đúng chỗ trong phần đã sắp xếp. Bubble và Selection phải có đủ dữ liệu trước. Ví dụ: đệm lệnh mua bán theo thứ tự ưu tiên giá rồi đến thời gian; khi số lệnh trong buffer ít thì chèn O(n) vào mảng đã sắp xếp có độ trễ thấp.
10. Đào sâu
Sách kinh điển:
- The Art of Computer Programming, Vol. 3, Donald Knuth, mục 5.2.1 (Insertion sort) và 5.2.2 (Selection sort): phân tích toán học đầy đủ về số inversion và số phép so sánh kỳ vọng.
Source code tham khảo:
OpenJDK DualPivotQuicksort.java: tìm hằng ngưỡng của Insertion sort để xem giá trị thật và cách dùng ở đúng bản JDK bạn đang chạy.java.util.TimSortvà ghi chú gốc của Tim Peters (Objects/listsort.txttrong CPython): giải thích cách nhận ra run và quy tắc gộp run.
11. Tóm tắt
Checklist khi gặp quadratic sort ngoài đời:
- Thấy Bubble sort trong code production: thay bằng sort của thư viện.
- Cần ít swap nhất vì swap đắt: Selection sort (đúng n-1 swap), nhưng nhớ là nó không stable.
- Sort nhiều key liên tiếp: chỉ dùng sort stable ở các bước sau, và kiểm tra thuật toán có thật sự stable.
- Dữ liệu nhỏ, gần như đã sắp xếp hoặc đến từng phần: dùng Insertion sort, nhớ viết
j >= 0trướcA[j] > key. - Khi đọc code thư viện: đoạn nhỏ chuyển sang Insertion sort là chủ ý về hằng số, không phải sót.
12. Tự kiểm tra
- Q1Vì sao Insertion sort O(n) cho input đã sắp xếp nhưng Selection sort luôn O(n²) dù input đã sắp xếp?
- Q2Bubble sort và Insertion sort cùng O(n²) trung bình, vì sao Insertion sort thường nhanh hơn trong benchmark?
- Q3Stable vs non-stable: cho đoạn pseudocode sort nhân viên theo salary rồi theo department, Selection sort phá ở đâu?
- Q4Insertion sort 'online' nghĩa là gì? Cho 1 tình huống thực tế.
- Q5Vì sao thư viện sort dùng Insertion sort cho đoạn nhỏ, thay vì dùng Quicksort hay Merge sort cho mọi kích thước?
- Q6Cho mảng A = [3,1,4,1,5,9,2,6]. Số swap của Bubble sort so với Selection sort là bao nhiêu?
Bài tiếp theo: Merge sort — divide and conquer, stable O(n log n)
Sorting landscape — Comparison vs non-comparison, lower bound n log n
Bài tiếpMerge sort — Divide & conquer, stable, foundation cho external sort
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này