TimSort & Redis ZSET — sort thắng ở production
Vì sao Java/Python dùng TimSort (run detection, galloping merge) và Redis ZSET dùng skip list — case study thuật toán production, không chỉ big-O trên giấy.
TL;DR: Trong production, việc sắp xếp quy về 2 họ chính: TimSort để sort object trong RAM (Java Arrays.sort(Object[]), Python sorted(), V8, Android) và skip list cho tập có thứ tự cần range query (Redis ZSET). TimSort tận dụng các run, tức đoạn liên tiếp đã sắp xếp sẵn trong dữ liệu thật, bằng cách nhận ra run, galloping merge và điều kiện cân bằng trên stack các run; gần O(n) khi dữ liệu gần như đã sắp xếp. Redis ZSET kết hợp skip list (range scan tự nhiên) với dict (tra cứu điểm O(1)), và trường span giúp ZRANK chạy O(log n). Cả hai thắng không phải vì worst case tốt hơn trên lý thuyết, mà vì khớp rất tốt với hình dạng của dữ liệu thật.
Module này đã đi qua 8 bài về sắp xếp: Quadratic sorts, Merge sort, Quick sort, Heap sort, Counting/Radix/Bucket sort, Skip list và External merge sort. Mỗi bài giải thích cơ chế, độ phức tạp và đánh đổi. Nhưng nếu hỏi production thực tế dùng gì, câu trả lời ngắn hơn nhiều.
Hầu hết code bạn viết đang dùng đúng 2 họ này: TimSort khi gọi Arrays.sort(Object[]) trong Java, sorted() trong Python, Array.prototype.sort trong V8; và skip list khi dùng Redis ZSET cho tập có thứ tự. Cả hai thắng không phải vì worst case tốt hơn trên lý thuyết, mà vì khớp rất tốt với hình dạng của dữ liệu thật.
Bài này đi sâu vào 2 hệ thống: TimSort (nhận ra run và galloping merge) và Redis ZSET (kết hợp skip list với dict). Bạn sẽ đọc source thật và hiểu vì sao 2 lựa chọn này thắng các phương án khác trong workload thực tế.
1. Thông tin dự án A: TimSort
Origin: Tim Peters viết năm 2002 cho Python list.sort().
Java port: OpenJDK 7+ cho Arrays.sort(Object[]) và Collections.sort().
Source Java: https://github.com/openjdk/jdk/blob/jdk-21+35/src/java.base/share/classes/java/util/TimSort.java
Source Python: https://github.com/python/cpython/blob/main/Objects/listobject.c (hàm list_sort_impl)
TimSort không phải thuật toán phát minh từ con số không. Tim Peters nhận ra một điều đơn giản: dữ liệu thật hiếm khi hoàn toàn ngẫu nhiên. File log có timestamp tăng dần. Row trong database có ID tăng đơn điệu. Hàng đợi sự kiện thường đã gần như sắp xếp. TimSort được thiết kế để tận dụng đặc điểm này, nên nhanh trên dữ liệu thực tế chứ không chỉ trên benchmark ngẫu nhiên.
2. Vì sao TimSort thắng trên real-world data
Cả 4 lý do TimSort vượt trội đều xoay quanh run: đoạn liên tiếp trong input đã sắp xếp xuôi hoặc ngược.
Dữ liệu thật thường có run. Timestamp trong log tăng đơn điệu. Primary key trong kết quả SQL trả về theo thứ tự insert. Sự kiện trong message queue đến theo thứ tự gần như đã sắp xếp. Merge sort thông thường cứ chia đôi mà không nhìn dữ liệu, còn TimSort tìm run trước để tận dụng cấu trúc đã có sẵn.
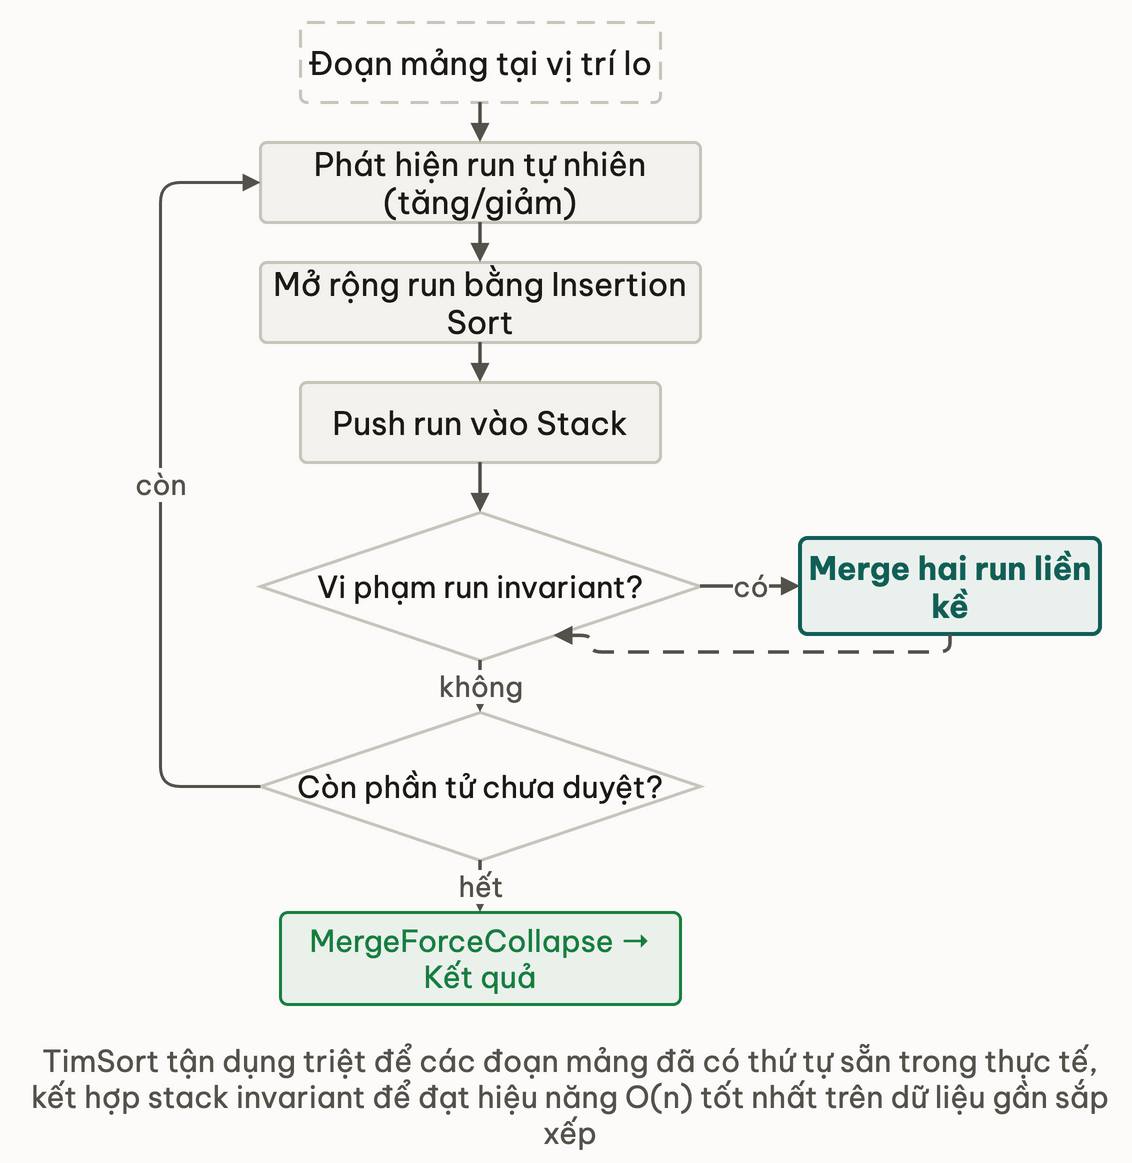
Nhận ra run rồi kéo dài. TimSort quét input để tìm đoạn liên tiếp tăng dần hoặc giảm dần. Gặp đoạn giảm dần thì đảo ngược tại chỗ thành tăng dần. Run quá ngắn thì kéo dài bằng Insertion sort đến min_run_length (cỡ 16 đến 32 trong bản Java, 32 đến 64 trong CPython). Insertion sort lý tưởng cho mảng con nhỏ vì ít chi phí phụ và tận dụng cache tốt trên dữ liệu gần như đã sắp xếp (bài 02 đã phân tích: O(n) khi gần đã sắp xếp).
Galloping merge. Khi merge 2 run, nếu một phía liên tục thắng (nhiều phần tử liên tiếp đến từ cùng 1 run), TimSort chuyển sang exponential search để tìm vị trí chèn cả một cụm thay vì từng phần tử. Số phép so sánh giảm đáng kể khi một run áp đảo.
Stable. Giữ nguyên thứ tự khi key bằng nhau, điều bắt buộc để Comparable<T> đúng. Ví dụ sort List<Person> theo lastName sau khi đã sort theo department: stability đảm bảo thứ tự trong cùng department được giữ nguyên.
3. TimSort: 4 bước algorithm
3.1 Bước 1: Tính min_run_length
TimSort tính min_run_length sao cho (bản Java: từ 16 đến 32; CPython dùng ngưỡng gấp đôi, từ 32 đến 64) n / min_run gần một lũy thừa của 2, để cây merge cân bằng.
MinRunLength(n):
    -- Kết quả r: n / r gần lũy thừa của 2; 16 <= r <= 32 khi n >= 32
    MIN_MERGE <- 32
    r <- 0
    while n >= MIN_MERGE:
        r <- r | (n & 1)    -- ghi nhận bit lẻ
        n <- n >> 1          -- dịch phải
    return n + r
Time: O(log n) Space: O(1)
Kết quả: với n = 1000 phần tử, vòng lặp cho min_run = 32 (kiểm: 1000 → 500 → 250 → 125 → 62 → 31, bit lẻ gặp ở 125 nên r = 1, trả về 31 + 1 = 32), tức khoảng 32 run, nên cây merge có khoảng 5 tầng và cân bằng tốt.
3.2 Bước 2: Detect và extend run
CountRunAndMakeAscending(A, lo, hi, compare):
    -- Trả về độ dài của run tăng dần bắt đầu tại lo
    runHi <- lo + 1
    if runHi = hi: return 1

    -- Kiểm tra descending
    if compare(A[runHi], A[lo]) < 0:
        runHi <- runHi + 1
        while runHi < hi và compare(A[runHi], A[runHi-1]) < 0:
            runHi <- runHi + 1
        ReverseRange(A, lo, runHi)   -- lật descending thành ascending
    else:
        while runHi < hi và compare(A[runHi], A[runHi-1]) >= 0:
            runHi <- runHi + 1

    return runHi - lo
Time: O(k) với k = độ dài run Space: O(1)
Sau khi nhận ra run, nếu runLen < minRun thì gọi binary insertion sort để kéo run dài lên minRun phần tử.
3.3 Bước 3: Merge stack với invariant
Mỗi run được push vào stack. TimSort giữ 2 điều kiện (invariant) luôn đúng để việc merge cân bằng:
-- Invariant 1: runLen[i-3] > runLen[i-2] + runLen[i-1]
-- Invariant 2: runLen[i-2] > runLen[i-1]

MergeCollapse(stack):
    while stackSize > 1:
        n <- stackSize - 2
        if n > 0 và runLen[n-1] <= runLen[n] + runLen[n+1]:
            if runLen[n-1] < runLen[n+1]:
                n <- n - 1
            MergeAt(n)      -- merge run n và run n+1
        else if runLen[n] <= runLen[n+1]:
            MergeAt(n)
        else:
            break           -- invariant đã thoả, dừng
Time: O(n log n) tổng thể Space: O(n)
Các invariant này đảm bảo các run chỉ được merge khi kích thước tương đương nhau, tức merge cân bằng như Merge sort, không bị lệch dồn về một phía.
Lưu ý: đoạn pseudocode trên là dạng cũ của mergeCollapse, trước bản sửa lỗi ở mục 5. Bản đã sửa (JDK 21) thêm một điều kiện kiểm tra sâu hơn trong stack: n > 1 và runLen[n-2] <= runLen[n] + runLen[n-1].
3.4 Bước 4: Galloping mode trong merge
Khi merge 2 run, TimSort đếm số lần thắng liên tiếp của mỗi phía. Nếu một phía thắng liên tục MIN_GALLOP lần (mặc định 7), nó chuyển sang gallop mode:
MergeWithGallop(A, run1, run2, compare):
    -- Cắt bỏ phần đầu/phần cuối không cần merge
    k <- GallopRight(A[run2.start], A, run1.start, run1.len, 0, compare)
    run1.start <- run1.start + k
    run1.len   <- run1.len - k
    if run1.len = 0: return

    run2.len <- GallopLeft(A[run1.end], A, run2.start, run2.len, run2.len-1, compare)
    if run2.len = 0: return

    -- Merge phần còn lại, dùng gallop mode khi một phía áp đảo
    MergeLo(A, run1.start, run1.len, run2.start, run2.len)
Time: O(n log k) khi gallop hiệu quả (k = số phần tử cần bỏ qua) Space: O(min(run1.len, run2.len))
GallopRight dùng exponential search: thử offset 1, 2, 4, 8, 16, ... để tìm vị trí trong O(log k) thay vì O(k) nếu cần bỏ qua k phần tử. Khi dữ liệu có một run áp đảo dài, một lần gallop bỏ qua được hàng trăm phép so sánh.
Gallop có chi phí phụ: khi k nhỏ, exponential search tốn nhiều phép so sánh hơn so sánh tuần tự. Vì vậy TimSort chỉ bật gallop sau khi một phía thắng liên tiếp 7 lần (MIN_GALLOP). Nếu gallop không có lợi (số lần thắng sau gallop thấp), TimSort tự tăng MIN_GALLOP để thoát gallop mode sớm hơn, tức là tự thích nghi.
Thử ngẫmgallop mode chỉ bật sau 7 lần thắng liên tiếp, để tránh chi phí của exponential search khi k nhỏ. Sort một mảng ngẫu nhiên hoàn toàn, không có run dài nào, MIN_GALLOP có bao giờ được kích hoạt không?
4. TimSort empirical: so sánh real workload
| Workload | TimSort | Dual-Pivot Quick | Ghi chú |
|---|---|---|---|
| Dữ liệu ngẫu nhiên | Tương đương | Hơi nhanh hơn | Quick ít chi phí phụ hơn trên dữ liệu ngẫu nhiên |
| Gần như đã sắp xếp | Nhanh hơn rõ rệt | Chậm hơn (bản mới có thêm bước nhận run cho mảng lớn) | TimSort nhận ra run, ít phải merge |
| Đã sắp xếp ngược | Gần O(n) | Worst case O(n²) nếu chọn pivot ngây thơ; JDK lấy mẫu pivot và có nhánh heap sort nên không suy biến | TimSort đảo run tại chỗ |
| Nhiều phần tử trùng | Nhanh (gallop bỏ qua) | Ổn nhờ chia 3 vùng | Gallop bỏ qua cả khối phần tử bằng nhau |
| Cần stable | Stable | Không stable | TimSort giữ thứ tự khi key bằng nhau |
Java dùng 2 thuật toán khác nhau: Arrays.sort(int[]) dùng Dual-Pivot Quicksort (Yaroslavskiy 2009): không cần stable, in-place, nhanh hơn trên mảng nguyên thuỷ ngẫu nhiên. Arrays.sort(Object[]) dùng TimSort vì cần stable (theo hợp đồng của Comparable); mảng object chứa tham chiếu tới các object rải rác trong heap nên cache miss nhiều hơn, và dữ liệu gần như đã sắp xếp rất hay gặp khi sort object nghiệp vụ.
5. Bug mergeCollapse: proof không đủ, test mới đủ
Năm 2015, Stijn de Gouw và cộng sự dùng formal verification (KeY theorem prover, công cụ chứng minh định lý tự động) khi cố chứng minh TimSort của Java đúng, và phát hiện một bug (bug được theo dõi là JDK-8072909):
mergeCollapse chỉ kiểm tra invariant ở vài run trên cùng của stack, trong khi comment cho rằng nó giữ invariant cho cả stack. Với một số chuỗi độ dài run (ví dụ stack 120, 80, 25, 20, 30, trong đó 120 ≤ 80 + 45), invariant bị vi phạm ở sâu hơn mà không ai merge kịp. Kết quả là mảng runLen được cấp theo giả định về chiều cao stack bị tràn và ném ArrayIndexOutOfBoundsException (lỗi chỉ số vượt mảng; nếu chưa quen đọc loại thông báo này, ôn lại ở đọc thông báo lỗi).
Bug này cực hiếm: cần mảng rất lớn với tỉ lệ kích thước run đúng kiểu. Hầu hết code production không bao giờ dính, nhưng khi dính thì crash lúc chạy với exception khó lần ra nguồn gốc. Nhóm tác giả cũng chỉ ra Python và Android bị ảnh hưởng vì dùng cùng thiết kế.
Cách sửa: thêm điều kiện kiểm tra runLen[n-2] <= runLen[n] + runLen[n-1] vào mergeCollapse, và điều chỉnh kích thước mảng stack. Sau khi sửa, bản cài đặt được chứng minh hình thức hoàn chỉnh.
TimSort có một chứng minh không hình thức (informal) về tính đúng đắn của Tim Peters (listsort.txt), và nhóm Java cài đặt dựa trên đó. Nhưng chứng minh không hình thức cộng với chi tiết cài đặt vẫn có thể để lọt bug. Property-based testing (kiểm thử theo thuộc tính, với input ngẫu nhiên ở mọi kích thước và hình dạng) là công cụ thực tế hơn để bắt các trường hợp biên của thuật toán sort trong production.
6. Thông tin dự án B: Redis ZSET
Project: Redis 7.x
Source: src/t_zset.c (ZADD, ZRANGE, ZRANGEBYSCORE, ZRANK, ZREM) và src/server.h (struct definitions)
Các thao tác: ZADD O(log n), ZRANGE O(log n + k), ZRANGEBYSCORE O(log n + k), ZRANK O(log n), ZREM O(log n)
Redis ZSET là tập có thứ tự (sorted set): mỗi member có một score (float64), và tập luôn giữ thứ tự theo (score, member) theo thứ tự từ điển. Tình huống điển hình: bảng xếp hạng, timeline feed, hàng đợi ưu tiên.
7. Redis ZSET: dual structure skip list + dict
ZSET lớn không phải một cấu trúc đơn giản. Nó dùng hai cấu trúc song song (với ZSET nhỏ, Redis 7 dùng một dạng mảng gọn gọi là listpack cho đến khi vượt ngưỡng cấu hình, mặc định 128 phần tử hoặc member dài hơn 64 byte; ở các bản cũ là ziplist):
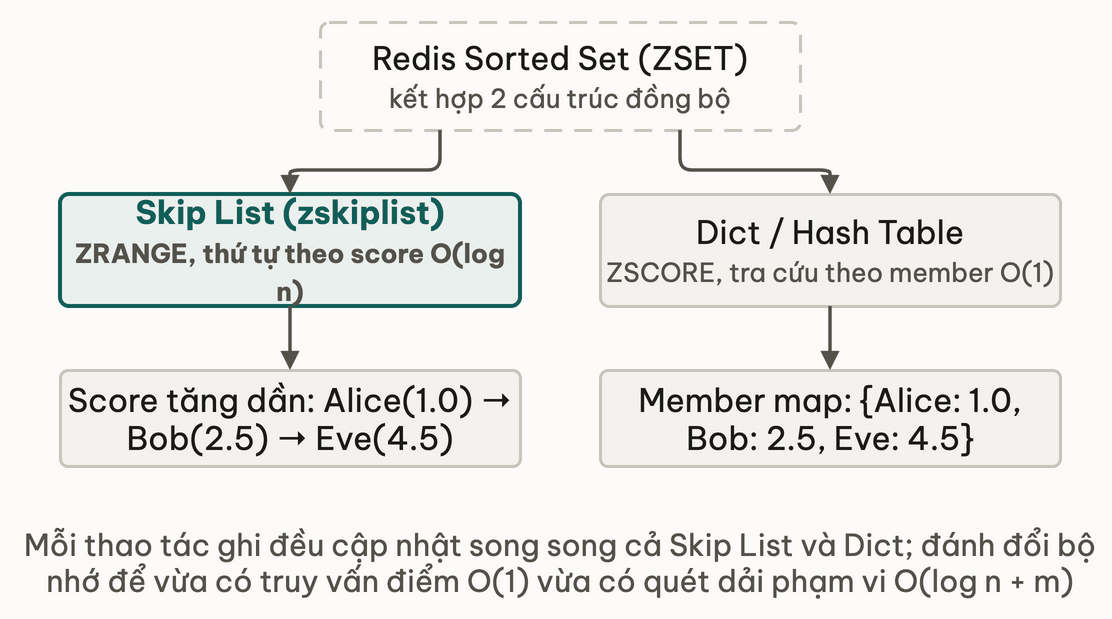
Skip list sắp xếp theo (score, member):
ZRANGEBYSCORE min maxtốn O(log n + k): đi từ header xuống đến score min, rồi quét tiếp level 0 để lấy k kết quả.ZRANGE(quét theo thứ tự) tốn O(1) cho mỗi bước tiếp: level 0 là linked list đã sắp xếp nên next pointer cho sẵn thứ tự.
Dict ánh xạ member → score:
ZSCORE membertốn O(1): tra hash trực tiếp.ZADDđể cập nhật: tra score cũ qua dict O(1), xoá khỏi skip list bằng score cũ O(log n), rồi insert với score mới O(log n).
Đánh đổi: tốn thêm bộ nhớ so với dùng một cấu trúc, vì mỗi member nằm trong cả node skip list lẫn entry dict (chuỗi member được dùng chung giữa hai bên, nhưng node skip list và entry dict vẫn là hai khoản riêng). Chấp nhận được vì Redis là kho dữ liệu trong RAM và người dùng đã chọn nó để đổi RAM lấy tốc độ.
Thử ngẫmZADD cập nhật score tốn O(1) để tra dict cộng hai lần O(log n) để xoá/thêm trong skip list, tức đổi thêm bộ nhớ lấy tốc độ đó. Bỏ hẳn skip list, chỉ giữ dict, thì lệnh nào trong ZRANGEBYSCORE/ZRANK mất khả năng chạy O(log n)?
8. Skip list node trong Redis source
Cấu trúc node Redis (C):
zskiplistNode:
    ele          -- member dạng chuỗi (SDS)
    score        -- khoá sắp xếp (float64)
    backward     -- con trỏ về node trước (level 0, để quét ngược)
    level[]:     -- mảng level (kích thước = level ngẫu nhiên của node)
        forward  -- con trỏ tới node kế tiếp tại level này
        span     -- số node ở level 0 bị skip khi đi từ đây tới forward
Trường span là đặc điểm riêng của Redis, skip list chuẩn không có. span tại level[i] là số node ở level 0 bị bỏ qua khi đi từ node hiện tại sang forward[i]. Cộng dồn span trên đường đi từ header xuống leaf thì biết chính xác rank của node đích, nên ZRANK chạy trong O(log n) thay vì O(n).
Pseudocode ZRANK (lấy rank theo score và member):
ZGetRank(zsl, score, member):
    node <- zsl.header
    rank <- 0

    for i <- zsl.maxLevel-1 xuống 0:
        while node.level[i].forward != null và
              (node.level[i].forward.score < score hoặc
               (node.level[i].forward.score = score và
                node.level[i].forward.ele <= member)):
            rank <- rank + node.level[i].span   -- cộng dồn span khi nhảy
            node <- node.level[i].forward

        if node.ele = member:
            return rank

    return 0   -- không tìm thấy
Time: O(log n) Space: O(1)
9. Vì sao Redis chọn skip list thay Red-Black tree
| Tiêu chí | Skip list | Red-Black tree |
|---|---|---|
| Độ dài code | Ngắn, không có phép xoay | Dài hơn: xoay và nhiều trường hợp sửa lỗi |
| Range scan | Level 0 là linked list đã sắp xếp, forward pointer cho sẵn thứ tự | Duyệt in-order cần stack hoặc đệ quy |
| Hỗ trợ ZRANK | Trường span: O(log n) | Cần thêm trường kích thước cây con |
| Debug và kiểm tra | Dễ xem cấu trúc | Bug ở phép xoay khó lần ra |
| Worst case | O(log n) kỳ vọng, không được đảm bảo | O(log n) được đảm bảo |
Theo bình luận của Salvatore Sanfilippo (tác giả Redis) trên Hacker News năm 2010, lý do là: bộ nhớ chỉnh được qua tham số xác suất của level, range scan duyệt như linked list nên cache locality không tệ hơn cây cân bằng, và skip list dễ cài, dễ debug (nhờ đơn giản mà một patch thêm trường span để ZRANK đạt O(log n) vào được dễ dàng). Redis chạy lệnh trên một luồng nên lợi thế xử lý đồng thời của skip list không phải lý do chính.
Red-Black tree vẫn tốt hơn khi cần O(log n) worst case được đảm bảo (không phải kỳ vọng) và không cần range scan thường xuyên, ví dụ Java TreeMap.
Thử ngẫmRedis chạy một luồng nên lợi thế xử lý đồng thời của skip list không phải lý do chính; sự đơn giản và range scan mới là. Nếu Redis chuyển sang nhiều luồng, lý do chọn skip list có còn vững không?
10. Bảng decision matrix
| Workload | Thuật toán tốt nhất | Nguồn |
|---|---|---|
Sort Object[] thông thường trong JDK | TimSort | Thư viện chuẩn của Java |
Sort int[] ngẫu nhiên | Dual-Pivot Quick | Quick sort |
| Sort file 10GB vượt RAM | External merge | Mini-challenge bài 08 |
| Sort từng phần tử khi dữ liệu đến liên tục | Insertion hoặc heap | Quadratic sorts, Heap sort |
| Tập có thứ tự với range query | Skip list (Redis ZSET) | Bài này |
| Map có thứ tự, nhiều luồng truy cập | ConcurrentSkipListMap | Java util.concurrent |
| Duy trì Top-K | Min/max heap | Heap sort |
11. Dùng ở đâu trong thực tế
Python sorted() / list.sort(): TimSort bản gốc (Tim Peters 2002, viết cho CPython). Mọi lời gọi sorted() trong Python đều chạy TimSort.
Android Collections.sort và V8: Android dùng bản port của OpenJDK nên Collections.sort chạy TimSort. V8 (Node.js, Chrome) dùng QuickSort trước năm 2018; từ V8 7.0 (Chrome 70) chuyển sang TimSort vì spec ES2019 yêu cầu sort stable.
Bảng xếp hạng và timeline: ZSET với điểm số hoặc timestamp làm score, ZADD khi có sự kiện mới, ZRANGE hoặc ZRANGEBYSCORE để phân trang, mỗi thao tác O(log n) (cộng k phần tử trả về).
12. Đào sâu: tài liệu gốc
- Tim Peters, listsort.txt: bản mô tả gốc, nên đọc trước source.
- OpenJDK 21, TimSort.java: xem
mergeCollapse,gallopRight,gallopLeft. - de Gouw et al. (2015), "OpenJDK’s Java.utils.Collection.sort() Is Broken: The Good, the Bad and the Worst Case": bug
mergeCollapseđược tìm ra bằng formal verification. - Redis
src/t_zset.c(zslInsert,zslGetRank) vàsrc/server.h(structzskiplistNode, trườngspan). - Bình luận của antirez trên Hacker News (2010) về vì sao Redis chọn skip list.
- V8 blog, "Array.prototype.sort stability".
- Đọc lại: Quadratic sorts, Merge sort, Skip list, Self-balancing tree.
13. Tóm tắt
Điều rút ra để áp dụng:
- Chọn thuật toán sort theo dữ liệu thật: nếu dữ liệu hay có đoạn đã sắp xếp sẵn thì thuật toán adaptive như TimSort có lợi lớn.
- Chứng minh bằng giấy chưa đủ: lỗi
mergeCollapsecủa TimSort tồn tại nhiều năm trong JDK, Python và Android cho tới khi bị formal verification tìm ra (2015). Hãy viết thêm test theo thuộc tính (property-based test) cho cấu trúc phức tạp. - Redis ZSET cần cả tra cứu theo member (dict) lẫn range theo score (skip list); khi một cấu trúc không đủ, ghép hai cái và trả giá bằng bộ nhớ.
- Chọn skip list thay Red-Black tree khi code đơn giản, range scan và xử lý đồng thời quan trọng hơn worst case được đảm bảo.
- Java dùng hai thuật toán: Dual-Pivot Quicksort cho
int[]và TimSort cho object.
14. Tự kiểm tra
- Q1TimSort nhận ra run rồi kéo dài bằng Insertion sort. Vì sao Insertion sort thắng cho mảng con 32 phần tử, chứ không phải Merge sort hay Quick sort?
- Q2Galloping merge giúp giảm số phép so sánh. Khi nào nó được bật và chi phí lớn nhất của nó là gì?
- Q3Redis ZSET dùng skip list và dict nên tốn thêm bộ nhớ. Hãy bảo vệ sự đánh đổi này.
- Q4Bug mergeCollapse của TimSort được phát hiện bằng formal verification năm 2015. Bài học gì cho việc review code production?
- Q5Cho code: Collections.sort(list) với 10 triệu Person object. TimSort có nhanh hơn Quick không, và điều đó phụ thuộc vào gì?
- Q6So sánh ZSET với một sorted Map kiểu (Score, List của Member) trong Java: ưu nhược điểm và đánh đổi là gì?
Bài tiếp theo: Tổng kết & cheat sheet
Mini-challenge — External merge sort: sort 10GB file với 1GB RAM
Bài tiếpSắp xếp & thứ tự: tổng kết và cheat sheet
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này