Sorting landscape — Comparison vs non-comparison, lower bound n log n
Vì sao Java sort int[] và Integer[] khác nhau? Comparison sort bị chặn n log n nhưng Counting sort đạt O(n) — bài này map 9 algorithm, 5 thuộc tính phân loại.
TL;DR: Thuật toán sắp xếp chia làm hai nhóm lớn: comparison sort (chỉ so sánh từng cặp phần tử, cận dưới Θ(n log n) không thể vượt qua) và non-comparison sort (dùng thông tin về khoảng giá trị của key để đặt thẳng phần tử vào vị trí, đạt O(n+k)). Năm thuộc tính phân loại là stable, in-place, adaptive, online và comparison-based; chúng quyết định thuật toán nào hợp với bài toán nào. Không thuật toán nào thắng cả 5. Java dùng Dual-Pivot Quicksort cho int[] (nhanh, non-stable) và TimSort cho Integer[] (stable, adaptive), mỗi lựa chọn đều có lý do rõ ràng.
Thử bài toán kinh điển: sắp xếp 1 triệu số nguyên. Junior viết Bubble sort O(n²): hai vòng lặp lồng nhau, cỡ 10¹² bước, chạy hàng chục phút trên laptop thông thường. Senior gọi built-in sort, xong trong chưa tới một giây. Chênh nhau hàng nghìn lần. (Nếu chưa quen vì sao hai vòng lặp lồng cho ra n², ôn lại ở lặp lồng nhau.)
Nhưng câu hỏi thú vị không phải "dùng hàm có sẵn thì nhanh hơn tự viết". Câu hỏi là: vì sao cận dưới (lower bound, tức mức nhanh nhất có thể đạt được) của mọi comparison sort là n log n, trong khi Counting sort lại đạt O(n)? Và tại sao Quick sort thực tế nhanh hơn Merge sort dù cùng độ phức tạp trung bình?
Bài này vẽ bản đồ các thuật toán sắp xếp: comparison vs non-comparison, stable vs in-place, adaptive. Đây là nền cho 8 bài tiếp theo của module (bài 02 đến 09).
1. Hình dung: Sắp bài tú lơ khơ
Hình dung bạn đang sắp lại một bộ bài 52 lá theo thứ tự.
Cách 1 — Comparison sort: cầm 2 quân bài, so sánh, đặt lá nhỏ hơn sang trái. Lặp lại cho đến khi xong. Mỗi cặp đặt cạnh nhau là 1 phép so sánh. Bạn không cần biết trước có những lá nào, chỉ cần biết "lá này lớn hơn hay nhỏ hơn lá kia". Merge sort, Quick sort, Heap sort đều thuộc nhóm này.
Cách 2 — Non-comparison sort: chia sẵn 4 ô theo suit (cơ, rô, nhép, bích), rồi đặt thẳng mỗi lá vào ô tương ứng mà không cần so sánh lá nào với lá nào. Nhanh hơn vì bạn dùng thông tin về khoảng giá trị của key: biết trước chỉ có 52 lá, biết trước 4 suit. Counting sort và Radix sort thuộc nhóm này.
| Sắp bài | Sorting algorithm |
|---|---|
| Cầm 2 lá, so sánh, đặt trái/phải | Comparison sort: mỗi bước là 1 phép so sánh |
| Biết trước có 4 suit, đặt thẳng vào ô | Non-comparison sort: dùng khoảng giá trị của key |
| Cần sắp lại khi có bài mới chèn vào | Online sort: Insertion sort xử lý từng phần tử mới đến |
| Bài đã gần thứ tự → ít bước hơn | Adaptive sort: TimSort, Insertion sort |
Comparison sort so từng cặp, không cần biết khoảng giá trị. Non-comparison sort biết khoảng giá trị nên đặt thẳng vào vị trí, không cần so sánh. Loại sau nhanh hơn nhưng chỉ dùng được khi biết trước khoảng giá trị của key.
2. Năm thuộc tính phân loại sorting algorithm
Trước khi chọn thuật toán sắp xếp cho một bài toán cụ thể, bạn cần hiểu 5 thuộc tính này:
| Thuộc tính | Định nghĩa | Ví dụ thắng | Ví dụ thua |
|---|---|---|---|
| Comparison-based | Chỉ dựa vào so sánh 2 phần tử | Merge / Quick / Heap | Counting / Radix (không so sánh) |
| Stable | Phần tử bằng nhau giữ thứ tự ban đầu | Merge / Insertion / TimSort | Quick / Heap |
| In-place | Bộ nhớ phụ O(1), không kể mảng đầu vào | Quick / Heap / Insertion | Merge (cần buffer phụ O(n)) |
| Adaptive | Nhanh hơn khi đầu vào gần đã sắp xếp | Insertion / TimSort | Merge / Heap (không nhanh hơn) |
| Online | Sort được khi dữ liệu đến từng phần | Insertion (được) | Quick / Merge (cần có toàn bộ dữ liệu) |
Không thuật toán nào thắng cả 5. Đó là lý do có nhiều thuật toán sort khác nhau, và Java dùng thuật toán khác nhau cho từng trường hợp.
3. Comparison sort lower bound: vì sao không thể nhanh hơn n log n
Đây là kết quả lý thuyết quan trọng nhất của bài toán sắp xếp: không comparison sort nào có worst-case tốt hơn O(n log n).
3.1 Decision tree argument
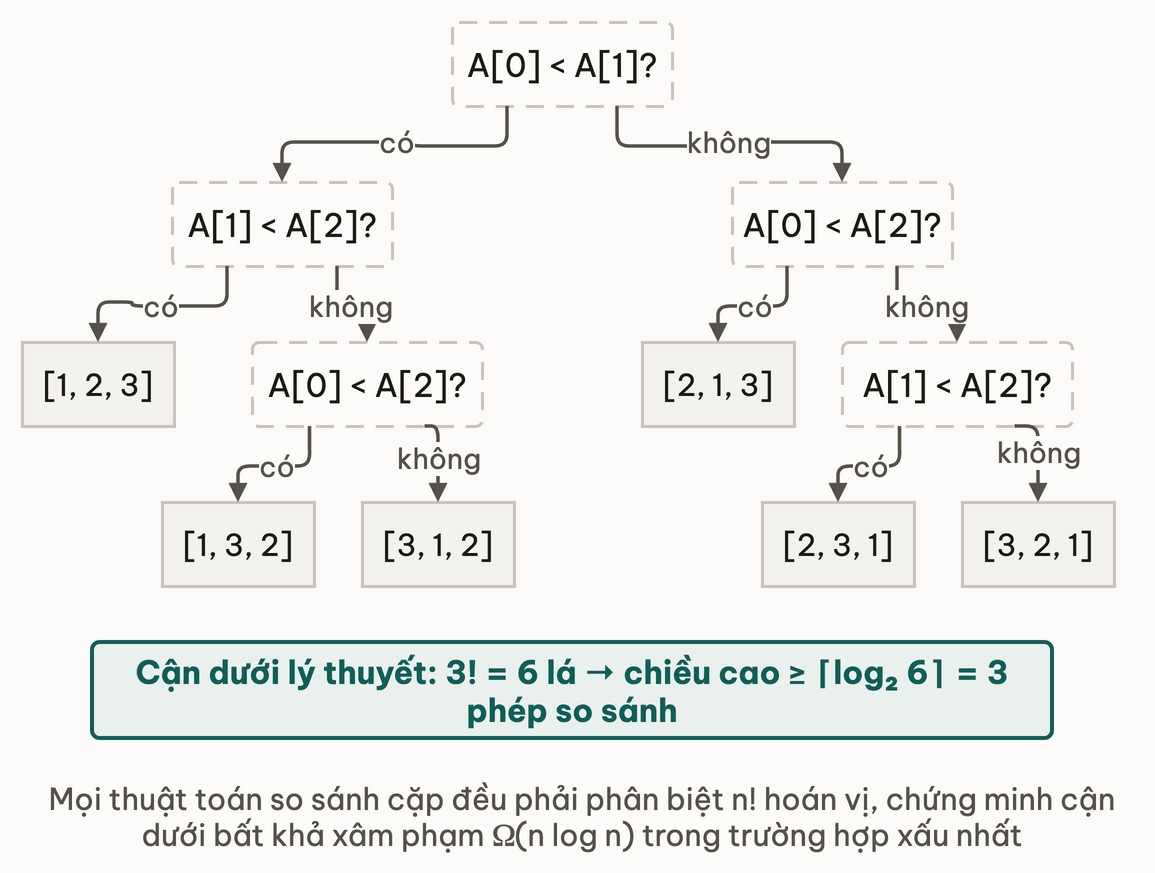
Mỗi lần so sánh hai phần tử là một nhánh quyết định nhị phân: "A nhỏ hơn B?" thì trả lời có hoặc không. Toàn bộ quá trình sort là một cây nhị phân gồm các quyết định này, gọi là decision tree (cây quyết định).
Với n phần tử, có n! cách sắp xếp khả dĩ (hoán vị, permutation). Để sort đúng mọi input, thuật toán phải phân biệt được tất cả n! hoán vị, nên mỗi lá (leaf) của cây quyết định phải ứng với đúng một hoán vị.
n = 3, n! = 6 permutation: [1,2,3] [1,3,2] [2,1,3] [2,3,1] [3,1,2] [3,2,1]

                 A[0] < A[1]?
                /            \
          yes                  no
       A[1] < A[2]?          A[0] < A[2]?
       /         \            /          \
    [1,2,3]  A[0]<A[2]?  [2,1,3]    A[1]<A[2]?
              /    \                  /       \
         [1,3,2] [3,1,2]         [2,3,1]  [3,2,1]
Cây nhị phân có n! lá thì cao ít nhất log₂(n!). Theo xấp xỉ Stirling:
log₂(n!) = Θ(n log n)
Hệ quả: trong worst case, mọi comparison sort phải so sánh ít nhất Θ(n log n) lần. Chỉ dùng so sánh thì không có cách nào nhanh hơn.
3.2 Non-comparison sort vượt qua cận dưới bằng cách nào?
Counting sort và Radix sort không so sánh các phần tử với nhau. Chúng dùng thông tin về khoảng giá trị của key:
-- Counting sort: biết key nằm trong [0, k)
count[v] <- 0 cho mọi v trong [0, k)
for each phần tử x trong A:
    count[x] <- count[x] + 1         -- đếm tần suất
-- tính prefix sum để biết vị trí đặt
for v <- 1 đến k-1:
    count[v] <- count[v] + count[v-1]
-- đặt thẳng vào vị trí đúng -- không một phép so sánh nào
for i <- n-1 xuống 0:
    output[count[A[i]] - 1] <- A[i]
    count[A[i]] <- count[A[i]] - 1
Time: O(n+k) Space: O(n+k)
Lập luận cây quyết định không áp dụng ở đây vì không có "nhánh so sánh" nào, chỉ có phép tính trên index. Bài Counting / Radix / Bucket sort trace từng bước.
Không cần chứng minh đầy đủ công thức Stirling. Chỉ cần nhớ: n! xấp xỉ (n/e)^n × sqrt(2πn), suy ra log(n!) xấp xỉ n×log(n) - n×log(e) = Θ(n log n). Muốn đọc chứng minh đầy đủ, xem Knuth TAOCP Vol. 3, Chapter 5.3.1.
Thử ngẫmcận dưới n log n chỉ áp dụng cho comparison sort. Nếu biết trước mọi key chỉ nằm trong khoảng 0-100, Counting sort có vượt được rào đó không, và cái giá phải trả là gì?
4. Bản đồ 9 thuật toán trong module
Bảng dưới đây là bản đồ toàn module. Các cột độ phức tạp ghi gọn: n log n là O(n log n), n+k là O(n+k):
| Algorithm | Best | Average | Worst | Space | Stable | In-place | Lesson |
|---|---|---|---|---|---|---|---|
| Bubble | n | n² | n² | 1 | yes | yes | 02 |
| Insertion | n | n² | n² | 1 | yes | yes | 02 |
| Selection | n² | n² | n² | 1 | no | yes | 02 |
| Merge | n log n | n log n | n log n | n | yes | no | 03 |
| Quick | n log n | n log n | n² | log n | no | yes | 04 |
| Heap | n log n | n log n | n log n | 1 | no | yes | 05 |
| Counting | n+k | n+k | n+k | n+k | yes | no | 06 |
| Radix | n×d | n×d | n×d | n+k | yes | no | 06 |
| Skip list* | n log n | n log n | n log n | n | yes | no | 07 |
Ghi chú: k = số giá trị key có thể có, d = số chữ số. Space của Quick sort là O(log n) cho recursion stack, không phải O(1) thật sự, nhưng người ta vẫn coi là "in-place" vì nó không dùng buffer phụ cỡ mảng đầu vào.
*Skip list là cấu trúc dữ liệu cho tập có thứ tự (không phải thuật toán sắp xếp mảng): insert/delete/search đều O(log n) mỗi thao tác, và tự giữ thứ tự. Các cột ở trên là chi phí để dựng tập có thứ tự từ n phần tử. Đừng dùng skip list để sort mảng thông thường; hãy dùng Merge/Quick/Heap sort. Bài 07 đi sâu vào cấu trúc bên trong của skip list và Redis ZSET.
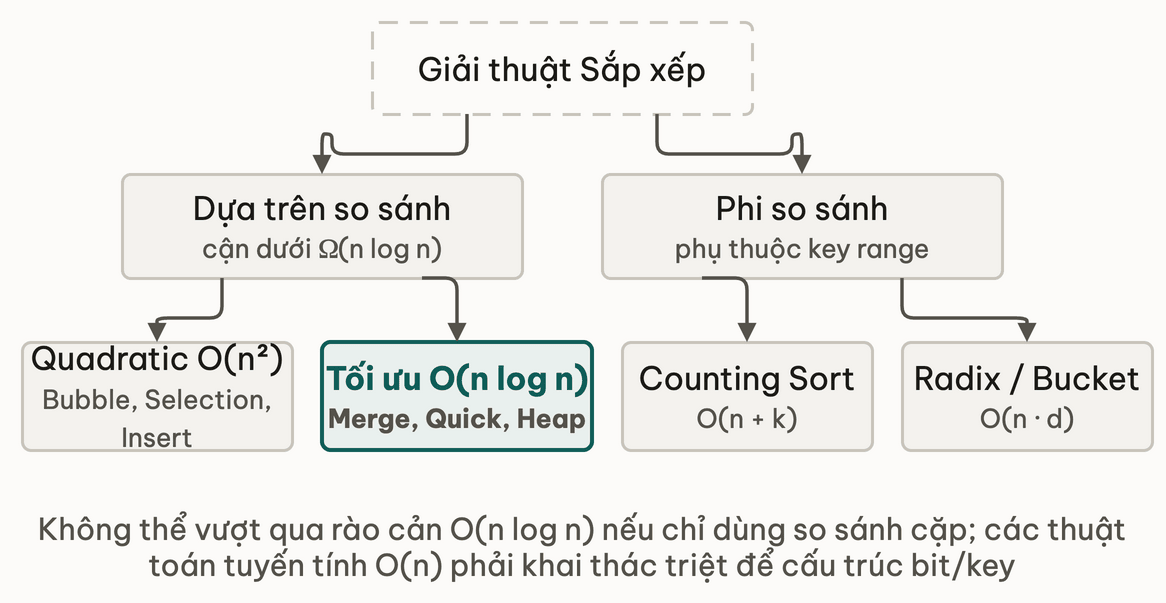
Heap sort có worst-case O(n log n) được đảm bảo và chỉ tốn O(1) bộ nhớ phụ, nghe như lựa chọn tốt nhất. Nhưng thực tế Quick sort thường nhanh hơn Heap sort khá rõ vì truy cập bộ nhớ gần nhau hơn nên tận dụng cache tốt hơn. Bảng Big-O không nói hết: tốc độ thực tế còn phụ thuộc vào hằng số bị Big-O che đi và cách truy cập bộ nhớ (xem thêm cache locality).
5. Stable sort: vì sao quan trọng
Stable sort giữ nguyên thứ tự tương đối của các phần tử có giá trị bằng nhau.
Tình huống cụ thể: bạn có danh sách nhân viên đã sort theo tên (A-Z), giờ cần sort lại theo mức lương. Với stable sort, những người cùng mức lương vẫn giữ thứ tự tên A-Z trong nhóm đó. Với non-stable sort (Quick / Heap), thứ tự tên trong cùng nhóm lương bị xáo trộn tuỳ ý.
-- Ví dụ: nhân viên đã sort theo tên
-- [Alice:50k, Bob:50k, Charlie:60k, David:50k]

-- Sau stable sort theo lương:
-- [Alice:50k, Bob:50k, David:50k, Charlie:60k]
-- Alice, Bob, David vẫn theo thứ tự gốc (A-B-D) trong nhóm 50k

-- Sau non-stable sort theo lương:
-- [David:50k, Alice:50k, Bob:50k, Charlie:60k]  -- thứ tự trong nhóm 50k: không xác định
Time: O(n log n) Space: O(n)
Java standard library:
- Khi sort
Object[]hoặcList, Java dùng TimSort (stable). Các phần tử bằng nhau giữ nguyên thứ tự ban đầu. - Khi sort mảng số nguyên nguyên thuỷ, Java dùng Dual-Pivot Quicksort (non-stable). Kiểu nguyên thuỷ không có "danh tính" (identity): hai số nguyên cùng giá trị 5 hoàn toàn như nhau, không có chuyện phân biệt cái nào đứng trước. Nên stability không có ý nghĩa với kiểu nguyên thuỷ.
6. In-place vs O(n) extra space
"In-place" thường được định nghĩa là chỉ tốn O(1) bộ nhớ phụ (auxiliary space), không tính mảng đầu vào và recursion stack.
Quick sort / Heap sort: in-place theo định nghĩa này. Quick sort dùng trung bình O(log n) cho recursion stack, nhưng không cần buffer phụ cỡ n.
Merge sort: cần buffer O(n) cho bước merge, nên RAM đỉnh khoảng gấp 2 lần kích thước input. Với mảng 100MB, cần thêm 100MB buffer.
External sort (khi dữ liệu vượt RAM) sẽ làm ở mini-challenge External merge sort: chỉnh Merge sort để sort file 10GB với 1GB RAM bằng k-way merge.
Thử ngẫmMerge sort cần buffer ngang kích thước input nên peak RAM gần gấp đôi. Sort một mảng 100MB trên máy chỉ còn trống 120MB RAM — Merge sort có chạy được không?
7. Adaptive sort: TimSort khai thác partially-sorted data
"Adaptive" nghĩa là thuật toán chạy nhanh hơn khi đầu vào đã (gần) sắp xếp sẵn.
Insertion sort là ví dụ adaptive cơ bản nhất: với mảng gần như đã sắp xếp (mỗi phần tử chỉ lệch vài vị trí so với vị trí đúng), nó chạy gần O(n). Với mảng đã sắp xếp hoàn toàn, nó chạy đúng O(n).
TimSort là thuật toán mặc định của Java cho mảng object, và khai thác điều này mạnh hơn nhiều:
- Quét đầu vào để tìm các "run", tức đoạn đã tăng dần hoặc giảm dần. Run ngắn thì kéo dài bằng Insertion sort.
- Gộp các run lại theo thứ tự hợp lý (không gộp tuần tự mà dùng chiến lược dựa trên stack).
Kết quả: với file log theo timestamp hay mảng ID tăng dần, TimSort chạy gần O(n) thay vì O(n log n). Dữ liệu thật thường có kiểu này, nên Python và Java đều dùng TimSort làm mặc định cho mảng object.
Bài Case study TimSort và Redis ZSET đi sâu vào TimSort: galloping mode, cách nhận ra run, quy tắc gộp run.
8. Bẫy thường gặp: cùng n log n không có nghĩa là nhanh bằng nhau
Quick sort (trung bình) và Merge sort cùng O(n log n), nhưng trên mảng số nguyên ngẫu nhiên Quick sort thường nhanh hơn một khoảng đáng kể (cỡ vài chục phần trăm, tuỳ máy và cách cài):
- Cache locality: ở bước partition, Quick sort đọc bộ nhớ gần như tuần tự. Merge sort đọc hai nửa mảng ở hai chỗ khác nhau nên cache miss nhiều hơn.
- Không cấp phát: Quick sort không cần buffer phụ nên không mất thời gian cấp phát.
- Hệ số hằng: ký hiệu O che đi hằng số. Trên dữ liệu ngẫu nhiên, hằng số của Quick sort nhỏ hơn Merge sort.
Đổi lại Quick sort không stable. Cần stable (ví dụ sort nhiều key liên tiếp như mục 5) thì dùng Merge sort hoặc TimSort; sort kiểu nguyên thuỷ mà không cần stable thì Quick sort nhanh hơn.
9. Ứng dụng thực tế
Database ORDER BY: Postgres và MySQL phân tích query để chọn thuật toán. Nếu dữ liệu vừa trong work_mem (Postgres, mặc định 4MB), database dùng Quick sort trong bộ nhớ. Nếu vượt work_mem, nó chuyển sang external merge sort: chia thành các sorted run, ghi ra disk rồi merge lại. Bài mini-challenge External merge sort sẽ tự cài external sort.
Top-K query: không cần sort toàn bộ, chỉ cần K phần tử lớn nhất. Heap cỡ K cho O(n log k) thay vì O(n log n). Ví dụ: lấy top 10 sản phẩm đang hot từ 10 triệu giao dịch, sort hết là lãng phí. Bài Heap sort nói về top-K bằng heap.
Redis ZSET (Sorted Set): dùng skip list để tự giữ thứ tự sau mỗi lần insert/update/delete, mỗi thao tác O(log n), không cần sort lại toàn bộ. Bài Skip list đào sâu cấu trúc skip list và lý do Redis chọn skip list thay vì balanced BST.
10. Đào sâu
- The Art of Computer Programming, Vol. 3: Sorting and Searching (Knuth), mục 5.3.1 nói về cận dưới bằng cây quyết định.
- Algorithms, 4th edition (Sedgewick & Wayne): cài đặt bằng Java kèm phân tích.
- "Engineering a Sort Function" (Bentley & McIlroy, 1993), Software: Practice and Experience 23(11): vì sao Quicksort thực tế nhanh, cùng các tối ưu cụ thể.
- Tim Peters, bản mô tả TimSort (
Objects/listsort.txttrong mã nguồn CPython): cách nhận ra run, quy tắc gộp run, galloping. - Vladimir Yaroslavskiy, Dual-Pivot Quicksort (2009): thuật toán Java dùng để sort kiểu nguyên thuỷ từ Java 7.
Đọc thêm: External sort — khoá Thuật toán ứng dụng dựng lại đúng kỹ thuật "chia sorted run, ghi ra disk, merge lại" nêu ở mục 9, với công thức I/O đầy đủ cho dataset không vừa RAM.
11. Tóm tắt
Checklist khi chọn thuật toán sort:
- Hỏi trước: có cần stable không (sort nhiều key liên tiếp)? Có cần in-place không? Dữ liệu có gần như đã sắp xếp không?
- Chỉ so sánh được phần tử với nhau thì không thể nhanh hơn n log n; muốn nhanh hơn phải biết thêm về key (khoảng giá trị, số chữ số) và dùng Counting hoặc Radix.
- Trong Java,
int[]dùng Dual-Pivot Quicksort vì số nguyên bằng nhau không phân biệt được; object dùng TimSort vì cần stable. - Quick sort thường nhanh hơn Merge sort trên dữ liệu ngẫu nhiên nhờ cache locality và không cấp buffer, nhưng mất stability.
- Dữ liệu thật hay có đoạn đã sắp xếp sẵn, nên TimSort chạy gần O(n) ở những trường hợp đó.
12. Tự kiểm tra
- Q1Vì sao cận dưới của comparison sort là n log n mà Counting sort lại đạt O(n)? Counting sort vượt qua bằng cơ chế gì?
- Q2Java sort kiểu nguyên thuỷ và sort object bằng hai thuật toán khác nhau. Vì sao kiểu nguyên thuỷ không cần stable sort?
- Q3Stable sort là gì? Cho 1 tình huống cụ thể mà non-stable sort sẽ cho kết quả sai.
- Q4In-place sort có thực sự tốn O(1) bộ nhớ khi có đệ quy không? Quick sort thực tế dùng bao nhiêu bộ nhớ?
- Q5Adaptive sort là gì? Khối lượng công việc nào hưởng lợi nhất từ adaptive sort?
- Q6Cho đoạn pseudocode: sort list theo lương rồi sort lại theo tên bằng non-stable sort. Thứ tự trong cùng nhóm tên có đúng không? Vì sao?
Bài tiếp theo: Quadratic sorts — Insertion / Selection / Bubble
Sắp xếp & thứ tự: tổng quan module
Bài tiếpQuadratic sorts — Bubble, Selection, Insertion sort
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này