Counting / Radix / Bucket sort — Non-comparison O(n) khi key range nhỏ
Counting sort đạt O(n) mà không vi phạm lower bound n log n — 3 non-comparison sort: counting, radix LSD/MSD, bucket; khi nào chọn từng loại và memory cost cần lưu ý.
TL;DR: Ba thuật toán sắp xếp không dùng phép so sánh (non-comparison sort) là Counting, Radix và Bucket. Chúng vượt qua cận dưới n log n không phải bằng cách "phá" lý thuyết, mà bằng cách thêm giả định về dữ liệu đầu vào. Counting sort đếm tần suất rồi đặt thẳng vào vị trí, đạt O(n + k) khi khoảng giá trị k nhỏ. Radix sort xử lý từng chữ số riêng, đạt O(n × d) cho key có độ rộng cố định. Bucket sort chia phần tử vào nhiều bucket rồi sort từng bucket, đạt O(n + k) kỳ vọng khi dữ liệu phân bố đều. Đánh đổi cốt lõi: tốn thêm O(n + k) bộ nhớ và phải giả định về dữ liệu để lấy tốc độ, không có "bữa trưa miễn phí".
Bài Sort landscape đã chứng minh cận dưới (lower bound) n log n cho mọi comparison sort: chỉ dùng phép so sánh thì không có cách nào nhanh hơn. Nhưng nếu cần sort 100 triệu bản ghi int có giá trị từ 0 đến 1000 thì sao? Counting sort chạy O(n + k) với k = 1001, tức là O(n), không dính n log n.
Điểm mấu chốt: cận dưới đó chỉ áp dụng cho sort dựa trên phép so sánh (comparison-based). Khi biết thêm về key (khoảng giá trị nhỏ, số chữ số cố định, hay phân bố đều), ta bỏ hẳn phép so sánh và chạy nhanh hơn.
Bài này dạy 3 thuật toán đó: Counting sort (khoảng giá trị nhỏ), Radix sort LSD/MSD (key có độ rộng cố định) và Bucket sort (dữ liệu phân bố đều). Bài cũng nói khi nào chọn loại nào và cái giá về bộ nhớ.
1. Hình dung: Sắp bài theo suit
Hình dung một bộ bài 52 lá cần sắp theo suit: cơ, rô, nhép, bích.
Nếu dùng comparison sort: cầm hai lá, so sánh, đặt lá nhỏ hơn sang trái, lặp lại đến khi xong. Mỗi bước tốn 1 phép so sánh.
Nếu dùng non-comparison sort: đặt sẵn 4 ô trên bàn, mỗi ô là 1 suit. Nhặt từng lá, nhìn suit, bỏ thẳng vào ô đúng, không cần so sánh lá nào với lá nào. Hết bài thì đọc theo thứ tự ô. Nhanh hơn vì biết trước chỉ có 4 suit.
| Sắp bài theo suit | Counting sort |
|---|---|
| 4 ô suit đặt sẵn trên bàn | Mảng đếm (counting array) kích thước k, bằng số giá trị key có thể có |
| Nhìn suit của lá, bỏ vào ô tương ứng | Đọc key, tăng count[key]++ |
| Không so sánh lá nào với lá nào | Không so sánh các phần tử với nhau |
| Biết trước chỉ có 4 suit | Biết trước key nằm trong khoảng [0, k) |
| Đọc ô theo thứ tự để lấy kết quả | Prefix sum rồi đặt từng phần tử = mảng kết quả đã sắp xếp |
Non-comparison sort nghĩa là đặt sẵn chỗ rồi bỏ thẳng vào. Không cần hỏi "lá này lớn hơn lá kia không?" — chỉ cần hỏi "lá này thuộc ô nào?". Đổi lại, phải biết trước có bao nhiêu ô.
2. Counting sort
2.1 Cơ chế
Cho mảng các số nguyên trong khoảng [0, k). Giá trị của phần tử được dùng làm chỉ số của mảng đếm, đúng như cách bạn tra mảng theo chỉ số ở for và danh sách. Ba bước:
- Count: đếm tần suất mỗi giá trị vào
count[0..k-1]. - Prefix sum: biến
count[i]thành số phần tử có giá trị nhỏ hơn hoặc bằngi, tức là vị trí cuối của giá trịitrong mảng kết quả. - Place (right-to-left): duyệt mảng gốc từ phải sang trái, đặt từng phần tử vào đúng vị trí trong mảng kết quả.
CountingSort(A, k):
    -- A: mảng n phần tử nguyên trong [0, k)
    count[0..k-1] <- 0

    -- Bước 1: đếm tần suất
    for each x trong A:
        count[x] <- count[x] + 1

    -- Bước 2: prefix sum — count[i] = số phần tử <= i
    for i <- 1 đến k-1:
        count[i] <- count[i] + count[i-1]

    -- Bước 3: đặt từ phải sang trái để đảm bảo stable
    output[0..n-1] <- 0
    for i <- n-1 xuống 0:
        count[A[i]] <- count[A[i]] - 1
        output[count[A[i]]] <- A[i]

    copy output vào A
Time: O(n + k) Space: O(n + k)
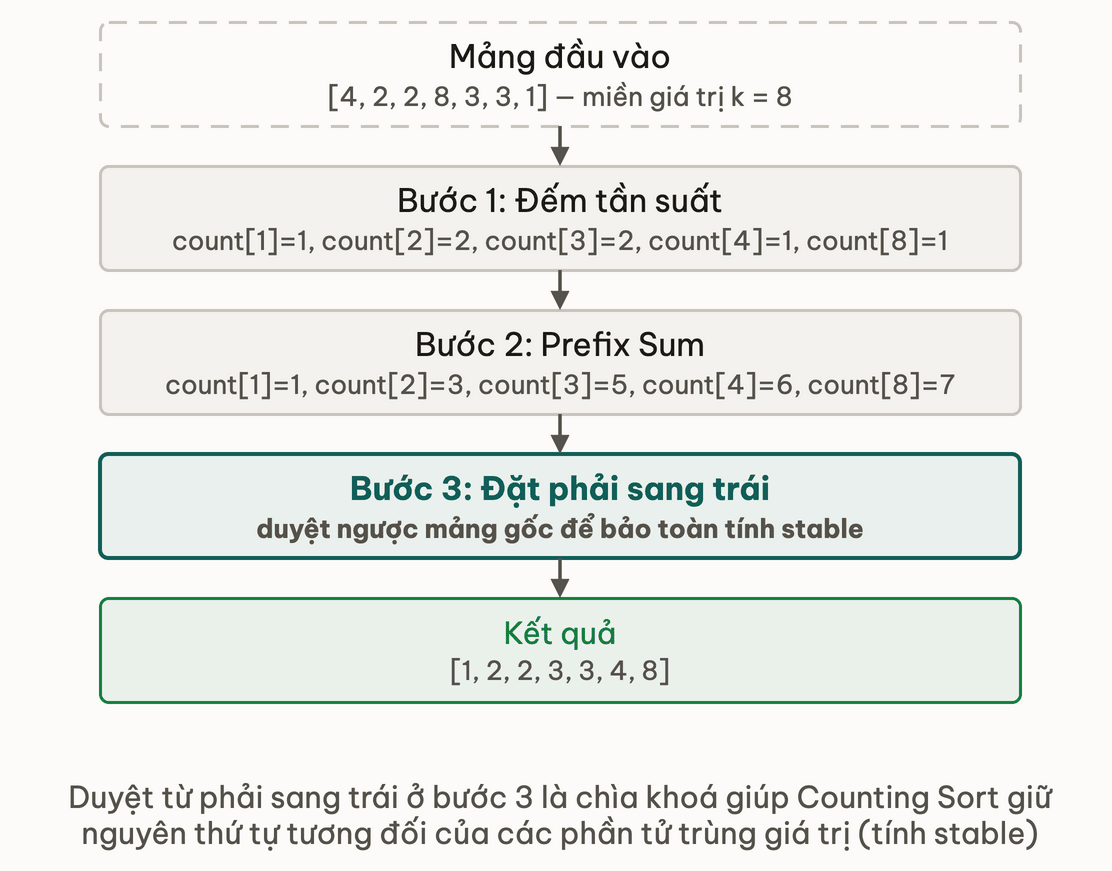
2.2 Trace ví dụ
Chưa quen đọc trace thì ôn lại bảng trace. Sort [4, 2, 2, 8, 3, 3, 1] với k = 10:
Input:       [4, 2, 2, 8, 3, 3, 1]

Count step:
  count[0]=0, count[1]=1, count[2]=2, count[3]=2
  count[4]=1, count[5..7]=0, count[8]=1

Prefix sum:
  count[0]=0, count[1]=1, count[2]=3, count[3]=5
  count[4]=6, count[5..7]=6, count[8]=7

Place right-to-left:
  i=6: A[6]=1 -> output[--count[1]] = output[0] = 1
  i=5: A[5]=3 -> output[--count[3]] = output[4] = 3
  i=4: A[4]=3 -> output[--count[3]] = output[3] = 3
  i=3: A[3]=8 -> output[--count[8]] = output[6] = 8
  i=2: A[2]=2 -> output[--count[2]] = output[2] = 2
  i=1: A[1]=2 -> output[--count[2]] = output[1] = 2
  i=0: A[0]=4 -> output[--count[4]] = output[5] = 4

Output: [1, 2, 2, 3, 3, 4, 8]
2.3 Properties
| Thuộc tính | Giá trị |
|---|---|
| Time | O(n + k) |
| Space | O(n + k) |
| Stable (các phần tử bằng nhau giữ nguyên thứ tự ban đầu) | Có (đặt từ phải sang trái giữ thứ tự gốc) |
| In-place (không cần mảng phụ cùng cỡ) | Không |
| Khi nào dùng | Key là số nguyên trong khoảng nhỏ: 0-100, 0-1000 |
Vì sao duyệt từ phải sang trái thì giữ được stability? Phần tử đứng sau trong input được đặt vào ô cuối cùng còn trống của giá trị đó, phần tử đứng trước thì lấp vào ô liền trước. Nhờ vậy các phần tử bằng nhau giữ nguyên thứ tự tương đối.
Thử ngẫmduyệt từ phải sang trái giữ được stability vì phần tử đứng sau trong input rơi vào ô cuối còn trống. Đổi vòng lặp đặt sang duyệt từ trái sang phải, kết quả vẫn đúng thứ tự SỐ nhưng mất gì?
3. Radix sort (LSD: Least Significant Digit first)
3.1 Ý tưởng
Counting sort đòi hỏi k nhỏ. Với số nguyên 32-bit, k có thể lên tới hàng tỉ nên không thực tế. Radix sort xử lý từng chữ số (digit) riêng, mỗi lượt chạy Counting sort theo chữ số đó.
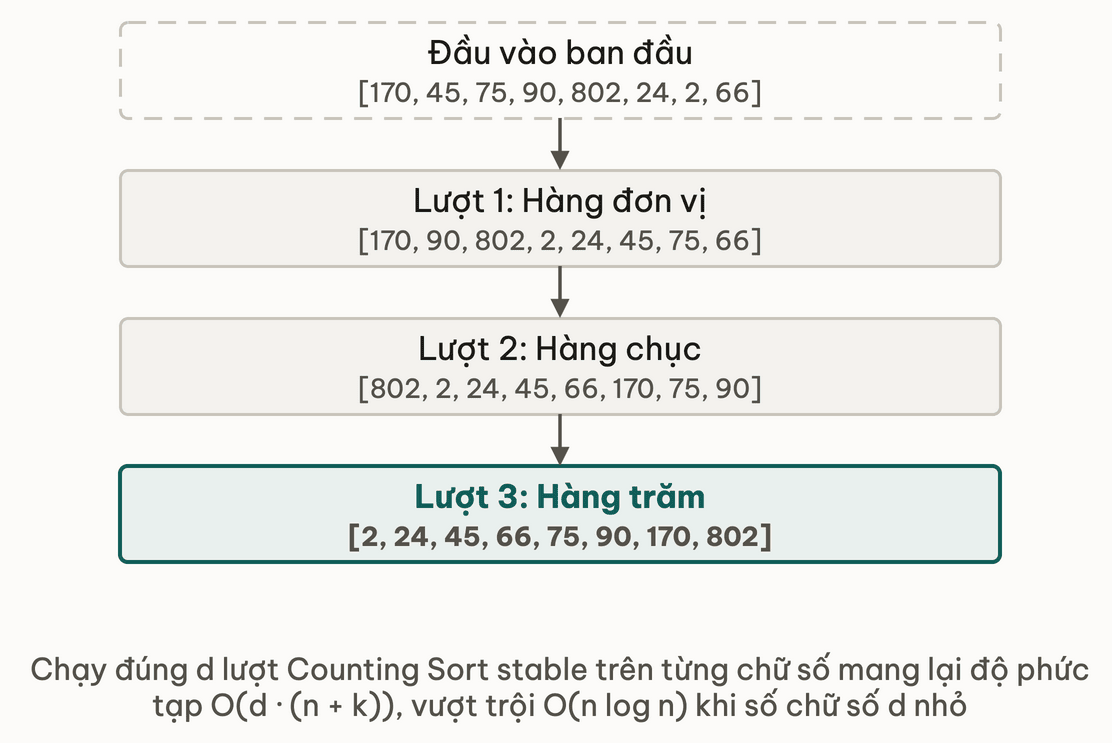
LSD (Least Significant Digit): bắt đầu từ chữ số ít quan trọng nhất (hàng đơn vị), sort theo đó, rồi tiến dần lên hàng chục, hàng trăm... Mỗi lượt sort con phải stable, để thứ tự đã xếp theo chữ số trước không bị phá khi sort chữ số sau.
RadixSortLSD(A, d):
    -- A: mảng n số nguyên; d: số chữ số tối đa
    for exp <- 1, 10, 100, ..., 10^(d-1):   -- từ hàng đơn vị lên
        CountingSortByDigit(A, exp)          -- sort ổn định theo chữ số exp

CountingSortByDigit(A, exp):
    -- Đếm theo chữ số tại vị trí exp (base 10)
    count[0..9] <- 0
    for each x trong A:
        digit <- (x / exp) % 10
        count[digit] <- count[digit] + 1

    -- Prefix sum
    for i <- 1 đến 9:
        count[i] <- count[i] + count[i-1]

    -- Đặt từ phải sang trái (stable)
    output[0..n-1] <- 0
    for i <- n-1 xuống 0:
        d <- (A[i] / exp) % 10
        count[d] <- count[d] - 1
        output[count[d]] <- A[i]

    copy output vào A
Time: O(n × d) Space: O(n + k)
3.2 Trace ví dụ
Sort [170, 45, 75, 90, 802, 24, 2, 66]:
exp=1 (hang don vi):
  Input:  [170, 45, 75, 90, 802, 24, 2, 66]
  Digits: [  0,  5,  5,  0,   2,  4, 2,  6]
  After:  [170, 90, 802, 2, 24, 45, 75, 66]

exp=10 (hang chuc):
  Input:  [170, 90, 802, 2, 24, 45, 75, 66]
  Digits: [  7,  9,   0, 0,  2,  4,  7,  6]
  After:  [802, 2, 24, 45, 66, 170, 75, 90]

exp=100 (hang tram):
  Input:  [802, 2, 24, 45, 66, 170, 75, 90]
  Digits: [  8, 0,  0,  0,  0,   1,  0,  0]
  After:  [2, 24, 45, 66, 75, 90, 170, 802]
3.3 Properties và variant
| Thuộc tính | Giá trị |
|---|---|
| Time | O(n × d), d = số digit |
| Space | O(n + k), k = base (10 hoặc 256) |
| Stable | Yes (dùng stable sub-sort) |
| In-place | No |
| Khi nào dùng | Fixed-width key: 32-bit int, 64-bit long, fixed-length string |
MSD (Most Significant Digit first): bắt đầu từ chữ số quan trọng nhất, rồi xử lý đệ quy theo từng bucket. Cách này hợp với chuỗi có độ dài thay đổi và với trường hợp muốn dừng sớm. Nó phức tạp hơn LSD vì phải quản lý bucket đệ quy riêng cho từng prefix.
Base lớn hơn thì ít pass hơn: thay vì base 10 (số cỡ 10 tỉ có 10 chữ số, tức 10 pass), dùng base 256 (1 byte = 1 digit, chỉ 4 pass cho int 32-bit). Mỗi pass tốn O(n + 256) thay vì O(n + 10), nhưng tổng số pass giảm nên chạy nhanh hơn ở hệ số hằng.
Thử ngẫmbase 256 chỉ cần 4 pass cho số 32-bit thay vì 10 pass ở base 10, mỗi pass tốn O(n + 256). Với key là long 64-bit, base 256 cần bao nhiêu pass?
4. Bucket sort
4.1 Ý tưởng
Bucket sort phù hợp khi dữ liệu phân bố đều (uniform distribution) trên một khoảng đã biết. Chia khoảng đó thành k bucket đều nhau, rải từng phần tử vào bucket tương ứng, sort từng bucket bằng comparison sort, rồi nối các bucket lại.
BucketSort(A, k):
    -- A: mảng n phần tử float trong [0.0, 1.0); k: số bucket
    buckets[0..k-1] <- danh sách rỗng

    -- Phân phối vào bucket
    for each x trong A:
        idx <- floor(x * k)
        buckets[idx].append(x)

    -- Sort từng bucket (insertion sort hiệu quả cho bucket nhỏ)
    pos <- 0
    for each bucket trong buckets:
        InsertionSort(bucket)
        for each x trong bucket:
            A[pos] <- x
            pos <- pos + 1
Time: O(n + k) kỳ vọng (phân bố đều) Space: O(n + k)
4.2 Phân tích
Best case (phân bố đều): mỗi bucket nhận xấp xỉ n/k phần tử. Sort từng bucket tốn O((n/k) log(n/k)). Tổng: O(n + k × (n/k) log(n/k)) = O(n + n log(n/k)). Khi k = n, O(n) — tuyến tính.
Worst case (phân bố lệch): toàn bộ phần tử rơi vào 1 bucket. Sort bucket đó tốn O(n log n), tức là thoái hoá thành comparison sort.
| Phân phối | Complexity |
|---|---|
| Đều | O(n + k) kỳ vọng |
| Lệch / dồn cụm | O(n log n) hoặc O(n²) |
5. Bảng so sánh đầy đủ
Về thời gian và bộ nhớ, ba thuật toán này đã nằm trong bảng ở Sort landscape. Điểm cần nhớ khi chọn: Counting dùng cho key số nguyên với k nhỏ, Radix LSD cho key rộng cố định, Bucket cho số thực phân bố đều; cả ba đều stable (Bucket stable nếu sort con stable) và đều không in-place.
6. Vì sao non-comparison sort không phá lower bound n log n
Cận dưới n log n chỉ áp dụng cho sort dựa trên phép so sánh. Nó được chứng minh bằng cây quyết định (decision tree) có n! hoán vị (xem Sort landscape).
Non-comparison sort không tạo cây quyết định kiểu so sánh. Thay vào đó, chúng dùng thêm giả định về input:
- Counting sort: key nằm trong khoảng nhỏ
[0, k), nên dùng key làm index trực tiếp. - Radix sort: key có số chữ số d cố định, nên xử lý từng chữ số độc lập.
- Bucket sort: dữ liệu gần phân bố đều, nên rải đều vào các bucket.
Khi giả định đó sai (k lớn, d lớn, dữ liệu phân bố lệch), non-comparison sort không còn nhanh hơn, thậm chí còn tệ hơn về bộ nhớ và worst case.
Đánh đổi ở đây là tốn thêm bộ nhớ và phải giả định về input để lấy tốc độ. Cận dưới không bị "phá"; bài toán chỉ đổi từ "sort dữ liệu bất kỳ" thành "sort dữ liệu có cấu trúc đặc biệt".
7. Bẫy thường gặp
Bẫy 1: Counting sort với range lớn: OOM
-- BUG: k = 2^31 -> cấp phát mảng 2 tỉ phần tử -> OOM
A <- [INT_MAX - 1, 0, 5]
k <- INT_MAX
count[0..k-1] <- 0   -- OutOfMemoryError

-- ĐÚNG: kiểm tra range trước khi cấp phát
min_val <- min(A)
max_val <- max(A)
range <- max_val - min_val + 1
if range > 10 * length(A):
    -- range quá lớn cho counting sort, dùng radix hoặc comparison sort
    ComparisonSort(A)
else:
    CountingSort(A, range, min_val)
Time: O(n) Space: O(range)
Counting sort chỉ thực tế khi k = O(n) hoặc nhỏ hơn. Với mảng 1 triệu phần tử, k hợp lý là dưới vài triệu. Nếu khoảng giá trị lớn, dùng Radix sort thay vì Counting sort trực tiếp.
Bẫy 2: Radix sort cho variable-length string: thứ tự sai
LSD Radix sort giả định mọi key có cùng độ dài. Với chuỗi dài ngắn khác nhau, phải đệm (padding) bằng ký tự null hoặc dấu cách. Việc đệm phải làm cẩn thận: ký tự đệm phải nhỏ hơn mọi ký tự thật thì thứ tự từ điển (lexicographic) mới đúng, và đệm cả mảng tới độ dài của chuỗi dài nhất có thể rất tốn.
Input strings: ["car", "cat", "a", "be"]
Pad to length 3: ["car", "cat", "a  ", "be "]   -- space padding
LSD only matches natural sort if the pad char is smaller than every real char

Safe approach: use MSD radix sort (handles variable length natively)
or use comparison sort with standard compareTo()
Với chuỗi có độ dài thay đổi: ưu tiên MSD radix, hoặc Counting sort theo ký tự ở từng tầng. Còn nếu chưa đo ra nút thắt (bottleneck) thật sự thì cứ dùng comparison sort cho đơn giản.
Bẫy 3: Bucket sort với non-uniform distribution
-- Nếu toàn bộ giá trị cluster gần 0.01, rơi hết vào bucket 0
A <- [0.001, 0.005, 0.003, 0.007, 0.002, 0.8, 0.9]
-- Bucket kích thước 0.1: hầu hết phần tử vào bucket 0
-- -> O(n log n) cho bucket đó -> không lợi gì so với comparison sort
Hãy đo phân bố dữ liệu trước khi dùng Bucket sort. Nếu dữ liệu có dạng log-normal, Zipfian hay power-law, phải chia ranh giới bucket theo phân bố thật thay vì chia đều. Hoặc chuyển sang Counting/Radix sort nếu key quy được về số nguyên.
Thử ngẫmdồn hết vào một bucket thì bucket sort thoái hoá về O(n log n). Timestamp của log giờ cao điểm dồn vào vài phút; bạn chia ranh giới bucket thế nào để tránh thoái hoá đó?
8. Java standard library và production note
Arrays.sort(int[]) của Java dùng Dual-Pivot Quicksort, không dùng Radix sort (kiểm trên mã nguồn JDK 21: không có radix sort trong DualPivotQuicksort). Lý do: Arrays.sort nhận mảng bất kỳ, không biết trước khoảng giá trị của key, còn non-comparison sort cần thêm thông tin (k, số chữ số, phân bố).
Có một ngoại lệ thú vị: với byte[], short[] và char[], khoảng giá trị chỉ 256 hoặc 65536 nên JDK 21 dùng đúng Counting sort khi mảng đủ lớn (từ khoảng 64 phần tử với byte[], từ khoảng 1750 với short[] và char[]). Đây là ví dụ sách giáo khoa về "biết khoảng giá trị thì đếm thay vì so sánh".
Ngoài JDK, thư viện fastutil có IntArrays.radixSort(int[]) là radix sort cho int; mức nhanh hơn Arrays.sort tuỳ máy và dữ liệu, hãy tự đo.
9. Ứng dụng thực tế
Database aggregation — GROUP BY với key số nguyên: khi gom COUNT(*) theo http_status_code (giá trị 100-599), cách nhanh nhất là giữ một mảng đếm kích thước 600, chính là cấu trúc của Counting sort. Tổng O(n) thay vì O(n log n) của cách sort rồi mới gom.
Sort điểm thi hoặc rating: điểm 0 đến 10 (hoặc rating 1 đến 5) của hàng triệu bản ghi chỉ có vài giá trị khác nhau, nên Counting sort O(n + k) với k nhỏ thắng sort so sánh.
10. Đào sâu
- Introduction to Algorithms (CLRS), chương 8 (Sorting in Linear Time).
- The Art of Computer Programming, Vol. 3 (Knuth), mục 5.2.5.
- McIlroy, Bostic & McIlroy (1993), "Engineering Radix Sort", Computing Systems 6(1); Sinha & Zobel (2004), "Burstsort". Về trie, xem Trie.
11. Tóm tắt
Checklist trước khi dùng sort không so sánh:
- Key là số nguyên, dải giá trị k nhỏ so với n: Counting sort O(n + k). Nếu k cỡ hàng triệu thì coi chừng hết bộ nhớ.
- Key có độ rộng cố định (int 32-bit, chuỗi cùng độ dài): Radix LSD, mỗi pass dùng Counting sort stable.
- Chuỗi độ dài thay đổi: dùng MSD radix, vì LSD đòi đệm cẩn thận mới ra đúng thứ tự.
- Dữ liệu thực phân bố đều trên một khoảng: Bucket sort, nhưng nếu dữ liệu lệch thì nó thoái hoá về O(n²).
- Không biết gì về dải giá trị thì cứ dùng
Arrays.sort; thư viện Java không dùng Radix choint[].
12. Tự kiểm tra
- Q1Vì sao Counting sort O(n) không phá cận dưới n log n của comparison sort?
- Q2Counting sort đặt từng phần tử vào mảng kết quả, duyệt từ phải sang trái thay vì từ trái sang phải. Điều này ảnh hưởng gì đến stability?
- Q3Radix LSD vs Radix MSD, khi nào pick cái nào?
- Q4Bucket sort worst case O(n²) — vì sao?
- Q5Cho bài toán: 1 triệu địa chỉ IP (32-bit integer) cần sort. Pick algorithm nào? Vì sao?
- Q6Arrays.sort(int[]) của Java không dùng Radix sort dù Radix nhanh hơn trên mảng int lớn. Lý do là gì?
Bài tiếp theo: Skip list — probabilistic balanced, code đơn giản hơn RBTree
Binary heap & Heapsort — Build-heap O(n) và priority queue backbone
Bài tiếpSkip list — Probabilistic balanced, dễ implement hơn Red-Black tree
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này