DFS — Depth-First Search, preorder/postorder, cycle detection
DFS đi sâu từng nhánh — recursive và iterative, white/gray/black coloring phát hiện cycle, preorder vs postorder, connected components, pattern hay gặp trong production.
TL;DR: DFS (Depth-First Search) đi sâu vào một nhánh trước, hết đường mới quay lại thử nhánh khác. Cơ chế là LIFO, qua call stack hoặc một stack tự dựng. Một lần chạy DFS cho ra hai thứ tự: preorder (lúc vào đỉnh) và postorder (lúc rời đỉnh, sau khi xử lý xong mọi đỉnh con). Đảo ngược postorder trên DAG ra topological sort. Bẫy lớn nhất: recursive DFS trên chain graph 1 triệu đỉnh gây StackOverflow, nên phải dùng iterative DFS với stack tự dựng trên heap.
BFS lan sóng theo từng level nên biết "đỉnh nào cách nguồn 3 hop". Nhưng có những bài toán không cần khoảng cách theo level: bạn muốn đi sâu vào một nhánh trước, rồi mới quay lại thử nhánh khác.
Hãy nghĩ đến dependency graph của Maven (cách Maven kéo về cả cây dependency gián tiếp, bạn đã gặp ở Spring Boot Starter & BOM). Để kiểm tra có circular dependency không, bạn đi theo một chuỗi: A phụ thuộc B, B phụ thuộc C, C phụ thuộc... cho đến khi hết đường hoặc quay lại đỉnh ban đầu. Đó chính là DFS. Các bài toán đếm connected component, topological sort, đi mê cung, Tarjan SCC cũng đều dùng DFS rất tự nhiên.
Bài này dạy DFS recursive và iterative, cách tô 3 màu white/gray/black để phát hiện cycle, preorder và postorder, cùng các dạng hay gặp trong hệ thống thật.
1. Hình dung: Khám phá mê cung
Hình dung bạn đang khám phá một mê cung lớn. Chiến lược: chọn một hướng và đi sâu hết mức, đến khi gặp ngõ cụt hoặc chỗ đã đến rồi. Lúc đó quay lại điểm rẽ gần nhất và thử hướng khác. Cứ vậy cho đến khi thăm hết mọi ngóc ngách.
Cơ chế ở đây là LIFO: bạn luôn quay lại điểm rẽ gần nhất, không phải điểm rẽ đầu tiên. BFS thì khác: giống một chiếc drone bay trên cao, thăm mọi phòng cách cửa vào 1 bước trước, rồi 2 bước, rồi 3 bước, không chui sâu vào nhánh nào.
| Mê cung | DFS |
|---|---|
| Bạn tại một ngã rẽ | Đỉnh hiện tại đang xử lý |
| Chọn 1 hướng, đi sâu hết | Đệ quy vào hàng xóm đầu tiên chưa thăm |
| Gặp ngõ cụt, quay lại | Hết hàng xóm chưa thăm, return (pop frame) |
| Điểm rẽ gần nhất | Top của call stack (hoặc explicit stack) |
| Đánh dấu phòng đã thăm | visited[v] <- true |
| Thứ tự vào phòng | Preorder |
| Thứ tự ra khỏi phòng | Postorder |
DFS đi sâu trước, BFS đi rộng trước. DFS dùng LIFO (call stack hoặc Stack), BFS dùng FIFO (Queue).
2. Thuật toán DFS — recursive
DFS đệ quy là một hàm tự gọi lại chính nó cho từng hàng xóm chưa thăm. Nếu chưa chắc tay về hàm nhận vào và trả ra gì, ôn lại Hàm trong khoá Nhập môn lập trình.
DFS(G, start):
    visited[v] <- false cho mọi v
    dfsHelper(G, start, visited)

dfsHelper(G, v, visited):
    if visited[v]: return
    visited[v] <- true

    -- xử lý preorder: ngay khi vào đỉnh
    process_preorder(v)

    for each đỉnh u kề v trong G:
        dfsHelper(G, u, visited)

    -- xử lý postorder: sau khi tất cả con xong
    process_postorder(v)
Time: O(V+E) Space: O(V) — call stack sâu tối đa V frame
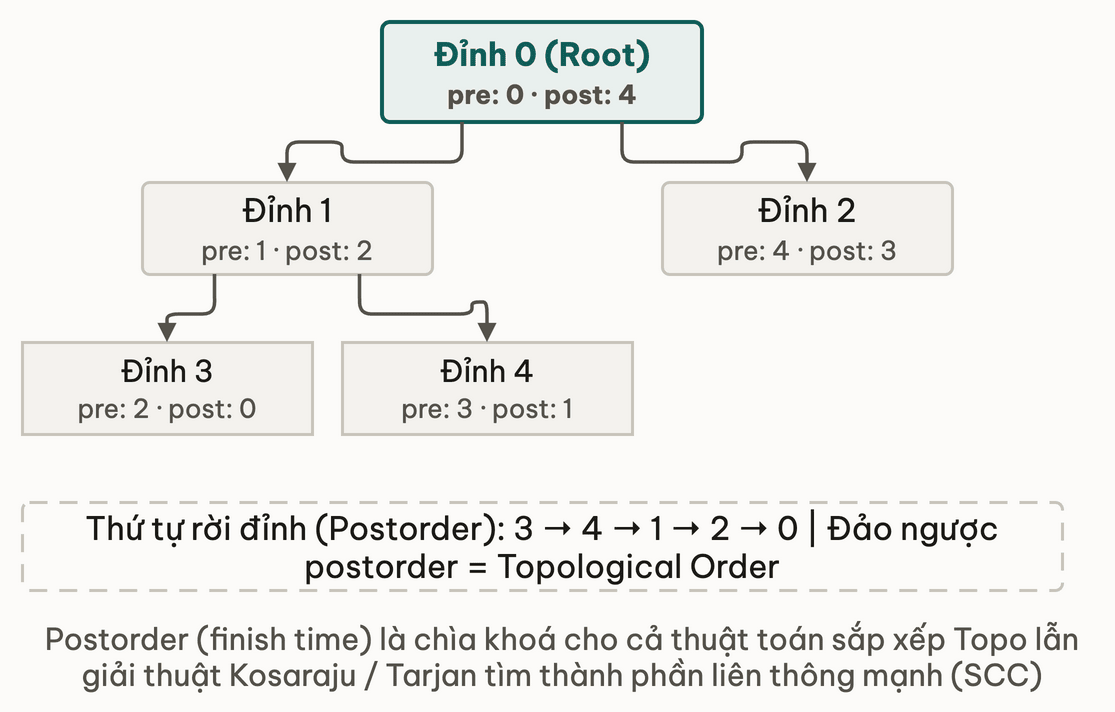
Trace ví dụ — graph: 0-1, 0-2, 1-3, 1-4. DFS từ đỉnh 0:
Cây gọi đệ quy:
dfsHelper(0)
  -> dfsHelper(1)
       -> dfsHelper(3)  preorder:3, postorder:3
       -> dfsHelper(4)  preorder:4, postorder:4
     postorder:1
  -> dfsHelper(2)       preorder:2, postorder:2
  postorder:0

Thứ tự preorder:  0, 1, 3, 4, 2
Thứ tự postorder: 3, 4, 1, 2, 0
3. DFS iterative — explicit stack
Recursive DFS dùng call stack của JVM. Với graph sâu O(V) frame, StackOverflowError là nguy cơ có thật: chain graph 1 triệu đỉnh sẽ crash. Cách xử lý: tự dựng một Stack trên heap.
dfsIterative(G, start):
    visited[v] <- false cho mọi v
    S <- Stack rỗng
    S.push(start)

    while S không rỗng:
        v <- S.pop()
        if visited[v]: continue        -- có thể vào stack nhiều lần
        visited[v] <- true
        process(v)

        -- push hàng xóm theo thứ tự ngược để giữ thứ tự duyệt
        for each u kề v theo thứ tự ngược:
            if not visited[u]:
                S.push(u)
Time: O(V+E) Space: O(V)
Tại sao push ngược? Recursive DFS xử lý hàng xóm theo thứ tự tự nhiên (0, 1, 2...). Stack là LIFO, nên nếu push theo thứ tự tự nhiên thì hàng xóm cuối bị pop ra trước. Push ngược thì hàng xóm đầu tiên được pop trước, và thứ tự duyệt giống bản recursive.
Đánh đổi:
| Recursive | Iterative | |
|---|---|---|
| Code | Ngắn gọn, rõ ràng | Dài hơn |
| Stack overflow | Có nguy cơ khi V lớn | An toàn, vì stack nằm trên heap |
| Postorder | Tự nhiên (code sau vòng lặp) | Phức tạp, cần state machine (lưu trạng thái từng đỉnh) |
| Production với V lớn | Phải tăng stack size hoặc chuyển sang iterative | Nên dùng |
Iterative DFS không có postorder sẵn, vì bạn chưa biết khi nào đã xong hết các đỉnh con. Cách làm là dùng state machine: push đỉnh hai lần, lần đầu đánh dấu "cần xử lý các con", lần sau (khi các con đã xong) mới xử lý postorder. Với recursive DFS, postorder chỉ là đoạn code ngay sau vòng lặp qua hàng xóm.
4. Preorder vs Postorder vs Reverse postorder
Một lần DFS cho ra hai thứ tự khác nhau, preorder và postorder.
dfsHelper(G, v, visited):
    visited[v] <- true
    process_preorder(v)        -- preorder: ngay khi vào đỉnh

    for each đỉnh u kề v:
        if not visited[u]:
            dfsHelper(G, u, visited)

    process_postorder(v)       -- postorder: sau khi TẤT CẢ con xong
Khi nào dùng preorder:
- Duyệt file system (
find,ls -R): in thư mục cha trước khi liệt kê nội dung. - Copy tree: tạo node cha trước khi sao chép các node con.
- Serialize cây: node cha phải có trước node con.
Khi nào dùng postorder:
- Xoá tree: xoá các con trước khi xoá cha (tránh con trỏ treo, tức trỏ tới node đã bị xoá).
- Tính giá trị expression tree: cần giá trị của 2 biểu thức con trước khi áp toán tử ở node cha.
- Giải dependency: artifact phải build sau khi mọi dependency của nó đã build xong; postorder DFS trên DAG cho ra thứ tự đúng.
Reverse postorder (đảo ngược thứ tự postorder) chính là topological sort của DAG. Topological sort bằng DFS dựa trên điều này, chi tiết ở bài Topological sort.
Thử ngẫmcùng một lần DFS cho cả preorder lẫn postorder. Nếu graph có cycle, reverse postorder còn là thứ tự topological hợp lệ không? Vì sao?
5. Cycle detection — white/gray/black coloring
Để phát hiện cycle trên directed graph, ta dùng 3 màu thay vì một boolean visited:
Đỉnh WHITE là đỉnh chưa thăm, GRAY là đỉnh đang nằm trên call stack, BLACK là đỉnh đã xong hoàn toàn (đã đi hết mọi đỉnh con cháu). Cạnh trỏ tới một đỉnh GRAY gọi là back-edge (cạnh quay ngược về tổ tiên).
Cách phát hiện cycle: nếu DFS từ đỉnh v gặp hàng xóm u màu GRAY thì u đang nằm trên call stack. Nghĩa là đã có đường đi từ u đến v (theo đường DFS đang đi), cộng với cạnh vừa xét từ v về u thì khép thành cycle.
hasCycle(G):
    color[v] <- WHITE cho mọi v

    for each v trong G:
        if color[v] = WHITE:
            if dfsCheck(G, v, color): return true
    return false

dfsCheck(G, v, color):
    color[v] <- GRAY               -- đang vào: đỉnh lên stack

    for each đỉnh u kề v:
        if color[u] = GRAY: return true    -- back-edge -> cycle
        if color[u] = WHITE:
            if dfsCheck(G, u, color): return true

    color[v] <- BLACK              -- đang rời: đã xử lý xong
    return false
Time: O(V+E) Space: O(V)
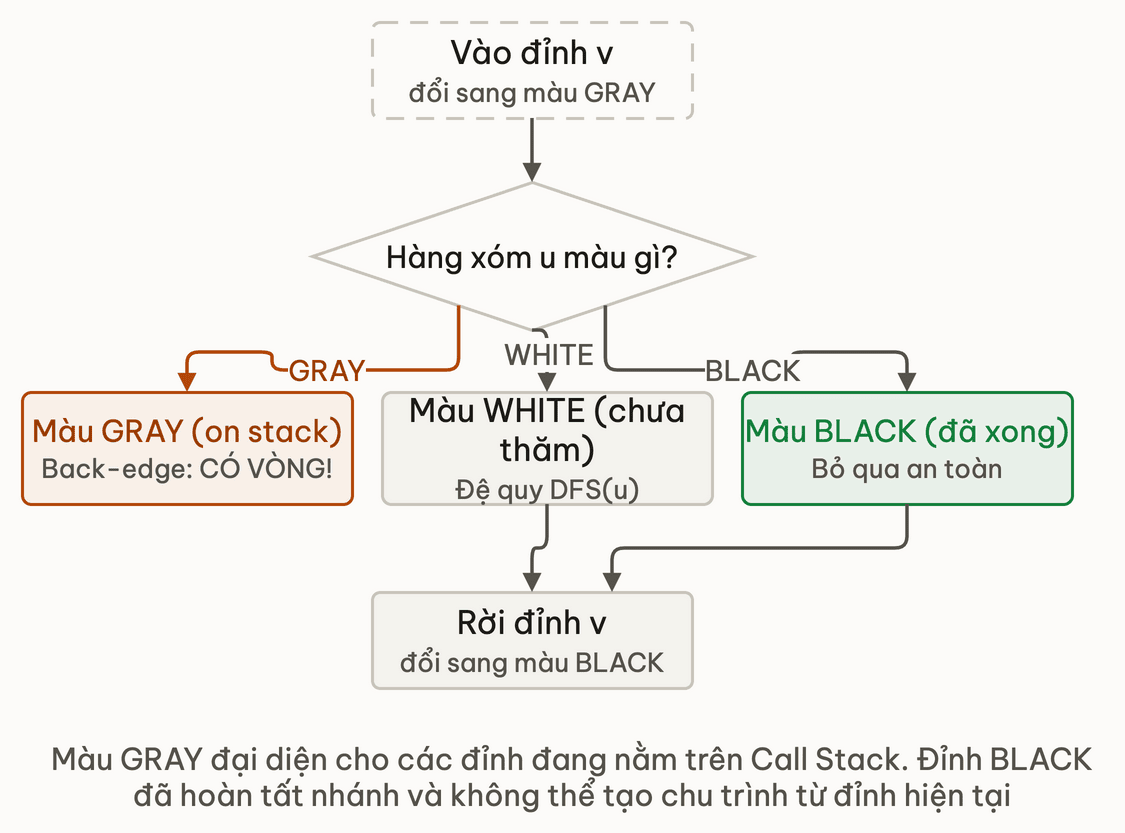
Tại sao cần GRAY thay vì chỉ boolean visited? Với directed graph, boolean visited không phân biệt được "đang trên stack" với "đã xử lý xong". GRAY là đang trên call stack ngay lúc này, BLACK là đã xong và không còn trên stack. Chỉ cạnh tới đỉnh GRAY mới tạo cycle.
Undirected graph: phải loại trừ đỉnh cha, vì trong undirected graph cùng một cạnh xuất hiện ở cả hai chiều trong adjacency list, nên quay về cha không phải cycle:
dfsCheckUndirected(G, v, parent, visited):
    visited[v] <- true
    for each đỉnh u kề v:
        if not visited[u]:
            if dfsCheckUndirected(G, u, v, visited): return true
        else if u != parent:
            return true           -- back-edge về non-parent -> cycle
    return false
Time: O(V+E) Space: O(V)
Thử ngẫmnếu quên loại trừ parent, chuỗi 3 node nối thẳng 0-1-2 bị báo nhầm là có cycle ở bước nào của DFS?
6. Connected components — undirected graph
Để đếm số connected component trong undirected graph: mỗi lần DFS từ một đỉnh chưa thăm sẽ đi hết đúng một component (tất cả đỉnh đến được từ đỉnh đó).
countComponents(G):
    visited[v] <- false cho mọi v
    count <- 0

    for each v trong G:
        if not visited[v]:
            dfsHelper(G, v, visited)   -- visit toàn bộ component chứa v
            count <- count + 1         -- một component mới được tìm thấy

    return count
Time: O(V+E) Space: O(V)
Nếu graph có K component, vòng for gọi DFS đúng K lần; mỗi lần đánh dấu cả component đó rồi tăng counter. Tổng cộng mỗi đỉnh và cạnh vẫn chỉ được xử lý một lần dù DFS chạy nhiều lần.
7. Bẫy tổng hợp
Bẫy 1: Stack overflow trên deep graph
-- BUG: recursive DFS trên chain graph 1 triệu đỉnh
-- 0 -> 1 -> 2 -> ... -> 999999
-- Độ sâu call stack = 1.000.000 frame -> crash StackOverflow

-- ĐÚNG: iterative DFS -- stack trên heap, không bị giới hạn
dfsIterative(G, start)    -- xử lý 1 triệu đỉnh thoải mái
Nếu buộc phải dùng recursive, có thể tạo thread riêng với stack size lớn hơn, nhưng đó chỉ là cách chữa cháy. Iterative DFS mới là cách giải quyết đúng.
Bẫy 2: Cycle detection sai trên undirected graph
-- BUG: không track parent -- false positive trên undirected graph
dfsCheckBug(G, v, visited):
    visited[v] <- true
    for each đỉnh u kề v:
        if visited[u]: return true   -- BUG: u có thể chỉ là parent!
    return false

-- Graph: 0 -- 1 -- 2 (không có cycle)
-- DFS từ 0: thăm 1, từ 1 thăm 0 (đã visited) -> báo có cycle -> SAI
Khi phát hiện cycle trên undirected graph, luôn theo dõi parent. Directed graph dùng white/gray/black, không cần parent vì mọi back-edge đều là cycle thật.
Bẫy 3: Mark visited sai chỗ gây visit nhiều lần
-- BUG: không kiểm tra visited trước khi đệ quy
dfsHelperBug(G, v, visited):
    visited[v] <- true
    for each đỉnh u kề v:
        dfsHelperBug(G, u, visited)   -- không check -- có thể vào u nhiều lần
Trên graph vô hướng (hoặc có cycle), code trên đệ quy vô hạn: từ v sang u, rồi từ u quay lại v, cho tới khi tràn stack. Trên DAG có nhiều đường tới cùng một đỉnh, nó vào u lặp lại theo từng đường, tổng thời gian có thể tăng theo hàm mũ. Hãy kiểm tra visited[u] trước khi gọi đệ quy, hoặc kiểm tra visited[v] ngay đầu hàm.
Thử ngẫmnếu graph là một cây có hướng (mỗi node chỉ có đúng một đường từ gốc tới nó), bug thiếu kiểm tra visited này có làm DFS chạy chậm đi không?
8. DFS variants — mở rộng
Iterative deepening DFS (IDDFS): vừa tốn ít bộ nhớ như DFS, vừa tìm theo từng level như BFS. Chạy DFS với giới hạn độ sâu 1, rồi 2, rồi 3... Tìm được đỉnh đích ở độ sâu d với bộ nhớ O(d) thay vì O(b^d) của BFS. Dùng trong tìm kiếm cây trò chơi của AI (chess engine, giải puzzle).
Tarjan SCC (Strongly Connected Components, tức các nhóm đỉnh đi tới được nhau): tìm tất cả SCC trong directed graph bằng một lần DFS, dùng giá trị low-link để biết khi nào một SCC đã đủ. Độ phức tạp O(V + E).
Articulation point và bridge: đỉnh là articulation point nếu xoá nó làm graph đứt thành nhiều mảnh. Cạnh là bridge nếu xoá nó cũng làm graph đứt. Cả hai tìm được trong O(V + E) bằng DFS với hai mảng disc và low. Ứng dụng: đánh giá độ bền của mạng, tìm single point of failure (điểm mà hỏng là cả hệ thống hỏng).
9. Dùng ở đâu trong thực tế
Phát hiện dependency vòng trong build tool: Maven dựng đồ thị các module trong một reactor và dò chu trình; có vòng thì nó dừng với lỗi bắt đầu bằng "The projects in the reactor contain a cyclic reference". Gradle cũng báo "Circular dependency between the following tasks" khi các task phụ thuộc vòng nhau. Dò vòng kiểu này chính là bài toán tìm back-edge của mục 5, vì không có thứ tự build hợp lệ cho một graph có vòng.
Duyệt cây của JSON / YAML parser: parse xong, cây AST được duyệt bằng DFS. Preorder dùng để serialize (ghi cha rồi ghi con), postorder dùng để tính giá trị (tính 2 node con trước rồi mới kết hợp ở node cha). Ví dụ: expression (a + b) * c là cây với * ở root, + ở nhánh trái, nên postorder sẽ tính a + b trước.
File system find / ls -R: DFS preorder điển hình: thư mục cha xuất hiện trước các file và thư mục con. find . -name "*.java" duyệt cả cây thư mục theo DFS, in path ngay khi vào mỗi node (preorder).
10. Đào sâu
Sách kinh điển:
- Introduction to Algorithms (CLRS), Chapter 22.3 — DFS: chứng minh chặt chẽ việc phân loại cạnh (tree/back/forward/cross edge), định lý đường trắng (white-path theorem) và định lý dấu ngoặc (parenthesis theorem).
- Introduction to Algorithms (CLRS), Chapter 22.4 — Topological sort: chứng minh vì sao topo sort bằng DFS cho kết quả đúng.
- Tarjan, R.E. (1972) — "Depth-first search and linear graph algorithms": bài báo kinh điển dùng DFS với low-link cho bài toán SCC và biconnected component.
Cross-link trong khóa học:
- Topological sort: topo sort bằng DFS chính là reverse postorder của DFS.
- Case study Maven và Google Maps: phát hiện dependency vòng của Maven ở quy mô thật.
Bài liên quan trong khoá học:
- Recursion & Call Stack: đệ quy trong DFS.
- Topological Sort: thứ tự topo qua DFS post-order.
11. Tóm tắt
Checklist khi gặp bài toán cần DFS:
- Graph sâu cỡ O(V)? Dùng iterative với Stack trên heap để tránh StackOverflow.
- Cần xử lý cha trước con (serialize, copy tree)? Dùng preorder. Cần xong con rồi mới xử lý cha (xoá tree, giải dependency)? Dùng postorder.
- Directed graph: tô 3 màu, gặp đỉnh GRAY là có cycle. Undirected graph: boolean visited kèm
parent. - Đếm connected component: mỗi lần DFS bắt đầu từ một đỉnh chưa thăm là thêm một component, tổng vẫn O(V + E).
- Cần thứ tự dependency trên DAG? Lấy reverse postorder, xem bài Topological sort.
12. Tự kiểm tra
- Q1DFS recursive hay iterative: khi nào nên chọn iterative?
- Q2Preorder và postorder: cho một ví dụ ứng dụng khác nhau cho mỗi loại.
- Q3Tô màu white/gray/black để phát hiện cycle: gray nghĩa chính xác là gì?
- Q4Phát hiện cycle trên undirected graph: vì sao cạnh về parent không phải cycle?
- Q5Đếm connected component: vì sao mỗi lần gọi DFS từ một đỉnh chưa visited là thêm 1 component?
- Q6Cho chain graph 1 triệu đỉnh (0→1→2→...→999999): recursive DFS gây ra chuyện gì? Sửa thế nào?
Bài tiếp theo: Topological sort — Kahn vs DFS-based
BFS — Breadth-First Search và unweighted shortest path
Bài tiếpTopological sort — Kahn (BFS-based) vs DFS-based, build order DAG
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này