Module Đồ thị: BFS, DFS, Dijkstra, MST
BFS, DFS, Dijkstra, Bellman-Ford, Floyd-Warshall, MST, DSU — tất cả đồ thị trong một module. Từ representation đến case study Maven DAG và routing trên bản đồ.
TL;DR: Module này dạy các thuật toán đồ thị (graph algorithm), nền tảng của hàng loạt bài toán thực tế: tìm đường ngắn nhất (GPS), phát hiện chu trình (dependency của Maven), sắp xếp thứ tự build (topo sort), nối mạng với chi phí thấp nhất (MST, ví dụ kéo cáp mạng), và gom nhóm quan hệ (Union-Find). Bạn sẽ đi từ cách lưu đồ thị trong bộ nhớ, qua BFS/DFS, đến Dijkstra/Bellman-Ford/Floyd-Warshall, Kruskal/Prim, Disjoint Set Union, rồi kết thúc bằng hai case study thực tế: Maven reactor build và kỹ thuật routing trên bản đồ.
Vì sao module này tồn tại
Graph không chỉ có trong đề thi. Mỗi lần bạn chạy mvn package, Maven tính topological sort trên DAG dependency để quyết định thứ tự compile. Mỗi lần ứng dụng bản đồ tìm đường, bên dưới là các thuật toán đường ngắn nhất trên graph hàng chục triệu đỉnh (kỹ thuật tiêu biểu như Contraction Hierarchy ở bài 11). Mỗi lần bạn dùng Git, DAG commit được duyệt để merge branch.
Vấn đề là thuật toán đồ thị hay bị học theo kiểu "thuộc công thức" mà không hiểu cơ chế. Kết quả là không biết chọn BFS hay DFS, không biết vì sao Dijkstra hỏng khi có trọng số âm, không biết Union-Find làm gì mà nhanh đến vậy. Module này giải thích từng cơ chế từ gốc, kèm bài toán thực tế cho thấy khi nào dùng cái nào.
Sau module này bạn sẽ
- Implement BFS / DFS và áp dụng cho shortest-path không trọng số, cycle detection, topo sort
- Compare Dijkstra, Bellman-Ford, Floyd-Warshall theo trọng số âm, số đỉnh/cạnh và bài toán
- Explain Union-Find với path compression / union by rank và độ phức tạp α(n)
- Design giải pháp đồ thị cho hệ thống thật (routing bản đồ, dependency Maven, MST)
Bản đồ module
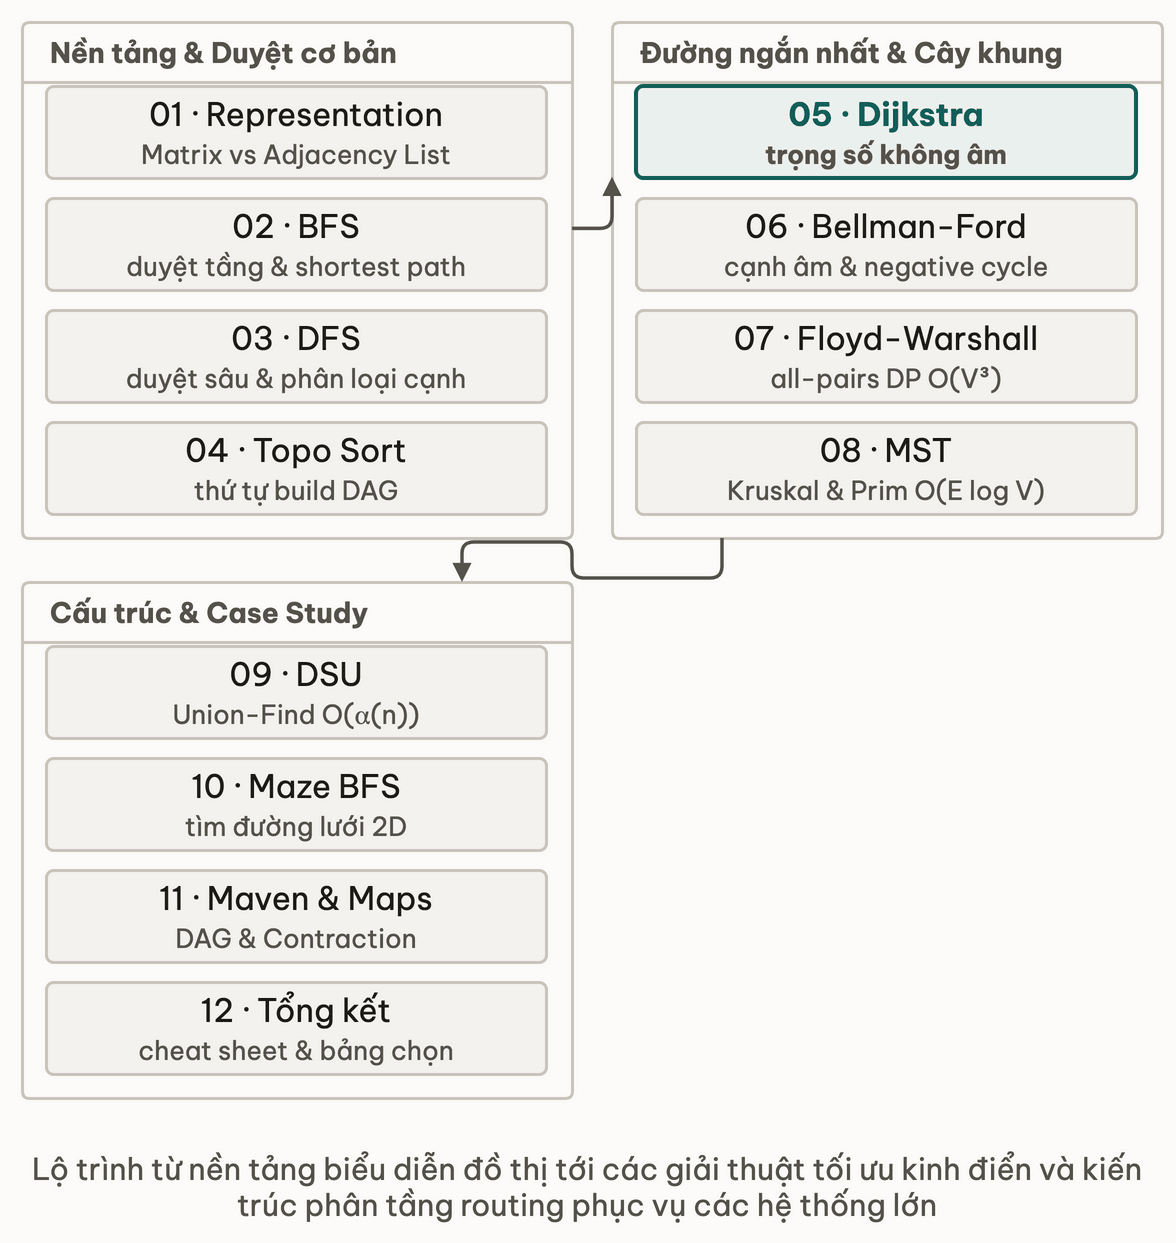
Lộ trình học
Thứ tự bài đi theo nguyên tắc "nền trước, ứng dụng sau":
Bài 01 — Graph representation là điểm xuất phát bắt buộc: adjacency list vs adjacency matrix. Mọi thuật toán sau đều dùng một trong hai cấu trúc này, nên không hiểu cách lưu thì không debug được độ phức tạp.
Bài 02 — BFS là traversal cơ bản nhất: duyệt theo tầng (level-order), tìm shortest path không trọng số, phát hiện connected component. BFS cũng là xương sống của bidirectional search (tìm từ hai đầu) ở bài case study.
Bài 03 — DFS bổ sung hướng khác: duyệt sâu trước, phát hiện cycle (back edge), topo sort qua DFS, và strongly connected component. DFS khó hình dung hơn BFS nhưng hợp hơn với các bài toán có cấu trúc đệ quy.
Bài 04 — Topological sort dùng trực tiếp DFS và BFS (Kahn) trên DAG: xếp thứ tự build Maven, thứ tự chạy task, phát hiện circular import trong compiler.
Bài 05 — Dijkstra mở ra bài toán đường ngắn nhất khi trọng số không âm: relaxation (thử cập nhật đường đi ngắn hơn qua một cạnh), MinHeap priority queue, và vì sao greedy cho kết quả đúng. Nền tảng để hiểu Contraction Hierarchy ở bài 11.
Bài 06 — Bellman-Ford bổ sung cho Dijkstra: chạy được khi có trọng số âm và phát hiện negative cycle (chu trình có tổng trọng số âm, ví dụ arbitrage tiền tệ). Chậm hơn nhưng tổng quát hơn.
Bài 07 — Floyd-Warshall tìm đường ngắn nhất giữa mọi cặp đỉnh (all-pairs) bằng DP với 3 vòng lặp. Cách này đơn giản hơn chạy Dijkstra N lần, hợp khi V nhỏ.
Bài 08 — MST (Kruskal + Prim) tìm cây khung nhỏ nhất (nối mọi đỉnh với tổng trọng số thấp nhất), ví dụ kéo cáp mạng hay đường truyền trong datacenter. Kruskal dùng DSU (bài 09); Prim dùng MinHeap giống Dijkstra.
Bài 09 — Disjoint Set Union (Union-Find) là cấu trúc dữ liệu phụ trợ, xuất hiện trong Kruskal, kiểm tra kết nối mạng và gom nhóm. Nhờ path compression + union by rank, mỗi thao tác tốn gần O(1).
Bài 10 — Mini Challenge: Maze BFS là bài thực hành BFS trên grid, một dạng hay gặp trong phỏng vấn và tìm đường trong game.
Bài 11 — Case Study: Maven + routing bản đồ đi sâu vào hai hệ thống thật: topo sort trong Maven reactor, và CH + bidirectional Dijkstra giúp routing trên bản đồ nhanh hơn Dijkstra thường rất nhiều.
Bài 12 — Tổng kết gom cheat sheet, bảng chọn thuật toán, glossary và phần tự đánh giá.
Yêu cầu trước khi bắt đầu
- Đã hoàn thành module Tìm kiếm nhanh và module Sắp xếp trong khoá này — đặc biệt là Binary Heap (dùng trong Dijkstra) và độ phức tạp O(n log n).
- Nắm vững đệ quy — DFS dùng đệ quy hoặc stack tự dựng. Chưa quen hàm gọi hàm thì ôn Hàm trong khoá Nhập môn lập trình trước.
- Không cần biết graph trước — bài 01 dạy từ đầu.
Time budget
| Bài | Chủ đề | Thời lượng |
|---|---|---|
| 00 | Tổng quan (bài này) | ~10 phút |
| 01 | Graph representation | ~17 phút |
| 02 | BFS | ~18 phút |
| 03 | DFS | ~17 phút |
| 04 | Topological sort | ~16 phút |
| 05 | Dijkstra | ~20 phút |
| 06 | Bellman-Ford | ~13 phút |
| 07 | Floyd-Warshall | ~16 phút |
| 08 | MST — Kruskal + Prim | ~19 phút |
| 09 | Disjoint Set Union | ~18 phút |
| 10 | Mini Challenge — Maze BFS | ~30 phút |
| 11 | Case Study — Maven + routing bản đồ | ~21 phút |
| 12 | Tổng kết & cheat sheet | ~15 phút |
| Tổng | ~3.8 giờ |
Cách học module này hiệu quả
- Vẽ tay trước khi code. Với mỗi thuật toán, cầm bút vẽ đồ thị nhỏ 5-6 đỉnh và chạy tay từng bước trước khi đọc pseudocode. Thuật toán đồ thị nhìn hình thì dễ hiểu, chỉ đọc chữ thì khó. Nếu chưa quen, ôn Làm tay trước khi làm máy và Bảng trace: các bảng dist/queue trong module đều là bảng trace.
- Bám bảng dist/parent. Dijkstra và Bellman-Ford đều xoay quanh bảng
dist[]vàparent[]. Mỗi lần relaxation, cập nhật bảng bằng tay, bạn sẽ thấy vì sao greedy chạy đúng. - Biết khi nào dùng, không chỉ cách code. Có 4 thuật toán shortest path (BFS không trọng số, Dijkstra, Bellman-Ford, Floyd-Warshall) — biết khi nào dùng cái nào quan trọng hơn biết code cái nào. Bảng chọn ở bài 12.
- Liên hệ bài toán thật. Mỗi lần học một thuật toán, tự hỏi "cái này giải bài toán nào trong công việc?". Câu trả lời nằm ở bài 11 case study, nhưng tự đoán trước thì nhớ lâu hơn.
Bài tiếp theo: Graph representation — Adjacency list vs matrix
Sắp xếp & thứ tự: tổng kết và cheat sheet
Bài tiếpGraph representation — Adjacency list vs matrix, trade-off bộ nhớ
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này