Dijkstra — Shortest path trên weighted graph với min-heap
Dijkstra tìm shortest path weighted graph: relaxation, min-heap lazy deletion O((V+E) log V), fail với edge âm — pattern Google Maps và OSPF routing áp dụng.
TL;DR: Dijkstra tìm đường ngắn nhất trên weighted graph (mọi cạnh có weight không âm) bằng cách luôn mở rộng đỉnh có tổng cost nhỏ nhất mà chưa finalized (chưa chốt kết quả). Đó là một lựa chọn tham lam (greedy) nhưng vẫn đúng, nhờ không có cạnh âm. Cấu trúc dữ liệu cốt lõi là min-heap (priority queue): mỗi lần cải thiện dist của đỉnh v, ta push một entry mới vào heap và bỏ qua entry cũ khi pop (lazy deletion, tức xoá lười). Độ phức tạp O((V+E) log V). Bẫy lớn nhất: Dijkstra SAI khi có bất kỳ cạnh âm nào, kể cả khi không có negative cycle, vì điều kiện để greedy đúng bị phá vỡ; lúc đó hãy dùng Bellman-Ford.
Bạn đã biết BFS tìm đường ngắn nhất trên unweighted graph: mỗi cạnh có weight bằng 1, BFS đảm bảo path ít cạnh nhất. Nhưng Google Maps không đếm số ngã tư mà tính thời gian di chuyển. Đường cao tốc từ Hà Nội đến Bắc Ninh có thể nhanh hơn đường làng dù nhiều "ngã rẽ" hơn. Mỗi cạnh trong mạng đường có weight riêng: thời gian đi, quãng đường hoặc chi phí.
BFS trên weighted graph cho kết quả sai hoàn toàn, vì nó tối ưu theo số cạnh chứ không theo tổng weight. Cần một thuật toán khác.
Bài này dạy Dijkstra: nguyên lý relaxation, cách cài đặt bằng min-heap O((V+E) log V), vì sao nó sai với cạnh âm, và nơi nó được dùng.
1. Hình dung: Lan tỏa wave với tốc độ khác nhau
BFS giống sóng nước trên mặt hồ phẳng: sóng lan đều mọi hướng, mỗi "bước" là một cạnh có cost bằng nhau.
Dijkstra giống sóng lan trên địa hình gồ ghề: đường rộng (weight nhỏ) sóng lan nhanh, đường núi (weight lớn) sóng lan chậm. Đỉnh nào bị sóng chạm trước thì tổng cost từ source đến đó là nhỏ nhất.
Cốt lõi greedy: ở mỗi bước, Dijkstra luôn mở rộng đỉnh gần source nhất (theo tổng cost) mà chưa finalized. Đó là lựa chọn tốt nhất tại chỗ, và với graph không có cạnh âm, nó cho kết quả tốt nhất trên toàn graph.
| Sóng trên địa hình | Dijkstra |
|---|---|
| Điểm xuất phát | start đỉnh |
| Địa hình bằng phẳng — đường dễ | Cạnh weight nhỏ |
| Địa hình núi — đường khó | Cạnh weight lớn |
| Sóng chạm điểm X sau cost C | dist[X] = C, khoảng cách ngắn nhất từ start đến X |
| Điểm bị chạm trước = tổng cost nhỏ nhất | Đỉnh được finalize = đã chốt đường ngắn nhất |
| Sóng KHÔNG thể đi ngược (weight âm) | Dijkstra sai khi có cạnh âm |
Dijkstra là BFS mở rộng cho weighted graph: thay Queue bằng MinHeap (xếp theo dist). Mỗi lần pop là chốt xong đỉnh gần nhất.
2. Thuật toán — Relaxation principle
2.1 Distance estimate và relaxation
dist[v] là ước tính tốt nhất hiện tại về khoảng cách ngắn nhất từ start đến v. Ban đầu:
dist[start] = 0dist[v] = INFcho mọivkhác
Relaxation (thử cải thiện ước tính): với mỗi cạnh u → v có weight w, kiểm tra:
if dist[u] + w < dist[v]:
    dist[v] <- dist[u] + w    -- cập nhật đường ngắn hơn
    push (v, dist[v]) vào MinHeap
Tên "relaxation" xuất phát từ ý "nới lỏng": ta hạ ước tính dist của v xuống một giá trị tốt hơn.
2.2 Greedy invariant
Khi pop đỉnh u có dist[u] nhỏ nhất từ MinHeap, dist[u] chính là khoảng cách ngắn nhất cuối cùng từ start đến u.
Trực giác của chứng minh: giả sử có path ngắn hơn đến u. Gọi w là đỉnh chưa finalized đầu tiên trên path đó (đỉnh ngay trước nó đã finalized nên dist[w] đã đúng). Ta đang pop giá trị nhỏ nhất nên dist[w] >= dist[u], và phần còn lại của path chỉ cộng thêm cost không âm, nên path đó có tổng cost ít nhất là dist[u], mâu thuẫn với "ngắn hơn". Lập luận này chỉ đúng khi mọi cạnh có weight không âm.
2.3 Lazy deletion pattern
Nhiều ngôn ngữ (Java, Python) không có sẵn min-heap hỗ trợ decrease-key (hạ giá trị một phần tử đang nằm trong heap). Thay vào đó ta dùng lazy deletion:
- Khi
distcủavđược cải thiện, push entry mới(v, newDist)vào heap; entry cũ vẫn nằm đó. - Khi pop entry
(u, d): nếud > dist[u]thì entry này đã lỗi thời (dist đã được cập nhật xuống giá trị tốt hơn), bỏ qua.
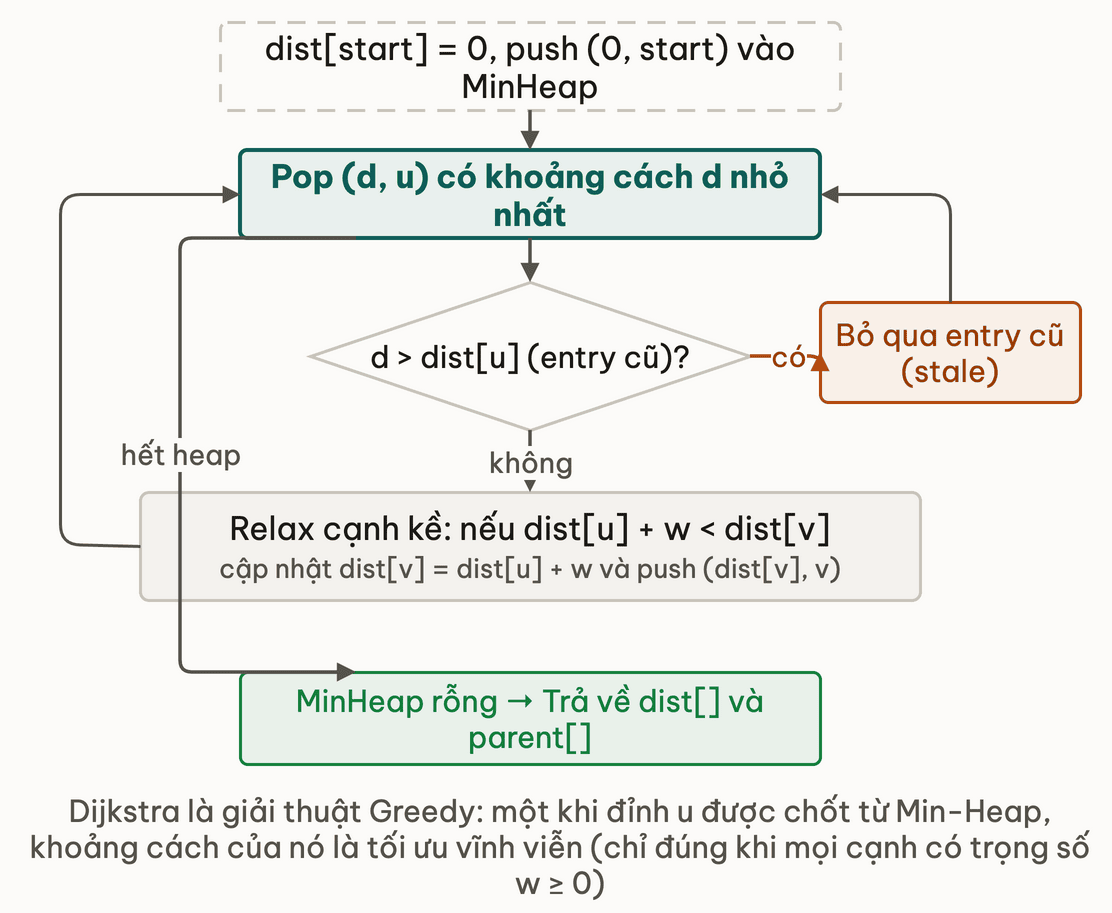
if d > dist[u]: continue -- entry cũ (lazy deletion), bỏ qua
Lazy deletion đơn giản hơn nhiều so với heap có chỉ mục (indexed heap), nhưng heap có thể chứa O(E) entry thay vì O(V). Với sparse graph (E ≈ V log V) thì không đáng kể.
3. Pseudocode đầy đủ
Dijkstra(G, start):
    dist[v] <- INF cho mọi v
    dist[start] <- 0
    parent[v] <- NIL cho mọi v

    H <- MinHeap rỗng        -- keyed by dist
    H.push((start, 0))

    while H không rỗng:
        (u, d) <- H.pop()    -- lấy đỉnh có dist nhỏ nhất

        if d > dist[u]: continue   -- entry cũ (lazy deletion), bỏ qua

        for each cạnh (u -> v, trọng số w) trong G:
            newDist <- dist[u] + w
            if newDist < dist[v]:
                dist[v] <- newDist
                parent[v] <- u
                H.push((v, newDist))

    return dist, parent
    -- dist[v] = INF nếu v không thể tới từ start
Time: O((V+E) log V) Space: O(V+E)
3.1 Trace ví dụ — graph 5 đỉnh
Graph directed weighted:
    (2)      (3)
0 ----> 1 ----> 3
|       |       ^
|(4)   (1)     |(1)
v       v      |
2 ----> 4 -----+
    (2)    (1)
Cạnh: 0→1 w2, 0→2 w4, 1→3 w3, 1→4 w1, 2→4 w2, 4→3 w1. Bảng dưới là một bảng trace (mỗi dòng là một lần pop, mỗi cột là một biến); nếu chưa quen, ôn Bảng trace.
| Bước | Pop (đỉnh, dist) | dist[] | Heap sau pop |
|---|---|---|---|
| Init | — | [0, INF, INF, INF, INF] | [(0,0)] |
| 1 | (0, 0) | [0, 2, 4, INF, INF] | [(1,2),(2,4)] |
| 2 | (1, 2) | [0, 2, 4, 5, 3] | [(4,3),(2,4),(3,5)] |
| 3 | (4, 3) | [0, 2, 4, 4, 3] | [(3,4),(2,4),(3,5)] |
| 4 | (3, 4) — finalized | [0, 2, 4, 4, 3] | [(2,4),(3,5)] |
| 5 | (2, 4) | [0, 2, 4, 4, 3] | [(3,5)] — 4 không cải thiện |
| 6 | (3, 5) — outdated, dist[3]=4 | skip | [] |
Kết quả: dist = [0, 2, 4, 4, 3]. Shortest path từ 0 đến 3: cost 4 qua 0→1→4→3.
Thử ngẫmbước 6 pop (3,5) nhưng bị skip vì dist[3] đã cải thiện xuống 4 từ bước 4 — entry cũ trong heap là stale. Bỏ bước check này, dist[3] cuối cùng sẽ sai theo hướng nào?
4. Path reconstruction
Theo dõi thêm mảng parent[] trong quá trình relaxation để reconstruct path thực tế.
reconstruct_path(parent, start, target):
    if dist[target] = INF: return []   -- không thể tới

    path <- []
    cur <- target
    while cur != NIL:
        path.prepend(cur)
        cur <- parent[cur]
    return path   -- thứ tự từ start đến target
Time: O(V) Space: O(V)
Vì sao prepend (hoặc reverse)? Ta đi ngược từ target về start qua chuỗi parent[]. Nếu dùng append và reverse, kết quả giống nhau. Nếu dùng prepend (insert đầu), list đã đúng thứ tự.
5. Complexity
| Implementation | Time | Space | Ghi chú |
|---|---|---|---|
| Binary heap MinHeap | O((V+E) log V) | O(V+E) | Lựa chọn chuẩn trong thực tế |
| Dùng mảng (không heap) | O(V²) | O(V) | Tốt hơn khi dense graph (E ≈ V²) |
| Fibonacci heap | O(E + V log V) | O(V) | Tiệm cận tốt hơn nhưng hằng số lớn, ít dùng |
O((V+E) log V) của binary heap từ đâu ra?
- Mỗi đỉnh chỉ được mở rộng (relax các cạnh đi ra) một lần, các entry lỗi thời bị bỏ qua ngay sau khi pop.
- Mỗi cạnh gây tối đa một lần push, nên heap nhận tối đa E + 1 entry. Số lần push và pop đều O(V + E), mỗi lần tốn log(kích thước heap) = O(log V), vì log E ≤ 2 log V.
- Tổng: O((V + E) log V).
Dùng mảng O(V²): không dùng heap, mỗi lần tìm đỉnh chưa thăm có dist nhỏ nhất bằng cách quét tuần tự O(V), lặp V lần nên O(V²). Với dense graph E = O(V²), cách dùng mảng thắng vì không tốn chi phí phụ của heap.
6. Vì sao FAIL với negative edge
6.1 Greedy assumption bị phá vỡ
Dijkstra dựa trên một bất biến (invariant, điều luôn đúng trong lúc chạy): khi pop đỉnh u (vì dist[u] nhỏ nhất trong heap), dist[u] đã là kết quả cuối, không cạnh nào về sau cải thiện được nữa. Bất biến này chỉ đúng khi mọi cạnh không âm, vì thêm một cạnh chỉ làm cost tăng hoặc giữ nguyên. Cạnh âm phá vỡ giả định đó: một path "dài hơn" tới u (nhiều cạnh hơn) vẫn có thể rẻ hơn nhờ cạnh âm.
Phản ví dụ (một ví dụ là đủ để thấy sai):
        (1)
   A ---------> B
   |            ^
  (3)         (-5)
   |            |
   +----> C ----+
Cạnh: A→B weight 1, A→C weight 3, C→B weight -5. Đường ngắn nhất thật tới B là A→C→B = 3 + (-5) = -2, không phải đường trực tiếp A→B = 1.
Dijkstra (finalize khi pop): dist = [0, INF, INF]. Pop A (0) → relax B=1, C=3. Heap: [(B,1),(C,3)]. Pop B (dist 1, nhỏ hơn C) → finalize B=1. Pop C (3) → relax B: 3 + (-5) = -2 < 1 — nhưng B đã finalized → bỏ qua. Kết quả báo dist[B] = 1, trong khi đáp án đúng là -2. Sai.
Gốc rễ: Dijkstra chốt B trước khi khám phá đường vòng qua C, vì greedy tin rằng "đã nhỏ nhất thì không thể nhỏ hơn". Với cạnh âm, niềm tin đó sai.
Bản Dijkstra dùng lazy deletion trong bài này (if d > dist[u]: continue, không có mảng visited) sẽ relax lại B khi pop C, nên trên ví dụ nhỏ này nó tình cờ ra -2 đúng. Nhưng đó không phải điều được đảm bảo: với cạnh âm, Dijkstra mất bất biến nền tảng, có graph nó vẫn cho kết quả sai, và việc relax lặp lại có thể làm số bước tăng theo hàm mũ. Quy tắc an toàn duy nhất: có cạnh âm thì dùng Bellman-Ford, đừng trông chờ vào may rủi của cách cài đặt.
6.2 Negative cycle — không có shortest path
Nếu graph có negative cycle (cycle có tổng weight âm) thì không tồn tại đường ngắn nhất, vì ta có thể đi vòng quanh cycle mãi để giảm tổng cost mãi.
Dijkstra không phát hiện được negative cycle (nó sẽ lặp mãi hoặc cho kết quả sai). Hãy dùng Bellman-Ford (bài 06): nó xử lý được cạnh âm và phát hiện được negative cycle.
7. Bẫy tổng hợp
Bẫy 1: Nhầm "negative weight" với "negative cycle"
-- BUG assumption: "chỉ có negative cycle mới sai, negative edge thường thì OK"
-- Dijkstra sai ngay cả khi chỉ có 1 negative edge, không có cycle
-- Test case: A->B w1, A->C w3, C->B w(-3)
-- Dijkstra bản chốt-khi-pop cho dist[B]=1, correct là A->C->B = 3+(-3)=0
-- Nhưng 0 < 1 mà Dijkstra finalize B=1 trước khi expand C
-- => Phải dùng Bellman-Ford
Bẫy 2: Quên lazy skip pattern
-- BUG: push duplicate vào heap nhưng không skip entry cũ
while H không rỗng:
    (u, d) <- H.pop()
    -- THIẾU: if d > dist[u]: continue
    for each cạnh (u -> v, w):
        newDist <- dist[u] + w
        if newDist < dist[v]:
            dist[v] <- newDist
            H.push((v, newDist))
Luôn đặt dòng if d > dist[u]: continue ngay sau H.pop(). Thiếu dòng này kết quả vẫn đúng (khi relax dùng dist[u] lấy từ mảng), nhưng chạy chậm vì relax thừa, và dễ thành bug thật nếu lỡ dùng d thay cho dist[u] khi relax.
Bẫy 3: Overflow khi cộng INF với weight
-- BUG: dist[u] = INF (giả sử là MAX_INT), w = 5
-- MAX_INT + 5 tràn số (overflow) -> số âm -> sai hoàn toàn
newDist <- dist[u] + w   -- overflow -> negative -> wrong comparison
if newDist < dist[v]: ...   -- luôn true -> làm hỏng dist array
-- CORRECT: guard trước khi cộng
if dist[u] = INF: continue   -- không thể đi tới u, bỏ qua
newDist <- dist[u] + w
Hoặc dùng kiểu số 64-bit (long) cho dist[] và weight để tránh hẳn overflow. Đây cũng là một ca biên điển hình (INF cộng thêm một số); cách soi ca biên trước khi chạy ở Edge case.
Thử ngẫmdòng chặn if dist[u] = INF: continue tránh cộng tràn số trước khi so sánh. So với việc đổi sang kiểu long, cách nào ít dòng phải sửa hơn trong một codebase lớn?
8. Variants và optimizations
A* (A-star): Dijkstra cộng thêm hàm heuristic h(v) ước lượng khoảng cách từ v đến đích. Khoá của heap là dist[v] + h(v). Nếu h là admissible (không bao giờ ước lượng quá cao so với thực tế), ví dụ khoảng cách đường thẳng trên grid, thì A* vẫn tìm ra đường tối ưu và nhanh hơn Dijkstra vì ưu tiên mở rộng về phía đích. Dùng trong tìm đường cho NPC trong game và các bài toán routing có đích rõ ràng.
Bidirectional Dijkstra: chạy Dijkstra từ start đi tới và từ goal đi lui, dừng khi hai frontier (rìa vùng đã duyệt) gặp nhau. Chi phí giảm từ O(b^d) xuống O(b^(d/2)), trong đó b là số nhánh con trung bình mỗi đỉnh. Với lý thuyết cây nhánh đều thì giảm rất mạnh; trên mạng đường thật mức giảm khiêm tốn hơn (cỡ một nửa số đỉnh phải duyệt), nên nó thường đi kèm kỹ thuật tiền xử lý bên dưới.
Contraction Hierarchy: tiền xử lý graph bằng cách "co" các đỉnh ít quan trọng lại và tạo cạnh tắt (shortcut). Trong các bài báo của nhóm Geisberger và Sanders, truy vấn trên mạng đường Tây Âu cỡ trăm micro-giây tới vài mili-giây, nhanh hơn Dijkstra chuẩn hàng chục nghìn lần, đổi lại phải tiền xử lý tốn vài phút đến dưới một giờ. Đây là kỹ thuật nền của nhiều engine routing mã nguồn mở (OSRM, GraphHopper có chế độ CH).
Thử ngẫmbidirectional Dijkstra giảm chi phí từ O(b^d) xuống O(b^(d/2)) bằng cách chạy hai hướng rồi gặp nhau giữa đường. Nếu hai điểm chỉ cách nhau 2 cạnh, kỹ thuật này có lợi gì hay chỉ thêm chi phí phụ?
9. Quy mô lớn — graph 1 triệu đỉnh
Với V = 1 triệu, E = 5 triệu, (V + E) × log V ≈ 6M × 20 = 120 triệu thao tác heap (cận trên thô). Đo thực tế tuỳ máy và cách cài, nhưng một truy vấn Dijkstra một chiều trên đồ thị cỡ này vẫn quá nặng nếu phải trả lời hàng nghìn request mỗi giây. Cách làm trong thực tế là tiền xử lý một lần (Contraction Hierarchy) rồi chạy bidirectional Dijkstra trên graph đã tiền xử lý. Bài case study đi sâu vào hướng này.
10. Ứng dụng thực tế
Routing trên bản đồ: mô hình cơ bản là Dijkstra với weight của cạnh là thời gian đi (quãng đường chia tốc độ). Google không công bố chi tiết thuật toán của Google Maps; các engine mã nguồn mở như OSRM và GraphHopper cho thấy hướng chung: tiền xử lý (Contraction Hierarchy) cộng bidirectional Dijkstra. Weight thay đổi theo giờ cao điểm thì dùng time-dependent Dijkstra, trong đó weight là một hàm của thời gian.
OSPF (Open Shortest Path First) — Internet routing: mỗi router chạy Dijkstra trên link-state database (graph toàn bộ mạng) để tính cây đường ngắn nhất từ nó đến mọi router khác. Weight của cạnh là chi phí (cost) của đường truyền, thường suy ra từ băng thông. Khi mạng đổi (router down, chi phí đường truyền đổi), router cập nhật database và chạy lại Dijkstra. Vì vậy OSPF mới có tên "Shortest Path First": Dijkstra là thuật toán cốt lõi.
Lộ trình giao thông công cộng: thường mô hình hoá bằng time-expanded graph, trong đó đỉnh là cặp (ga, thời điểm), rồi chạy Dijkstra. Hệ thống thật hay dùng thuật toán chuyên biệt hơn như RAPTOR.
11. Đào sâu
Bài báo và sách kinh điển:
- Dijkstra, E.W. (1959) — "A note on two problems in connexion with graphs": bài báo gốc, chỉ vài trang, giải hai bài toán: cây khung nhỏ nhất và đường ngắn nhất. Ngắn và đọc được.
- Introduction to Algorithms (CLRS), Chapter 24.3 — Dijkstra's Algorithm: chứng minh chặt chẽ vì sao greedy cho kết quả đúng, cùng độ phức tạp với binary heap và Fibonacci heap.
- Goldberg & Harrelson (2005) — "Computing the Shortest Path: A* Search Meets Graph Theory": A* kết hợp landmark và bất đẳng thức tam giác, một kỹ thuật routing dùng trong thực tế.
Production engineering:
- "Engineering Route Planning Algorithms" (Delling et al., 2009) — tổng quan về Contraction Hierarchy, bidirectional Dijkstra và các kỹ thuật mà hệ thống cỡ Google Maps dùng.
- OSRM hoặc GraphHopper — engine routing mã nguồn mở, có chế độ Contraction Hierarchies để đọc code.
Cross-link trong khóa học:
- Hàng đợi ưu tiên (priority queue), khoá Thuật toán Căn bản: cơ chế binary heap mà Dijkstra dựa vào.
- Heap và heapsort: cấu trúc bên trong của heap, vì sao mỗi thao tác tốn log V.
Bài liên quan trong khoá học:
- BFS: trường hợp đặc biệt khi mọi cạnh có trọng số bằng 1.
- Priority Queue: trích xuất đỉnh có khoảng cách nhỏ nhất.
- Bellman-Ford: xử lý khi đồ thị có trọng số âm.
12. Tóm tắt
- Dijkstra tìm đường ngắn nhất trên weighted graph có trọng số không âm bằng cách tham lam mở rộng đỉnh có khoảng cách nhỏ nhất.
- Relaxation & Lazy deletion: cập nhật
dist[v] = dist[u] + wvà push vào MinHeap; bỏ qua entry cũ bằngif d > dist[u]: continue. - Độ phức tạp: O((V + E) log V) khi dùng binary heap.
- Cạnh âm: Dijkstra cho kết quả sai nếu có trọng số âm; bắt buộc chuyển sang Bellman-Ford hoặc SPFA.
- Biến thể thực tế: A* (thêm heuristic) và Contraction Hierarchies phục vụ routing bản đồ thời gian thực.
13. Tự kiểm tra
- Q1Vì sao Dijkstra sai với cạnh âm? Cho một phản ví dụ cụ thể.
- Q2Bỏ dòng if d > dist[u]: continue trong MinHeap lazy deletion thì chuyện gì xảy ra?
- Q3Độ phức tạp O((V+E) log V): log V đến từ đâu?
- Q4A* so với Dijkstra: heuristic nào đảm bảo kết quả đúng? Khi nào A* không cho đường tối ưu?
- Q5Dựng lại path qua parent[]: vì sao cần reverse (hoặc prepend)? Quên thì chuyện gì xảy ra?
- Q6Graph 1 triệu đỉnh cho routing thời gian thực: Dijkstra thường khác bidirectional Dijkstra + A* thế nào trong thực tế?
Bài tiếp theo: Bellman-Ford — handle negative weight
Topological sort — Kahn (BFS-based) vs DFS-based, build order DAG
Bài tiếpBellman-Ford — Negative weight, detect negative cycle
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này