Disjoint Set Union — Near-O(1) với path compression + union by rank
DSU dùng mảng parent[] đạt amortized O(α(n)) nhờ path compression + union by rank. Từ naive O(n²) lên gần hằng số, ứng dụng Kruskal MST, image segmentation, connectivity.
TL;DR: Disjoint Set Union (DSU) quản lý các tập hợp rời nhau với hai thao tác: find(x) trả về phần tử đại diện (root) của tập chứa x, union(x, y) gộp hai tập. Cấu trúc này chỉ dùng một mảng parent[], nhưng nhờ hai kỹ thuật bổ trợ nhau là path compression (sau mỗi find, trỏ thẳng parent tới root) và union by rank (gắn cây thấp vào cây cao), mỗi thao tác tốn amortized O(α(n)) (trung bình trên nhiều lần gọi), với α là hàm ngược Ackermann, không vượt quá 4 với mọi n thực tế. Chỉ dùng riêng một trong hai thì không đạt được giới hạn này, phải kết hợp cả hai.
Bài MST đã dùng DSU như một hộp đen trong Kruskal: find(x) trả root của component chứa x, union(x, y) gộp hai component, kèm ghi chú độ phức tạp "O(α(V)) amortized". Vậy α là gì, và vì sao một mảng số nguyên đơn giản lại nhanh gần như hằng số?
Dùng riêng từng kỹ thuật cho O(log n); kết hợp cả hai mới đạt O(α(n)) amortized.
Bài này dạy DSU từ bản ngây thơ O(n²) lên bản tối ưu α(n), kèm pseudocode đầy đủ và ứng dụng trong Kruskal MST và bài toán nhóm bạn bè (friend circle).
1. Hình dung: Cây gia phả tìm tổ tiên chung
Tưởng tượng một nhóm người, mỗi người có đúng một "parent" (cha hoặc mẹ). Người ở gốc cây gia phả thì parent là chính mình. Để biết hai người có cùng dòng họ không, ta đi ngược lên chuỗi parent của từng người đến gốc: cùng gốc là cùng dòng họ.
Find giống như hỏi "tổ tiên xa nhất của người này là ai?": đi lên từng bước cho đến khi gặp người có parent là chính mình.
Union giống như "nhập hai dòng họ làm một": đặt gốc của dòng họ này làm con của gốc dòng họ kia.
Path compression giống như "sau khi tìm ra tổ tiên xa nhất, mọi người trên đường đi đó đổi parent của mình thành thẳng tổ tiên ấy", nên lần sau hỏi lại là trả lời ngay.
| Cây gia phả | DSU |
|---|---|
| Người | Node (phần tử của set) |
| Parent | parent[x] |
| Gốc dòng họ (parent là chính mình) | Root — representative của set |
| Tìm tổ tiên xa nhất | find(x) |
| Kết hợp hai dòng họ | union(x, y) |
| Hai người cùng dòng họ? | connected(x, y): kiểm tra cùng root |
| Nhớ đường tắt tới tổ tiên | Path compression |
| Ghép dòng họ nhỏ vào dòng họ lớn | Union by rank/size |
DSU chỉ là 1 mảng parent[]. Mọi thứ khác chỉ là cách đọc và ghi mảng đó khéo hơn.
2. API của DSU
Ba thao tác cốt lõi:
find(x): trả root (phần tử đại diện) của tập chứa x. Hai phần tử cùng tập khi và chỉ khifind(x) = find(y).union(x, y): gộp tập chứa x với tập chứa y. Trảtruenếu thực sự gộp (hai phần tử chưa cùng tập),falsenếu đã cùng tập rồi.connected(x, y): trảtruenếu x và y cùng tập, tứcfind(x) = find(y).
-- Ví dụ sử dụng -- DSU trên 5 phần tử: {0, 1, 2, 3, 4}
DSU dsu <- khởi tạo với 5 phần tử
dsu.union(0, 1)       -- gộp set chứa 0 và set chứa 1
dsu.union(2, 3)       -- gộp set chứa 2 và set chứa 3
dsu.connected(0, 1)   -- true -- cùng set
dsu.connected(0, 2)   -- false -- khác set
dsu.union(1, 2)       -- gộp hai nhóm lại
dsu.connected(0, 3)   -- true -- giờ tất cả cùng một set
3. Naive implementation — và tại sao O(n²)
Ý tưởng cơ bản: parent[i] = i nghĩa là i là root của tập chứa nó. find(x) đi lên chuỗi parent cho đến khi parent[x] = x. union(x, y) đặt root của x làm parent của root của y.
DSU_naive_find(parent, x):
    while parent[x] != x:
        x <- parent[x]    -- đi lên parent chain
    return x

DSU_naive_union(parent, x, y):
    rx <- DSU_naive_find(parent, x)
    ry <- DSU_naive_find(parent, y)
    if rx = ry: return false    -- đã cùng set
    parent[rx] <- ry            -- attach root của x vào root của y
    return true
Time: O(n) worst case mỗi find Space: O(n)
Trường hợp xấu nhất, chuỗi dài: nếu cứ union theo một chiều cố định, cây DSU suy biến thành linked list dài n. Ví dụ: union(0,1), union(1,2), union(2,3), ..., union(n-2, n-1) tạo ra chuỗi 0 → 1 → 2 → ... → n-1. Lúc đó find(0) phải đi qua n bước.
Tổng n lần union, mỗi lần gọi find tốn O(n) trong trường hợp xấu nhất, nên toàn bộ là O(n²).
4. Optimization 1 — Union by Rank
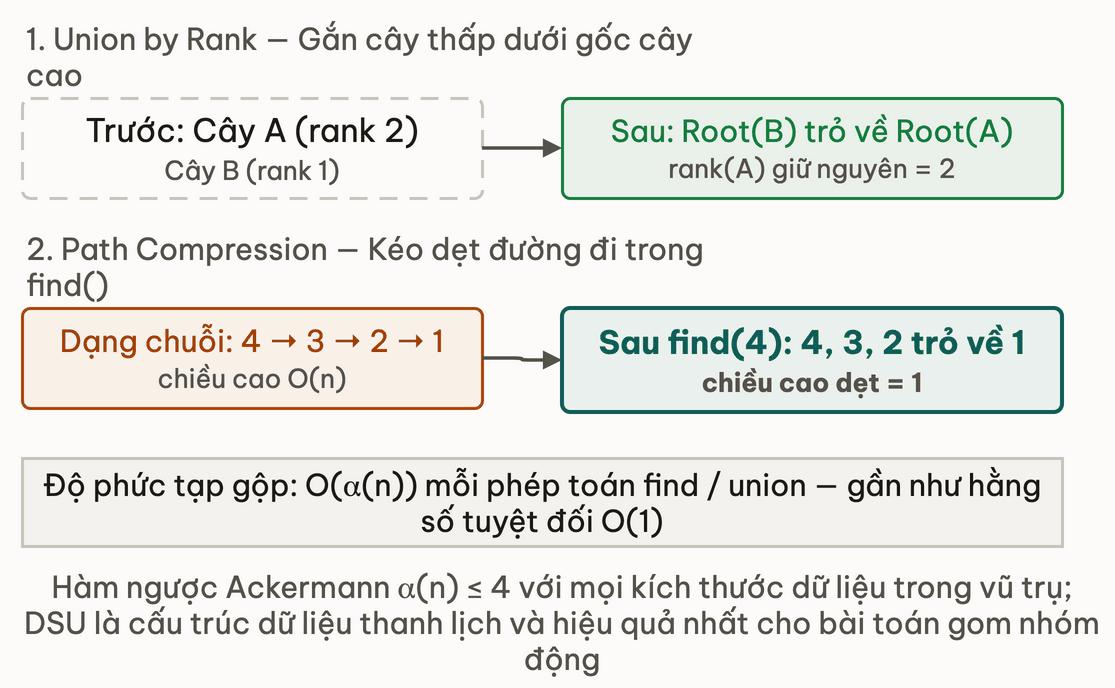
Ý tưởng: khi gộp hai cây, gắn cây thấp hơn vào cây cao hơn để chiều cao cả cây giữ ở mức O(log n). Nếu gắn cây cao vào cây thấp, chiều cao tổng tăng thêm 1 mà chẳng được gì.
rank[x] là ước lượng chiều cao của cây có gốc tại x. Khi gộp hai cây có rank bằng nhau, rank của root mới tăng thêm 1. Khi rank khác nhau, gắn root có rank thấp vào root có rank cao, và rank không đổi.
DSU_rank_find(parent, x):
    while parent[x] != x:
        x <- parent[x]
    return x

DSU_rank_union(parent, rank, x, y):
    rx <- DSU_rank_find(parent, x)
    ry <- DSU_rank_find(parent, y)
    if rx = ry: return false
    -- Attach cây có rank thấp hơn vào cây có rank cao hơn
    if rank[rx] < rank[ry]:
        đổi chỗ rx và ry    -- đảm bảo rank[rx] >= rank[ry]
    parent[ry] <- rx
    if rank[rx] = rank[ry]:
        rank[rx] <- rank[rx] + 1
    return true
Time: O(log n) mỗi find Space: O(n)
Kết quả: chiều cao cây DSU tối đa là log n sau bất kỳ chuỗi union nào, nên find(x) tốn O(log n). Tổng n thao tác tốn O(n log n). Tốt hơn hẳn O(n²) nhưng vẫn chưa tối ưu.
5. Optimization 2 — Path Compression
Ý tưởng: khi find(x) đi lên từ x đến root, nó đã biết root là ai cho mọi node trên đường đó. Vậy sao không gán thẳng parent[x] = root cho chúng luôn? Lần find sau trên bất kỳ node nào của đường đó sẽ chỉ tốn O(1).
Cách 1: nén toàn bộ đường (đệ quy): đi lên root bằng đệ quy, rồi trên đường quay về, đặt parent của từng node thành root.
DSU_compress_find(parent, x):
    if parent[x] != x:
        parent[x] <- DSU_compress_find(parent, parent[x])    -- compress khi quay về
    return parent[x]
Cách 2: path halving (dùng vòng lặp): mỗi bước nhảy lên hai cấp (parent[parent[x]]) thay vì một. Không cần đệ quy, mà amortized vẫn bằng cách nén toàn bộ đường.
DSU_halving_find(parent, x):
    while parent[x] != x:
        parent[x] <- parent[parent[x]]    -- path halving -- nhảy qua một cấp
        x <- parent[x]
    return x
Time: O(log n) amortized (chỉ path compression) Space: O(n)
Kết quả (chỉ path compression, không union by rank): O(log n) amortized mỗi thao tác. Cây được "dẹt" dần sau nhiều lần find, nhưng không gì ngăn cây ban đầu cao tới O(n) trước khi được nén.
Thử ngẫmnén toàn bộ đường bằng đệ quy và path halving bằng vòng lặp cho cùng độ phức tạp amortized. Với 1 triệu union liên tiếp trên một chuỗi thẳng dài, bản đệ quy gặp rủi ro gì mà halving không có?
6. Combined — Union by Rank + Path Compression
DSU_init(parent, rank, n):
    for i <- 0 đến n-1:
        parent[i] <- i    -- mỗi phần tử là root của chính mình
        rank[i] <- 0

-- Full path compression -- đệ quy
DSU_find(parent, x):
    if parent[x] != x:
        parent[x] <- DSU_find(parent, parent[x])
    return parent[x]

-- Union by rank -- attach cây thấp vào cây cao
DSU_union(parent, rank, x, y):
    rx <- DSU_find(parent, x)
    ry <- DSU_find(parent, y)
    if rx = ry: return false
    if rank[rx] < rank[ry]:
        đổi chỗ rx và ry
    parent[ry] <- rx
    if rank[rx] = rank[ry]:
        rank[rx] <- rank[rx] + 1
    return true

DSU_connected(parent, x, y):
    return DSU_find(parent, x) = DSU_find(parent, y)
Time: O(α(n)) amortized mỗi operation Space: O(n)
Độ phức tạp amortized: O(α(n)) mỗi thao tác, trong đó α là hàm ngược Ackermann (inverse Ackermann).
α(n) là hàm tăng cực kỳ chậm:
- α(n) không vượt quá 4 với n không vượt quá 2^65536 (con số lớn hơn số nguyên tử trong vũ trụ).
- Với mọi input thực tế: α(n) không vượt quá 4.
- Nên thực tế coi như hằng số.
Cận trên O(α(n)) amortized do Tarjan (1975) chứng minh trong bài báo "Efficiency of a Good But Not Linear Set Union Algorithm", kèm kết quả cho thấy chính thuật toán này không thể tốt hơn. Các nghiên cứu sau đó cho thấy cận dưới tương tự với những mô hình tính toán rộng hơn, nên coi như không thể cải thiện thêm đáng kể.
7. Trace ví dụ — step-by-step
Bảng cuối mục này là một bảng trace của mảng parent[]; chưa quen thì ôn Bảng trace. Bắt đầu với DSU 5 phần tử (0 đến 4). parent = [0,1,2,3,4], rank = [0,0,0,0,0].
Bước 1: union(1, 2)
find(1) = 1,find(2) = 2: khác nhau.rank[1] = rank[2] = 0: gắn 2 dưới 1, tăngrank[1]lên 1.parent = [0,1,1,3,4],rank = [0,1,0,0,0].
Bước 2: union(3, 4)
find(3) = 3,find(4) = 4: khác nhau.rank[3] = rank[4] = 0: gắn 4 dưới 3, tăngrank[3]lên 1.parent = [0,1,1,3,3],rank = [0,1,0,1,0].
Bước 3: union(1, 3)
find(1) = 1,find(3) = 3: khác nhau.rank[1] = rank[3] = 1: gắn 3 dưới 1, tăngrank[1]lên 2.parent = [0,1,1,1,3],rank = [0,2,0,1,0].- Cây: root là 1, con trực tiếp là 2 và 3, con của 3 là 4.
Bước 4: find(4)
parent[4] = 3,parent[3] = 1,parent[1] = 1, nên root là 1.- Path compression:
parent[4] = 1, cònparent[3] = 1thì đã đúng sẵn. parent = [0,1,1,1,1]. Node 4 giờ trỏ thẳng tới root.- Lần sau gọi
find(4)chỉ tốn O(1).
| Operation | parent[] | Ghi chú |
|---|---|---|
| Init | [0,1,2,3,4] | Mỗi node là root của chính mình |
| union(1,2) | [0,1,1,3,4] | 2 trỏ tới 1. rank[1]=1 |
| union(3,4) | [0,1,1,3,3] | 4 trỏ tới 3. rank[3]=1 |
| union(1,3) | [0,1,1,1,3] | 3 trỏ tới 1. rank[1]=2 |
| find(4) | [0,1,1,1,1] | Path compression: 4 trỏ thẳng tới 1 |
Thử ngẫmở bước find(4), path compression gán thẳng parent[4] = 1 và bỏ qua node trung gian 3. Sau bước này, gọi find(3) tốn bao nhiêu bước?
8. Bẫy tổng hợp
Bẫy 1: Chỉ dùng một trong hai optimization
Chỉ dùng union by rank (không có path compression) thì mỗi find tốn O(log n): tốt, nhưng chưa tối ưu.
Chỉ dùng path compression (không có union by rank) thì mỗi thao tác tốn O(log n) amortized (theo phân tích của Tarjan): tốt, nhưng trong trường hợp xấu nhất, lần find đầu tiên trên cây chưa nén vẫn tốn O(n), vì không gì ngăn cây ban đầu cao O(n) trước khi được nén lần đầu.
-- WRONG: chỉ union by rank, không path compression
DSU_find_wrong1(parent, x):
    while parent[x] != x:
        x <- parent[x]    -- O(log n) mỗi lần -- chưa tối ưu

-- WRONG: chỉ path compression, không union by rank
DSU_union_wrong2(parent, x, y):
    rx <- DSU_find(parent, x)
    ry <- DSU_find(parent, y)
    if rx = ry: return false
    parent[rx] <- ry    -- không kiểm tra rank -- cây vẫn có thể cao trước khi compress
    return true
Phải dùng cả hai mới đạt O(α(n)).
Bẫy 2: Recursive find gây stack overflow
Độ sâu đệ quy của find bằng chiều cao cây. Khi có union by rank, chiều cao không quá log n nên đệ quy an toàn. Nhưng nếu chỉ dùng path compression (hoặc union ngây thơ), một chuỗi union xấu dựng ra cây cao cỡ n trước lần nén đầu tiên, và find đệ quy có thể tràn stack: Python mặc định giới hạn 1000 mức đệ quy, JVM cỡ vài nghìn đến vài chục nghìn frame.
-- RISKY: độ sâu đệ quy = chiều cao cây, có thể stack overflow
DSU_find_recursive(parent, x):
    if parent[x] != x:
        parent[x] <- DSU_find_recursive(parent, parent[x])
    return parent[x]

-- SAFE: iterative two-pass full compression
DSU_find_safe(parent, x):
    root <- x
    while parent[root] != root:
        root <- parent[root]       -- pass 1: tìm root
    while parent[x] != root:      -- pass 2: compress
        next <- parent[x]
        parent[x] <- root
        x <- next
    return root
Time: O(α(n)) amortized Space: O(1) thêm (không stack)
Bẫy 3: DSU không thread-safe
union đọc hai root rồi ghi parent[] thành hai bước không nguyên tử. Nếu nhiều thread cùng gọi union, hai lần gộp có thể ghi đè nhau (race condition, tức tranh chấp dữ liệu):
-- RACE CONDITION: hai thread gọi union đồng thời
-- Thread A: union(a, b): find(a) = 1, find(b) = 2
-- Thread B: union(a, c): find(a) = 1, find(c) = 3
-- Thread A ghi parent[1] = 2
-- Thread B ghi parent[1] = 3   -- ghi đè, mất lần gộp của A
-- Kết quả: b bị tách khỏi nhóm của a, dù A đã gộp a với b
(Việc ghi của path compression tự nó thường vô hại, vì nó vẫn trỏ tới một tổ tiên hợp lệ; cái hỏng là các union đồng thời.) DSU không an toàn khi dùng từ nhiều thread mà không có đồng bộ hoá. Nếu cần chạy đồng thời, hãy dùng lock hoặc thiết kế theo kiểu offline: gom hết query trước, chạy DSU trên một thread, rồi trả kết quả.
Thử ngẫmbẫy 3 gợi ý thiết kế offline, tức gom hết query trước rồi chạy DSU trên một thread. Nếu hệ thống xử lý union theo luồng thời gian thực, cách offline này có dùng được không?
9. Variants đáng biết
DSU theo size (thay cho rank): thay rank[] bằng size[], trong đó size[root] là số phần tử của tập đó. union gắn tập nhỏ hơn vào tập lớn hơn. Nhờ vậy còn trả lời được "tập này có bao nhiêu phần tử?" trong O(α(n)).
-- Query: số phần tử trong set chứa x
DSU_size(size, parent, x):
    return size[DSU_find(parent, x)]
LCA offline (Lowest Common Ancestor, tổ tiên chung gần nhất), thuật toán Tarjan: tìm LCA cho nhiều cặp node trong cây khi đã biết trước toàn bộ query. Dùng DSU để theo dõi các component đã xử lý trong lúc DFS, tổng cộng O((V + Q) × α(V)) với Q query.
DSU có rollback (hoàn tác union): cho phép "undo" các union theo thứ tự ngược lại. Đánh đổi: không dùng được path compression, chỉ dùng union by rank, mỗi thao tác tốn O(log n).
10. Ứng dụng thực tế
Kruskal MST (bài 08): DSU dùng để phát hiện cycle khi thêm cạnh. Với mỗi cạnh (u, v) trong danh sách đã sort, gọi dsu.union(u, v): nếu trả về false thì u và v đã cùng component, thêm cạnh này sẽ tạo cycle. Tốc độ của DSU ảnh hưởng trực tiếp đến cả Kruskal: E lần gọi union × O(α(V)) = O(E × α(V)), thực tế coi như O(E), không phải điểm nghẽn so với bước sort O(E log E).
Kiểm tra kết nối mạng (offline): social network có hàng triệu user, cần trả lời "A và B có kết nối không?" cho nhiều cặp. Dựng DSU một lần trên toàn graph (O(E × α(V))), sau đó mỗi query chỉ tốn O(α(V)) ≈ O(1). Hợp với các câu hỏi kiểu "hai tài khoản có cùng một nhóm không?". DSU chỉ cho biết có kết nối hay không, không cho biết đường đi hay số bậc.
Suy luận kiểu (type inference) trong compiler: thuật toán unification kiểu Hindley-Milner thường được cài bằng union-find: khi hai biến kiểu bị ép bằng nhau thì union chúng lại, và find cho biết kiểu đại diện hiện tại.
11. Đào sâu
Bài báo gốc và proof:
- Tarjan, R.E. (1975) — "Efficiency of a Good But Not Linear Set Union Algorithm", Journal of the ACM: chứng minh cận trên O(α(n)) amortized cho Union by Rank + Path Compression.
- Galler, B.A. & Fischer, M.J. (1964) — "An Improved Equivalence Algorithm", Communications of the ACM: bài báo sớm mô tả cấu trúc DSU dạng rừng cây.
Sách tham khảo:
- Introduction to Algorithms (CLRS), Chapter 21 (ấn bản 3) — Data Structures for Disjoint Sets: chứng minh đầy đủ O(m α(n)) cho m thao tác trên n phần tử, kèm phân tích bổ đề về rank.
Cross-link trong khóa học:
- Amortized analysis, khoá Thuật toán Căn bản: nền tảng về độ phức tạp amortized, cần để hiểu vì sao "trung bình O(α(n))".
Bài liên quan trong khoá học:
- Kruskal MST: ứng dụng kinh điển của DSU.
- Amortized Analysis: độ phức tạp hàm ngược Ackermann α(n).
12. Tóm tắt
- DSU quản lý các tập hợp rời nhau qua mảng
parent[], mỗi tập đại diện bởi một node gốc (parent[x] = x). - Union by rank: gắn cây có rank thấp vào cây có rank cao hơn để khống chế chiều cao cây tối đa O(log n).
- Path compression: nén đường đi sau mỗi lệnh
find, trỏ thẳng các node trung gian về gốc. - Hiệu năng: kết hợp cả hai kỹ thuật đạt độ phức tạp amortized O(α(n)) — coi như O(1) trong thực tế.
- Ứng dụng: thuật toán Kruskal tìm cây khung nhỏ nhất (MST), phát hiện chu trình và phân cụm kết nối.
13. Tự kiểm tra
- Q1DSU ngây thơ (không tối ưu) tốn O(n²) trong trường hợp xấu nhất. Hãy chạy tay một ví dụ cụ thể để giải thích vì sao.
- Q2Union by rank và union by size khác nhau thế nào? Có ảnh hưởng đến độ phức tạp không?
- Q3Path compression đệ quy so với path halving: đánh đổi thực tế là gì? Khi nào chọn cái nào?
- Q4α(n) (hàm ngược Ackermann) không vượt quá 4 với mọi n thực tế: điều đó có ý nghĩa gì trong thực tế? Nó có thật sự là O(1) không?
- Q5DSU không thread-safe: vì sao? Cho một ví dụ race condition cụ thể.
- Q6Kruskal MST dùng DSU để phát hiện cycle: vì sao DSU hợp hơn các cách khác (ví dụ kiểm tra cycle bằng BFS/DFS)?
Bài tiếp theo: Mini-challenge: maze BFS + path reconstruction
Minimum Spanning Tree — Kruskal vs Prim, cut property
Bài tiếpMini-challenge — Maze solver: BFS shortest path + path reconstruction
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này