Minimum Spanning Tree — Kruskal vs Prim, cut property
MST: kết nối nhiều node chi phí tối thiểu không vòng lặp. Kruskal (sort edges + DSU) và Prim (MinHeap), cut property chứng minh correctness, khi nào chọn từng thuật toán.
TL;DR: Minimum Spanning Tree (MST, cây khung nhỏ nhất) là một spanning tree (nối mọi vertex bằng V-1 cạnh, không có cycle) có tổng weight các cạnh nhỏ nhất. Hai thuật toán kinh điển: Kruskal sort toàn bộ cạnh tăng dần rồi thêm từng cạnh nếu không tạo cycle (dùng DSU để kiểm tra), O(E log V); Prim cho cây lớn dần từ một vertex, dùng MinHeap chứa các cạnh đi ra ngoài cây và luôn lấy cạnh nhỏ nhất, O((V+E) log V). Cả hai dựa trên cùng một nền tảng lý thuyết là cut property: cạnh nhỏ nhất đi qua bất kỳ cut (S, V-S) nào phải thuộc ít nhất một MST.
Một kỹ sư mạng cần nối 100 datacenter bằng cáp quang. Mỗi cặp datacenter có chi phí lắp đặt khác nhau, tuỳ khoảng cách, địa hình, giấy phép. Mục tiêu: chọn tập cáp có tổng chi phí nhỏ nhất sao cho mọi datacenter đều thông với nhau.
Thêm cáp thừa (tạo vòng) là lãng phí: nếu datacenter A và B đã nối qua C, kéo thêm cáp trực tiếp A–B chỉ tốn tiền mà không làm mạng thông hơn. Cấu hình tối ưu là một tree: liên thông, không có cycle, đúng V-1 cạnh cho V đỉnh.
Bài này dạy 2 thuật toán tìm Minimum Spanning Tree: Kruskal (sort các cạnh và dùng Disjoint Set Union, xem bài 09) và Prim (cho cây lớn dần với MinHeap), khi nào chọn cái nào, và cut property là nền tảng chứng minh cả hai đều đúng.
1. Hình dung: Thiết kế đường dây điện
Có N ngôi nhà cần điện. Kỹ sư đo chi phí kéo dây giữa từng cặp nhà, tính cả khoảng cách, địa hình, vật cản. Cần chọn cách kéo dây có tổng chi phí nhỏ nhất sao cho nhà nào cũng có điện.
Nếu kéo dây tạo thành vòng, tức nhà A nối với B vừa qua đường thẳng vừa qua đường vòng qua C, thì đường vòng hoàn toàn thừa. Cấu hình tối ưu là N nhà, N-1 đường dây, không có vòng, nhà nào cũng nối được. Đó chính là spanning tree.
| Thiết kế đường điện | MST |
|---|---|
| Ngôi nhà | Vertex |
| Đường dây giữa hai nhà | Edge |
| Chi phí rải dây | Edge weight |
| Mọi nhà có điện | Graph liên thông |
| Không có vòng thừa | Không có cycle (tree) |
| Tổng chi phí nhỏ nhất | Tổng weight nhỏ nhất |
MST là spanning tree (nối mọi vertex, V-1 cạnh, không cycle) có tổng weight nhỏ nhất. Nó không tối ưu từng đường đi riêng lẻ mà tối ưu tổng chi phí của cả cây.
2. Định nghĩa MST
Cho graph G = (V, E) connected, undirected, weighted:
- Spanning tree: tập con E' của E sao cho tất cả V vertex nối được với nhau bằng đúng V-1 cạnh, không có cycle.
- MST (Minimum Spanning Tree): spanning tree có tổng weight nhỏ nhất.
Có bao nhiêu MST:
- Nếu mọi weight đều khác nhau thì MST là duy nhất.
- Nếu có cạnh bằng weight nhau thì có thể tồn tại nhiều MST cùng có tổng weight tối thiểu.
Lưu ý quan trọng: MST tối ưu tổng weight của cả cây, không tối ưu đường ngắn nhất giữa từng cặp vertex. Đây là điểm khác biệt cốt lõi so với Dijkstra.
3. Cut property — nền tảng correctness
Cut là cách chia tập vertex V thành 2 tập không giao nhau: S và V-S (mỗi vertex thuộc đúng một trong hai tập).
Cạnh qua cut là cạnh có một đầu trong S và một đầu trong V-S, tức cạnh này "bắc cầu" giữa hai tập.
Cut property: với bất kỳ cut (S, V-S) nào, cạnh có weight nhỏ nhất qua cut đó phải thuộc ít nhất một MST.
Vì sao? Gọi cạnh đó là e. Giả sử e không thuộc MST T. Thêm e vào T sẽ tạo đúng một cycle, và cycle đó phải chứa ít nhất một cạnh f khác cũng qua cut này (vì cycle phải đi ra khỏi S rồi quay vào S). Do e là cạnh nhỏ nhất qua cut nên weight(e) <= weight(f). Thay f bằng e trong T được spanning tree T' có tổng weight không tăng. Vậy T' cũng là MST, nên có ít nhất một MST chứa e.
Ý nghĩa thực tế: cả Kruskal và Prim đều chỉ là áp dụng cut property lặp đi lặp lại: ở mỗi bước, chọn cạnh nhỏ nhất qua một cut nào đó, và cạnh đó chắc chắn thuộc MST.
4. Kruskal algorithm
4.1 Ý tưởng
Kruskal xây MST theo góc nhìn lấy cạnh làm trung tâm:
- Sort tất cả cạnh theo weight tăng dần.
- Duyệt từng cạnh (từ nhỏ đến lớn): thêm cạnh vào MST nếu hai đầu của nó chưa nằm trong cùng một component (tức thêm cạnh này không tạo cycle).
- Dừng khi đã có V-1 cạnh.
Câu hỏi ở bước 2, "hai đầu cạnh có cùng component không?", được giải bằng Disjoint Set Union (DSU). Bài 09 sẽ phân tích DSU chi tiết; ở đây ta coi nó như hộp đen với hai thao tác (cách tách một mảnh việc thành hộp đen có tên, đầu vào, đầu ra này là thói quen ở bài Phân rã): find(x) trả về gốc (root) của component chứa x, union(x, y) gộp hai component.
4.2 Pseudocode
Kruskal(G, V, E):
    -- Sắp xếp tất cả cạnh theo trọng số tăng dần
    sắp xếp E theo weight tăng dần

    DSU dsu <- khởi tạo với V đỉnh    -- mỗi đỉnh là component riêng
    result <- []

    for each cạnh (u, v, w) trong E (theo thứ tự đã sắp xếp):
        -- Chỉ thêm nếu u và v thuộc component khác nhau (không tạo cycle)
        if dsu.union(u, v) = true:
            result.append((u, v, w))
            if result.length = V - 1:
                break    -- MST đã đủ V-1 cạnh

    return result    -- nếu result.length < V-1: graph không liên thông
Time: O(E log E) để sort + O(E × α(V)) cho DSU ≈ O(E log V) Space: O(V)
α là hàm ngược Ackermann (inverse Ackermann), tăng cực kỳ chậm nên thực tế coi như hằng số.
4.3 Trace ví dụ — graph 4 vertex
Bảng dưới là bảng trace: mỗi dòng một cạnh được xét, cột là trạng thái DSU và kết quả. Chưa quen thì ôn Bảng trace.
0 ---(1)--- 1
|  \        |
(4) (3)    (2)
|     \     |
3 ---(5)--- 2
Edges sorted: (0,1,1), (1,2,2), (0,2,3), (0,3,4), (2,3,5).
| Bước | Edge | DSU state | Kết quả |
|---|---|---|---|
| 1 | (0,1) w1 | find(0)=0, find(1)=1 → khác → union | Thêm. MST: 1 |
| 2 | (1,2) w2 | find(1)=0, find(2)=2 → khác → union | Thêm. MST: 2 |
| 3 | (0,2) w3 | find(0)=0, find(2)=0 → cùng component | Bỏ qua (tạo cycle) |
| 4 | (0,3) w4 | find(0)=0, find(3)=3 → khác → union | Thêm. MST: 3 |
V-1 = 3 cạnh đã có. Dừng. Tổng weight = 1+2+4 = 7.
Thử ngẫmbước 3 bỏ cạnh (0,2) vì find(0)=find(2), cùng component nên thêm vào sẽ tạo cycle. Nếu bỏ hẳn bước kiểm tra DSU và cứ thêm các cạnh nhỏ dần cho đến khi đủ V-1 cạnh, kết quả có còn là cây không?
5. Prim algorithm
5.1 Ý tưởng
Prim xây MST theo góc nhìn lấy đỉnh làm trung tâm:
- Bắt đầu từ một vertex bất kỳ (ví dụ vertex 0).
- Giữ một MinHeap chứa các cạnh đi từ "tập trong cây" (các vertex đã thuộc MST) ra "tập ngoài cây" (các vertex chưa thuộc MST).
- Lặp: lấy cạnh nhỏ nhất từ heap; nếu đầu đích chưa trong cây thì thêm vertex đó vào cây, thêm cạnh vào MST, rồi đẩy vào heap mọi cạnh từ vertex mới ra các hàng xóm chưa trong cây.
- Dừng khi mọi vertex đã nằm trong cây.
Đây là cut property được áp dụng trực tiếp: ở mỗi bước, cut là (tập trong cây, phần còn lại), và Prim luôn chọn cạnh nhỏ nhất qua cut đó.
5.2 Pseudocode
Prim(G, n):
    inTree[0..n-1] <- false
    H <- MinHeap rỗng    -- keyed by edge weight
    result <- []

    -- Bắt đầu từ đỉnh 0
    inTree[0] <- true
    for each cạnh (0, v, w) kề đỉnh 0:
        H.push((0, v, w))

    while H không rỗng và result.length < n - 1:
        (u, v, w) <- H.pop()    -- lấy cạnh có trọng số nhỏ nhất
        if inTree[v]:
            continue             -- v đã trong tree, bỏ qua (lazy delete)

        -- Thêm v vào tree
        inTree[v] <- true
        result.append((u, v, w))

        -- Đẩy các cạnh từ v ra neighbor chưa trong tree
        for each cạnh (v, x, wx) kề v:
            if not inTree[x]:
                H.push((v, x, wx))

    return result
Time: O((V+E) log V) Space: O(V+E)
5.3 Trace ví dụ — cùng graph 4 vertex
| Bước | Poll | inTree | Kết quả |
|---|---|---|---|
| Init | — | 0 | Heap: [(0→1,1),(0→2,3),(0→3,4)] |
| 1 | (0→1, w1) | {0,1} | Thêm. Push 1→2 w2. Heap: [(1→2,2),(0→2,3),(0→3,4)] |
| 2 | (1→2, w2) | {0,1,2} | Thêm. Push 2→3 w5. Heap: [(0→2,3),(0→3,4),(2→3,5)] |
| 3 | (0→2, w3) | — | vertex 2 đã trong tree → skip |
| 4 | (0→3, w4) | {0,1,2,3} | Thêm. Heap: [(2→3,5)] |
MST: 4, tổng weight = 7. Kết quả giống Kruskal.
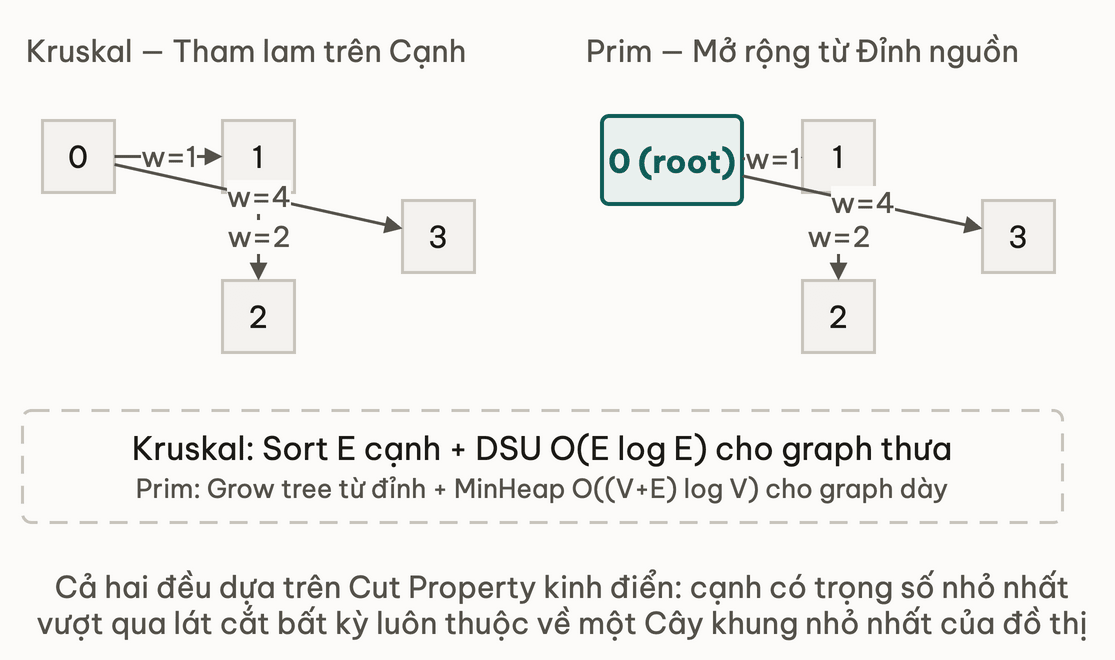
6. Kruskal vs Prim — khi nào chọn gì
| Tiêu chí | Kruskal | Prim |
|---|---|---|
| Cách làm | Sort cạnh + DSU | Mở rộng cây từ đỉnh + MinHeap |
| Độ phức tạp thời gian | O(E log V) | O((V+E) log V) |
| Space | O(V) DSU | O(V + E) heap |
| Hợp với | Sparse graph (E nhỏ) | Dense graph (E gần V²) |
| Graph không liên thông | Trả về minimum spanning forest (rừng khung nhỏ nhất) | Chỉ xử lý 1 component chứa vertex 0 |
| Dạng input tự nhiên | Edge list | Adjacency list |
Khi nào Kruskal thắng Prim?
Với sparse graph (E nhỏ hơn nhiều so với V²), O(E log V) của Kruskal tốt hơn O((V+E) log V) của Prim. Ví dụ: V = 1000, E = 2000 (sparse). Kruskal ≈ 2000 × 10 = 20.000 thao tác chính. Prim ≈ (1000 + 2000) × 10 = 30.000, chậm hơn một chút nhưng ở quy mô này thì không đáng kể.
Khi nào Prim thắng Kruskal?
Dense graph (E gần V²). Với E = V², Kruskal sort E cạnh tốn V² log V thao tác. Prim vẫn là O((V + V²) log V) ≈ O(V² log V), tương đương. Nhưng Prim còn có thể tối ưu thêm bằng adjacency matrix thay cho heap, đạt O(V²) cho dense graph, thắng Kruskal rõ ràng.
7. Bẫy tổng hợp
Bẫy 1: Kruskal trên disconnected graph trả spanning forest, không phải spanning tree
-- Graph có 2 component: {0,1,2} và {3,4}
-- Kruskal trả cạnh kết nối mỗi component riêng biệt
-- result.length = 3, không phải 4 (V-1)
-- Đây là minimum spanning FOREST -- đúng cho disconnected input
-- Nhưng caller phải kiểm tra result.length = n-1 để phát hiện graph không liên thông

if result.length < n - 1:
    báo lỗi "Graph không liên thông"
Prim bắt đầu từ vertex 0 và chỉ xử lý component chứa vertex 0; các component khác bị bỏ qua hoàn toàn.
Bẫy 2: Prim heap chứa duplicate entries
-- Nhiều cạnh có thể dẫn đến cùng một vertex v -- tất cả được push vào heap
-- Khi poll entry (u->v, w): kiểm tra inTree[v] khi POLL, không khi PUSH
(u, v, w) <- H.pop()
if inTree[v]: continue    -- lazy delete -- an toàn để bỏ qua
Đây là cùng kiểu "lazy deletion" (xoá lười) như Dijkstra (bài 05). Push nhiều entry vào heap là bình thường và an toàn, chỉ cần kiểm tra khi poll. Heap có thể chứa tới O(E) entry; kết quả vẫn đúng, chỉ tốn thêm bộ nhớ.
Bẫy 3: Nhầm MST với shortest path tree (Dijkstra)
-- MST: tối ưu TỔNG weight của cây
-- Shortest path tree: tối ưu khoảng cách từ source đến TỪNG vertex riêng lẻ
--
-- Ví dụ đối chiếu (4 đỉnh):
-- Cạnh (vô hướng): 0-1 w1, 0-2 w2, 1-3 w1, 2-3 w1
--
-- MST: {(0,1,1), (1,3,1), (2,3,1)} -- tổng weight = 3
-- Dijkstra shortest path tree từ vertex 0:
--   dist[0]=0, dist[1]=1, dist[2]=2 (đi thẳng, rẻ hơn 1+1+1=3), dist[3]=2
--   Cạnh tree: {(0,1,1), (1,3,1), (0,2,2)} -- tổng weight = 4
--
-- Điểm mấu chốt: MST cạnh (2,3,1) = "kết nối vertex 2 vào cây rẻ nhất"
--               Dijkstra cạnh (0,2,2) = "đến vertex 2 từ nguồn 0 với chi phí nhỏ nhất"
--               Hai mục tiêu KHÁC NHAU
Đừng dùng Dijkstra để tìm MST, vì chúng giải hai bài toán khác nhau.
Thử ngẫmMST tối ưu tổng weight của cả cây, còn Dijkstra tối ưu khoảng cách từ nguồn đến từng đỉnh. Bài toán "độ trễ từ server gốc đến mọi node là nhỏ nhất" cần loại cây nào trong hai loại này?
8. Variants và mở rộng
Thuật toán Borůvka (1926): thuật toán MST đầu tiên được phát minh, có trước cả Kruskal và Prim. Mỗi vòng, mỗi component tìm cạnh nhỏ nhất đi ra ngoài component đó rồi thêm tất cả các cạnh ấy cùng lúc; số component giảm ít nhất một nửa sau mỗi vòng, nên tổng cộng O(E log V). Hợp với MST phân tán.
Kiểm tra một cây có phải MST không: cho trước spanning tree T, kiểm tra T có phải MST của G hay không trong O(V+E), không cần chạy lại Kruskal/Prim. Dùng cycle property: với mỗi cạnh e không thuộc T, nếu weight của e nhỏ hơn weight lớn nhất trên đường đi trong T giữa hai đầu của e thì T không phải MST. Thuật toán kiểm tra thời gian tuyến tính này do Dixon, Rauch, Tarjan (1992) đề xuất.
9. Ứng dụng thực tế
Thiết kế mạng viễn thông và datacenter: đây là bài toán gốc của MST. Thiết kế mạng cáp quang nối N điểm với tổng chi phí nhỏ nhất. Thực tế còn nhiều điều kiện phức tạp hơn (độ tin cậy, dự phòng), nên MST chỉ là phương án nền, sau đó mới thêm ràng buộc.
Phân cụm (clustering) trong machine learning: hierarchical clustering theo kiểu single-link tương đương xây MST trên graph khoảng cách, rồi cắt bỏ các cạnh có weight lớn nhất. Số cụm bằng số lần cắt cộng một. Nhiều thư viện, trong đó có scikit-learn (AgglomerativeClustering với linkage='single'), cài single-link qua MST.
Xấp xỉ cho bài toán Traveling Salesman (TSP): MST là cận dưới của TSP, vì tour TSP nào cũng có weight ít nhất bằng weight của MST. Doubled MST (đi mỗi cạnh MST 2 lần) cho tour dài không quá 2 lần tối ưu (với khoảng cách thoả bất đẳng thức tam giác). Thuật toán Christofides (1976) kết hợp MST với ghép cặp hoàn hảo weight nhỏ nhất trên các đỉnh bậc lẻ, cho tour có weight tối đa 1.5 × tối ưu. Tỷ lệ này đứng yên nhiều thập kỷ, cho đến khi Karlin, Klein và Oveis Gharan (2020) hạ được xuống 1.5 − ε với ε cực nhỏ.
10. Đào sâu
Bài báo gốc:
- Kruskal, J.B. (1956) — "On the shortest spanning subtree of a graph and the traveling salesman problem", Proceedings of the AMS: bài báo ngắn, giới thiệu thuật toán Kruskal và mối liên hệ với TSP.
- Prim, R.C. (1957) — "Shortest connection networks and some generalizations", Bell System Technical Journal: thuật toán Prim, tập trung vào dense graph và ứng dụng thiết kế mạng điện thoại.
- Borůvka, O. (1926) — "O jistém problému minimálním" (tiếng Czech): thuật toán MST đầu tiên, phát minh cho bài toán thiết kế mạng điện ở Moravia, sớm hơn Kruskal và Prim khoảng 30 năm.
Sách tham khảo:
- Introduction to Algorithms (CLRS), Chapter 23 — Minimum Spanning Trees: chứng minh đầy đủ cut property, cycle property và tính đúng của Kruskal và Prim.
Bài liên quan trong khoá học:
- DSU / Union-Find: kiểm tra chu trình tức thời trong Kruskal.
- Dijkstra: so sánh kỹ thuật kết nạp đỉnh của Prim.
11. Tóm tắt
- MST là spanning tree (V-1 cạnh, không cycle) có tổng weight nhỏ nhất; duy nhất nếu mọi weight khác nhau.
- Cut property: cạnh nhỏ nhất qua một cut bất kỳ thuộc ít nhất một MST; đó là nền tảng của Kruskal lẫn Prim.
- Kruskal: sort cạnh, thêm cạnh nếu DSU báo hai đầu khác component, O(E log V), hợp sparse graph. Prim: cây lớn dần với MinHeap, O((V+E) log V), hợp dense graph.
- Graph không liên thông: Kruskal ra minimum spanning forest, Prim chỉ xử lý component của vertex bắt đầu; kiểm tra
result.length < n - 1. - MST khác cây đường ngắn nhất: MST tối ưu tổng cả cây, Dijkstra tối ưu khoảng cách từ nguồn tới từng đỉnh.
12. Tự kiểm tra
- Q1Cut property: vì sao cạnh nhỏ nhất qua một cut chắc chắn thuộc MST? Vì sao điều này chứng minh được cả Kruskal và Prim đều đúng?
- Q2Kruskal O(E log V) so với Prim O((V+E) log V): với sparse graph (E nhỏ hơn nhiều so với V²) và dense graph (E gần V²), nên chọn thuật toán nào? Ước lượng số thao tác.
- Q3Graph không liên thông: Kruskal và Prim xử lý khác nhau thế nào? Làm sao phát hiện graph không liên thông?
- Q4Heap của Prim có nhiều entry trùng: vì sao push một cạnh nhiều lần vào heap vẫn an toàn? So sánh với lazy deletion trong Dijkstra.
- Q5Cho graph 4 vertex: edges (0,1,w2), (0,2,w4), (1,2,w1), (1,3,w5), (2,3,w3). MST và cây đường ngắn nhất từ vertex 0 có khác nhau không? Giải thích sự khác biệt.
- Q6DSU trong Kruskal: path compression và union by rank giúp gì cho độ phức tạp? Nếu không dùng hai tối ưu này thì sao?
Bài tiếp theo: Disjoint Set Union — path compression, union by rank
Floyd-Warshall — All-pairs shortest path qua DP-on-graph
Bài tiếpDisjoint Set Union — Near-O(1) với path compression + union by rank
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này