Graph representation — Adjacency list vs matrix, trade-off bộ nhớ
Adjacency list hay matrix ảnh hưởng RAM và time complexity mỗi op. So sánh 3 representation, pseudocode, rule of thumb cho social network, road map, dependency graph.
TL;DR: Graph lưu trong bộ nhớ theo 3 cách chính: adjacency matrix (bảng V×V), adjacency list (mỗi đỉnh giữ danh sách hàng xóm), và edge list (danh sách tất cả cạnh). Với graph 1 triệu đỉnh, matrix cần ~1 TB RAM còn list chỉ cần vài trăm MB, vì hầu hết graph ngoài đời là sparse (thưa, ít cạnh so với V²). Bẫy lớn nhất: chọn matrix "vì đơn giản" rồi gặp OutOfMemory ngay khi V vượt vài nghìn.
Mọi thuật toán trong module Đồ thị (BFS, DFS, Dijkstra, MST) đều bắt đầu từ cùng một câu hỏi: lưu graph thế nào trong bộ nhớ?
Nghe tưởng đơn giản, nhưng lựa chọn này quyết định cả RAM lẫn thời gian chạy. Với graph 1 triệu đỉnh, adjacency matrix cần 1.000.000² ô = 10¹² byte ≈ 1 TB RAM, dù graph có ít cạnh. Adjacency list chỉ lưu các cạnh thật nên nhẹ hơn rất nhiều. Đổi lại, tra một cạnh thì matrix O(1) còn list O(degree), trong đó degree là số hàng xóm của đỉnh.
Bài này đi qua 3 cách lưu (adjacency list, adjacency matrix, edge list), kèm pseudocode và quy tắc chọn.
1. Hình dung: sổ liên lạc lớp học
Hình dung một lớp 30 học sinh, trong đó có tổng cộng 100 cặp bạn bè.
Adjacency matrix = bảng 30×30, mỗi ô đánh dấu "X có quen Y không". Tốn đúng 900 ô dù chỉ có 100 quan hệ, tức 800 ô trống bị lãng phí.
Adjacency list = mỗi học sinh giữ danh sách bạn riêng. Tổng kích thước tất cả các list = 2 × 100 = 200 entry (mỗi cặp đếm 2 lần vì undirected, tức vô hướng). Không tốn ô trống.
Edge list = 1 danh sách khổng lồ ghi "X-Y" cho từng cặp bạn. Tra "X có bạn nào?" phải scan toàn bộ danh sách.
| Sổ liên lạc | Graph representation |
|---|---|
| Bảng 30×30, ô tick X quen Y | Adjacency matrix: V×V boolean/int |
| Mỗi HS giữ danh sách bạn riêng | Adjacency list: mỗi đỉnh giữ list hàng xóm |
| 1 list "X-Y" cho từng cặp bạn | Edge list: list of (u, v, weight) |
| 900 ô dù chỉ 100 quan hệ | Matrix: O(V²) space dù ít cạnh |
| Total list = 2×số quan hệ | List: O(V + E) space |
Matrix là bảng vuông cố định V×V, tra cạnh nhanh nhưng tốn RAM khi graph sparse. List chỉ lưu cạnh thực sự có, hợp với sparse graph, mà hầu hết graph ngoài đời là sparse.
2. Định nghĩa graph
Graph G = (V, E): V là tập đỉnh (vertices/nodes), E là tập cạnh (edges).
- Directed graph: cạnh (u, v) khác (v, u), như đường một chiều. Ví dụ: Twitter follow, dependency DAG.
- Undirected graph: cạnh
{u, v}={v, u}, đi được cả hai chiều. Ví dụ: Facebook friendship, đường hai chiều. - Weighted graph: mỗi cạnh mang một trọng số (số thực). Ví dụ: khoảng cách km, travel time, bandwidth.
- Self-loop: cạnh từ đỉnh tới chính nó — (u, u).
- Multi-edge: nhiều cạnh nối cùng một cặp đỉnh.
Ví dụ ngoài đời:
| Hệ thống | Loại graph |
|---|---|
| Twitter follow | Directed (follow khác nhau 2 chiều) |
| Facebook friendship | Undirected |
| Google Maps road | Weighted directed (one-way street) |
| Maven/Gradle dependency | DAG — directed acyclic graph |
| LinkedIn connections | Undirected weighted |
3. Adjacency Matrix
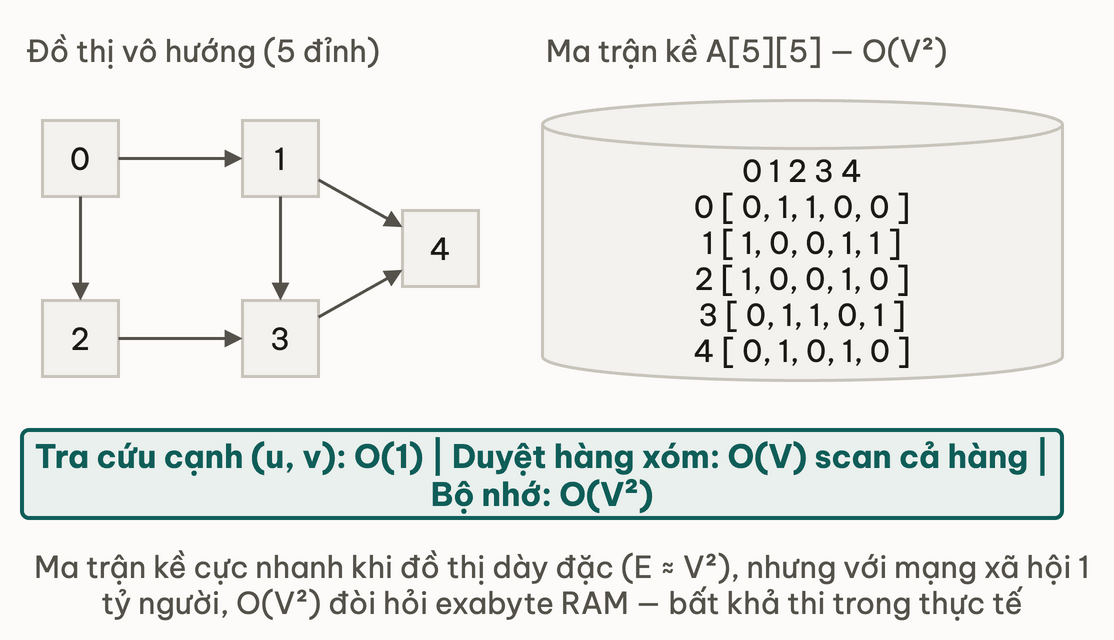
Ma trận V×V, ô adj[u][v] = 1 (hoặc true) nếu có cạnh từ u đến v.
-- Khởi tạo adjacency matrix cho graph V đỉnh
GraphMatrix(V):
    adj[0..V-1][0..V-1] <- 0      -- toàn bộ ô khởi tạo bằng 0

-- Thêm cạnh (undirected)
addEdge(u, v):
    adj[u][v] <- 1
    adj[v][u] <- 1                 -- bỏ dòng này nếu directed

-- Kiểm tra cạnh
hasEdge(u, v):
    return adj[u][v]               -- O(1)

-- Lấy danh sách hàng xóm
neighbors(u):
    result <- []
    for v <- 0 đến V-1:
        if adj[u][v] = 1:
            result.append(v)
    return result                  -- phải scan toàn hàng — O(V)
Time: O(1) cho hasEdge Space: O(V²)
Ví dụ matrix 5 đỉnh (0–4), 6 cạnh: 0-1, 0-2, 1-3, 2-3, 3-4, 1-4:
     0   1   2   3   4
0  [ .   X   X   .   . ]
1  [ X   .   .   X   X ]
2  [ X   .   .   X   . ]
3  [ .   X   X   .   X ]
4  [ .   X   .   X   . ]
Complexity:
| Operation | Matrix |
|---|---|
| Space | O(V²) |
| Edge lookup | O(1) |
| Iterate neighbors | O(V) — scan toàn hàng |
| Add edge | O(1) |
| Remove edge | O(1) |
Dùng khi: graph dense (E gần V²), cần tra cạnh O(1) liên tục, hoặc V đủ nhỏ để matrix vừa RAM.
Thử ngẫmmatrix tra cạnh O(1) nhưng duyệt hàng xóm phải quét cả hàng, tốn O(V). Với social network 1 tỷ user, trung bình 200 bạn mỗi người, matrix có vừa RAM không?
4. Adjacency List
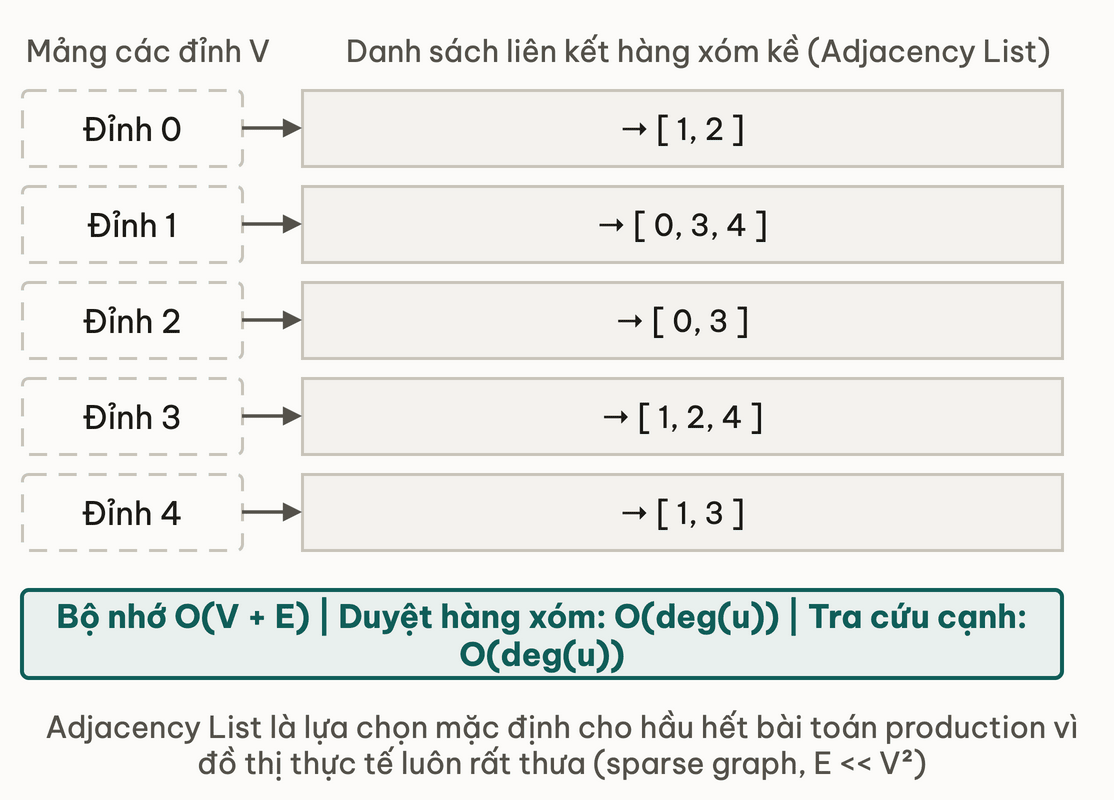
Mỗi đỉnh giữ một list các hàng xóm. Chỉ lưu cạnh thực sự tồn tại.
-- Khởi tạo adjacency list cho graph V đỉnh
GraphList(V):
    adj[0..V-1] <- [] cho mọi đỉnh   -- mỗi đỉnh có list rỗng

-- Thêm cạnh (undirected)
addEdge(u, v):
    adj[u].append(v)
    adj[v].append(u)                  -- bỏ dòng này nếu directed

-- Kiểm tra cạnh
hasEdge(u, v):
    return v trong adj[u]             -- O(degree(u))

-- Lấy danh sách hàng xóm
neighbors(u):
    return adj[u]                     -- O(1) trả về, duyệt O(degree)
Time: O(degree) cho hasEdge Space: O(V + E)
Với weighted graph, mỗi entry trong list là cặp (đỉnh đích, trọng số):
-- Thêm cạnh có trọng số (undirected)
addEdge(u, v, weight):
    adj[u].append((v, weight))
    adj[v].append((u, weight))

-- Duyệt cạnh có trọng số
for each (v, w) trong adj[u]:
    -- v là đỉnh đích, w là trọng số cạnh
Time: O(V + E) Space: O(V + E)
Complexity:
| Operation | Adjacency list |
|---|---|
| Space | O(V + E) |
| Edge lookup | O(degree) |
| Iterate neighbors | O(degree) |
| Add edge | O(1) |
| Remove edge | O(degree) |
Dùng khi: graph sparse (E gần V) và cần duyệt hàng xóm nhanh (BFS, DFS, Dijkstra). Đây là lựa chọn mặc định cho hầu hết graph ngoài đời.
Thử ngẫmadjacency list đánh đổi việc tra cạnh từ O(1) xuống O(degree) để lấy space O(V+E) thay vì O(V²). Với V = 100.000 và E = 300.000, chọn matrix thay vì list tốn thêm bao nhiêu lần bộ nhớ?
5. Edge List
Chỉ một list các cạnh, không chia theo đỉnh. Space O(E), tra hàng xóm O(E).
-- Edge list: danh sách tất cả cạnh
edges <- []
edges.append((0, 1, 5))    -- cạnh từ 0 đến 1, trọng số 5
edges.append((0, 2, 3))
edges.append((1, 3, 2))

-- Duyệt tất cả cạnh (dùng trong Bellman-Ford, Kruskal)
for each (u, v, w) trong edges:
    -- xử lý cạnh u->v với trọng số w
Time: O(E) để duyệt toàn bộ Space: O(E)
Complexity:
| Operation | Edge list |
|---|---|
| Space | O(E) |
| Edge lookup | O(E) |
| Iterate neighbors of u | O(E) — scan toàn bộ |
| Add edge | O(1) |
| Remove edge | O(E) |
Dùng khi: thuật toán cần duyệt qua tất cả cạnh theo thứ tự, như Kruskal MST (bài MST) và Bellman-Ford (bài Bellman-Ford). Những thuật toán này không cần tra hàng xóm của một đỉnh cụ thể, chỉ cần xử lý từng cạnh một lần.
6. Bảng so sánh tổng hợp
| Aspect | Matrix | Adjacency list | Edge list |
|---|---|---|---|
| Space | O(V²) | O(V + E) | O(E) |
| Edge lookup | O(1) | O(degree) | O(E) |
| Iterate neighbors | O(V) | O(degree) | O(E) |
| Add edge | O(1) | O(1) | O(1) |
| Remove edge | O(1) | O(degree) | O(E) |
| Best for | Dense graphs, fast lookup | Sparse graphs, traversal | Edge-centric algorithms |
7. Rule of thumb — chọn representation nào
Adjacency list là lựa chọn mặc định cho hầu hết graph ngoài đời:
- Social network: mỗi user chỉ có cỡ vài trăm bạn trong hàng tỉ user, nên E cỡ vài trăm × V, vẫn rất xa V².
- Bản đồ đường: mỗi ngã tư có 2-4 đường đi ra, nên graph sparse, có trọng số và có hướng.
- Dependency graph: mỗi package có vài chục dependency, nên là DAG sparse.
Adjacency matrix khi:
- Dense graph (E gần V²): complete graph, all-pairs shortest path baseline.
- V đủ nhỏ (vài nghìn đỉnh) và cần tra cạnh O(1) liên tục.
- Thuật toán Floyd-Warshall (đường ngắn nhất giữa mọi cặp đỉnh), vì nó đọc
dist[u][v]rất nhiều lần.
Edge list khi thuật toán xoay quanh cạnh chứ không phải đỉnh:
- Kruskal MST: sort tất cả cạnh theo trọng số rồi xử lý từng cạnh, nên edge list là tự nhiên.
- Bellman-Ford: relaxation (thử cập nhật đường đi ngắn hơn) qua tất cả cạnh V-1 lần, nên duyệt edge list là hợp nhất.
8. Bẫy tổng hợp
Bẫy 1: Default dùng matrix "vì đơn giản"
-- BUG: matrix cho graph lớn, sparse
adj[1_000_000][1_000_000] <- 0
-- Cấp phát 10^12 ô = 1 TB RAM
-- Crash ngay lập tức với lỗi hết bộ nhớ
Với social network 1 triệu user, matrix cần 10¹² byte (1 TB RAM). Adjacency list với 5 triệu cạnh vô hướng là 10 triệu entry, chỉ cỡ vài chục MB nếu mỗi entry là một số nguyên 4 byte. Hãy ước lượng density (E/V²) trước khi chọn: nếu density nhỏ hơn 0.01 thì dùng list.
Bẫy 2: ArrayList vs HashSet cho neighbor list
-- Mặc định: List — cho phép multi-edge, hasEdge O(degree)
adj[u] = List of neighbors

-- Thay thế: Set — không trùng, hasEdge O(1) amortized
adj[u] = Set of neighbors
Nếu graph không có multi-edge và cần hasEdge thường xuyên (ví dụ phát hiện chu trình), hãy dùng Set cho danh sách hàng xóm: hasEdge còn O(1) amortized (trung bình, tính trên nhiều lần gọi) thay vì O(degree). Đánh đổi: tốn thêm chi phí hash và không giữ thứ tự thêm vào.
Dùng List khi cần multi-edge, cần duyệt hàng xóm theo thứ tự, hoặc chạy BFS/DFS (chỉ duyệt, không cần hasEdge).
Bẫy 3: Quên double-add cho undirected graph
-- BUG: undirected nhưng chỉ thêm một chiều
addEdge(u, v):
    adj[u].append(v)
    -- Quên: adj[v].append(u)
-- Kết quả: graph bị directed — v không thấy u
-- BFS/DFS từ v bỏ sót mọi path đi qua cạnh này từ phía v
-- ĐÚNG: undirected — thêm cả hai chiều
addEdge(u, v):
    adj[u].append(v)
    adj[v].append(u)
Bug này khó debug vì graph "trông" đúng khi duyệt từ u, nhưng hỏng khi duyệt từ v. Hãy viết test kiểm tra đường đi cả 2 chiều.
Thử ngẫmbug thiếu một chiều chỉ lộ ra khi duyệt từ phía bị thiếu, test một chiều không bắt được. Test BFS bạn đang viết đã kiểm tra đường đi cả hai chiều chưa?
9. Special graph types — preview
Một số loại graph đặc biệt sẽ gặp trong module này:
- DAG (Directed Acyclic Graph): graph có hướng, không có chu trình (cycle). Dùng cho dependency graph và lập lịch task. Topological sort (bài 04) chỉ chạy được trên DAG.
- Tree: graph vô hướng, liên thông, không có chu trình, với đúng V - 1 cạnh. Spanning tree (cây khung) của một graph là một tree con chứa tất cả đỉnh.
- Bipartite graph: đỉnh chia được thành 2 nhóm, cạnh chỉ nối giữa hai nhóm, không bao giờ nối hai đỉnh cùng nhóm. Dùng cho bài toán ghép cặp (ví dụ ghép ứng viên với vị trí tuyển dụng).
- Planar graph: vẽ được trên mặt phẳng mà không có 2 cạnh cắt nhau, như bản đồ đường hay đi dây trên bo mạch.
10. Ứng dụng thực tế
Social network và bản đồ đường đều dùng adjacency list (lý do ở mục 7). Với graph có hướng như Twitter follow, mỗi user giữ 2 list riêng: following và followers. Với bản đồ, mỗi ngã tư là một đỉnh, mỗi đoạn đường là một cạnh có hướng, trọng số là thời gian đi; Dijkstra (bài 05) chạy thẳng trên list này.
Maven/Gradle build dependency: DAG dùng adjacency list (cây transitive dependency bạn thấy ở Spring Boot Starter & BOM chính là graph này). Mỗi artifact là một đỉnh, mỗi dependency là một cạnh có hướng. Topological sort trên DAG cho ra thứ tự build: artifact phải build sau tất cả dependency của nó. Maven reactor phát hiện module phụ thuộc vòng và dừng với lỗi, vì DAG không được có chu trình.
Neo4j / TigerGraph (graph databases): lưu graph theo kiểu adjacency list dùng pointer. Mỗi node giữ pointer trực tiếp đến hàng xóm, nên mỗi bước nhảy tốn O(1) thay vì phải tra B-tree như relational DB. Vì vậy graph DB thường nhanh hơn hẳn SQL JOIN khi truy vấn quan hệ sâu (bạn của bạn của bạn).
11. Đào sâu
Sách kinh điển:
- Introduction to Algorithms (CLRS), Chapter 22 (ấn bản 3) — Elementary Graph Algorithms: phân tích chặt chẽ về adjacency list và matrix, kèm chứng minh độ phức tạp.
- Graph Algorithms: Practical Examples in Apache Spark and Neo4j — Mark Needham và Amy Hodler: cách lưu graph trong hệ phân tán và trong graph DB.
Thư viện:
- JGraphT documentation (jgrapht.org): interface Graph với các lớp cài đặt SimpleGraph, DefaultDirectedGraph, SimpleWeightedGraph, cùng các thuật toán có sẵn.
- Guava
com.google.common.graphpackage: MutableGraph, MutableValueGraph — API theo phong cách functional, thân thiện với dữ liệu bất biến (immutable).
Bài liên quan trong khoá học:
- Array vs ArrayList: Ma trận kề vs Danh sách kề.
- BFS: thuật toán duyệt đồ thị theo chiều rộng.
12. Tóm tắt
Checklist chọn representation:
- Graph sparse (E ≪ V², như hầu hết graph thật)? Dùng adjacency list, space O(V + E).
- Graph dense và nhỏ, hoặc cần hỏi "có cạnh u-v không" trong O(1)? Dùng adjacency matrix, nhưng ước lượng RAM O(V²) trước.
- Thuật toán duyệt theo cạnh (Kruskal, Bellman-Ford)? Dùng edge list, space O(E).
- Undirected graph: luôn thêm cả 2 chiều, quên một chiều là biến nó thành directed.
- DAG, tree, bipartite, planar là các loại graph đặc biệt có thuật toán riêng, sẽ gặp lại ở các bài sau.
13. Tự kiểm tra
- Q1Vì sao adjacency list thắng adjacency matrix cho social network 1 tỉ user?
- Q2Edge lookup adjacency list là O(degree). Khi nào degree đủ nhỏ để không ảnh hưởng tốc độ?
- Q3Undirected graph trong adjacency list: vì sao mỗi cạnh xuất hiện 2 lần?
- Q4Cho graph 100 đỉnh, 500 cạnh. So sánh RAM dùng của adjacency matrix và adjacency list.
- Q5Edge list dùng cho Kruskal MST — vì sao thuật toán cần danh sách cạnh thay vì map hàng xóm?
- Q6DAG là gì? Cho 2 ví dụ thực tế production dùng DAG.
Bài tiếp theo: BFS — unweighted shortest path
Module Đồ thị: BFS, DFS, Dijkstra, MST
Bài tiếpBFS — Breadth-First Search và unweighted shortest path
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này