Tại sao cần index — full scan 800ms vs index scan 0.2ms
Heap = unsorted data. Index = sorted lookup table. 4000x speedup. 3 scan strategy: full scan / index scan / index-only scan. When index NOT help.
TL;DR: Database lưu data không có thứ tự — truy vấn không có index buộc quét toàn bộ bảng từ đầu đến cuối (full scan). Index tạo ra một cấu trúc riêng đã được sắp xếp, cho phép database nhảy thẳng đến dữ liệu cần tìm (index scan) với chi phí O(log N). Đánh đổi: index tốn thêm storage và làm chậm write vì mỗi INSERT/UPDATE/DELETE phải cập nhật cả index. Nguyên lý này phổ quát với mọi relational database — MySQL, PostgreSQL, SQL Server, Oracle đều hoạt động theo cùng cơ chế.
Team TaskFlow có bảng tasks với 10 triệu row. Dashboard load chậm — QA report: query SELECT * FROM tasks WHERE id = 12345 chạy mất 800ms. Không ai để ý vì local chỉ có vài trăm row, test pass sạch. Production traffic tăng, response time leo thang — đến lúc khách hàng bắt đầu complain.
Sau khi kiểm tra query plan lần đầu, thấy database đọc toàn bộ 10 triệu row chỉ để tìm một dòng. CREATE INDEX idx_tasks_id ON tasks(id) — query chạy lại: 0.2ms. Chênh 4000 lần. Vì sao chênh khủng vậy? Bài này giải thích cơ chế heap vs index, 3 loại scan strategy, và 4 trường hợp index không giúp gì.
1. Analogy — Mục lục sách
Hình dung bạn cầm cuốn sách 1000 trang. Muốn tìm tất cả chỗ nhắc đến "B-tree" — bạn có hai cách: đọc từ trang 1 đến trang 1000, hoặc lật thẳng ra mục lục cuối sách, thấy "B-tree: trang 42, 87, 156", đến thẳng ba trang đó.
Heap (bảng dữ liệu) = 1000 trang đọc tuần tự. Index = mục lục cuối sách → đến thẳng trang cần tìm. Trade-off: in mục lục tốn thêm giấy và phải cập nhật khi sách in lại bổ sung nội dung.
| Sách in | Database |
|---|---|
| 1000 trang nội dung | Heap — data pages chứa row |
| Mục lục cuối sách | Index — sorted lookup structure |
| Trang số trong mục lục | Heap page + offset pointer trong index leaf |
| Tìm từ đầu đến cuối | Sequential scan (Seq Scan) |
| Tra mục lục rồi đến trang | Index Scan |
| Mục lục đủ thông tin, khỏi mở sách | Index Only Scan |
| In thêm mục lục tốn giấy | Index chiếm storage thêm |
| Mỗi lần in lại phải cập nhật mục lục | Mỗi INSERT/UPDATE/DELETE phải update index |
Index là mục lục — tra nhanh, nhưng tốn giấy và phải đồng bộ khi nội dung thay đổi. Không có index: đọc toàn bộ. Có index: nhảy thẳng đến chỗ cần. Over-index: mỗi lần ghi phải cập nhật nhiều mục lục cùng lúc.
2. Heap = unsorted data, Index = sorted lookup
Heap là nơi database lưu data thực tế. Không có thứ tự. Row được insert vào bất kỳ page nào còn chỗ trống — page 1 có thể chứa row id=42, id=7, id=99 xen kẽ nhau.
Heap (tasks table):
[Page 1] row(id=42, title='Fix login'), row(id=7, title='Write docs'), row(id=99, title='Deploy')
[Page 2] row(id=15, title='Review PR'), row(id=3, title='Setup CI'), row(id=88, title='Load test')
[Page 3] row(id=1, title='Init repo'), row(id=55, title='Write tests'), ...
...
[Page N] ... (10 million rows total, no ordering)
Seq Scan = đọc từ Page 1 đến Page N, check mọi row. Với 10 triệu row trải trên hàng nghìn page = 800ms.
Hai con số 800ms và 0,2ms là kết quả. Đại lượng thật đứng sau chúng là số trang engine phải chạm:
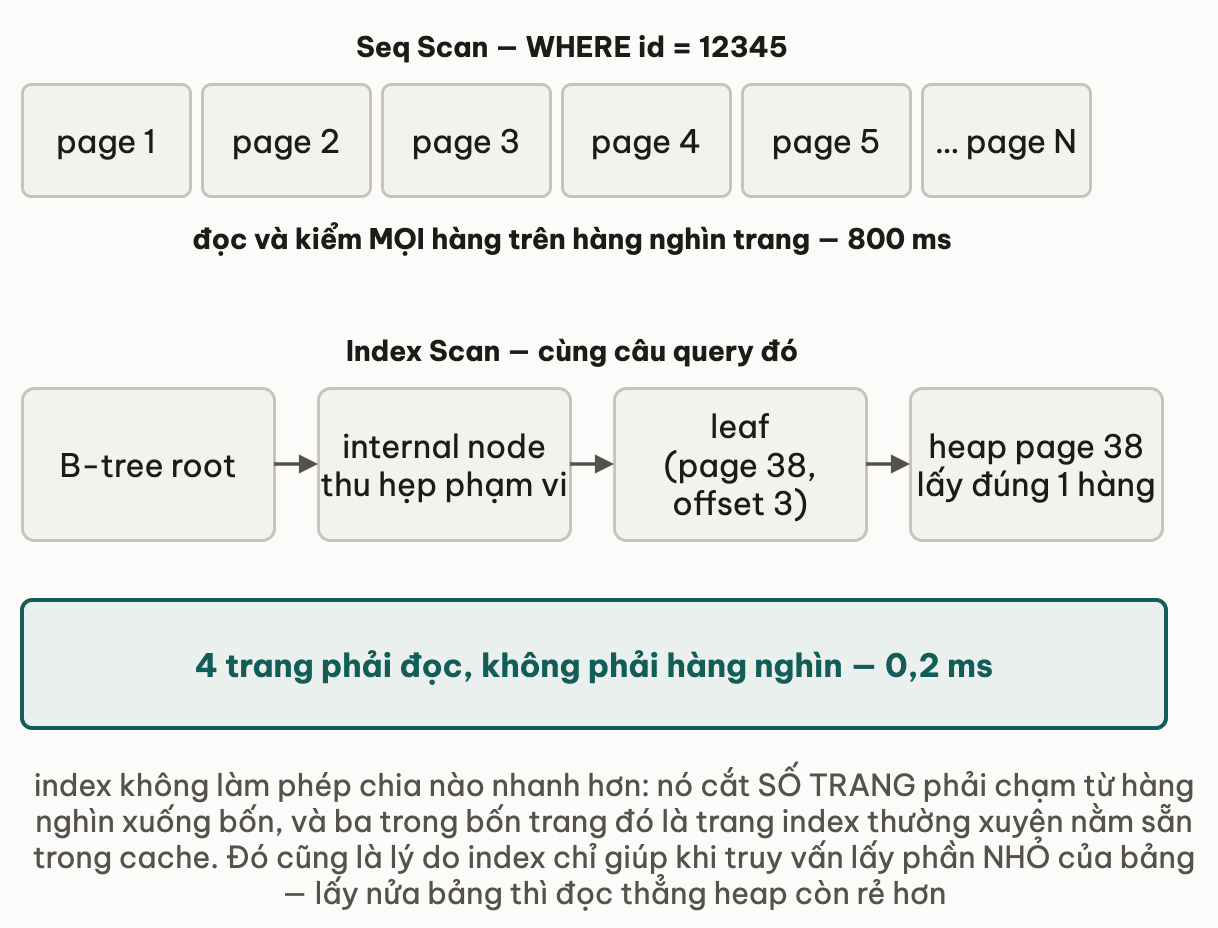
B-tree Index lưu riêng một cấu trúc sorted theo column được index. Mỗi leaf entry chứa giá trị column + pointer (heap_page, offset) để fetch row gốc.
B-tree index ON tasks(id):

            [Root: 5000000]
           /               \
   [Node: 1-2500000]   [Node: 2500001-10000000]
        |                       |
[Leaf: 1,3,7,15,42,...]  [Leaf: 2500001,2500003,...]
      |      |                  |
  (ptr: P1   (ptr: P2       (ptr: P47
   off=2)     off=0)         off=1)
Lookup id = 12345: navigate tree từ root xuống leaf, O(log N) bước, thấy pointer (heap_page=38, offset=3), fetch đúng 1 page = 0.2ms.
Hầu hết database tự tạo B-tree index cho mọi PRIMARY KEY và UNIQUE constraint. Index trên column khác phải CREATE INDEX explicit.
Thử ngẫmbảng tasks tăng từ 10 triệu lên 1 tỷ row: số bước B-tree phải đi qua tăng theo cấp nào, tuyến tính hay logarit, và điều đó nói gì về giới hạn thực của index?
3. Ba loại scan strategy
3.1 Setup demo
-- Tao bang demo 10 trieu row (SQL chuan, chay duoc tren moi RDBMS)
CREATE TABLE tasks_demo (
  id     BIGINT PRIMARY KEY,
  title  VARCHAR(255),
  status VARCHAR(20),
  due_at DATE
);

-- Populate bang voi du lieu mau (cach insert phu thuoc tool/engine)
-- Vi du: chay script tao 10,000,000 row voi status phan bo deu todo/doing/done

CREATE INDEX idx_tasks_demo_status ON tasks_demo(status);
CREATE INDEX idx_tasks_demo_due    ON tasks_demo(due_at);

-- Sau bulk insert: chay lenh cap nhat statistics cua engine ban dang dung
-- de query planner co uoc luong row count chinh xac
3.2 Full Scan — đọc toàn heap
-- Query khong co WHERE -> bat buoc full scan
SELECT * FROM tasks_demo;
-- Full scan: doc ~88,000 page cho 10 trieu row

-- Query tren column khong co index
SELECT * FROM tasks_demo WHERE title = 'Task 12345';
-- Full scan (khong co index tren title), ~750ms
Query planner chọn full scan khi:
- Không có index phù hợp.
- Selectivity thấp: query trả về hơn 5–10% số row → random I/O từ index lookup đắt hơn đọc tuần tự heap.
- Bảng nhỏ (dưới vài trăm page): cost-based planner thấy full scan rẻ hơn.
3.3 Index Scan — lookup B-tree rồi fetch heap
-- Selectivity cao: tim 1 row trong 10 trieu -> index scan
SELECT * FROM tasks_demo WHERE id = 12345;
-- Index Scan (dung idx tren id)
-- Chi doc ~4 page: 3 B-tree node + 1 heap page, ~0.2ms
Cost = O(log N) navigate tree + số heap fetch tương ứng số row trả về. Càng ít row trả về, index scan càng vượt trội so với full scan.
-- Selectivity thap: status = 'todo' ~ 33% row -> planner co the chon full scan
SELECT * FROM tasks_demo WHERE status = 'todo';
-- Full scan (33% = ~3.3 trieu row, random fetch 3.3M heap page dat hon seq scan)
3.4 Index-Only Scan — không cần chạm heap
-- Index co du moi column query can (status filter + id return)
-- SQL chuan: INCLUDE la extension cua nhieu engine (PostgreSQL, SQL Server, MySQL 8+)
CREATE INDEX idx_tasks_status_id
  ON tasks_demo(status)
  INCLUDE (id);

SELECT id FROM tasks_demo WHERE status = 'done';
-- Index-Only Scan: lay data tu index leaf, khong fetch heap
-- ~12ms cho 3.3 trieu row
Index-only scan hoạt động khi index chứa mọi column query cần (status để filter, id để SELECT). Engine bỏ qua heap hoàn toàn. Một số engine cần cơ chế kiểm tra row visibility (ví dụ PostgreSQL dùng visibility map, được autovacuum cập nhật) để xác nhận row còn valid mà không cần đọc heap.
Cú pháp INCLUDE (col) để thêm non-key column vào index leaf có ở PostgreSQL 11+ và SQL Server. Tên tính năng khác nhau ("covering index", "included columns") nhưng nguyên lý giống nhau: nhét thêm column vào leaf node để tránh fetch heap. MySQL không có mệnh đề INCLUDE — muốn cover thì phải đưa thẳng column vào danh sách key của index.
4. Demo before/after index — TaskFlow scenario
-- TaskFlow: 100k task, query dashboard theo assignee
-- Truoc khi co index: full scan
SELECT * FROM tasks
WHERE assignee_id = 5;
-- Full scan tren 100k row: ~250ms

-- Tao index
CREATE INDEX idx_tasks_assignee ON tasks(assignee_id);

-- Cap nhat statistics cho query planner (lenh cu the tuy engine):
-- PostgreSQL: ANALYZE tasks;
-- MySQL:      ANALYZE TABLE tasks;
-- SQL Server: UPDATE STATISTICS tasks;
-- Oracle:     DBMS_STATS.GATHER_TABLE_STATS(...)

-- Sau khi co index: index scan
SELECT * FROM tasks
WHERE assignee_id = 5;
-- Index Scan tren idx_tasks_assignee: ~1.2ms
-- 200 lan nhanh hon, cung tra ve dung 412 row
200 lần nhanh hơn. Cập nhật statistics sau khi tạo index hoặc bulk insert lớn là bước quan trọng: query planner cần thông tin mới về row count và data distribution để chọn đúng execution plan. Module 8 của khoá này đi sâu vào statistics và cost model.
5. Bốn trường hợp index không giúp gì
-- 1. Selectivity thap: status = 'todo' chiem ~33% bang
--    Planner chon full scan vi random index fetch 3.3M heap page dat hon seq scan
SELECT * FROM tasks WHERE status = 'todo';
-- Full scan (du co idx_tasks_demo_status) -- nhanh hon index scan o day
-- 2. Function tren indexed column: index tren email, query dung LOWER()
--    B-tree index luu gia tri goc, khong luu LOWER() gia tri
SELECT * FROM users WHERE LOWER(email) = '[email protected]';
-- Full scan (index tren email khong dung cho LOWER(email))

-- Fix: tao expression index (ho tro o PostgreSQL, MySQL 8+, SQL Server, Oracle)
CREATE INDEX idx_users_email_lower ON users(LOWER(email));
SELECT * FROM users WHERE LOWER(email) = '[email protected]';
-- Index scan using idx_users_email_lower
-- 3. Type mismatch: id kieu so nguyen, query compare voi chuoi text
--    Vi du PostgreSQL-style cast (engine khac: CAST(id AS VARCHAR) hoac tuong duong)
SELECT * FROM tasks WHERE CAST(id AS VARCHAR) = '12345';
-- Full scan: cast doi kieu tren indexed column -> index khong applicable
-- Fix: bo cast, compare dung kieu
SELECT * FROM tasks WHERE id = 12345;
-- Index scan
-- 4. Leading wildcard LIKE: % dau chuoi -> B-tree khong biet bat dau tu dau
SELECT * FROM users WHERE email LIKE '%@gmail.com';
-- Full scan: B-tree chi support prefix search (LIKE 'foo%'), khong support suffix
-- Fix: trigram index hoac full-text search (xem bai pattern-matching module 02)
Pattern chung: tạo index không đảm bảo được dùng. Phải kiểm tra query plan (lệnh tùy engine: EXPLAIN với PostgreSQL/MySQL, SHOWPLAN với SQL Server) và giữ statistics mới.
Thử ngẫmmột PR thêm WHERE email LIKE '%@gmail.com' vào báo cáo hàng tuần. Index trên email đã có sẵn — review có nên chặn PR này không, và index đó có cứu được gì không?
6. Pitfall — over-index là write killer
Mỗi index trên một bảng là một cấu trúc riêng cần được cập nhật khi có INSERT/UPDATE/DELETE. Bảng 7 index = mỗi insert phải update 7 B-tree. Write throughput giảm, storage 2–5 lần data.
-- Anti-pattern: index moi column
CREATE INDEX idx1 ON tasks(title);
CREATE INDEX idx2 ON tasks(status);
CREATE INDEX idx3 ON tasks(due_at);
CREATE INDEX idx4 ON tasks(assignee_id);
CREATE INDEX idx5 ON tasks(project_id);
CREATE INDEX idx6 ON tasks(created_at);
CREATE INDEX idx7 ON tasks(updated_at);
-- Hau qua: INSERT tasks phai update 7 B-tree
-- Write throughput giam, storage phong len 3-5x

-- Fix: chi index column can thiet dua tren workload thuc te
-- Identify slow query truoc, sau do moi them index
-- Sau khi deploy: kiem tra index nao khong bao gio duoc dung
-- va xoa no (cach kiem tra tuy engine)
Nguyên tắc: đo trước, index sau. Không đoán mò.
7. Index lifecycle — tạo, xóa, maintain
-- Tao index
CREATE INDEX idx_tasks_due ON tasks(due_at);

-- Xoa
DROP INDEX idx_tasks_due;
Trên production, tạo index khi bảng đang có traffic cần cẩn thận — một số engine block write trong lúc build index (MySQL InnoDB), một số hỗ trợ build không block write (CREATE INDEX CONCURRENTLY trong PostgreSQL, ONLINE = ON trong SQL Server). Kiểm tra tài liệu engine đang dùng trước khi chạy CREATE INDEX trên bảng lớn ở production.
Mỗi engine có cách khác nhau để phát hiện index không được sử dụng sau khi deploy. PostgreSQL có pg_stat_user_indexes (cột idx_scan). MySQL có sys.schema_unused_indexes. SQL Server có sys.dm_db_index_usage_stats. Nguyên lý chung: sau khi deploy đủ lâu, index có lượt dùng = 0 là ứng viên để drop — nhưng đảm bảo đã chạy đủ workload đại diện trước khi quyết định.
Thử ngẫmbảng tasks đang nhận traffic liên tục lúc bạn cần thêm index. Chạy thẳng CREATE INDEX không kèm CONCURRENTLY trong giờ cao điểm gây rủi ro gì cho write đang chạy?
8. Applied — TaskFlow dashboard query
Module 3 của khoá này có dashboard query:
SELECT id, title, project_id, due_at
FROM tasks
WHERE assignee_id = 5
  AND status IN ('todo', 'doing')
  AND due_at BETWEEN CURRENT_DATE AND CURRENT_DATE + INTERVAL '7' DAY
ORDER BY due_at;
Naive index — chỉ index assignee_id:
CREATE INDEX ON tasks(assignee_id);
-- Index scan tren assignee_id, roi filter status + due_at tren heap
-- Ket qua: ~200ms (fetch hang ngan row, sau do filter)
Composite index — cover cả ba column filter:
CREATE INDEX ON tasks(assignee_id, status, due_at);
-- Index scan, filter status va due_at trong index (khong can fetch heap row thua)
-- Ket qua: ~5ms
Covering index với INCLUDE — index-only scan:
CREATE INDEX ON tasks(assignee_id, status, due_at) INCLUDE (project_id, title);
-- Index-only scan: moi column SELECT (id, title, project_id, due_at)
--   deu co trong index -> khong can fetch heap
-- Ket qua: ~1ms
Bài tiếp theo của module này sẽ giải thích B-tree internals — tại sao thứ tự column trong composite index quan trọng và (assignee_id, status, due_at) tốt hơn các hoán vị khác.
9. Deep Dive — Index foundations
- Use The Index, Luke — "Anatomy of an Index" — Markus Winand giải thích B-tree từ góc developer, agnostic giữa các engine, diagram rõ ràng. Free web. Đọc "The Leaf Nodes" và "The B-Tree" để hiểu cơ chế leaf node và range scan.
- Use The Index, Luke — "Where Clause" — đi sâu vào khi nào index được dùng, khi nào không, function-on-column trap, composite index column order. Agnostic, rất thực tiễn.
- PostgreSQL Documentation Ch.11 "Indexes" — ví dụ một engine cụ thể: catalog index types (B-tree, Hash, GIN, BRIN), partial index, expression index. Đọc khi muốn xem implementation cụ thể của một engine.
Ghi chú: Use The Index Luke là nguồn agnostic tốt nhất để xây intuition về index — không gắn engine. Tài liệu engine (PG, MySQL, SQL Server) cho cú pháp và behavior chính xác khi triển khai.
10. Liên hệ các bài khác
- Module 5 — Thiết kế schema, bài 01 — Data types: chọn đúng data type cho column ảnh hưởng trực tiếp đến hiệu quả index — type mismatch là một trong 4 trường hợp index không được dùng (mục 5 bài này).
- Bài 05 — Pattern matching: giải thích tại sao
LIKE '%x%'không dùng được B-tree index và khi nào cần index chuyên dụng — đọc song song với mục 5 bài này. - Module 7 của khoá này (Transactions & consistency): khi tạo index trên production, cần hiểu isolation và locking để tránh block write — bài 2 module 7 giới thiệu transaction control.
11. Tóm tắt
- Heap lưu row không có thứ tự — full scan phải đọc mọi page từ đầu đến cuối.
- B-tree index lưu riêng cấu trúc sorted — lookup O(log N) rồi fetch đúng heap page cần. Đây là cấu trúc index mặc định của hầu hết RDBMS.
- 3 loại scan: full scan (không index hoặc selectivity thấp), index scan (selectivity cao, fetch heap), index-only scan (index chứa mọi column cần, không fetch heap).
- Kiểm tra query plan (EXPLAIN hoặc tương đương) trước/sau khi thêm index — không đoán plan.
- Cập nhật statistics sau bulk insert hoặc tạo index mới — planner cần thông tin mới để chọn đúng plan.
- 4 trường hợp index không giúp: selectivity thấp, function trên indexed column, type mismatch, leading wildcard LIKE.
- Over-index = write killer: mỗi index thêm là một B-tree phải update trên mỗi INSERT/UPDATE/DELETE. Đo trước, index sau.
12. Tự kiểm tra
- Q1Vì sao full scan đôi khi rẻ hơn index scan dù đã có index? Cơ chế selectivity threshold hoạt động thế nào?
- Q2Phân biệt index scan và index-only scan. Khi nào INCLUDE column trong index thực sự quan trọng?
- Q3Bạn CREATE INDEX xong query vẫn chậm — query plan cho thấy full scan. Bốn nguyên nhân phổ biến và cách fix từng cái?
- Q4Over-index 7 index trên một bảng. Khi nào tradeoff write overhead đáng chấp nhận, khi nào không?
- Q5TaskFlow thêm index (assignee_id) nhưng dashboard query vẫn 250ms — query plan cho thấy index scan, không phải index-only scan. Vấn đề gì? Cách fix theo 2 cấp?
Bài tiếp theo: B-tree internals — page split, fill factor, height (bài 02 của module này)
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Ôn phỏng vấn
Bài này trả lời được các câu phỏng vấn sau — tự trả lời thử trước khi mở đáp án.
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên