B-tree vs LSM-tree — hai triết lý lưu trữ index
B-tree update tại chỗ, tối ưu đọc. LSM-tree ghi nối tiếp, tối ưu ghi. Đánh đổi write vs read amplification, sequential vs random I/O — agnostic theo tinh thần DDIA.
TL;DR: Mọi storage engine của database đứng giữa hai họ thiết kế index. B-tree giữ một cây cân bằng trên đĩa, cập nhật tại chỗ (update-in-place) ngay trên page chứa dữ liệu — đọc ổn định, range query nhanh, nhưng mỗi lần ghi sửa page tại chỗ nên phát sinh random I/O và page split. LSM-tree (log-structured merge-tree) không bao giờ sửa tại chỗ: ghi nối vào bộ nhớ rồi flush ra các file bất biến (SSTable), gộp dần qua compaction — ghi rất nhanh (nối tiếp, tuần tự), nhưng đọc phải gộp nhiều tầng. Đánh đổi cốt lõi là write amplification (B-tree thấp hơn) đổi lấy read amplification (LSM cao hơn): chọn họ nào tuỳ workload đọc-nhiều hay ghi-nhiều.
Bài trước giải thích vì sao cần index: heap không có thứ tự, index là cấu trúc sorted cho tra cứu O(log N). Nhưng "cấu trúc sorted" đó được hiện thực ra sao trên đĩa? Hoá ra có hai cách trả lời hoàn toàn khác nhau, dẫn tới hai họ storage engine với tính cách trái ngược.
Hãy hình dung TaskFlow chạy hai tình huống. Tình huống A: bảng tasks đọc nhiều (dashboard, báo cáo), ghi vừa phải — cần đọc nhanh và ổn định. Tình huống B: một bảng events ghi log hành vi, hàng chục nghìn dòng mỗi giây đổ vào, đọc lại ít hơn — cần ghi cực nhanh. Cùng một khái niệm "index sorted", nhưng hai workload này muốn hai cách lưu khác nhau. Bài này mổ hai cách đó — B-tree và LSM-tree — và đánh đổi khiến mỗi cái thắng ở một workload.
1. Analogy — Sổ ghi sửa tại chỗ vs nhật ký nối tiếp
Tưởng tượng bạn quản lý số dư tài khoản của khách hàng bằng sổ giấy. Có hai phong cách:
- Sổ cái sửa tại chỗ (B-tree): mỗi khách một dòng cố định, sắp theo thứ tự tên. Khi số dư đổi, bạn tìm đúng dòng đó, tẩy số cũ ghi số mới. Tra cứu cực nhanh (sổ luôn sắp xếp, lật thẳng tới tên cần tìm), nhưng mỗi lần cập nhật phải lật đúng trang, tẩy, ghi — và nếu một trang đầy, phải xé trang ra làm đôi để chèn dòng mới.
- Nhật ký nối tiếp (LSM-tree): bạn không sửa gì cả. Mỗi giao dịch, bạn nối thêm một dòng mới xuống cuối nhật ký: "khách A: +50". Ghi siêu nhanh vì chỉ viết tiếp xuống cuối. Nhưng muốn biết số dư hiện tại của khách A, bạn phải đọc ngược nhật ký gộp mọi dòng của A lại. Định kỳ, bạn ngồi chép lại sạch (compaction) — gộp các dòng cũ thành một bản tổng hợp gọn gàng để lần sau đọc nhanh hơn.
| Sổ giấy | Storage engine |
|---|---|
| Sổ cái sắp theo tên, tẩy-ghi tại chỗ | B-tree — page sorted, update-in-place |
| Xé trang khi trang đầy để chèn dòng | Page split khi page đầy |
| Nhật ký chỉ nối thêm xuống cuối | LSM-tree — append-only, ghi tuần tự |
| Đọc số dư = gộp nhiều dòng của khách | Read amplification — gộp memtable + nhiều SSTable |
| Định kỳ chép lại sạch cho gọn | Compaction — merge sort các SSTable |
B-tree = sổ cái tẩy-ghi tại chỗ (đọc nhanh, ghi tốn công sửa trang). LSM-tree = nhật ký chỉ nối thêm rồi định kỳ chép lại sạch (ghi nhanh, đọc tốn công gộp).
2. B-tree — cây cân bằng, update tại chỗ
B-tree là cấu trúc index mặc định của hầu hết relational database truyền thống. Ý tưởng: chia đĩa thành các khối cố định gọi là page (thường 4KB hoặc 8KB), tổ chức các page thành một cây cân bằng (balanced tree). Mỗi page chứa một dải khoá đã sắp xếp cùng pointer xuống page con.
B-tree (sap theo key, moi node = 1 page tren dia):

                 [ Root page: 100 | 500 ]
                /         |          \
      [<100]         [100..500]       [>500]
    /   |   \         /    \          /    \
  leaf leaf leaf   leaf   leaf     leaf   leaf
  (key + pointer toi heap row, sorted trong leaf)
Tra cứu một khoá: bắt đầu từ root, so sánh khoá để chọn nhánh, đi xuống cho tới leaf — số bước bằng chiều cao cây, mà chiều cao của B-tree rất thấp (một cây 4 tầng với page rộng đã chứa được hàng tỷ khoá). Đó là O(log N) với cơ số lớn.
Range query là điểm mạnh của B-tree. Vì khoá trong leaf đã sắp xếp và (trong biến thể B+tree dùng cho database) các leaf được liên kết thành một danh sách, quét một dải WHERE date BETWEEN ... AND ... chỉ cần định vị leaf đầu rồi đi tuần tự qua các leaf kế tiếp — không phải nhảy lung tung.
-- Range query: B-tree dinh vi leaf dau roi quet tuan tu cac leaf ke
SELECT id, title FROM tasks
WHERE due_at BETWEEN '2026-06-01' AND '2026-06-30'
ORDER BY due_at;
Ghi thì tốn công hơn. Để cập nhật giá trị một khoá, B-tree tìm đúng leaf page rồi ghi đè tại chỗ (update-in-place). Nếu chèn khoá mới vào một page đã đầy, page phải tách đôi (page split): cấp phát page mới, chia khoá sang hai page, rồi cập nhật pointer ở page cha — đôi khi split lan lên tới root. Mỗi thao tác này là random I/O (ghi vào vị trí rải rác trên đĩa) và sửa nhiều page cho một thay đổi logic nhỏ.
Update-in-place có rủi ro: nếu mất điện giữa lúc một page split đang dở (đã ghi page con nhưng chưa cập nhật page cha), cây hỏng. Để chống điều này, engine B-tree thường ghi một write-ahead log (WAL) nối tiếp trước khi sửa page thật — log dùng để khôi phục cây về trạng thái nhất quán sau sự cố. Lưu ý: chính WAL này cũng góp vào write amplification của B-tree.
Thử ngẫmbảng audit_log chỉ INSERT, gần như không bao giờ UPDATE dòng cũ. Chi phí "ghi tại chỗ" của B-tree (tìm leaf, ghi đè, có thể split) còn nặng như với bảng tasks không?
3. LSM-tree — log-structured, ghi nối tiếp
LSM-tree (log-structured merge-tree) lật ngược triết lý: không bao giờ sửa tại chỗ. Mọi thứ đều là nối thêm (append) hoặc ghi file mới bất biến. Luồng ghi đi qua ba tầng:
- Memtable — một cấu trúc sorted trong bộ nhớ (thường skip list hoặc cây cân bằng). Mọi ghi vào trước hết nối vào đây. Vì ở RAM, ghi cực nhanh. (Một WAL nối tiếp trên đĩa chạy song song để chống mất dữ liệu nếu crash trước khi flush.)
- SSTable — khi memtable đầy, nó được flush xuống đĩa thành một file bất biến (immutable) tên là SSTable (sorted string table): các khoá đã sắp xếp, ghi một mạch tuần tự. Đã ghi ra rồi thì không bao giờ sửa file đó nữa.
- Compaction — theo thời gian, đĩa tích nhiều SSTable (có thể chứa nhiều phiên bản của cùng một khoá). Một tiến trình nền định kỳ merge sort các SSTable lại, loại bản cũ và bản đã xoá, viết ra SSTable mới gọn hơn.
Đặt hai thiết kế cạnh nhau trên cùng một lần ghi thì khác biệt hiện ra không phải "nhanh hay chậm", mà là trả tiền lúc nào:
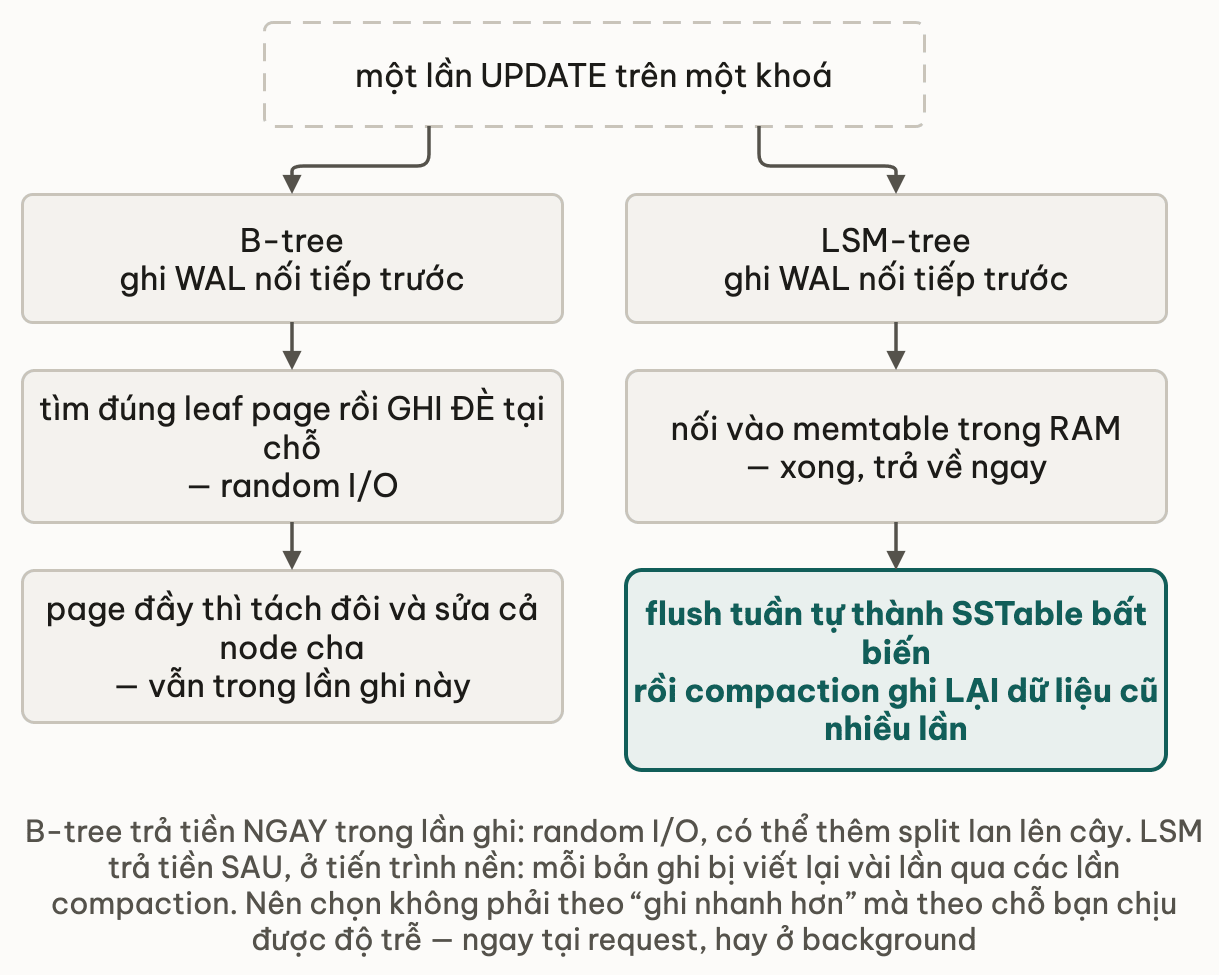
Ghi là điểm mạnh của LSM. Ghi den chỉ chạm RAM (memtable) cộng một dòng nối vào WAL — không random I/O, không page split. Flush và compaction đều ghi tuần tự (sequential), thứ mà cả đĩa cơ lẫn SSD đều xử lý nhanh hơn nhiều so với random I/O. Nhờ vậy LSM nuốt được throughput ghi rất cao.
Đọc tốn công hơn. Để tra một khoá, engine phải tìm qua nhiều tầng: memtable trước, rồi lần lượt các SSTable từ mới đến cũ, cho tới khi gặp khoá (hoặc một bản ghi "đã xoá"). Nếu khoá không tồn tại, về lý thuyết phải sờ tới mọi SSTable — đó là read amplification.
Để khỏi đọc đĩa từng SSTable cho một khoá không tồn tại, mỗi SSTable kèm một bloom filter — cấu trúc xác suất nhỏ gọn trả lời nhanh "khoá này chắc chắn không có trong SSTable" hoặc "có thể có". Engine hỏi bloom filter trước; nếu nó nói "chắc chắn không", bỏ qua SSTable đó mà không cần đọc đĩa. Bloom filter có thể báo dương tính giả (nói "có thể có" nhưng thực ra không), nhưng không bao giờ báo âm tính giả — đủ để cắt phần lớn lần đọc đĩa vô ích.
4. Cơ chế cốt lõi — write vs read amplification
Hai họ engine khác nhau ở chỗ chi phí dồn vào đâu. Hai khái niệm đo điều này:
- Write amplification — một byte dữ liệu logic kéo theo bao nhiêu byte ghi xuống đĩa thực tế. B-tree ghi page tại chỗ cộng WAL, đôi khi split — mỗi cập nhật logic sửa ít nhất một page. LSM ghi memtable rồi flush, nhưng compaction ghi đi ghi lại cùng dữ liệu nhiều lần khi gộp tầng — đây là nguồn write amplification chính của LSM.
- Read amplification — một lần đọc logic kéo theo bao nhiêu lần chạm đĩa. B-tree đi thẳng từ root xuống một leaf — số chạm bằng chiều cao cây, ổn định và thấp. LSM phải gộp memtable cộng nhiều SSTable — số chạm tăng theo số tầng (giảm nhờ bloom filter nhưng vẫn cao hơn B-tree).
- Space amplification — dữ liệu chiếm bao nhiêu đĩa so với kích thước logic. LSM có thể giữ nhiều bản cũ của một khoá cho tới khi compaction dọn, nên tốn thêm chỗ tạm thời; B-tree có thể để lại page chỉ lấp một phần sau split (fragmentation).
Cung 1 UPDATE logic mot khoa:

B-tree:  tim leaf -> ghi de page (random I/O) [+ WAL] [+ split neu day]
         => write amplification THAP, doc on dinh

LSM:     noi vao memtable (RAM) [+ WAL]
         => sau do flush + compaction ghi lai du lieu NHIEU lan (nen)
         => write amplification CAO HON nhung ghi den deu tuan tu (nhanh)
Cách diễn đạt gọn: B-tree dồn chi phí vào lúc ghi tại chỗ (random I/O) để đọc rẻ; LSM dồn chi phí vào compaction nền để ghi đến rẻ. Đây chính là đánh đổi quyết định chọn họ nào.
Thử ngẫmổ đĩa production báo dung lượng dùng gấp 1,5 lần dữ liệu logic dù chưa xoá dòng nào. Đây là dấu hiệu của amplification nào, và engine LSM hay B-tree dễ gặp hơn?
5. So sánh theo workload
| Tiêu chí | B-tree | LSM-tree |
|---|---|---|
| Mô hình ghi | Update-in-place (random I/O) | Append-only, flush tuần tự |
| Throughput ghi | Vừa phải | Cao (ghi tuần tự) |
| Độ trễ đọc điểm | Thấp, ổn định (chiều cao cây) | Cao hơn, biến động (gộp tầng) |
| Range query | Rất nhanh (leaf liên kết) | Tốt (SSTable sorted) nhưng phải gộp tầng |
| Write amplification | Thấp hơn | Cao hơn (do compaction) |
| Read amplification | Thấp | Cao hơn (bù bằng bloom filter) |
| Space amplification | Fragmentation sau split | Bản cũ chờ compaction |
| Hợp với workload | Đọc-nhiều, cần độ trễ đọc ổn định | Ghi-nhiều, throughput ingest cao |
Quy tắc chọn theo pattern: workload đọc-nhiều, độ trễ đọc phải ổn định (dashboard giao dịch, tra cứu theo khoá) nghiêng về B-tree. Workload ghi-nhiều, ingest tốc độ cao (log sự kiện, time-series, telemetry) nghiêng về LSM. Lưu ý "ghi-nhiều" ở đây là ghi mới/append liên tục — đúng tạng append-only của LSM.
Đây chỉ là ví dụ trung lập để định vị, KHÔNG phải trọng tâm bài (nguyên lý mới là chính). Nhiều RDBMS truyền thống dùng B-tree làm index mặc định; nhiều kho ghi-nhiều như các store kiểu Cassandra hoặc thư viện như RocksDB/LevelDB dùng LSM-tree. Internals cụ thể của từng engine thuộc track riêng — ví dụ track PostgreSQL — không mổ ở bài agnostic này.
6. Pitfall — chọn engine sai workload
Sai lầm thường gặp: lấy một engine B-tree đa năng rồi đổ vào nó một bảng events ghi hàng chục nghìn dòng mỗi giây. Mỗi insert là một lần tìm leaf + ghi đè + có thể split — random I/O dồn dập, page split liên tục, throughput ghi tụt và độ trễ ghi tăng vọt.
-- Bang ghi-nhieu: ingest telemetry lien tuc
INSERT INTO events (ts, user_id, action) VALUES (NOW(), 7, 'click');
-- Tren B-tree: moi insert -> tim leaf + ghi de + co the page split (random I/O)
-- Hang chuc nghin/giay -> bottleneck ghi
Chiều ngược lại cũng sai: ép một store LSM phục vụ workload đọc-điểm độ-trễ-thấp khi compaction chưa kịp gộp — đọc phải sờ nhiều SSTable, độ trễ đọc biến động (đặc biệt đuôi p99 cao khi compaction đang chạy nền).
Hướng đúng: chọn họ engine theo tỉ lệ đọc/ghi và yêu cầu độ trễ của bảng, không theo thói quen "DB mặc định". Đo workload thực (đọc-nhiều hay ghi-nhiều, cần range query không, độ trễ p99 mục tiêu) rồi mới quyết. Nhiều khi một hệ thống dùng cả hai họ cho các bảng khác tính chất.
7. 📚 Deep Dive
- Designing Data-Intensive Applications (Kleppmann) — Chương 3 "Storage and Retrieval" — nguồn nền tảng so sánh B-tree vs LSM-tree, write/read amplification, SSTable, compaction. Đọc mục "SSTables and LSM-Trees" và "B-Trees".
- Rudolf Bayer & Edward McCreight (1970), "Organization and Maintenance of Large Ordered Indices" — paper khai sinh B-tree. Biến thể B+tree dùng trong database: internal node không chứa pointer tới record, chỉ leaf chứa; các leaf liên kết để sequential scan range nhanh.
- Patrick O'Neil, Edward Cheng, Dieter Gawlick, Elizabeth O'Neil (1996), "The log-structured merge-tree (LSM-tree)" — paper khai sinh LSM-tree. Tầng C0 (memtable) thường skip list / B+tree trong RAM; SSTable bất biến trên đĩa; compaction kiểu merge sort. Thiết kế cho workload write-intensive.
- Wikipedia — Log-structured merge-tree — tóm tắt cấu trúc tầng, compaction strategy, bloom filter.
Ghi chú: DDIA Chương 3 là nguồn chuẩn agnostic — giải thích đánh đổi mà không gắn engine. Hai paper gốc (Bayer-McCreight 1970, O'Neil 1996) cho nền tảng lịch sử chính xác của hai họ thiết kế.
8. Liên hệ các bài khác
- Bài 01 — Tại sao cần index: nền tảng heap vs index sorted và 3 loại scan — đọc trước bài này để hiểu "index sorted" mà B-tree/LSM hiện thực hoá.
- Bài 03 — Hash index và bức tranh các loại index: B-tree là họ "ordered index" cho range; hash index là họ "equality-only". Đọc tiếp để thấy B-tree đứng đâu trong bức tranh các loại index.
- Module 10 — OLTP vs OLAP: row-store/column-store là một trục lưu trữ khác (theo dòng vs theo cột) song song với trục B-tree/LSM — cùng đọc để thấy nhiều chiều đánh đổi lưu trữ.
- Module 2 — Pattern matching: range/prefix query (
LIKE 'foo%') tận dụng được thứ tự sorted của B-tree — minh hoạ vì sao "ordered" quan trọng. - Tuần tự vs ngẫu nhiên — khoá Lưu trữ & I/O: lý do LSM-tree biến mọi write thành ghi nối tiếp nằm ở tầng ổ đĩa bên dưới — bài này giải thích vì sao sequential write nhanh hơn random write hàng chục lần trên HDD/SSD.
9. Tóm tắt
- Có hai họ storage engine cho index: B-tree (update-in-place) và LSM-tree (log-structured, append-only).
- B-tree: cây cân bằng page, sorted; tra cứu O(log N) theo chiều cao cây; range query nhanh nhờ leaf liên kết; ghi = ghi đè tại chỗ + đôi khi page split (random I/O, có WAL).
- LSM-tree: ghi nối vào memtable (RAM) → flush ra SSTable bất biến (tuần tự) → compaction merge sort; đọc gộp nhiều tầng, bloom filter cắt lần đọc đĩa vô ích.
- Đánh đổi cốt lõi: B-tree write amplification thấp + đọc ổn định; LSM throughput ghi cao + read amplification cao hơn. Còn có space amplification (bản cũ chờ compaction vs fragmentation sau split).
- Chọn họ theo workload: đọc-nhiều / độ-trễ-đọc-ổn-định → B-tree; ghi-nhiều / ingest-cao → LSM.
- Pitfall: đổ workload ghi-nhiều vào B-tree (page split dồn dập) hoặc ép LSM phục vụ đọc-điểm độ-trễ-thấp — đo tỉ lệ đọc/ghi thật rồi mới chọn.
10. Tự kiểm tra
- Q1Vì sao B-tree đọc nhanh và ổn định, nhưng ghi lại tốn công hơn LSM-tree? Cơ chế nào gây ra điều đó?
- Q2Luồng ghi của LSM-tree đi qua những tầng nào, và vì sao toàn bộ luồng đó nhanh dù dữ liệu cuối cùng vẫn nằm trên đĩa?
- Q3Phân biệt write amplification và read amplification. Mỗi họ engine cao/thấp ở chỉ số nào, và vì sao?
- Q4Bloom filter giải quyết vấn đề gì trong LSM-tree? Vì sao nó an toàn để bỏ qua một SSTable mà không cần đọc đĩa?
- Q5TaskFlow có hai bảng: 'tasks' (dashboard đọc liên tục, ghi vừa phải) và 'events' (ingest hàng chục nghìn dòng/giây, đọc lại ít). Nên nghiêng mỗi bảng về họ engine nào và vì sao?
- Q6Vì sao range query (BETWEEN, ORDER BY trên key) là điểm mạnh tự nhiên của B-tree, còn hash index thì không làm được?
Bài tiếp theo: Hash index và bức tranh các loại index
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Ôn phỏng vấn
Bài này trả lời được các câu phỏng vấn sau — tự trả lời thử trước khi mở đáp án.
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên