Cache locality — Vì sao mảng nhanh hơn linked list 25 lần
Cùng O(n) nhưng mảng có thể nhanh hơn linked list hàng chục lần. Bài giải thích cache line, prefetcher, overhead của object, và khi nào Big-O không đủ.
TL;DR: Big-O giấu constant. Cùng O(n) mà cache miss liên tục khiến linked list chậm hơn mảng số nguyên cỡ hàng chục lần (ví dụ trong bài là 25 lần), vì độ trễ bộ nhớ không nằm trong ký hiệu Big-O. CPU có nhiều tầng bộ nhớ (memory hierarchy): L1 cache ~1ns, L2 ~10ns, L3 ~30ns, DRAM ~100ns. Mỗi cache miss khi duyệt linked list phải đợi cỡ 100ns đọc từ RAM. Mảng số nguyên nằm liền nhau: CPU đọc một cache line 64 byte là nạp được 16 phần tử, và hardware prefetcher còn nạp trước. Linked list nhảy theo con trỏ ngẫu nhiên: 1 cache miss mỗi node, prefetcher bó tay. Nguyên tắc thực tế: data-oriented thinking, nghĩa là dữ liệu nằm liền nhau trong bộ nhớ quan trọng hơn hình dạng cấu trúc trừu tượng.
Bạn cần tính tổng 10 triệu phần tử. Hai đoạn thuật toán bên dưới có cùng logic, cùng độ phức tạp O(n), chạy trên cùng máy:
-- Tính tổng qua mảng số nguyên liên tiếp
-- Thời gian ví dụ: cỡ vài ms đến chục ms
sumArray(A):
    total <- 0
    for each x trong A: total <- total + x
    return total
-- Tính tổng qua linked list với giá trị được đóng gói (boxed)
-- Thời gian ví dụ: cỡ vài trăm ms
sumLinkedList(L):
    total <- 0
    node <- L.head
    while node != NIL:
        total <- total + node.value
        node <- node.next         -- theo con trỏ đến node tiếp theo
    return total
Cùng O(n), cùng số phép cộng, mà cách nhau cỡ 25 lần (con số minh hoạ, máy bạn sẽ ra khác, nhưng chênh lệch vài chục lần là chuyện thường). Big-O không giải thích được chuyện này.
Bài này giải thích cache locality từ gốc: vì sao cách xếp dữ liệu trong bộ nhớ đôi khi quan trọng hơn thuật toán bạn chọn, và lúc nào Big-O đánh lừa bạn ở production.
1. Hình dung: thư viện và bàn đọc sách
Hình dung bạn đang đọc 10 cuốn sách theo thứ tự.
Mảng giống kệ sách liên tiếp: tất cả cuốn xếp cạnh nhau trên cùng một kệ. Lấy xong cuốn 1, với tay lấy ngay cuốn 2, không phải đứng dậy.
Linked list giống hệ thống mục lục phân tán: mỗi cuốn sách có ghi chú "đọc tiếp ở kệ 7, tầng 3, phòng B". Đọc xong cuốn 1 phải đi bộ 5 phút đến kệ đó mới lấy được cuốn 2. CPU cache giống cái bàn đọc nhỏ chỉ chứa vài cuốn gần nhất. Cuốn tiếp theo không có trên bàn thì phải đứng dậy đi lấy.
| Đời thường | Concept |
|---|---|
| Cuốn sách | Phần tử dữ liệu |
| Kệ sách liên tiếp | Mảng, bộ nhớ liên tục |
| Ghi chú "đến kệ 7 tầng 3" | Con trỏ next trong node linked list |
| Bàn đọc sách nhỏ | CPU cache (L1/L2) |
| Lấy sách không cần đứng dậy | Cache hit: đọc từ cache, nhanh |
| Đi bộ 5 phút sang kệ khác | Cache miss: đọc từ RAM, chậm |
| Mỗi chuyến đi lấy sách | Độ trễ bộ nhớ (memory latency) ~100ns |
Cache locality nghĩa là dữ liệu cần dùng tiếp theo đã nằm sẵn trên "bàn đọc" (cache). Duyệt mảng tuần tự tận dụng tối đa điều này, còn đuổi theo con trỏ thì phá nó.
2. CPU memory hierarchy: bậc thang latency
CPU không đọc RAM trực tiếp theo từng byte. Giữa CPU và RAM có một chuỗi bộ nhớ đệm nhỏ nhưng nhanh hơn:
| Cấp | Độ trễ (latency) | Dung lượng điển hình | Ghi chú |
|---|---|---|---|
| Register | dưới 1 ns | vài chục đến vài trăm byte | Trực tiếp trong CPU |
| L1 cache | ~1 ns | 32–64 KB | Mỗi core có riêng |
| L2 cache | ~3–10 ns | 256 KB–1 MB | Mỗi core có riêng |
| L3 cache | ~10–30 ns | 4–64 MB | Dùng chung giữa các core |
| DRAM | ~100 ns | GB | Bộ nhớ chính |
| SSD/NVMe | ~10–100 µs | TB | ~1.000x chậm hơn DRAM |
| HDD | ~10 ms | TB | ~100.000x chậm hơn DRAM |
Để dễ hình dung, nếu L1 cache là 1 giây thì:
- L2 tương đương 3–10 giây
- L3 tương đương 10–30 giây
- DRAM tương đương 100 giây, gần 2 phút
- SSD tương đương vài ngày
- HDD tương đương vài tháng
DRAM chậm hơn L1 khoảng 100 lần. Mỗi cache miss khi duyệt linked list buộc CPU đợi 100ns. Nghe nhỏ, nhưng nhân với 10 triệu phần tử là tới cỡ 1 giây đợi.
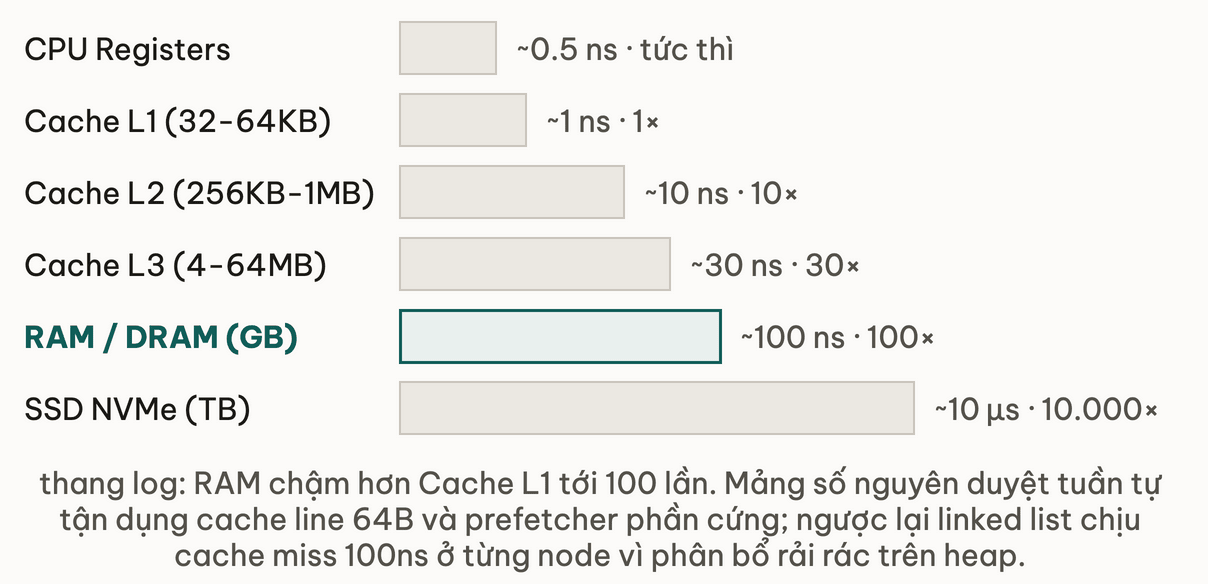
Độ trễ trên chỉ là xấp xỉ cho server x86-64 hiện đại (2020+). Số thực tế thay đổi theo đời CPU, xung nhịp và loại DRAM.
3. Cache line và prefetch: cơ chế bên dưới
3.1 Cache line là gì
CPU không đọc từng byte riêng lẻ. Mỗi lần cần dữ liệu từ RAM, nó đọc cả một cache line — khối 64 byte liên tiếp (phổ biến trên x86 và nhiều chip ARM; một số chip như Apple M-series dùng khối lớn hơn).
Cụ thể: khi bạn đọc A[0] trong mảng số nguyên 4-byte, CPU tự động nạp cả A[0] đến A[15] vào cache (16 phần tử × 4 byte = 64 byte). Lần đọc A[1], A[2], ..., A[15] kế tiếp đều là cache hit, gần như miễn phí.
3.2 Hardware prefetcher
CPU hiện đại có hardware prefetcher, một mạch chuyên đoán dữ liệu sắp cần và nạp trước vào cache.
Khi thấy kiểu truy cập tuần tự A[0], A[1], A[2], ..., prefetcher nhận ra quy luật đó và bắt đầu nạp A[16], A[17], ... trước khi code đến đó. Kết quả: duyệt mảng tuần tự gần như không phải chờ phần tử nào.
3.3 Đuổi theo con trỏ phá vỡ prefetch
Node của linked list chứa con trỏ next trỏ đến node tiếp theo, và node đó có thể nằm ở bất kỳ đâu trên heap. Kiểu truy cập trông như:
Node A tại 0x1000 → Node B tại 0x8F20 → Node C tại 0x3A40 → ...
Địa chỉ nhảy ngẫu nhiên nên prefetcher không đoán được. Trong trường hợp xấu nhất, mỗi bước duyệt là một cache miss, CPU đợi cỡ 100ns để lấy từ RAM. Với 10 triệu node: 10 triệu × 100ns = tối đa cỡ 1 giây chờ. Đo thực tế thường thấp hơn (vài trăm ms) vì node cấp phát liên tiếp vẫn nằm gần nhau một phần, nhưng vẫn chậm hơn mảng rất nhiều.
Sơ đồ cache hit/miss khi duyệt:
Mảng truy cập tuần tự:
[0x1000: 1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16]
  ^-- nạp một cache line, prefetch dòng tiếp theo
  đọc phần tử 1: HIT (vừa nạp)
  đọc phần tử 2: HIT
  đọc phần tử 3: HIT
  ... 16 lần đọc từ 1 cache line

Linked list đuổi theo con trỏ:
Node@0x1000 -> next=0x8F20 -> MISS (đọc từ RAM, đợi 100ns)
Node@0x8F20 -> next=0x3A40 -> MISS (đọc từ RAM, đợi 100ns)
Node@0x3A40 -> next=0xC510 -> MISS (đọc từ RAM, đợi 100ns)
  ... 1 cache miss mỗi node
Thử ngẫmbạn đổi LinkedList thành ArrayList trong đúng một dòng code, không đổi logic gì khác. Phần nào trong thời gian chờ RAM đó biến mất, và phần nào (boxing) thì còn nguyên?
4. Overhead của object: vì sao linked list thật sự tệ
Vấn đề không chỉ là đuổi theo con trỏ. Linked list chứa giá trị boxed (số nguyên bị bọc trong một object Integer) còn chịu chi phí phụ của object rất lớn so với mảng số nguyên.
4.1 Kích thước mỗi phần tử
Số nguyên 4-byte trong mảng primitive: 4 byte. Chỉ vậy thôi.
Số nguyên được đóng gói (boxed Integer): 12 byte object header (compressed OOPs trên JVM 64-bit) + 4 byte giá trị int = 16 byte, gấp 4 lần số nguyên primitive.
Node của linked list: 12 byte header + 4 byte tham chiếu item + 4 byte tham chiếu prev + 4 byte tham chiếu next = 24 byte (tổng đã là bội số của 8 nên không cần padding, với compressed OOPs).
Tổng cho 1 phần tử trong linked list boxed:
- Integer object: 16 byte
- Node: 24 byte
- Tổng: 40 byte, so với 4 byte của mảng số nguyên
Gấp 10 lần về RAM. 10 triệu phần tử: mảng số nguyên chiếm 40 MB; linked list boxed chiếm khoảng 400 MB, chưa kể heap bị phân mảnh.
4.2 Đo bằng JOL (Java Object Layout)
JOL là công cụ của OpenJDK để đo kích thước object trên JVM thật. Con số 16 byte ở trên đúng khi compressed OOPs bật (mặc định khi heap dưới khoảng 32 GB).
Với -XX:-UseCompressedOops (hoặc heap lớn hơn ~32 GB): header tăng từ 12 lên 16 byte, reference từ 4 lên 8 byte, nên Integer thành 24 byte và Node thành 40 byte. Luôn đo bằng JOL thay vì ghi cứng con số.
Thử ngẫmservice của bạn giữ 10 triệu số nguyên trong bộ nhớ suốt vòng đời request. Đổi từ LinkedList<Integer> sang int[] tiết kiệm khoảng bao nhiêu RAM, theo con số ở mục 4.1?
5. Benchmark: con số thực tế
Số đo minh hoạ, chỉ để thấy bậc độ lớn (kiểu số liệu JMH sau khi warm up; máy và JVM của bạn sẽ ra khác):
| Thao tác | Mảng int[] | ArrayList boxed | LinkedList boxed |
|---|---|---|---|
| Tổng 10M phần tử | ~8 ms | ~25 ms | ~200 ms |
Lấy một phần tử ở giữa (get(5.000.000)) | vài ns (O(1)) | vài ns (O(1)) | hàng chục ms trở lên (O(n), đi qua ~5 triệu node) |
| RAM cho 10M phần tử | ~40 MB | ~200 MB | ~400 MB |
ArrayList boxed chậm hơn mảng primitive vì boxing: mỗi phần tử là Integer object 16 byte thay vì 4 byte, L1 cache chứa ít phần tử hơn, nhưng layout vẫn liền kề nên prefetcher còn hoạt động được. Linked list boxed chịu cả hai vấn đề: boxing và đuổi theo con trỏ.
6. Các bẫy hay gặp
Bẫy 1: dùng linked list vì "O(1) insert" mà quên chi phí duyệt.
-- Nhầm: add tại index i -- phải duyệt đến i trước
list.add(50000, newElement)
-- O(n) duyệt + O(1) cập nhật con trỏ = O(n) tổng
-- Còn chậm hơn mảng động trong thực đo vì cache miss khi duyệt
add(index, value) trên linked list phải tìm vị trí index trước: duyệt từ đầu hoặc cuối đến index, tốn O(n/2). Chỉ bước cập nhật con trỏ sau đó mới là O(1). Tổng vẫn O(n), và thực đo còn chậm hơn mảng động vì cache miss khi duyệt.
Bẫy 2: tin Big-O quá mức, chọn cây tìm kiếm cho 100 phần tử.
-- Quá mức cần thiết cho n nhỏ: TreeMap O(log n) với cache miss overhead
-- Với 100 entry: dùng mảng linear scan thường nhanh hơn trong thực đo
-- Vì toàn bộ 100 phần tử vừa trong L1 cache (100 × 8 byte = 800 byte, nhỏ hơn 32KB L1)
-- TreeMap duyệt qua cây đỏ-đen -- nhiều cache miss mỗi bước
Duyệt cây tìm kiếm là đuổi theo con trỏ qua các node, nhiều cache miss. Quét tuyến tính qua 100 phần tử nằm liền nhau thì cả mảng vừa trong L1 cache. Với n nhỏ cỡ vài trăm, quét mảng thường ngang hoặc nhanh hơn cây tìm kiếm. Đo trước khi kết luận từ độ phức tạp tiệm cận.
Thử ngẫmbạn thấy đồng nghiệp dùng TreeMap cho một cấu hình chỉ có 100 entry, lý do ghi trong code review là "O(log n) tốt hơn". Theo mục 6, review đó đúng hay sai?
7. Dùng ở đâu trong thực tế
Deque dùng mảng thay linked list: Nhiều thư viện khuyến nghị Deque dựa trên mảng thay vì linked list/Stack truyền thống. Mảng circular dùng vùng nhớ liên tiếp — cache-friendly cho push/pop ở cả hai đầu. Linked list tốn thêm 2 con trỏ và 1 object header mỗi node, cộng với cache miss mỗi bước.
LMAX Disruptor, ring buffer không tốn con trỏ: Disruptor dùng một mảng liền nhau (ring buffer) thay cho queue gồm các node nối nhau. Các slot cố định, thread ghi và đọc không cần cấp phát object mới, nên cache miss và áp lực lên GC gần như biến mất. Các biến vị trí (sequence) của producer và consumer còn được đệm thêm byte (padding) để mỗi biến nằm trên một cache line riêng, tránh false sharing (xem self-check).
Database row store vs column store: Row store (PostgreSQL, MySQL) lưu các cột của một hàng liền kề, hợp với SELECT * trên ít hàng. Column store (Parquet, ClickHouse, Apache Arrow) lưu các giá trị của một cột liền kề, hợp với SUM(revenue) trên nhiều hàng. Chọn cách lưu theo kiểu query hay gặp cũng là cache locality, chỉ khác là ở cấp database.
8. Đào sâu: tài liệu gốc
Spec / reference chính thức:
- Ulrich Drepper — "What Every Programmer Should Know About Memory" (2007) — paper 114 trang đầy đủ nhất về CPU cache, TLB, NUMA, prefetching. Có thể đọc từ phần 3 (CPU cache) nếu bỏ qua phần hardware cứng ở đầu.
- Java Object Layout (JOL) — công cụ đo kích thước object thực tế trên JVM đang chạy.
Bài liên quan trong khoá học:
- Array vs ArrayList: mảng tuần tự tận dụng Cache Line.
- Linked List: sự trả giá khi nhảy con trỏ (pointer chasing).
- Cache Line & Locality: nguyên lý phân tầng bộ nhớ.
Đọc thêm: False sharing. Khoá Bộ nhớ đi sâu vào đúng hiện tượng false sharing vừa nêu, kèm cách đo và padding cache line.
9. Tóm tắt
Checklist khi chọn cấu trúc dữ liệu cho dữ liệu lớn hoặc đường chạy nóng:
- Ưu tiên mảng hoặc Deque vòng tròn nếu chỉ cần duyệt và thêm/bớt ở hai đầu. Linked list chỉ đáng dùng khi đã có iterator tại vị trí cần sửa.
- Với số nguyên hoặc số thực khối lượng lớn, cân nhắc mảng primitive thay cho collection boxed: ít hơn khoảng 10 lần RAM.
- Với n nhỏ (vài trăm), thử quét mảng trước khi dùng cây tìm kiếm.
- Chia dữ liệu theo cách truy cập: hay đọc cùng nhau thì đặt cạnh nhau, hay bị nhiều thread ghi thì tách ra (tránh false sharing).
- Đo bằng profiler hoặc JMH, đừng chỉ tin Big-O. Kích thước object thì đo bằng JOL.
10. Tự kiểm tra
- Q1Vì sao Big-O không tính đến cache locality? Bạn cần bổ sung mô hình nào để so sánh đầy đủ?
- Q2Linked list với giá trị boxed chứa 10 triệu phần tử dùng bao nhiêu RAM so với mảng số nguyên cùng kích thước? Giải thích từng thành phần.
- Q3Khi nào linked list thực sự thắng mảng động — ngay cả khi phải chịu phạt về cache?
- Q4Cache line 64 byte có ý nghĩa gì cho việc thiết kế cấu trúc dữ liệu? Cho ví dụ cụ thể.
- Q5False sharing là gì? Khi nào nó quan trọng trong lập trình đa luồng?
- Q6Cho hai hàm tính tổng dưới đây. So sánh lượng cache line mỗi bản phải nạp, và cho biết bản nào dùng cache hiệu quả hơn.
-- Phiên bản A: truy cập tuần tự
sumSequential(A):
  s <- 0
  for i <- 0 đến n-1: s <- s + A[i]
  return s

-- Phiên bản B: nhảy theo stride 16
sumStrided(A):
  s <- 0
  for i <- 0 đến n-1 bước 16: s <- s + A[i]
  return s
Bài tiếp theo: Problem-solving framework
Amortized analysis — ArrayList.add() O(1) dù đôi khi tốn O(n)
Bài tiếpFramework giải bài thuật toán — 5 bước biến brute force thành tối ưu
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Ôn phỏng vấn
Bài này trả lời được các câu phỏng vấn sau — tự trả lời thử trước khi mở đáp án.
Thảo luận & góp ý
Hỏi đáp về bài này