Recursion & call stack — Khi đệ quy phá vỡ giới hạn ngăn xếp
Đệ quy ẩn nguy cơ tràn ngăn xếp trong production. Bài giải thích cơ chế call stack, lý do JVM thiếu TCO, và 3 pattern chuyển sang iteration an toàn.
TL;DR: Mỗi lời gọi hàm đẩy một stack frame lên thread stack; đệ quy đủ sâu thì stack tràn. JVM thread stack mặc định cỡ 1MB trên nền tảng 64-bit phổ biến (có nơi 512KB), đủ cho khoảng 10.000–20.000 frame tùy kích thước method. JVM không có Tail-Call Optimization (TCO, tối ưu lời gọi đuôi), phần lớn vì phải giữ stack trace đầy đủ. Kotlin và Scala biến đệ quy đuôi thành vòng lặp ngay lúc compile. Ba pattern chuyển đổi: đệ quy đuôi → accumulator + while; đệ quy cây → bảng DP/biến rolling; đệ quy tổng quát → Deque tường minh trên heap.
Bạn viết hàm tính giai thừa đệ quy — gọn, đúng, trông như toán học. Test với n = 10, n = 100 đều ổn. Rồi một ngày cần xử lý input từ API bên ngoài, n = 100.000, và máy ném ngay lỗi tràn ngăn xếp.
CPython còn gặp sớm hơn: giới hạn đệ quy mặc định chỉ 1.000 frame. JVM mặc định cỡ 1MB stack mỗi thread, đủ cho khoảng 10.000 đến 20.000 frame tùy kích thước method. factorial(100000) vượt xa ngưỡng đó.
Bài này giải thích đệ quy thực sự chạy thế nào, vì sao đệ quy đẹp trên lý thuyết nhưng nguy hiểm trên production, và khi nào nên chuyển sang iteration. Nếu chưa quen việc một hàm gọi hàm khác rồi nhận kết quả về, ôn lại Hàm trước.
Ôn lại kiến thức nền tảng từ bài big o from essence trước khi đi sâu vào nội dung bài học này.
1. Hình dung: chồng giấy ghi nhớ tạm
Hình dung mỗi lần gọi hàm, bạn lấy một tờ giấy, ghi xuống "mình đang tính gì, số nào đã biết, sau khi xong thì quay về đâu", rồi đặt tờ đó lên một chồng giấy trên bàn. Khi hàm trả về, bạn lấy tờ trên cùng ra, đọc lại, và tiếp tục làm việc còn dở.
Mỗi cuộc gọi đệ quy là thêm một tờ. Gọi 20.000 lần liên tiếp mà chưa lấy tờ nào ra thì chồng giấy đổ. Đó là tràn ngăn xếp.
| Đời thường | Concept |
|---|---|
| Tờ giấy ghi nhớ | Stack frame |
| Chồng giấy đặt thẳng đứng | Call stack |
| Bút ghi note tạm | Biến cục bộ trong frame |
| Mũi tên "quay về bàn cũ" | Return address |
| Chồng đổ vì cao quá | Tràn ngăn xếp |
Mỗi lần gọi hàm là push 1 frame, mỗi lần return là pop 1 frame. Stack tràn khi push mãi mà chưa pop.
2. Stack frame là gì, và cơ chế bên dưới
Mỗi khi một hàm được gọi, runtime cấp phát một stack frame trên thread stack. Frame đó chứa:
- Mảng biến cục bộ: các biến trong hàm và tham số đầu vào.
- Ngăn xếp toán hạng: vùng tính toán trung gian (giá trị tạm khi tính biểu thức).
- Return address: địa chỉ để biết nhảy về đâu khi hàm trả về.
- Frame pointer: con trỏ liên kết frame hiện tại với frame của caller.
Kích thước mỗi frame phụ thuộc số biến cục bộ: hàm đơn giản có thể chỉ 32–64 byte, hàm nhiều biến có thể 128 byte hoặc hơn. Công thức gần đúng: khi chiều sâu × kích thước frame vượt giới hạn stack, máy ném lỗi tràn ngăn xếp.
-- Giai thừa đệ quy: mỗi lời gọi đẩy một frame mới lên thread stack.
-- Frame của factorial(n) chứa: tham số n, return address về caller.
factorial(n):
    if n <= 1: return 1               -- base case: return pop frame này
    return n * factorial(n-1)         -- lời gọi đệ quy: push frame mới
    -- CHÚ Ý: n * (...) nghĩa là frame này phải tồn tại cho đến khi
    -- factorial(n-1) trả về. Đó là lý do TCO không áp dụng ở đây.

Time: O(n)  Space: O(n) -- n frame đồng thời trên ngăn xếp
Với factorial(5), call stack lúc sâu nhất trông như sau. Mỗi dòng là một lời gọi chưa xong, giống một dòng bảng trace dựng đứng. Nếu chưa quen đọc bảng trace, ôn lại Bảng trace.
[factorial(1)]   -- đỉnh ngăn xếp (lời gọi gần nhất)
[factorial(2)]
[factorial(3)]
[factorial(4)]
[factorial(5)]   -- đáy (lời gọi đầu tiên)
[main]
Runtime unwind từ trên xuống: factorial(1) trả về 1, frame bị pop; factorial(2) nhận 1, tính 2 × 1 = 2, pop; và cứ thế đến factorial(5).
Thử ngẫmhàm của bạn có 20 biến cục bộ thay vì 2. Theo công thức chiều sâu × kích thước frame, ngưỡng tràn ngăn xếp ở độ sâu đệ quy đó dịch chuyển thế nào?
3. Sơ đồ phát triển ngăn xếp với fib(4)
Hàm Fibonacci đệ quy tạo ra cây gọi phức tạp hơn, vì mỗi lời gọi sinh ra hai nhánh con:
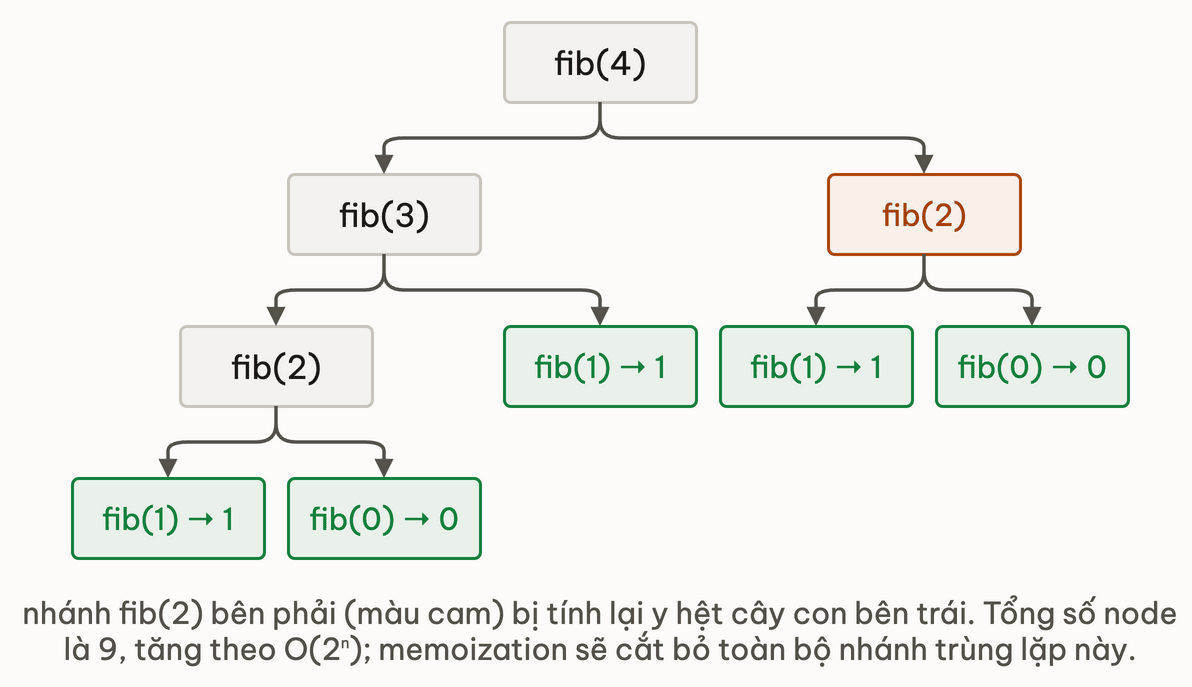
Độ sâu ngăn xếp tối đa bằng chiều cao cây, với fib(n) là n frame. Nhưng tổng số lần gọi tăng theo O(2^n) (với fib(50) là cỡ 40 tỷ lần), nên đệ quy thuần túy chậm đến mức không dùng được ở n lớn.
Chiều sâu ngăn xếp = chiều sâu tối đa tại một thời điểm = O(n) cho fib. Tổng lần gọi = tổng node trong cây = O(2^n). Tràn ngăn xếp xảy ra khi chiều sâu vượt giới hạn, không phải khi tổng lần gọi lớn.
4. Tail recursion và vì sao JVM không có TCO
Tail call là khi lời gọi đệ quy là thao tác cuối cùng trong hàm, hàm không cần làm gì thêm với kết quả trả về. Ví dụ:
-- Giai thừa đệ quy đuôi với accumulator.
-- Lời gọi đệ quy là thao tác CUỐI -- không còn gì để tính sau khi nó trả về.
-- Compiler có TCO có thể tái dùng frame hiện tại thay vì push frame mới.
factorialTail(n, acc):
    if n <= 1: return acc
    return factorialTail(n-1, n * acc)  -- vị trí đuôi: kết quả dùng trực tiếp

Time: O(n)  Space: O(n) trên JVM (O(1) nếu có TCO)
Ở phiên bản này, factorialTail(n-1, n × acc) là lệnh cuối, hàm không cần giữ gì từ frame hiện tại sau khi lời gọi trả về. Về lý thuyết, compiler có thể tái dùng frame hiện tại thay vì push frame mới. Kỹ thuật đó gọi là Tail-Call Optimization (TCO). Có TCO thì đệ quy sâu bao nhiêu cũng không tốn thêm stack.
JVM không có TCO, với hai lý do hay được nhắc:
1. Stack trace phải đầy đủ để debug: debugger, profiler và APM agent đều dựa vào frame đầy đủ. Nếu TCO xóa frame, bạn mất thông tin "hàm được gọi từ đâu".
2. Thiết kế của JVM giả định mỗi lần gọi method có frame riêng: một số cơ chế (như kiểm tra quyền dựa trên stack) duyệt qua các frame. Muốn có TCO phải sửa cả đặc tả, không chỉ thêm một bước tối ưu của JIT. Tính đến Java 21, JVM vẫn chưa có TCO.
Scala và Kotlin né vấn đề bằng cách viết lại lúc compile: annotation @tailrec (Scala) và từ khóa tailrec (Kotlin) bảo compiler biến tail recursion thành vòng lặp trong bytecode, trước khi JVM nhìn thấy.
-- Tương đương với những gì Kotlin/Scala làm ở compile time:
-- Chuyển factorialTail() thành vòng lặp thủ công.
factorialIterative(n):
    acc <- 1
    while n > 1:
        acc <- acc * n
        n <- n - 1
    return acc

Time: O(n)  Space: O(1)
Với Java, bạn phải tự chuyển đổi như vậy.
Thử ngẫmbạn port một hàm đệ quy đuôi từ Kotlin (có tailrec) sang Java thuần. Điều gì xảy ra với đúng cùng input mà bên Kotlin chạy êm?
5. Ba pattern chuyển đổi đệ quy sang iteration
5.1 Đệ quy đuôi: accumulator + vòng lặp while
Bất kỳ hàm đệ quy đuôi nào cũng có thể chuyển cơ học thành vòng lặp while:
-- Trước: đệ quy đuôi -- tràn ngăn xếp ở độ sâu ~10k-20k trên JVM
factorialTail(n, acc):
    if n <= 1: return acc
    return factorialTail(n-1, n * acc)

-- Sau: iteration với accumulator -- độ sâu không giới hạn
factorialIter(n):
    acc <- 1
    while n > 1:
        acc <- acc * n
        n <- n - 1
    return acc

Time: O(n)  Space: O(1)
5.2 Đệ quy cây: bảng DP hoặc biến rolling
Fibonacci: thay vì cây gọi O(2^n), dùng bảng kết quả đã tính:
-- O(2^n) đệ quy thuần túy -- KHÔNG dùng cho n lớn hơn 40
fibNaive(n):
    if n <= 1: return n
    return fibNaive(n-1) + fibNaive(n-2)

Time: O(2^n)  Space: O(n)

-- O(n) time, O(1) space -- hai biến rolling
fibFast(n):
    if n <= 1: return n
    prev <- 0
    curr <- 1
    for i <- 2 đến n:
        next <- prev + curr
        prev <- curr
        curr <- next
    return curr

Time: O(n)  Space: O(1)
5.3 Đệ quy tổng quát: Deque tường minh thay ngăn xếp JVM
Khi đệ quy không thuộc dạng đuôi hay cây đơn giản (ví dụ duyệt cây DOM, phân tích JSON lồng sâu), dùng Deque làm stack tường minh. Heap lớn hơn thread stack nhiều (heap thường vài GB, stack chỉ 512KB–1MB), nên tràn heap khó xảy ra hơn tràn ngăn xếp.
-- DFS iteration dùng stack tường minh trên heap
-- Tránh tràn ngăn xếp với cây lồng rất sâu (ví dụ 50k cấp từ input không tin cậy).
dfsIterative(root):
    if root = NIL: return
    S <- Stack rỗng
    S.push(root)
    while S không rỗng:
        node <- S.pop()
        process(node)                       -- thăm node
        if node.right != NIL: S.push(node.right)    -- push phải trước
        if node.left  != NIL: S.push(node.left)     -- trái được xử lý trước

Time: O(n)  Space: O(n) -- trên heap thay vì thread stack
6. Các bẫy hay gặp
Bẫy 1: quên base case, tràn ngăn xếp ngay lập tức.
-- Thiếu base case -- đệ quy vô hạn, tràn ngăn xếp ngay
countDown(n):
    return countDown(n-1)   -- quên: if n = 0: return 0

-- Đã sửa: base case tường minh kết thúc đệ quy
countDownFixed(n):
    if n <= 0: return 0     -- base case
    return countDownFixed(n-1)
Đây là lỗi phổ biến nhất và dễ nhất để debug: stack trace sẽ hiển thị cùng một hàm lặp lại hàng nghìn dòng.
Bẫy 2: độ sâu phụ thuộc input từ bên ngoài, mở cửa cho tấn công từ chối dịch vụ.
Hàm flattenJson(node) đệ quy hoạt động tốt với JSON thông thường sâu vài chục cấp. Nhưng kẻ tấn công có thể gửi JSON lồng 50.000 cấp, mỗi cấp push một frame, và máy crash trong mili giây. Nhiều thư viện JSON giới hạn độ lồng mặc định chính là để chặn việc này.
-- Giới hạn độ sâu đệ quy khi input đến từ nguồn bên ngoài
flattenJson(node, depth, result):
    if depth > 100:
        throw IllegalArgumentException("Độ lồng JSON vượt giới hạn: " + depth)
    if node là object:
        for each (key, value) trong node:
            flattenJson(value, depth+1, result)
    else:
        result["leaf_" + depth] <- node.value

Time: O(n)  Space: O(depth)
Bẫy 3: tăng giới hạn stack trông như giải pháp nhưng có giá.
Tăng giới hạn stack từ 512KB lên 8MB giải quyết tràn ngăn xếp tạm thời, nhưng:
Mỗi thread giữ chỗ (reserve) toàn bộ stack đó. Server với 1.000 thread concurrent: 1.000 × 8MB = 8GB stack reserved, còn 1.000 × 512KB chỉ 500MB. Hậu quả: chạy được ít thread hơn, hoặc phải thêm RAM để bù.
Thử ngẫmteam bạn định tăng -Xss từ 512KB lên 8MB để hết lỗi StackOverflowError. Với 1.000 thread concurrent, quyết định đó âm thầm đổi con số nào khác?
7. Dùng ở đâu trong thực tế
Parser JSON/XML và giới hạn độ sâu: nhiều thư viện giới hạn độ lồng mặc định (cỡ vài trăm đến 1.000 cấp tuỳ thư viện). Tự viết recursive parser thì phải thêm bộ đếm độ sâu như ở bẫy 2.
Virtual Threads (JEP 444, Java 21): virtual thread lưu stack trên heap thay vì native thread stack. Khi virtual thread block, runtime chép frame xuống một object trên heap ("continuation") và giải phóng native thread. Nhờ vậy stack của virtual thread co giãn theo nhu cầu thay vì cấp cố định cho từng thread. Đệ quy quá sâu thì vẫn tràn ngăn xếp được.
8. Đào sâu: tài liệu gốc
Spec / reference chính thức:
- JVMS §2.6 — Frames — định nghĩa cấu trúc stack frame: local variable array, operand stack, frame data. Đây là tài liệu gốc về những gì JVM lưu trong mỗi frame.
- JEP 444 — Virtual Threads — mục "Stack" giải thích cụ thể virtual thread stack trên heap và cơ chế continuation. Java 21.
Bài liên quan trong khoá học:
- Stack (Ngăn xếp): cấu trúc dữ liệu nền của Call Stack.
- Stack Frame & Stack Overflow: mổ xẻ vùng nhớ Stack.
- Duyệt đồ thị DFS: đệ quy biến thành duyệt cây/đồ thị.
Đọc thêm: Stack và stack frame. Bài này nói riêng cho JVM, còn bài kia cho thấy stack frame là cơ chế chung của mọi ngôn ngữ compiled/managed, không riêng Java.
9. Tóm tắt
Checklist khi bạn viết hoặc review một hàm đệ quy:
- Có base case rõ ràng chưa? Thiếu base case là nguyên nhân phổ biến nhất gây tràn ngăn xếp.
- Độ sâu có phụ thuộc input từ bên ngoài không? Nếu có, đặt giới hạn độ sâu tường minh hoặc đổi sang Deque trên heap.
- Hàm có dạng đuôi, dạng cây, hay tổng quát? Mỗi dạng có một cách chuyển sang iteration (accumulator + while, DP/biến rolling, Deque).
- Đừng sửa lỗi tràn ngăn xếp bằng cách tăng
-Xsscho mọi thread: mỗi thread đều reserve thêm bộ nhớ. - Virtual threads (Java 21) nới ngưỡng nhưng không xóa được nguy cơ tràn.
10. Tự kiểm tra
- Q1Vì sao JVM không tối ưu tail call (TCO), trong khi Scala và Kotlin có thể chạy tail recursion không giới hạn độ sâu?
- Q2Trong production, độ sâu đệ quy bao nhiêu là an toàn? Điều đó phụ thuộc vào những yếu tố nào?
- Q3Tail recursion và head recursion khác nhau như thế nào về mức dùng stack? Cho ví dụ cụ thể với giai thừa.
- Q4Đoạn pseudocode sau đếm tổng số node trong cây nhị phân. Hãy chuyển sang dạng vòng lặp (iteration).
countNodes(root): if root = NIL: return 0 return 1 + countNodes(root.left) + countNodes(root.right) - Q5Khi nào dùng Deque tường minh thay ngăn xếp runtime tốt hơn? Khi nào vẫn nên dùng đệ quy?
- Q6Tăng giới hạn stack để fix tràn ngăn xếp — khi nào hợp lý, khi nào là giải pháp sai?
Bài tiếp theo: Amortized analysis
Độ phức tạp Big-O từ bản chất — Theta, Omega, amortized intro
Bài tiếpAmortized analysis — ArrayList.add() O(1) dù đôi khi tốn O(n)
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này