Mini-challenge — findCommonElements: naive vs optimized
Bài thực hành khép lại Module 1: viết findCommonElements hai cách (nested loop và hash set), đo benchmark, và thấy vì sao từ timeout xuống còn khoảng 30ms.
Teammate junior của bạn vừa nộp code để tìm phần tử chung giữa hai mảng. Manager test với 1 triệu phần tử mỗi mảng, máy chạy mãi không xong rồi timeout. Manager bảo bạn: "Tối ưu đi."
Bạn nhìn vào code và thấy hai vòng lặp lồng nhau. Bottleneck rõ ràng, nhưng fix thế nào? Và làm sao biết fix xong nhanh hơn bao nhiêu?
Bài này luyện framework 5 bước của bài trước: viết brute force, tìm bottleneck, tối ưu, rồi đo bằng benchmark.
Đề bài
Viết hàm findCommonElements(A, B) trả về mảng các phần tử xuất hiện trong cả hai mảng đầu vào.
Yêu cầu chi tiết
- Input: hai mảng số nguyên A và B. Mỗi mảng có tối đa 1 triệu phần tử.
- Output: mảng chứa các phần tử có mặt trong cả hai mảng. Mỗi phần tử xuất hiện đúng một lần trong output (dedup), không yêu cầu thứ tự.
- Độ phức tạp cần đạt: O(n+m) về thời gian, O(min(n,m)) về bộ nhớ.
Test cases hiển thị
| Input A | Input B | Output |
|---|---|---|
[1,2,3] | [2,3,4] | [2,3] |
[] | [1] | [] |
[1,1,2] | [1,2,2] | [1,2] (dedup) |
[5] | [5] | [5] |
Test ẩn: 1 triệu random int cho mỗi mảng, xem phần benchmark.
Pseudocode khởi đầu
-- TODO: implement findCommonNaive -- mong đợi O(n*m)
function findCommonNaive(A, B):
    throw "TODO"

-- TODO: implement findCommonFast -- mong đợi O(n+m)
function findCommonFast(A, B):
    throw "TODO"
Trước khi gõ, lấy giấy làm tay với bảng test hiển thị: bạn tự tìm phần tử chung của [1,2,3] và [2,3,4] bằng cách nào, và cách đó lặp lại việc gì nhiều nhất? Cách tập thói quen này nằm ở Làm tay trước khi làm máy.
Dành 20–25 phút tự làm trước khi xem gợi ý.
Gợi ý
Brute force là hai vòng lặp lồng nhau: với mỗi phần tử A[i], duyệt toàn bộ B để xem có phần tử bằng không.
-- Khung gợi ý, điền logic vào
-- Time: O(n*m)  Space: O(k) với k là số phần tử chung
function findCommonNaive(A, B):
    result <- Set rỗng (tự dedup)
    for each x trong A:
        for each y trong B:
            if x = y:
                result.add(x)
                break          -- early exit: không cần scan tiếp B
    return result dưới dạng mảng
Với n = m = 1 triệu: n*m = 1 nghìn tỷ phép tính, chắc chắn timeout.
Bottleneck là vòng lặp trong: với mỗi A[i], bạn đang quét tuyến tính toàn bộ B để kiểm tra phần tử có tồn tại không. Chi phí O(m) cho mỗi phần tử của A.
Câu hỏi chính xác: "Có cách nào kiểm tra 'x có trong B không?' với chi phí O(1) thay vì O(m) không?"
Trả lời: Hash set. Nạp toàn bộ B vào hash set một lần, tốn O(m). Sau đó mỗi lookup là O(1).
Đổi lại: bạn dùng thêm O(m) bộ nhớ để bớt O(n*m) thời gian.
Có thể tiết kiệm memory hơn không? Hãy nạp mảng nhỏ hơn vào hash set thay vì luôn nạp B, bộ nhớ giảm từ O(max(n,m)) xuống O(min(n,m)).
Hash set là tối ưu về thời gian. Nhưng nếu cả hai mảng đã được sắp xếp sẵn, có cách không tốn thêm bộ nhớ (nếu chưa sắp xếp thì phải sort bản sao, tốn O(n+m) bộ nhớ như ở lời giải bên dưới):
Sort + 2-pointer: một con trỏ trên A, một trên B. Nếu A[i] = B[j] thì đó là phần tử chung. Nếu A[i] < B[j] thì tăng i. Nếu A[i] > B[j] thì tăng j. O(n+m) thời gian, O(1) bộ nhớ thêm (ngoài output).
Nếu input nằm trong khoảng giá trị nhỏ (ví dụ 0 đến 100): dùng mảng boolean thay hash set, vừa tận dụng cache tốt hơn vừa không tốn chi phí boxing.
Lời giải
Naive O(n*m):
-- Time: O(n*m)  Space: O(k) với k là số phần tử chung
function findCommonNaive(A, B):
    result <- Set rỗng
    for each x trong A:
        for each y trong B:
            if x = y:
                result.add(x)
                break             -- dedup early exit
    return result dưới dạng mảng
Optimized O(n+m):
-- Nạp mảng nhỏ hơn vào hash set để tiết kiệm memory
-- Time: O(n+m)  Space: O(min(n,m))
function findCommonFast(A, B):
    if A.length <= B.length:
        smaller <- A
        larger  <- B
    else:
        smaller <- B
        larger  <- A

    seen <- HashSet(smaller)      -- nạp mảng nhỏ một lần: O(min(n,m))

    result <- Set rỗng
    for each x trong larger:
        if x trong seen:
            result.add(x)         -- dedup tự động

    return result dưới dạng mảng
Giải thích từng điểm:
- Chọn mảng nhỏ hơn cho hash set: O(min(n,m)) bộ nhớ thay vì O(max(n,m)).
- Set cho
result: dedup tự động, không cần kiểm tra trùng thủ công. - Pre-size hash set (khi cài đặt thực tế): tránh rehash khi load factor vượt ngưỡng. Với hash set kích thước
svà load factor 0.75, capacity thực =s / 0.75→ pre-size =s * 4/3 + 1.
Sort + 2-pointer (biến thể: sắp xếp trên bản sao rồi duyệt hai con trỏ):
-- Time: O(n log n + m log m) do sort  Space: O(n+m) cho bản sao
-- Tốt hơn khi input đã sorted sẵn; chậm hơn hash set trên random data
function findCommonTwoPointer(A, B):
    sortedA <- sort(copy(A))
    sortedB <- sort(copy(B))

    result <- []
    i <- 0
    j <- 0
    while i < sortedA.length AND j < sortedB.length:
        if sortedA[i] = sortedB[j]:
            val <- sortedA[i]
            result.append(val)
            -- bỏ qua duplicate liên tiếp để dedup
            while i < sortedA.length AND sortedA[i] = val: i <- i + 1
            while j < sortedB.length AND sortedB[j] = val: j <- j + 1
        else if sortedA[i] < sortedB[j]:
            i <- i + 1
        else:
            j <- j + 1
    return result
Benchmark
-- Benchmark harness (pseudocode, bạn cài trong ngôn ngữ nào cũng được)
function benchmark():
    A <- randomArray(1_000_000, seed=42)
    B <- randomArray(1_000_000, seed=42)

    -- warm up trước khi đo (quan trọng với JVM và JIT)
    repeat 3 times: findCommonFast(A, B)

    t0 <- now()
    result <- findCommonFast(A, B)
    elapsed <- now() - t0
    print "Fast  (n=1M):", elapsed, "ms,", result.length, "phần tử chung"

    -- naive quá chậm ở 1M nên chỉ chạy ở 10k
    A10k <- randomArray(10_000, seed=42)
    B10k <- randomArray(10_000, seed=42)

    repeat 3 times: findCommonNaive(A10k, B10k)

    t0 <- now()
    resultN <- findCommonNaive(A10k, B10k)
    elapsed <- now() - t0
    print "Naive (n=10k):", elapsed, "ms,", resultN.length, "phần tử chung"
Kết quả kỳ vọng (phần cứng hiện đại, runtime đã warm up):
| n | Naive | Fast | Sort+2P | Tăng tốc naive→fast |
|---|---|---|---|---|
| 1k | ~5ms | ~0.1ms | ~0.3ms | ~50x |
| 10k | ~500ms | ~1ms | ~5ms | ~500x |
| 1M | timeout | ~30ms | ~100ms | rất lớn |
Số thực tế phụ thuộc vào máy và runtime. Điều quan trọng là hình dạng đường cong: naive tăng bậc hai, fast tăng tuyến tính.
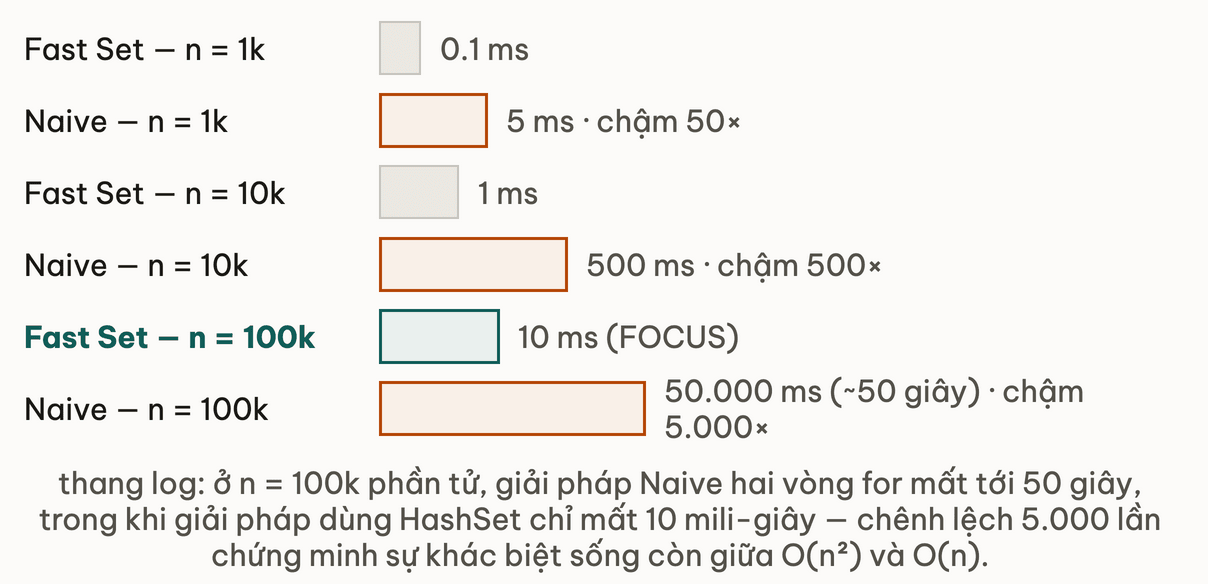
Tại n=1 triệu, naive theo đường cong này lên cỡ hàng triệu ms (hàng giờ) trong khi fast chỉ cỡ chục ms. Các con số trong bảng và biểu đồ chỉ minh hoạ bậc độ lớn, chưa đo trên máy cụ thể.
Bẫy khi benchmark
Bẫy 1: quên warm up runtime trước khi đo.
JVM và nhiều runtime khác không compile code thành native ngay: có JIT tier C1 (biên dịch nhanh) và C2 (biên dịch tối ưu). Lần chạy đầu tiên luôn chậm hơn 2–10x vì phải thông dịch. Đo ngay lần đầu thì kết quả nhiễu, không phản ánh hiệu năng ổn định.
Cách sửa: chạy 3–5 lần warm-up trước khi lấy thời gian (như đoạn pseudocode trên).
Bẫy 2: dùng đồng hồ wall-time độ phân giải thấp.
Một số nền tảng có độ phân giải timer 10–20ms. Đo một hàm chạy 1ms thì kết quả luôn ra 0ms hoặc 10ms, không có giá trị nào ở giữa. Dùng monotonic clock độ phân giải cao (nanosecond): System.nanoTime() trên JVM, time.perf_counter_ns() trên Python, performance.now() trên JavaScript.
-- Đo đúng: monotonic high-resolution clock
t0 <- monotonic_ns()
-- ... chạy hàm ...
elapsed_ms <- (monotonic_ns() - t0) / 1_000_000
Bẫy 3: random seed cố định (42), tiện để tái lập nhưng có mặt trái.
Seed cố định giúp mọi người chạy ra cùng kết quả, tiện cho debug và chia sẻ. Tuy nhiên một kiểu dữ liệu cụ thể có thể làm hash set suy biến (nhiều collision) hoặc làm naive nhanh hơn bình thường (thoát sớm nhiều lần). Nếu benchmark cho production, chạy với nhiều seed khác nhau để xác nhận kết quả nhất quán.
Biến thể để tự thử
Biến thể 1: xử lý song song:
-- Parallel filter trên mảng larger
seenSet <- HashSet(smaller)
result <- parallel_filter(larger, x => x trong seenSet).distinct()
Thử đo xem có nhanh hơn findCommonFast không. Gợi ý trước: song song chỉ có ích khi n đủ lớn và thao tác đủ nặng. Chi phí chia việc và gộp kết quả có thể lớn hơn lợi ích khi n vừa phải và thao tác đơn giản như contains; hãy đo thay vì đoán.
Biến thể 2: input dạng stream (không vừa RAM):
Nếu mảng không vừa RAM (ví dụ 10 tỷ phần tử) thì hash set cũng không dùng được. Gợi ý: Bloom filter xấp xỉ một tập hợp với xác suất dương tính giả (false positive) nhỏ và rất ít bộ nhớ. Các kỹ thuật cùng họ (sketch, sampling) nằm ở module Big Data & Streaming của khoá Thuật toán Ứng dụng. Câu hỏi: trong bài này, false positive ảnh hưởng output thế nào?
Thử ngẫmđổi mảng nhỏ trong bài từ 10 nghìn lên 10 tỷ phần tử, không vừa RAM nữa. Hash set không dùng được, Bloom filter thay thế nó, nhưng bạn phải đánh đổi cái gì để lấy ít bộ nhớ hơn?
Bài liên quan
Bài này tương ứng trực tiếp với ba bài LeetCode:
- 349. Intersection of Two Arrays — dedup, trả về set. Chính là bài này.
- 350. Intersection of Two Arrays II giữ số lần xuất hiện của mỗi phần tử. Cần cách khác: hash map đếm thay hash set.
- 1213. Intersection of Three Sorted Arrays mở rộng sang 3 mảng, input đã sorted nên dùng 3-pointer.
Bạn vừa làm được gì
- Áp framework 5 bước vào một bài thực tế: brute force, tìm bottleneck, hash set, benchmark để verify.
- Nhận ra vòng lặp trong O(m) là bottleneck, đổi O(min(n,m)) bộ nhớ để cắt về O(n+m).
- Đo benchmark đúng cách: clock độ phân giải cao, warm-up runtime, seed cố định.
- Biết 3 bẫy hay gặp khi micro-benchmark.
- Thấy curve thực tế: naive tăng bậc hai, hash set tăng tuyến tính, đúng như lý thuyết Big-O.
Bài tiếp theo: Tổng kết & cheat sheet
Một thư viện thật dùng ý tưởng amortized ở đâu? Chính là
ArrayListcủa Java: mỗi lần đầy, nó nhân dung lượng lên 1.5 lần. Nếu bạn học Java, ArrayList.grow() cho thấy code OpenJDK và lý do chọn con số 1.5x.
Framework giải bài thuật toán — 5 bước biến brute force thành tối ưu
Bài tiếpModule 1 — Tổng kết & cheat sheet: Nền tảng thuật toán
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này