Framework giải bài thuật toán — 5 bước biến brute force thành tối ưu
Framework 5 bước biến bài toán chưa từng gặp thành cách giải viết được thành code: hiểu input, brute force, tìm bottleneck, áp kỹ thuật, verify và biết trước độ phức tạp.
TL;DR: Framework 5 bước: (1) hiểu rõ input/output (n cỡ nào, có duplicate không, output ra sao); (2) viết brute force trước để có kết quả đúng làm mốc đối chiếu (ground truth) và biết độ phức tạp ban đầu; (3) tìm bottleneck, tức thao tác tốn nhất và lặp nhiều nhất; (4) áp kỹ thuật phù hợp như Hashing, Sort + 2-pointer, Sliding window, DP; (5) verify bằng test case, so với brute force và các edge case đã liệt kê. Two Sum đi từ O(n²) brute force xuống O(n) với HashMap: vòng lặp trong thực chất là tìm tuyến tính một complement, nên ta đổi O(n) bộ nhớ để cắt O(n) mỗi vòng. Framework dùng được cả ngoài interview: debug production, system design, code review.
Bạn được hỏi: "Two Sum trên array 1 triệu phần tử, target = 100. Viết lời giải tối ưu." Đầu óc trống rỗng. Không biết bắt đầu từ đâu. Không nhớ "mẹo" nào hợp.
Cảm giác đó không phải vì bạn kém, mà vì không ai dạy quy trình tiếp cận bài mới. Hầu hết tài liệu chỉ cho xem lời giải, không cho xem cách nghĩ ra nó.
Bài này dạy cách nghĩ về một bài toán mới theo quy trình, thay vì trông chờ vào thiên tài hay may mắn. Với framework 5 bước, bạn bắt đầu được từ bất kỳ bài nào, tìm ra cách giải viết được thành code, và biết độ phức tạp của nó trước khi gõ dòng code đầu tiên.
1. Hình dung: bác sĩ chẩn đoán
Bệnh nhân bước vào phòng khám. Bác sĩ giỏi mấy cũng không đoán được bệnh ngay từ cái nhìn đầu tiên, dù đã khám hàng nghìn ca. Họ có quy trình:
Hỏi triệu chứng → xét nghiệm cơ bản → đặt giả thuyết → xét nghiệm chuyên sâu → kết luận điều trị.
Mỗi bước dựa trên kết quả bước trước. Bỏ qua bước nào cũng làm tăng nguy cơ chẩn đoán sai.
Giải bài thuật toán cũng vậy. Không có "thiên tài nhìn vào là biết", chỉ có người đã thuộc quy trình đến mức chạy tự động.
| Chẩn đoán bệnh | Giải bài thuật toán |
|---|---|
| Hỏi triệu chứng, tiền sử bệnh | Hiểu rõ input, output, ràng buộc (constraint) |
| Xét nghiệm cơ bản (máu, X-quang) | Viết brute force chạy được |
| Tìm ra đây là bệnh gì, ở đâu | Tìm bottleneck của brute force |
| Xét nghiệm chuyên sâu, điều trị thử | Áp kỹ thuật tối ưu phù hợp |
| Kiểm tra bệnh nhân sau điều trị | Verify bằng test case biên/stress |
Framework là quy trình, không phải phép màu. Bác sĩ giỏi không đoán bệnh mà có quy trình. Dev giỏi không "biết mẹo" ngay mà có framework.
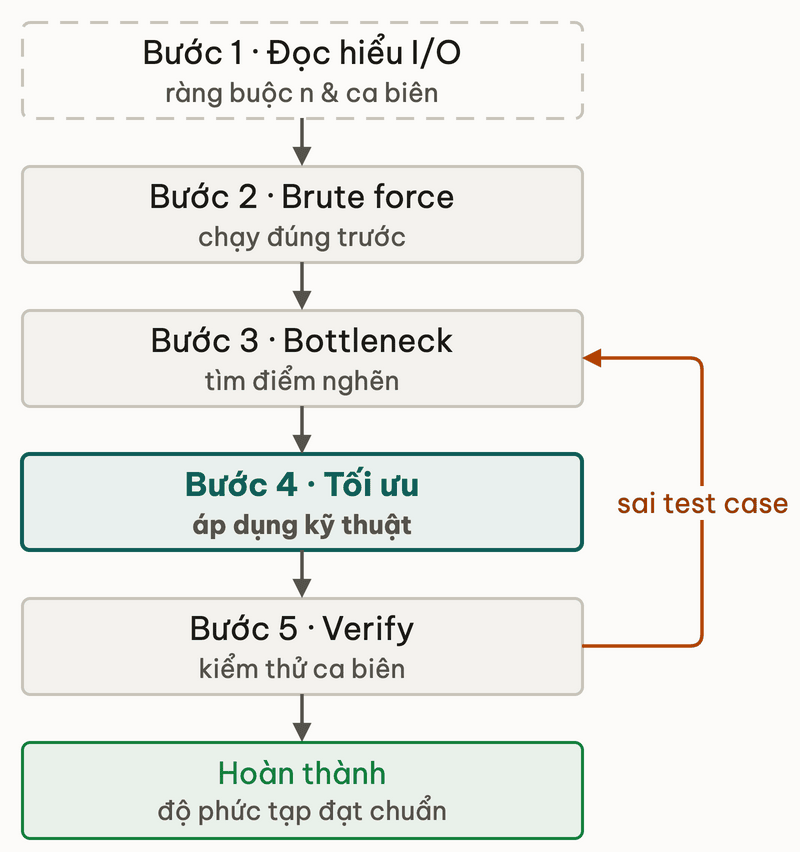
2. Bước 1: hiểu rõ input/output
Sai lầm phổ biến nhất: nhảy vào code khi chưa hiểu đề bài đủ kỹ. Kết quả là giải xong một bài toán khác, hoặc đúng 80% test case và không biết tại sao sai 20% còn lại. Kỹ năng bóc input, output, ràng buộc ra khỏi đề được tập riêng ở Đọc đề bài, còn danh sách ca biên nằm ở Edge case. Chưa quen thì đọc hai bài đó trước.
Những câu hỏi cần trả lời trước khi code bất kỳ dòng nào:
Về input:
ncỡ bao nhiêu? 100? 10.000? 1 triệu? (quyết định độ phức tạp cần đạt)- Có thể âm không? Có duplicate không? Đã sorted chưa?
- Kiểu dữ liệu là gì? Số nguyên hay số thực? Có overflow không?
Về output:
- Trả về index hay value? Một kết quả hay tất cả?
- Nếu không có kết quả, trả về gì?
-1,null, hay mảng rỗng? - Có yêu cầu thứ tự không?
Về edge case:
- Mảng rỗng?
- Chỉ có 1 phần tử?
- Tất cả phần tử giống nhau?
- Giá trị cực đại hay cực tiểu của kiểu số nguyên?
-- Document understanding trước khi code:
-- Input:  A: mảng số nguyên (độ dài từ 1 đến 10^4, không null)
--         target: số nguyên (có thể âm)
-- Output: cặp index [i, j] với i != j và A[i] + A[j] = target
-- Bảo đảm: tồn tại đúng 1 solution
-- Edge:   n = 2 -> phải trả về [0, 1]
Bỏ qua bước này là cách nhanh nhất để giải sai bài toán. "Tôi hiểu rồi" thường là ảo tưởng, nhất là với ràng buộc về tràn số (overflow) hoặc định dạng output không rõ ràng.
3. Bước 2: brute force trước
Sau khi hiểu đề bài, đừng nghĩ tới "tối ưu" ngay. Hãy viết lời giải đơn giản nhất, cái mà ai cũng nghĩ ra. Mẹo là làm tay một ví dụ nhỏ trước, rồi mới viết thành code; cách làm này nằm ở Làm tay trước khi làm máy.
Lý do:
Thứ nhất: brute force cho bạn code chạy được để so sánh kết quả. Khi tối ưu xong, bạn có kết quả đúng làm mốc (ground truth) để đối chiếu.
Thứ hai: đo Big-O của brute force cho bạn biết mức xuất phát: bạn đang cải thiện từ đâu và cần cải thiện bao nhiêu.
Thứ ba: nếu n đủ nhỏ và brute force đủ nhanh với constraint đã cho, bạn không cần tối ưu. Theo nguyên tắc YAGNI (You Aren't Gonna Need It), đừng tối ưu khi chưa biết có cần không.
-- Brute force Two Sum: thử mọi cặp (i, j) với i != j
-- Time: O(n²)  Space: O(1)
twoSumBrute(A, target):
    for i <- 0 đến n-1:
        for j <- i+1 đến n-1:
            if A[i] + A[j] = target:
                return [i, j]
    return [-1, -1]    -- không đến đây theo bảo đảm của đề
Với n = 1 triệu: n² = 1 nghìn tỷ phép tính. Máy chạy khoảng 10⁸–10⁹ phép đơn giản/giây nên mất 1.000 đến 10.000 giây. Không chấp nhận được, cần tối ưu.
Với n = 1.000: n² = 1 triệu, chạy trong vài ms, nên brute force là đủ.
Thử ngẫmbài phỏng vấn ghi rõ n ≤ 2.000. Brute force O(n²) của bạn chạy trong vài ms. Có đáng bỏ thời gian viết bản HashMap phức tạp hơn không?
4. Bước 3: tìm bottleneck
Nhìn vào brute force, tìm phần nào tốn thời gian nhất. Thường là:
Vòng lặp lồng nhau: vòng trong lặp lại việc vòng ngoài đã làm. Có cách dùng thêm bộ nhớ để tránh lặp không?
Tính lại kết quả đã biết: tính lại cùng giá trị nhiều lần (overlapping subproblem → dấu hiệu của DP).
Tìm kiếm tuyến tính trong dữ liệu có thể sort: nếu mảng đã sắp xếp, binary search thay được linear scan.
Tìm kiếm tuyến tính trong tập đã có: nếu bạn đang hỏi "có X trong tập này không?" bằng một vòng lặp, thì bảng băm (hash map/set) trả lời trong O(1).
Với Two Sum brute force:
Outer loop: i từ 0 đến n-1                     -- O(n)
  Inner loop: j từ i+1 đến n-1                 -- O(n)
    Check: A[i] + A[j] = target                -- O(1)

Bottleneck = inner loop: với mỗi i,
ta đang tìm kiếm "target - A[i]"
trong phần còn lại của mảng bằng linear scan.
Câu hỏi đúng: "Có cách nào tìm target - A[i] nhanh hơn O(n) không?"
Nếu lưu các giá trị đã thấy vào bảng băm, lookup từ O(n) xuống O(1). Đây là đánh đổi bộ nhớ lấy thời gian: dùng thêm O(n) bộ nhớ để bớt O(n) mỗi vòng lặp, tổng từ O(n²) xuống O(n). Trong Java, thao tác đếm hoặc gom nhóm quen thuộc với bảng băm thường viết bằng getOrDefault hoặc merge, ví dụ count.merge(x, 1, Integer::sum). Muốn hiểu chúng chạy thế nào bên dưới, đọc HashMap internals.
5. Bước 4: áp kỹ thuật phù hợp
Bốn kỹ thuật hay gặp nhất, bạn sẽ học kỹ từng cái ở các module sau:
Mỗi kỹ thuật trả lời một kiểu bottleneck: hashing đổi tìm tuyến tính thành O(1) lookup (đổi lại tốn O(n) bộ nhớ); sort rồi 2-pointer hoặc binary search hợp bài về cặp/bộ ba/lân cận khi không cần giữ index gốc; sliding window tận dụng tính đơn điệu của dãy; divide & conquer / DP hợp khi bài con trùng lặp, và memoization (lưu kết quả đã tính) giúp không tính lại.
Bảng ghép dạng input với kỹ thuật:
| Dạng input | Dấu hiệu | Kỹ thuật nên thử |
|---|---|---|
| Tìm pair/triplet tổng = target | n vừa, có thể sort | Sort + 2-pointer, hoặc Hashing |
| Kiểm tra phần tử có tồn tại | Lookup nhiều lần | Hash set |
| Tìm complement (target - x) | Một pass | Hash map (value → index) |
| Subarray tổng lớn nhất | Continuous | Kadane (DP 1D) |
| Substring/subarray thỏa điều kiện | Window expand/shrink | Sliding window |
| Mảng sorted, tìm phần tử | Search | Binary search |
| Tất cả tổ hợp/hoán vị | Số trường hợp bùng nổ → cắt tỉa | Backtracking + pruning |
| Subproblem trùng lặp | Đệ quy tự nhiên | DP + memoization |
(Kadane là thuật toán DP 1 chiều tìm subarray có tổng lớn nhất trong O(n): duyệt một lần, tại mỗi vị trí giữ "tổng lớn nhất kết thúc tại đây". Bạn sẽ học kỹ ở module DP.)
Bảng trên là gợi ý, không phải công thức. Quan trọng hơn là hiểu vì sao kỹ thuật đó hợp, không phải học thuộc. Bước 3 sẽ tự dẫn bạn đến đây.
Thử ngẫmbạn đang giải một bài "tìm subarray có tổng lớn nhất", không phải Two Sum. Theo bảng ở mục 5, bốn kỹ thuật kia có áp được không, và kỹ thuật nào mới đúng?
6. Bước 5: verify bằng test case
Lời giải đẹp trên lý thuyết vẫn có thể sai ở trường hợp biên (edge case). Bước này không phải "chạy thử cho chắc" mà là kiểm tra có chủ đích:
Verify trên input nhỏ so với brute force: nếu có brute force từ Bước 2, chạy cả hai trên cùng input n = 5–20 và so sánh output. Nếu khác nhau, tìm ngay lý do.
Test edge case đã xác định ở Bước 1: mảng rỗng, 1 phần tử, tất cả giống nhau, giá trị cực đại/cực tiểu.
Test ở giới hạn lớn nhất của đề: với n = 10⁶, solution có chạy trong thời gian chấp nhận không? Nếu có thể đo thực tế thì đo.
Trace tay 1 ví dụ cụ thể: đừng chỉ đọc code bằng mắt. Trace từng bước với [2, 7, 11, 15], target = 9 và kiểm tra output đúng là [0, 1].
7. Áp framework vào Two Sum: từ O(n²) xuống O(n)
Đây là toàn bộ 5 bước trên một bài cụ thể:
7.1 Bước 1 đến 3: đề, brute force, bottleneck
Input: mảng số nguyên A (ít nhất 2 phần tử), target. Output: cặp index [i, j] với i != j và A[i] + A[j] = target, có đúng 1 lời giải. Brute force thử mọi cặp bằng hai vòng lặp lồng, O(n²) time, O(1) space, code đã có ở mục 3. Với n = 10⁶ không chấp nhận được.
Bottleneck là vòng lặp trong: nó quét tuyến tính để tìm target - A[i], mỗi lần O(n). Nếu lưu giá trị đã thấy vào bảng băm, mỗi lần tìm xuống O(1).
7.2 Bước 4: áp kỹ thuật, ba cách làm
Cách 1: bảng băm (O(n) time, O(n) space)
-- One pass: với mỗi phần tử, kiểm tra complement trong map trước khi thêm
-- Time: O(n)  Space: O(n)
twoSumHash(A, target):
    M <- Map rỗng   -- lưu value -> index
    for i <- 0 đến n-1:
        complement <- target - A[i]
        if complement trong M:
            return [M[complement], i]
        M[A[i]] <- i
    return [-1, -1]   -- không đến đây theo bảo đảm
Duyệt một lượt: với mỗi phần tử, kiểm tra complement có trong map không; nếu không thì thêm vào. Không cần hai vòng lặp riêng. Chạy tay với A = [3, 2, 4], target = 6 (đây là một bảng trace, nếu chưa quen đọc thì xem Bảng trace):
| i | A[i] | complement | M trước khi tra | Kết quả |
|---|---|---|---|---|
| 0 | 3 | 3 | {} | không có, thêm 3 → 0 |
| 1 | 2 | 4 | {3 → 0} | không có, thêm 2 → 1 |
| 2 | 4 | 2 | {3 → 0, 2 → 1} | có, trả về [M[2], 2] = [1, 2] |
Ở dòng đầu, complement của 3 cũng là 3, nhưng M còn rỗng nên phần tử không tự ghép với chính nó. Đó là lý do phải tra M trước rồi mới thêm.
Cách 2: sort + 2-pointer (O(n log n) time, O(n) space nếu cần giữ index)
-- Sort kèm index gốc, sau đó 2 pointer hội tụ từ 2 đầu
-- Time: O(n log n) do sort  Space: O(n) cho bản sao có index
-- Dùng khi: không cần index, chỉ cần values; hoặc bảng băm bị cấm
twoSumTwoPointer(A, target):
    -- Ghép mỗi giá trị với index gốc
    indexed <- [(A[0], 0), (A[1], 1), ..., (A[n-1], n-1)]

    -- Sắp xếp theo giá trị.
    -- QUAN TRỌNG: dùng so sánh chuẩn (Integer.compare), KHÔNG trừ a-b:
    -- trừ tràn số khi giá trị vượt phạm vi số nguyên (ví dụ Integer.MIN_VALUE và Integer.MAX_VALUE)
    sort indexed theo indexed[i].value tăng dần

    left <- 0
    right <- n - 1
    while left < right:
        s <- indexed[left].value + indexed[right].value
        if s = target:
            i <- min(indexed[left].index, indexed[right].index)
            j <- max(indexed[left].index, indexed[right].index)
            return [i, j]
        else if s < target: left <- left + 1   -- cần tổng lớn hơn
        else:               right <- right - 1  -- cần tổng nhỏ hơn
    return [-1, -1]
2-pointer hoạt động vì sau sort, nếu tổng nhỏ hơn target thì di chuyển left sang phải (tăng giá trị), nếu lớn hơn thì di chuyển right sang trái (giảm giá trị). Mỗi bước loại đi ít nhất 1 phần tử.
So sánh ba cách:
| Cách làm | Time | Space | Giữ index gốc | Khi nào dùng |
|---|---|---|---|---|
| Brute force | O(n²) | O(1) | Có | n nhỏ (dưới 1.000), code cần đơn giản tuyệt đối |
| Bảng băm | O(n) | O(n) | Có | Đa số trường hợp: tối ưu cả time lẫn độ dễ đọc |
| Sort + 2-pointer | O(n log n) | O(n) | Cần gói kèm index | Khi không cần index, chỉ cần values; hoặc khi bảng băm bị cấm |
7.3 Bước 5: Verify
-- Test cases để verify:
-- Normal:   [2,7,11,15], target=9    -> [0,1]
-- Small:    [3,3], target=6          -> [0,1]  (duplicate values, different indices)
-- Negative: [-1,-2,-3,-4,-5], target=-8 -> [2,4]
-- Complement: [0,4,3,0], target=0   -> [0,3]

-- Chạy cả twoSumHash và twoSumBrute trên 4 test case trên -- kết quả phải khớp
8. Các bẫy hay gặp
Bẫy 1: tối ưu sớm khi chưa có brute force chạy được.
Nhảy vào solution bảng băm mà chưa có brute force để so sánh là đặt cược rằng mình đúng ngay lần đầu. Có bug thì không có gì để đối chiếu. Brute force là lưới an toàn, đừng bỏ.
Bẫy 2: nhận pattern sai, thấy mảng là nghĩ binary search, thấy pair là nghĩ bảng băm.
Nhận dạng bài quá nông làm bạn áp sai kỹ thuật. Binary search đòi hỏi mảng đã sắp xếp và bài toán có tính đơn điệu (monotonic). Bảng băm hợp khi cần lookup complement, không phải mọi bài pair đều vậy. Luôn đi qua Bước 3 trước khi chọn kỹ thuật.
Bẫy 3: quên test edge case, solution đẹp nhưng sai trên input biên.
Lời giải bảng băm cho Two Sum sẽ sai nếu vô tình để i == j trong kết quả. Trường hợp [3, 3], target = 6 — phải trả về [0, 1], không phải [0, 0]. Bug này chỉ xuất hiện khi test duplicate value. Không test edge case thì dù thuật toán đúng về lý thuyết, bạn vẫn có thể trượt phỏng vấn hoặc gây sự cố production.
Thử ngẫmcode review của bạn pass hết test case thường nhưng fail với input [3, 3], target = 6. Theo bẫy 3, bug đó nằm ở bước nào trong 5 bước?
9. Dùng ở đâu trong thực tế
Phỏng vấn: nhiều nhà tuyển dụng chấm theo bốn chiều: hướng giải, code, phân tích độ phức tạp, và việc tự test ca biên. Framework 5 bước phủ đủ cả bốn, nên ứng viên chỉ code nhanh mà không nói được bottleneck thường mất điểm dù code đúng.
Production debug dùng đúng quy trình này. Gặp slow query: bảng bao nhiêu row (bước 1)? Hiện đang full table scan hay N+1 query (bước 2)? Chỗ tốn nằm ở CPU, I/O hay network (bước 3)? Sửa bằng index, cache hay batch (bước 4)? Kiểm bằng explain plan và đo lại (bước 5). Nếu chưa quen đọc plan, xem định dạng EXPLAIN: bài đó chỉ cách tìm dòng tốn nhất, chính là bước "tìm bottleneck".
10. Đào sâu: tài liệu gốc
Tài liệu tham khảo:
- Steven Skiena — "The Algorithm Design Manual" — các mục "War Story" kể lại bài toán thực tế và cách tiếp cận từng bước.
- Jon Bentley — "Programming Pearls", Column 1 (Cracking the Oyster) — Column 1 là case study kinh điển: bài sorting 10 triệu số với 1 MB RAM. Bentley dẫn từng bước từ cách đơn giản đến cách tối ưu, rất gần tinh thần của framework 5 bước.
- George Polya — "How to Solve It" (1945) — Framework gốc cho problem-solving trong toán học: hiểu bài toán → lập kế hoạch → thực hiện kế hoạch → nhìn lại. Hơn 80 năm tuổi nhưng vẫn là nền tảng; framework trong bài này đi cùng tinh thần đó.
11. Tóm tắt
Mang theo khi gặp bài mới:
- Đọc đề xong, viết ra input, output và các edge case trước khi gõ code.
- Có brute force chạy được trước, rồi mới tính chuyện tối ưu. Nếu
nnhỏ thì dừng ở đó. - Hỏi "thao tác nào tốn nhất, lặp lại nhiều nhất?" thay vì "tối ưu cái gì?".
- Dùng bảng dạng bài ở mục 5 để chọn kỹ thuật. Với Two Sum, bảng băm cho O(n); sort + 2-pointer cho O(n log n), nhớ so sánh bằng comparator chuẩn thay vì trừ để khỏi tràn số.
- Verify bằng cách so với brute force trên input nhỏ, thử các edge case, và trace tay một ví dụ. Cùng quy trình này dùng được khi debug production và review code.
12. Tự kiểm tra
- Q1Vì sao luôn viết brute force trước, không nhảy thẳng vào solution tối ưu?
- Q2Bước 3 là tìm bottleneck. Làm sao tìm được nếu code chưa chạy và chưa có profiler?
- Q3Cho bài 'tìm 3 số trong mảng có tổng bằng target'. Áp 5 bước framework.
- Q4Đánh đổi bộ nhớ lấy thời gian: khi nào không đáng?
- Q5Interview hỏi 'max profit từ 1 giao dịch mua/bán cổ phiếu'. Framework 5 bước dẫn đến kỹ thuật nào?
- Q6Production hot path đang chạy được nhưng tốn 5 giây mỗi request. Có nên tối ưu không? Cân nhắc gì trước khi quyết định?
Bài tiếp theo: Mini-challenge: naive vs optimized benchmark
Cache locality — Vì sao mảng nhanh hơn linked list 25 lần
Bài tiếpMini-challenge — findCommonElements: naive vs optimized
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này