Case Study: LMAX Disruptor — Ring buffer thắng BlockingQueue
LMAX Disruptor thắng BlockingQueue nhờ ring buffer cấp phát sẵn, sequence counter, đệm cache line và wait strategy. Bài giải thích từng kỹ thuật theo bậc.
TL;DR: LMAX Disruptor nhanh hơn ArrayBlockingQueue cỡ chục lần nhờ bốn kỹ thuật cộng dồn: (1) ring buffer cấp phát sẵn nên chạy ổn định không tạo object mới, GC không có việc gì để làm; (2) sequence counter chỉ tăng, và khi chỉ có một producer thì không cần CAS; (3) đệm cache line quanh mỗi Sequence để hai core không tranh nhau một cache line (false sharing); (4) wait strategy cho consumer chọn cách chờ không dùng lock. Pipeline nhiều consumer dùng chung một ring buffer với SequenceBarrier, không cần queue giữa các stage.
LMAX Exchange (London) xây dựng hệ thống khớp lệnh tài chính cần xử lý hàng triệu order mỗi giây với độ trễ rất thấp và ổn định. Đây là ràng buộc cứng: độ trễ vọt lên một lần là lệnh có thể thất bại.
Họ thấy queue có sẵn của JDK không đủ: lock gây tranh chấp, mỗi phần tử đẩy vào tốn một lần cấp phát, và độ trễ có những cú vọt khó lường. Nhóm LMAX (Martin Thompson, Dave Farley, Michael Barker và đồng nghiệp) tự thiết kế Disruptor. Trong bài báo của họ, độ trễ trung bình mỗi bước trong một pipeline ba stage là khoảng 52 nanosecond, so với khoảng 32.757 nanosecond của ArrayBlockingQueue.
Bài này ghép ring buffer (bài 05), cache locality (Module 1) và cấp phát sẵn có chi phí chia đều (amortized) thành một thiết kế chạy được trong hệ thống thật. Vì có khá nhiều khái niệm mới (false sharing, CAS, wait strategy), mỗi khái niệm đều được giải thích từng bước trước khi dùng. Đây là bài tổng hợp cuối của Module 2.
1. Thông tin dự án
Dự án: LMAX Disruptor (open-source)
Repo: https://github.com/LMAX-Exchange/disruptor (Apache License 2.0)
Paper: "Disruptor: High performance alternative to bounded queues" — Martin Thompson, Dave Farley, Michael Barker, Patricia Gee, Andrew Stewart (LMAX, 2011). https://lmax-exchange.github.io/disruptor/disruptor.html
Ai đang dùng: Log4j 2 (async logger) và nhiều hệ thống độ trễ thấp khác.
2. Vấn đề LinkedBlockingQueue không giải được
ArrayBlockingQueue và LinkedBlockingQueue là lựa chọn mặc định cho mẫu producer-consumer trong Java (xem Blocking queues): an toàn giữa các thread, có giới hạn kích thước, đủ API. Nhưng bên trong có bốn nguồn chi phí cộng dồn:
Tranh chấp lock: put() và take() dùng ReentrantLock, mỗi lúc chỉ một thread được vào đoạn code được bảo vệ (critical section). Phần lớn thời gian các thread chờ lock chứ không làm việc thật.
Áp lực lên GC: LinkedBlockingQueue tạo một Node mới cho mỗi put(), nên GC phải liên tục thu hồi, và mỗi lần GC dừng chương trình là một cú vọt độ trễ. (ArrayBlockingQueue không tạo Node, nhưng vẫn bị lock và các chi phí dưới đây.)
Lần theo pointer và cache miss: cấu trúc liên kết khiến prefetcher bó tay, như bài cache locality đã đo.
False sharing: đây là khái niệm mới, nên đi từng bước.
- CPU không nạp từng biến lẻ vào cache mà nạp cả một khối 64 byte gọi là cache line. Hình dung cache line như một tờ giấy ghi chú dùng chung: ai muốn đọc một dòng cũng phải cầm cả tờ.
- Mỗi core có bản sao tờ giấy riêng. Khi core A ghi vào một dòng, mọi bản sao của tờ đó ở các core khác bị đánh dấu hết hạn.
- Giả sử
head(producer ghi) vàtail(consumer ghi) tình cờ nằm trên cùng một tờ. Producer ghiheadthì bản của consumer hết hạn, dù consumer chỉ quan tâmtail. Consumer phải nạp lại tờ giấy từ RAM, rồi khi nó ghitailthì bản của producer lại hết hạn. Hai bên liên tục giành giật một tờ giấy dù không ai đụng đến dữ liệu của nhau.
Đó là false sharing: tranh chấp "giả", vì hai biến độc lập về logic. Cơ chế chi tiết ở bài False sharing.
3. Bốn trụ cột thiết kế của Disruptor
3.1 Ring buffer cấp phát sẵn: GC không phải dọn gì khi chạy ổn định
Disruptor dùng ring buffer (circular array) với kích thước cố định là luỹ thừa của 2. Khác LinkedBlockingQueue, toàn bộ N ô được cấp phát sẵn lúc khởi tạo, nên khi chạy không tạo object mới nào.
Lúc khởi động, một EventFactory được gọi đúng bufferSize lần để tạo sẵn mọi ô (xem skeleton ở mục 6). Sau đó không tạo thêm object nào khi chạy ổn định.
Khi producer muốn publish một event, thay vì tạo object mới, nó sửa trực tiếp (in-place) vào ô đã có:
-- Publish event: không cấp phát, chỉ sửa ô sẵn có
publish(orderId, price, quantity):
    seq <- ring.next()           -- claim sequence kế tiếp
    try:
        event <- ring.get(seq)   -- lấy object cấp phát sẵn tại ô đó
        event.orderId  <- orderId   -- sửa trực tiếp
        event.price    <- price
        event.quantity <- quantity
    finally:
        ring.publish(seq)        -- cho consumer thấy ô này
        -- finally đảm bảo publish luôn xảy ra dù có exception
Object trong mỗi ô tồn tại suốt vòng đời ring buffer và được dùng lại ở mỗi vòng. Chi phí tạo N object được chia cho vô số lần publish nên chi phí trung bình mỗi lần tiến về 0, cùng ý tưởng với amortized analysis.
Vì ô được dùng lại, consumer phải xoá các field sau khi xử lý xong. Nếu quên, field cũ của event trước sẽ lọt sang lần publish kế tiếp, làm hỏng dữ liệu mà không báo lỗi, và rất khó debug.
3.2 Sequence counter thay int index
Disruptor không dùng index int đơn giản. Thay vào đó, cả producer và consumer theo dõi một số thứ tự (sequence number) chỉ tăng, mãi mãi không quay về 0. Ô thật sự trong ring buffer được tính bằng sequence & (bufferSize - 1), chính là mẹo bit ở bài 05. Nhánh nhiều producer dùng CAS, nên ta giải thích CAS ngay dưới đây.
CAS (compare-and-set) từng bước. CAS là một lệnh CPU nguyên tử: "nếu giá trị hiện tại vẫn là X thì đổi thành Y và báo thành công, nếu khác X thì không đổi gì và báo thất bại". Hai producer cùng muốn claim ô kế tiếp, giá trị sequence đang là 5:
| Bước | Producer A | Producer B | Sequence |
|---|---|---|---|
| 1 | đọc 5 | đọc 5 | 5 |
| 2 | CAS(5 → 6) thành công, claim ô 6 | 6 | |
| 3 | CAS(5 → 6) thất bại vì giá trị đã là 6 | 6 | |
| 4 | đọc lại 6, CAS(6 → 7) thành công, claim ô 7 | 7 |
Không ai claim trùng ô và không ai phải khoá. Muốn tìm hiểu sâu hơn, đọc Atomic và CAS.
-- Sequence: bọc một volatile long, chỉ tăng
Sequence:
    volatile value <- 0
    -- (padding bọc quanh — xem section 3.3)

-- Một producer: chỉ cần tăng 1, không cần CAS
claimSequence_single():
    next <- producerSequence.value + 1
    producerSequence.value <- next
    return next

-- Nhiều producer: dùng CAS để không claim trùng nhau
claimSequence_multi():
    loop:
        current <- producerSequence.value
        next    <- current + 1
        if producerSequence.compareAndSet(current, next):
            return next   -- claim thành công
        -- thua race thì thử lại
Consumer chỉ đọc khi sequence đã sẵn sàng: SequenceBarrier giữ consumer lại cho đến khi sequence của producer đạt đủ giá trị. Không có lock nào tham gia.
3.3 Cache-line padding tránh false sharing
Như đã giải thích ở mục 2, nếu hai biến nằm trong cùng 64 byte thì ghi vào biến này làm hết hạn cache của biến kia trên core khác.
Disruptor xử lý bằng cách đệm (padding) mỗi Sequence với 7 long (56 byte) ở hai phía:
-- Sequence với đệm cache line làm thủ công
-- Mỗi long = 8 byte. 7 long trước + value + 7 long sau = 120 byte
-- Đảm bảo value nằm trên một cache line riêng

Sequence:
    p1, p2, p3, p4, p5, p6, p7 <- 0L   -- đệm trước: 56 byte
    volatile value              <- 0L   -- sequence thật: 8 byte
    p9, p10, p11, p12, p13, p14, p15 <- 0L  -- đệm sau: 56 byte
Nhờ đệm này, mỗi Sequence chiếm riêng một cache line, nên producer ghi vào không ảnh hưởng đến cache line của sequence bên consumer.
Java 8 có annotation @Contended (JEP 142) để JVM tự thêm đệm quanh field. Disruptor ra đời trước đó nên đệm thủ công. Lưu ý annotation này chủ yếu dành cho code của JDK, code ứng dụng muốn dùng phải bật cờ -XX:-RestrictContended.
3.4 Wait strategy: không lock, không block
Consumer luôn phải chờ khi chưa có event mới, và có nhiều cách chờ. Hình dung bạn đợi xe buýt: đứng nhìn chằm chằm đầu đường suốt (BusySpin, bắt được xe ngay nhưng không làm gì khác được), thỉnh thoảng nhìn rồi nhường chỗ cho người khác (Yielding), hay ngồi quán chợp mắt đặt báo thức (Blocking, tiết kiệm sức nhưng bị đánh thức thì mất thời gian). Disruptor cho bạn chọn, đánh đổi giữa độ trễ và mức dùng CPU:
| Strategy | Cơ chế | Độ trễ | Mức dùng CPU | Khi nào dùng |
|---|---|---|---|---|
BusySpinWaitStrategy | Quay vòng liên tục kiểm tra sequence | Thấp nhất | 100% một core | HFT, có core riêng |
YieldingWaitStrategy | Quay N lần rồi Thread.yield() | Thấp | Cao nhưng chịu nhường core | Throughput cao, dùng chung core |
SleepingWaitStrategy | Quay, nhường, rồi parkNanos(1) | Trung bình | Trung bình | Xử lý nền, tải hỗn hợp |
BlockingWaitStrategy | ReentrantLock + Condition.await() | Cao nhất | Thấp (ngủ khi rảnh) | Cần tiết kiệm CPU |
YieldingWaitStrategy cân bằng tốt giữa throughput và CPU. BusySpinWaitStrategy chỉ nên dùng khi có core CPU riêng và độ trễ là ưu tiên tuyệt đối, thường trong hệ thống giao dịch tần suất cao (HFT).
4. Sơ đồ data flow và sequence barrier
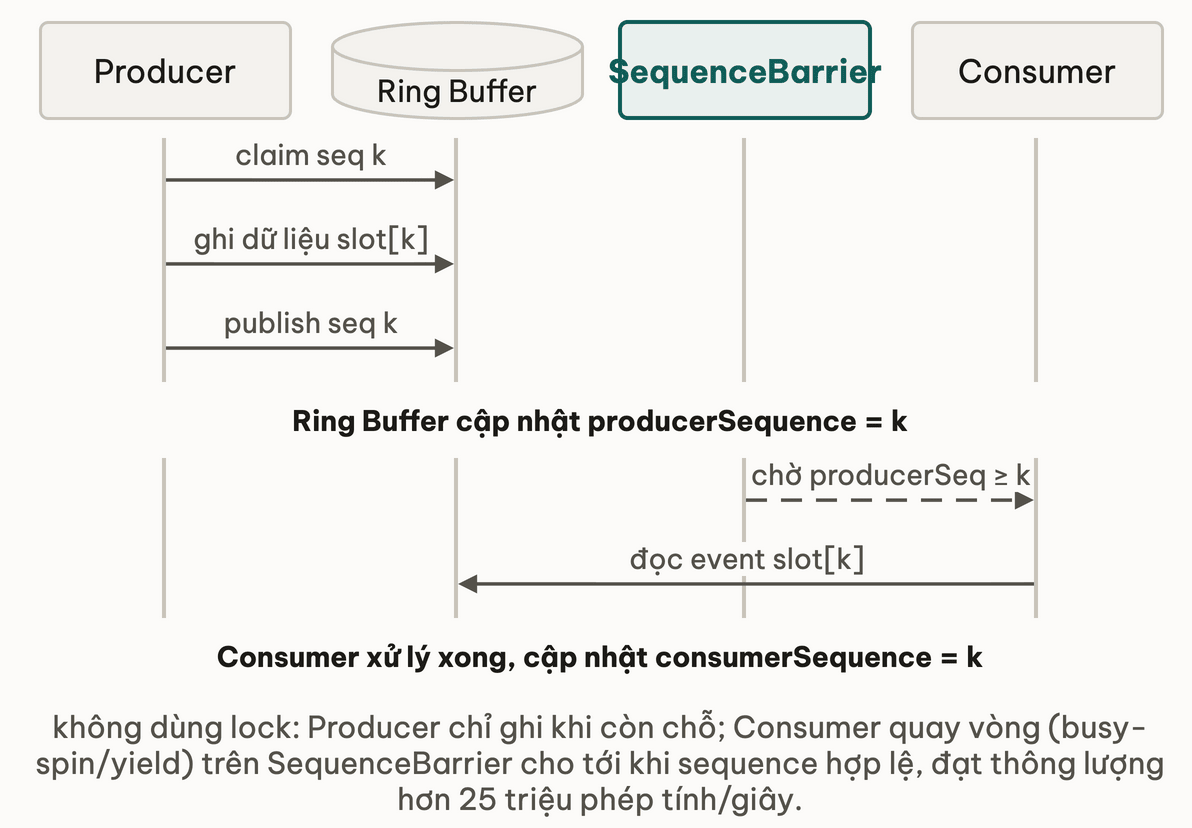
Consumer không bao giờ đọc ô cho đến khi producer publish sequence tương ứng. Không có lock: consumer quay vòng hoặc nhường core theo wait strategy đã chọn.
Thử ngẫmconsumer chỉ đọc ô sau khi producer publish sequence tương ứng, không lock, chỉ quay vòng hoặc nhường core. Nếu chọn sai wait strategy khiến consumer quay liên tục, chi phí đó sẽ lộ ra ở đâu trong hệ thống chạy thật?
5. Multi-consumer pipeline pattern
-- Pipeline nhiều stage dùng một ring buffer duy nhất
-- Không có queue giữa các stage

Producer --> [Ring Buffer] --> Consumer A (validation)
                                    |
                              SequenceBarrier A
                                    |
                                    v
                              Consumer B (risk check)
                                    |
                              SequenceBarrier B
                                    |
                                    v
                              Consumer C (persistence)
Consumer B chỉ đọc event sau khi Consumer A đã xử lý xong. Disruptor diễn tả sự phụ thuộc này bằng cách nối các SequenceBarrier với nhau, không có queue riêng giữa các stage.
-- Khai báo pipeline (pseudocode theo API của Disruptor):
disruptor.handleEventsWith(validator)
         .then(riskChecker)
         .then(persister, replicator)  -- persister và replicator chạy song song
Stage 1 là validator kiểm tra field của order. Stage 2 là riskChecker, chỉ chạy sau khi validator xong. Stage 3 gồm persister ghi xuống storage và replicator đẩy sang node dự phòng: hai việc này không phụ thuộc nhau nên chạy song song, nhưng đều chờ riskChecker.
Toàn bộ pipeline dùng một ring buffer duy nhất, không có queue nào giữa các stage. Disruptor theo dõi sequence của từng consumer; một event chỉ được coi là đã dùng xong (ô sẵn sàng cho producer ghi đè) khi consumer chậm nhất đã xử lý xong.
Thử ngẫmpipeline dùng một ring buffer duy nhất, không có queue riêng giữa các stage. Nhóm bạn thêm một stage notifier chạy sau persister; lời gọi .then() đó viết tiếp ra sao?
6. Skeleton sử dụng Disruptor
-- Cấu trúc event (ô cấp phát sẵn)
OrderEvent:
    orderId  <- 0
    price    <- 0.0
    quantity <- 0

    -- Consumer PHẢI gọi hàm này sau khi xử lý xong
    clear():
        orderId  <- 0
        price    <- 0.0
        quantity <- 0

-- Khởi tạo rồi chạy
main():
    bufferSize <- 1024   -- phải là luỹ thừa của 2

    disruptor <- Disruptor(
        factory    = OrderEvent::new,      -- cấp phát sẵn 1024 ô
        bufferSize = bufferSize,
        threadFactory,
        ProducerType.SINGLE,               -- một producer: không cần CAS
        YieldingWaitStrategy               -- quay + nhường core: độ trễ thấp
    )

    -- Đăng ký consumer
    disruptor.handleEventsWith((event, sequence, endOfBatch) ->
        xử lý event.orderId tại sequence
        event.clear()   -- PHẢI clear sau khi xử lý
    )

    disruptor.start()
    ring <- disruptor.getRingBuffer()

    -- Publish 1 triệu event, không cấp phát object nào trong vòng lặp
    for i <- 0 đến 999_999:
        seq <- ring.next()       -- claim sequence (chờ nếu consumer quá chậm)
        try:
            event <- ring.get(seq)  -- lấy ô cấp phát sẵn
            event.orderId  <- i
            event.price    <- 100.0 + i * 0.01
            event.quantity <- 10
        finally:
            ring.publish(seq)    -- PHẢI nằm trong finally, tránh deadlock nếu có exception

    disruptor.shutdown()
Hai điểm đáng chú ý: ring.next() chặn producer khi ring buffer đầy (backpressure tự nhiên: bên nhận chậm thì bên gửi phải chậm theo), và ring.publish(seq) phải nằm trong finally, vì nếu exception xảy ra mà không publish thì sequence bị kẹt và pipeline đứng mãi.
7. Benchmark thực tế
Bài báo của LMAX so Disruptor với ArrayBlockingQueue. Số liệu trong bản hiện hành của bài báo:
| Workload | ArrayBlockingQueue | Disruptor |
|---|---|---|
| Throughput, 1 producer 1 consumer | ~20,9 triệu ops/s | ~160 triệu ops/s |
| Throughput, pipeline 1 producer 3 consumer | ~5,2 triệu ops/s | ~101 triệu ops/s |
| Độ trễ trung bình mỗi bước (pipeline ba stage) | ~32.757 ns | ~52 ns |
| Độ trễ p99 | ~2.097.152 ns | ~128 ns |
Chênh lệch từ cỡ 8 lần đến cỡ 20 lần về throughput, và hàng trăm lần về độ trễ. Đặc biệt pipeline nhiều consumer là chỗ queue thông thường tụt mạnh, vì mỗi stage thêm một lượt tranh chấp lock.
Số liệu đo trên phần cứng cụ thể, có core riêng, JIT đã nóng. Hệ thống thật của bạn sẽ thấp hơn, nhưng khoảng cách tương đối giữa Disruptor và BlockingQueue vẫn cùng bậc độ lớn. Muốn kết luận cho hệ thống của bạn thì phải tự đo.
8. Lỗi hay gặp khi chạy thật
Bẫy 1: Consumer chậm làm producer bị chặn
Ring buffer có kích thước cố định. Nếu consumer xử lý chậm hơn producer, ring buffer đầy và ring.next() chờ mãi. Đây là backpressure đúng thiết kế, nhưng nếu không giám sát, thread producer bị đứng mà không ai được báo.
-- Thay vì ring.next() chờ cho tới khi có chỗ, dùng tryNext để không chờ:
try:
    seq <- ring.tryNext()      -- ném exception ngay nếu ring buffer đầy
    try:
        event <- ring.get(seq)
        event.orderId <- orderId
    finally:
        ring.publish(seq)
catch InsufficientCapacityException:
    -- ring buffer đầy -- báo động, bỏ event, hoặc ép bên gửi phía trước chậm lại
    metrics.increment("disruptor.producer.rejected")
Hãy theo dõi chênh lệch giữa producerSequence và consumerSequence: khoảng cách lớn dần liên tục nghĩa là consumer đang chậm.
Bẫy 2: Quên event.clear() sau khi consume
Ô được dùng lại sau mỗi vòng, nên nếu consumer không xoá field, event kế tiếp mang theo field cũ từ vòng trước: dữ liệu hỏng mà không báo lỗi. Luôn gọi event.clear() ngay sau khi xử lý xong.
Bẫy 3: Cấu hình SINGLE producer trong khi thực tế có nhiều thread publish
ProducerType.SINGLE không dùng CAS, nên nhanh hơn nhưng không an toàn khi nhiều thread gọi ring.next() cùng lúc: hai thread có thể claim cùng một sequence và làm hỏng dữ liệu mà không có exception nào. Loại bug này rất khó tái hiện trong test. Có nhiều thread publish thì phải dùng ProducerType.MULTI (claim bằng CAS).
Bẫy 4: Chọn wait strategy không phù hợp
BusySpinWaitStrategy tốn 100% CPU trên core của consumer. Nếu container bị giới hạn CPU (ví dụ --cpus=2) mà chạy 4 consumer BusySpin, các thread tranh nhau phần CPU được cấp, throughput giảm và độ trễ tăng, ngược hẳn mục đích. Chỉ dùng BusySpin khi consumer có core riêng. Trên cloud chạy container, Yielding hoặc Sleeping hợp hơn.
Thử ngẫmBẫy 4 chỉ ra BusySpinWaitStrategy ăn 100% CPU của một core. Trong container giới hạn --cpus=2 chạy 4 consumer thread, đổi sang YieldingWaitStrategy cải thiện được điều gì cụ thể?
9. Các queue throughput cao khác
Disruptor không phải lựa chọn duy nhất. JCTools là bộ queue lock-free (SPSC, MPSC, SPMC, MPMC) nhẹ hơn, hợp khi chỉ cần một queue đơn giản thay ConcurrentLinkedQueue hay ArrayBlockingQueue. Chronicle Queue lưu bền xuống đĩa bằng memory-mapped file. Chọn Disruptor khi pipeline có nhiều stage phụ thuộc nhau, chạy trên JVM, và bạn muốn tự chọn wait strategy và kiểu producer.
10. Đào sâu: tài liệu gốc
Paper và spec gốc:
- Disruptor paper — Martin Thompson et al., bài báo gốc mô tả thiết kế ring buffer, sequence barrier và phương pháp benchmark.
- LMAX Disruptor GitHub Wiki, hướng dẫn bắt đầu và các mẫu nhiều producer/nhiều consumer.
- JEP 142 — Reduce Cache Contention in Specified Fields, annotation
@Contended. - Martin Thompson — "Mechanical Sympathy" blog, loạt bài về thiết kế phần mềm hiểu phần cứng: cache line, memory barrier.
Bài liên quan trong khoá học: Cache locality, Circular buffer, Amortized analysis, ArrayList.grow().
Đọc thêm: Tư duy stream — Disruptor là một cách làm stream processing ngay trong một tiến trình (ring buffer trên một máy); bài đó mở rộng cùng tư duy "xử lý sự kiện liên tục" lên nhiều máy với Kafka và các broker dựa trên log.
11. Tóm tắt
- BlockingQueue chậm vì bốn nguồn chi phí cộng dồn: tranh chấp lock, cấp phát object, cache miss do con trỏ, và false sharing.
- Ring buffer cấp phát sẵn được dùng lại mãi, nên chạy ổn định thì GC gần như không có việc. Vì ô được dùng lại, consumer phải
clear()field sau khi xử lý. - Sequence counter chỉ tăng: một producer không cần CAS, nhiều producer dùng CAS. Đệm cache line quanh
Sequencetránh false sharing. - Wait strategy chọn cách chờ của consumer:
BusySpin(độ trễ thấp nhất, tốn 100% một core),Yielding,Sleeping,Blocking(tiết kiệm CPU nhất). - Bẫy khi chạy thật:
ProducerType.SINGLEvới nhiều thread publish làm hỏng dữ liệu âm thầm; consumer chậm mà không giám sát làm producer đứng.
12. Tự kiểm tra
- Q1Vì sao Disruptor đạt zero GC pressure trong steady state trong khi LinkedBlockingQueue không thể?
- Q2False sharing là gì? Tại sao padding 7 long trước và 7 long sau mỗi Sequence giải quyết được vấn đề này?
- Q3So sánh BusySpinWaitStrategy và BlockingWaitStrategy về độ trễ và mức dùng CPU. Khi nào chọn cái nào trong hệ thống chạy thật?
- Q4ProducerType.SINGLE và ProducerType.MULTI trong Disruptor khác nhau ở cơ chế nào? Chọn sai thì gây hại gì?
- Q5Consumer chậm trong Disruptor được xử lý khác LinkedBlockingQueue thế nào? Hệ quả cho producer là gì?
Bài tiếp theo: Module 2 — Tổng kết & cheat sheet
Mini-challenge — Implement LRU Cache thủ công không dùng LinkedHashMap
Bài tiếpModule 2 — Tổng kết: cheat sheet cấu trúc tuyến tính
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này