Circular buffer — Ring queue cho hot path & log buffer
Circular buffer giữ N event gần nhất với O(1) enqueue, tự đẩy event cũ nhất ra khi đầy, không cấp phát, không dời phần tử. Nền của log, audio và Disruptor.
TL;DR: Circular buffer (ring buffer) là array kích thước cố định với hai con trỏ head và tail chạy vòng theo modulo: O(1) enqueue và dequeue, không cấp phát thêm, không dời phần tử. Khi buffer đầy, offerOverwrite tự đẩy event cũ nhất ra và cửa sổ dữ liệu trượt sang event mới hơn. Nếu capacity là luỹ thừa của 2, có thể thay modulo bằng phép AND bit (& (N-1)), nhanh hơn đáng kể trong vòng lặp chạy dày. SPSC lock-free chỉ cần volatile vì producer và consumer ghi vào hai biến khác nhau.
Hệ thống nhận 100.000 event mỗi giây từ user — nhưng chỉ cần giữ 10.000 event gần nhất cho audit trail. Dùng ArrayList thì mỗi khi đầy phải dời toàn bộ phần tử một ô, tốn O(n) cho mỗi enqueue, và thành nút thắt cổ chai khi throughput cao. Dùng LinkedList thì mỗi event tạo một Node object, duyệt qua là cache miss liên tục, và GC phải dọn ngày càng nhiều theo tần suất event.
Ta cần một cấu trúc dữ liệu kích thước cố định, enqueue O(1), tự đẩy event cũ nhất ra khi đầy, và không cấp phát, không dời phần tử, không lần theo pointer. Bài này giải thích ring buffer (circular buffer): nền của log system, audio DSP, các kỹ thuật lock-free, và LMAX Disruptor (case study cuối Module 2).
Ôn lại kiến thức nền tảng từ bài queue deque trước khi đi sâu vào nội dung bài học này.
1. Analogy: Đường vòng tròn một chiều
Hình dung một đường vòng tròn một chiều có 8 ô vé, đánh số 0 đến 7. Một chiếc xe chạy quanh vòng theo một chiều duy nhất và ghi vé vào ô trống kế tiếp.
- Khi xe ghi hết ô 7, nó quay lại ô 0, không dừng, không chờ.
- Ô cũ nhất bị ghi đè. Đây là cơ chế tự đẩy phần tử cũ nhất ra (evict oldest).
- Một con trỏ thứ hai (
tail) đánh dấu ô cũ nhất chưa đọc, luôn đi sauheadđúng k ô (k là số dữ liệu hiện có trong buffer).
| Đường vòng tròn | Ring buffer |
|---|---|
| 8 ô vé trên đường | Array kích thước N cố định |
| Vị trí xe đang ghi | head — index ô tiếp theo viết |
| Vé cũ nhất chưa đọc | tail — index ô cũ nhất chưa poll |
| Xe quay lại ô 0 sau ô 7 | (head + 1) % N — quay vòng (wrap around) |
| Ghi đè vé cũ khi đầy | offerOverwrite — tự đẩy phần tử cũ nhất ra |
Ring buffer là array thẳng nhưng index "vòng lại": một head để ghi, một tail để đọc, cả hai chạy cùng chiều và quay vòng ở cuối mảng.
2. Định nghĩa và cấu trúc
Ring buffer gồm ba thành phần cốt lõi:
buffer[0..N-1]— array kích thước N cố định, chỉ cấp phát một lần.head— index ô tiếp theo sẽ ghi vào.tail— index ô cũ nhất chưa đọc (hoặc ô tiếp theo sẽ đọc từ đó).
Hai operation cơ bản:
offer(x) -- enqueue:
    buffer[head] <- x
    head <- (head + 1) % N

poll() -- dequeue:
    item <- buffer[tail]
    tail <- (tail + 1) % N
    return item
Time: O(1) Space: O(1) mỗi thao tác
2.1 Phân biệt full vs empty khi head == tail
Đây là chỗ tinh tế nhất của circular buffer, và là một edge case điển hình (cách nghĩ về edge case xem ở bài Edge case). Khi head == tail, có hai khả năng: buffer rỗng hoặc buffer đầy. Có hai cách xử lý phổ biến:
| Cách | Cơ chế | Đánh đổi |
|---|---|---|
| Biến đếm size | Dùng biến size riêng: đầy khi size == N, rỗng khi size == 0 | Thêm 1 field, code rõ ràng hơn |
| Bỏ phí 1 ô | Đầy khi (head + 1) % N == tail, không dùng hết N ô | Mất 1 ô dùng được, không cần counter |
Mục 3 dùng cách 1. Cách 2 hay gặp ở bản lock-free vì tránh được biến đếm chung mà cả producer lẫn consumer cùng sửa.
3. Thuật toán đầy đủ: size counter
-- RingBuffer với capacity N và biến đếm size
-- Khởi tạo:
buffer[0..N-1] <- array N phần tử
head <- 0        -- vị trí ghi tiếp theo
tail <- 0        -- vị trí đọc tiếp theo (phần tử cũ nhất)
size <- 0
capacity <- N

-- offer(x): enqueue, reject khi đầy
offer(x):
    if size = capacity: return false   -- đầy, từ chối
    buffer[head] <- x
    head <- (head + 1) % capacity
    size <- size + 1
    return true

-- poll(): dequeue, trả NIL khi rỗng
poll():
    if size = 0: return NIL
    item <- buffer[tail]
    buffer[tail] <- NIL     -- xoá reference, giúp GC thu hồi
    tail <- (tail + 1) % capacity
    size <- size - 1
    return item

-- peek(): xem phần tử đầu không xoá
peek():
    if size = 0: return NIL
    return buffer[tail]

-- offerOverwrite(x): enqueue, evict oldest khi đầy
offerOverwrite(x):
    buffer[head] <- x
    head <- (head + 1) % capacity
    if size < capacity:
        size <- size + 1
    else:
        -- Buffer đầy: trượt tail theo head, evict phần tử cũ nhất
        tail <- (tail + 1) % capacity
Time: O(1) mỗi thao tác Space: O(N) tổng
Khi buffer đầy, offerOverwrite tăng cả head lẫn tail: buffer vẫn đầy nhưng "cửa sổ" dữ liệu trượt một ô, bỏ event cũ nhất. Chế độ này hợp với audit trail: luôn giữ N event gần nhất, không từ chối event mới.
4. Sơ đồ vòng tròn: head và tail
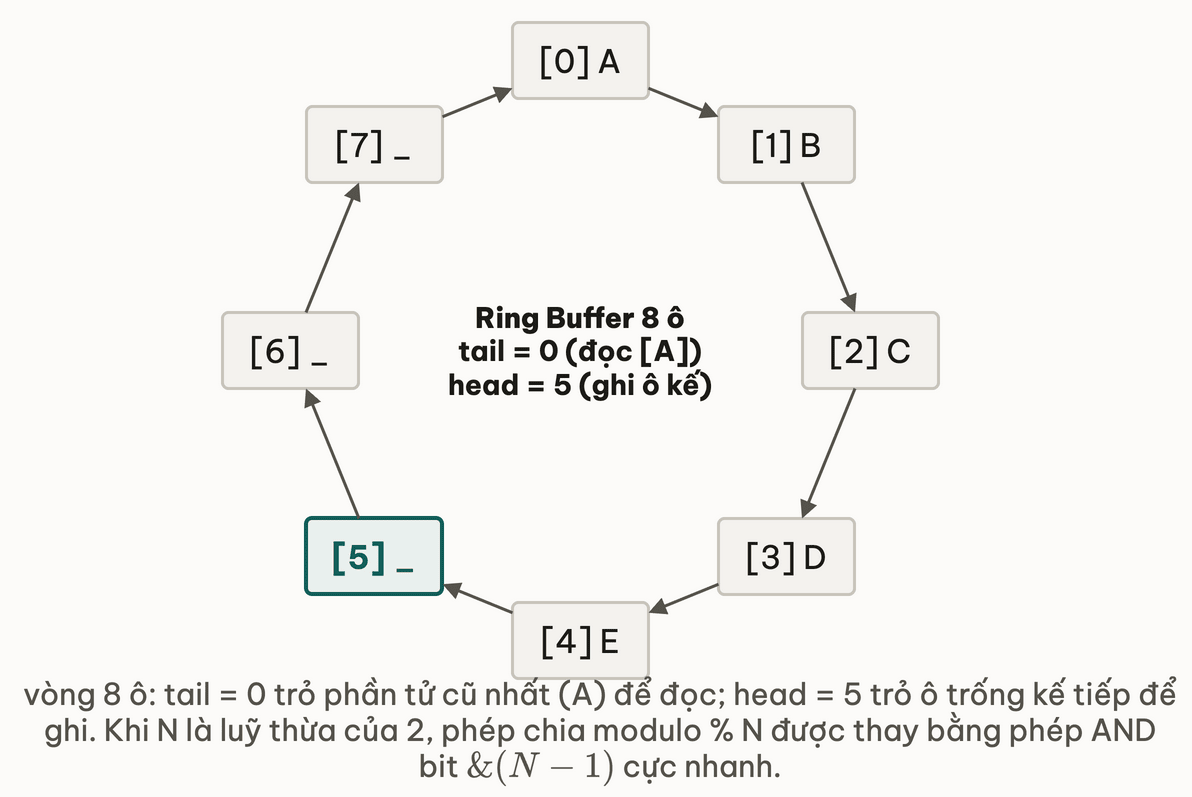
Vòng tròn có 8 ô: tail=0 là phần tử cũ nhất (A), head=5 là ô trống sẽ ghi tiếp. Khi head đã đến ô 7, lần ghi sau quay về ô 0.
5. Bit trick: power-of-2 capacity
Modulo % là phép chia, nên chậm hơn một lệnh bit. Nếu capacity là luỹ thừa của 2, ta thay bằng phép AND bit:
-- Cách thông thường: modulo, chậm hơn khi chạy dày:
head <- (head + 1) % capacity

-- Mẹo bit: chỉ một lệnh AND, nhanh hơn đáng kể:
-- Yêu cầu: capacity PHẢI là lũy thừa của 2 (8, 16, 32, 64, ...)
head <- (head + 1) & (capacity - 1)
Vì sao & (capacity - 1) chạy đúng? Khi N là luỹ thừa của 2, N - 1 là mặt nạ bit (bitmask) có toàn bộ bit thấp bằng 1. Ví dụ N = 8 (nhị phân 1000) thì N - 1 = 7 (nhị phân 0111). AND với 0111 giữ lại 3 bit thấp nhất, tương đương % 8 nhưng chỉ tốn một lệnh.
-- Kiểm tra capacity là luỹ thừa của 2 ngay lúc khởi tạo (lỗi thì báo ngay):
RingBuffer(capacity):
    assert (capacity & (capacity - 1)) = 0   -- nếu sai, báo lỗi ngay
    this.capacity <- capacity
    this.buffer <- array[capacity]
Lưu ý: ArrayDeque của JDK 8 từng dùng đúng mẹo này, nhưng ở JDK 21 nó dùng phép so sánh thường và capacity không còn bị ép là luỹ thừa của 2. Mẹo bit vẫn rất phổ biến ở các ring buffer tự viết như Disruptor hay kfifo.
Thử ngẫmcapacity - 1 chỉ thành mặt nạ bit đúng khi capacity là luỹ thừa của 2. Nếu truyền capacity = 100 vào & (capacity - 1) thay cho % capacity, index sẽ sai theo kiểu nào?
6. Trace trạng thái: capacity = 4
Theo dõi buffer, head, tail, size sau từng thao tác, đúng kiểu bảng trace ở bài Bảng trace.
Khởi tạo — rỗng:
buffer: [_,  _,  _,  _]
         0   1   2   3
head=0, tail=0, size=0

offer(A):
buffer: [A,  _,  _,  _]
head=1, tail=0, size=1

offer(B), offer(C):
buffer: [A,  B,  C,  _]
head=3, tail=0, size=3

offer(D):
buffer: [A,  B,  C,  D]
head=0  (quay vòng!), tail=0, size=4 -- đầy

poll() trả A:
buffer: [_,  B,  C,  D]
head=0, tail=1, size=3

offer(E) -- slot 0 trống:
buffer: [E,  B,  C,  D]
head=1, tail=1, size=4 -- đầy lại, E vào slot 0

offerOverwrite(F) trên buffer đầy -- evict B (tail=1):
buffer: [E,  F,  C,  D]
head=2, tail=2, size=4 -- đầy, cửa sổ trượt: C,D,E,F
Quan sát: sau offerOverwrite(F), buffer vẫn đầy nhưng phần tử cũ nhất (B) đã bị đẩy ra và F chiếm chỗ đó. head và tail đều bằng 2, nhưng buffer đầy chứ không rỗng (phân biệt nhờ size = capacity).
7. Lock-free SPSC pattern
SPSC (Single Producer Single Consumer: một bên ghi, một bên đọc) là trường hợp đặc biệt quan trọng: một thread ghi, một thread đọc. Không cần lock nếu dùng volatile đúng cách (volatile bắt mọi thread luôn đọc giá trị mới nhất của biến).
-- SpscRingBuffer: chỉ đúng cho 1 producer + 1 consumer
-- head: CHỈ producer ghi
-- tail: CHỈ consumer ghi
-- volatile đảm bảo thread này thấy giá trị thread kia vừa ghi

SpscRingBuffer(capacity):
    -- capacity phải là lũy thừa của 2
    assert (capacity & (capacity - 1)) = 0
    buffer <- array[capacity]
    mask   <- capacity - 1
    volatile head <- 0   -- chỉ producer write
    volatile tail <- 0   -- chỉ consumer write

-- Gọi từ producer thread
offer(item):
    h <- head
    if h - tail = buffer.length: return false  -- đầy
    buffer[h & mask] <- item
    head <- h + 1     -- ghi volatile: consumer thấy ngay

-- Gọi từ consumer thread
poll():
    t <- tail
    if head = t: return NIL   -- rỗng (đọc volatile head)
    item <- buffer[t & mask]
    buffer[t & mask] <- NIL   -- giúp GC
    tail <- t + 1     -- ghi volatile: producer thấy ngay
    return item
Time: O(1) Space: O(N)
Vì sao SPSC không cần lock? Producer chỉ ghi head, consumer chỉ ghi tail, nên không có hai thread nào ghi cùng một biến. volatile đảm bảo thứ tự bộ nhớ: khi producer ghi head, consumer thấy giá trị mới ngay ở lần đọc kế tiếp. Không có race condition.
Pseudocode trên chỉ đúng cho một producer và một consumer. Với nhiều producer hoặc nhiều consumer (MPMC), phải dùng CAS (Compare-And-Swap, so sánh rồi đổi trong một bước nguyên tử) để cập nhật head/tail, nếu không hai producer sẽ cùng ghi vào một ô.
8. Pitfall tổng hợp
Pitfall 1: Quên xử lý head == tail có hai nghĩa
Nếu không có biến đếm size và cũng không bỏ phí 1 ô, isEmpty() và isFull() cùng kiểm tra head = tail: khi đầy, code tưởng rỗng và đọc ra dữ liệu cũ; khi rỗng, code tưởng đầy và từ chối offer. Cách sửa như ở mục 2.1.
Pitfall 2: Truy cập đồng thời không có đồng bộ hoá
Với SPSC, head và tail phải là volatile, nếu không thread kia có thể mãi thấy giá trị cũ: producer và consumer cùng ghi vào một ô, hoặc consumer đọc ô chưa có dữ liệu. Với MPMC thì dùng AtomicInteger/CAS, và trong code thật nên dùng LinkedBlockingQueue hoặc Disruptor thay vì tự cài.
Pitfall 3: poll() quên xoá reference, gây rò rỉ bộ nhớ
-- SAI: vẫn giữ reference sau khi poll
poll():
    if size = 0: return NIL
    item <- buffer[tail]
    -- buffer[tail] <- NIL  -- THIẾU dòng này!
    tail <- (tail + 1) % capacity
    size <- size - 1
    return item
Mảng nền vẫn giữ tham chiếu mạnh (strong reference) đến object đã "dequeue", nên GC không thu hồi được. Với buffer capacity 10.000 mà mỗi phần tử là object lớn (mảng byte của ảnh, body của HTTP response, stream), đây là rò rỉ bộ nhớ thật: heap tăng liên tục dù logic không còn dùng các object đó. Cách đúng: gán buffer[tail] <- NIL ngay sau khi đọc giá trị, trước khi tăng tail.
Thử ngẫmcả ba bẫy trên đều là lỗi do thiếu một dòng: quên gán NIL, quên đồng bộ hoá, quên phân biệt đầy/rỗng. Khi review code, dấu hiệu nào giúp bạn nhận ra loại bug này nhanh hơn?
9. Ứng dụng thực tế
LMAX Disruptor (case study cuối Module 2): ring buffer là lõi của nó. Thay vì biến đếm int thường, Disruptor dùng object Sequence có đệm xung quanh để tránh false sharing (hai core CPU tranh nhau một cache line dù ghi hai biến khác nhau). Chi tiết ở bài case study.
Bộ đệm audio DSP: ring buffer giữ N mẫu âm gần nhất. Hiệu ứng vang đọc mẫu cách head k bước rồi trộn với tín hiệu hiện tại, vừa ghi vừa đọc liên tục, không cấp phát thêm.
Linux kernel kfifo — <linux/kfifo.h> là circular buffer dùng trong kernel cho character device và giao tiếp giữa các tiến trình (IPC). Nó dùng số nguyên không dấu cho head/tail; khi tràn, giá trị tự quay về 0 (tính chất của số nguyên không dấu), nên phép modulo với capacity vẫn đúng và không cần xử lý riêng chỗ quay vòng. Nó không cần lock nếu chỉ có một bên ghi và một bên đọc.
JDK ArrayBlockingQueue: ring buffer có chặn trong java.util.concurrent, dùng ReentrantLock và hai Condition (notFull, notEmpty) thay vì lock-free.
Bounded log retention (Sentry breadcrumb, Loki, application audit trail) — ring buffer giữ N event gần nhất và tự bỏ event cũ nhất khi đầy. Sentry SDK giữ một số breadcrumb gần nhất (mặc định cỡ 100) trước khi lỗi xảy ra, cho bạn ngữ cảnh để debug mà không tốn bộ nhớ vô hạn.
10. Deep Dive
Paper và source code:
- LMAX Disruptor — Martin Thompson et al., bài báo gốc mô tả ring buffer, sequence barrier và wait strategy.
- Linux kernel
kfifo.h— bản cài bằng C dùng số nguyên không dấu tự quay vòng thay cho modulo, gọn và đã được kiểm chứng trong thực tế. - OpenJDK 21 — ArrayBlockingQueue.java, circular buffer có chặn, dùng
ReentrantLockvàCondition. So sánh với SPSC lock-free để thấy điểm được/mất. Bài liên quan trong khoá học: - Cache locality: vì sao array liền nhau nhanh hơn lần theo pointer.
- False sharing: lý do Disruptor đệm quanh
Sequence. - Case study Disruptor: ring buffer này trong hệ thống thật.
11. Tóm tắt
- Ring buffer là array cố định với
head/tailchạy vòng:O(1)enqueue và dequeue, không cấp phát thêm, không dời phần tử. head == tailcó hai nghĩa (đầy hoặc rỗng), nên cần biến đếm size hoặc bỏ phí 1 ô.offerOverwriteđẩy phần tử cũ nhất ra khi đầy.- Capacity luỹ thừa của 2 cho phép thay
% capacitybằng& (capacity - 1). - SPSC lock-free chỉ cần
volatilevì mỗi bên chỉ ghi biến của mình; nhiều producer thì cần CAS. - Quên xoá reference sau
polllàm mảng nền giữ object cũ, gây rò rỉ bộ nhớ.
12. Tự kiểm tra
- Q1Vì sao power-of-2 capacity giúp tăng tốc ring buffer? Bit trick cụ thể là gì?
- Q2Có hai cách phân biệt đầy với rỗng khi head == tail. Đánh đổi giữa biến đếm size và bỏ phí 1 ô là gì?
- Q3Vì sao SPSC lock-free chạy được? MPMC cần thêm gì?
- Q4Khi nào chọn offerOverwrite (đẩy cũ nhất ra) thay vì từ chối khi đầy?
- Q5Vì sao
poll()phải xoá reference tại ô sau khi đọc? Bỏ qua thì hậu quả trong code thật là gì?
Bài tiếp theo: PriorityQueue intro
Queue & Deque — FIFO, sliding window, ArrayDeque thay LinkedList
Bài tiếpPriorityQueue — Top-K, scheduler, Dijkstra cần queue thứ tự
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này