Module 2 — Tổng kết: cheat sheet cấu trúc tuyến tính
Cheat sheet Big-O, memory footprint, glossary 13 thuật ngữ, 5 bẫy hay gặp, bảng tự kiểm tra 4 outcome, và lộ trình tiếp theo.
TL;DR
Bạn vừa đi qua 8 bài về cấu trúc dữ liệu tuyến tính, từ array nguyên thuỷ 40 MB đến ring buffer SPSC lock-free không cấp phát thêm khi chạy ổn định. Bài tổng kết này gom lại cheat sheet, glossary, các bẫy hay mắc và bảng tự kiểm tra để bạn biết mình đã nắm chưa.
Đã đi qua
| Bài | Chủ đề | Điểm cốt lõi |
|---|---|---|
| 01 | Array vs ArrayList | Chi phí boxing: 40 MB vs 234 MB cho 10M số nguyên |
| 02 | Linked list | Cache miss 25x dù cùng O(n); mỗi Node tốn thêm 24 byte |
| 03 | Stack | LIFO, call stack, undo, kiểm tra ngoặc cân bằng, DFS lặp |
| 04 | Queue & Deque | FIFO, BFS, cửa sổ trượt lấy max với monotonic deque |
| 05 | Circular buffer | Ring + mẹo modulo; SPSC lock-free chỉ cần volatile |
| 06 | Priority queue | Min-heap intro, O(log n) insert/poll, O(1) peek |
| 07 | Mini-challenge LRU | HashMap + DoublyLinkedList, O(1) get & put |
| 08 | Case study Disruptor | Cấp phát sẵn + đệm 7 long, 25M+ ops/s, GC gần như không phải làm gì |
Cheat sheet
Big-O theo thao tác
| Cấu trúc | Truy cập index | Tìm kiếm | Chèn đầu | Chèn cuối | Xoá đầu | Xoá cuối |
|---|---|---|---|---|---|---|
| Array nguyên thuỷ | O(1) | O(n) | O(n) phải dời | O(n) phải dời | O(n) phải dời | O(1) |
| ArrayList (mảng động) | O(1) | O(n) | O(n) phải dời | Amortized O(1) | O(n) phải dời | O(1) |
| Singly linked list | O(n) | O(n) | O(1) | O(n) hoặc O(1) nếu giữ tail | O(1) | O(n) |
| Doubly linked list | O(n) | O(n) | O(1) | O(1) nếu giữ tail | O(1) | O(1) |
| Stack (trên array) | — | — | — | O(1) push | — | O(1) pop |
| Queue (trên array) | — | — | O(1) enqueue | — | O(1) dequeue | — |
| Deque (ArrayDeque) | O(1) đầu/cuối | O(n) | O(1) | O(1) | O(1) | O(1) |
| Circular buffer | O(1) | O(n) | O(1) overwrite | O(1) | O(1) | O(1) |
| Priority queue (heap) | O(1) peek min | O(n) | O(log n) | O(log n) | O(log n) poll | — |
Memory footprint cho 10 triệu phần tử
| Cấu trúc | RAM ước tính | Ghi chú |
|---|---|---|
int[] nguyên thuỷ | ~40 MB | 4 byte/phần tử, không boxing |
Integer[] boxed | ~200 MB | 16 byte object + 4 byte tham chiếu = 20 byte mỗi ô |
ArrayList<Integer> | ~234 MB | Mảng boxed + chừa trống capacity ~17% |
LinkedList<Integer> | ~400 MB | Mỗi Node tốn thêm 24 byte |
ArrayDeque<Integer> | ~200 MB trở lên | Circular array boxed (như Integer[] cộng phần chừa trống), ít bộ nhớ phụ hơn LinkedList |
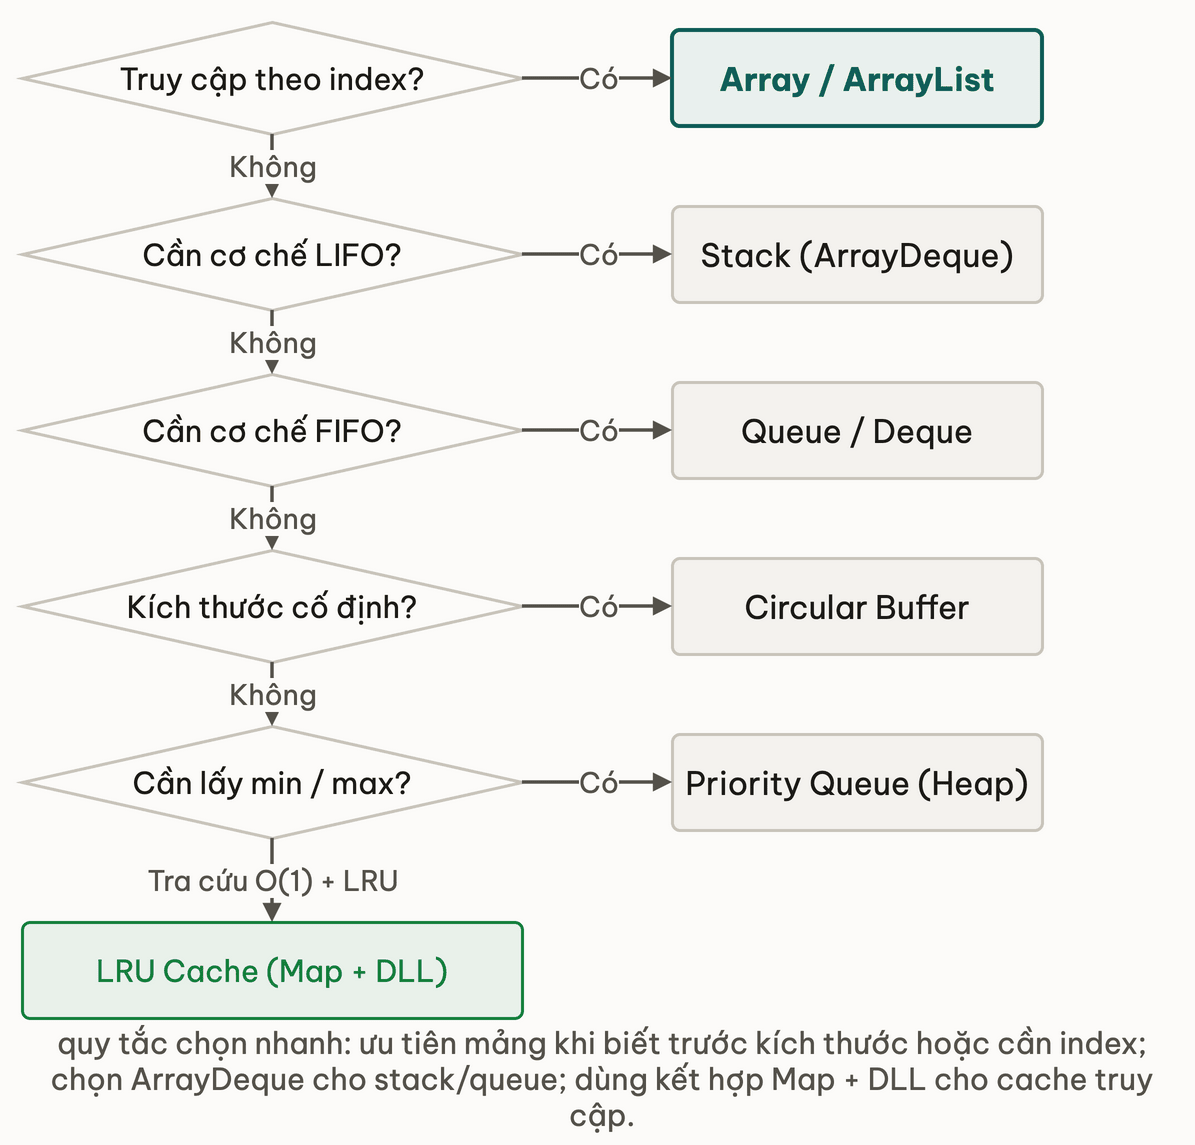
Khi nào chọn cái nào
Biết trước kích thước + cần tốc độ tối đa (hot loop)?
    -> array nguyên thuỷ int[], long[], double[]

Cần danh sách tự nở + truy cập theo index?
    -> ArrayList (mặc định cho hầu hết trường hợp)

Cần chèn/xoá ở đầu thường xuyên + không cần truy cập theo index?
    -> ArrayDeque (không phải LinkedList)

Cần LIFO (undo, call stack, DFS)?
    -> Stack bằng ArrayDeque (Deque.push/pop)

Cần FIFO (BFS, task queue)?
    -> Queue bằng ArrayDeque (Deque.offer/poll)

Cần giữ N phần tử gần nhất, O(1) enqueue, tự đẩy cái cũ nhất ra?
    -> Circular buffer (ring buffer)

Cần luôn lấy min/max nhanh?
    -> Priority queue (min-heap)

Cần O(1) get + O(1) put + đẩy LRU ra?
    -> HashMap + DoublyLinkedList (hoặc LinkedHashMap)

Cần producer-consumer lock-free với throughput cao nhất?
    -> Ring buffer SPSC (Disruptor pattern hoặc JCTools)
Glossary
| Thuật ngữ | Định nghĩa ngắn |
|---|---|
| Array nguyên thuỷ | Mảng lưu giá trị trực tiếp (int[]), không boxing, thân thiện với cache, kích thước cố định |
| Boxing | Bọc primitive vào một object (int → Integer), tốn thêm object header 12 byte |
| Cache locality | Dữ liệu nằm liền nhau trong bộ nhớ thì CPU nạp trước (prefetch) cùng lúc; array thắng linked list nhờ điều này |
| False sharing | Hai biến không liên quan nằm cùng cache line 64 byte, ghi một biến làm mất hiệu lực cache của biến kia |
| Amortized O(1) | Chi phí trung bình trên cả chuỗi thao tác. Ví dụ ArrayList nở 1.5 lần: mỗi lần nở tốn O(n) nhưng chia đều ra thì mỗi thao tác chỉ O(1) |
| Circular buffer | Array kích thước cố định với head/tail chạy vòng theo modulo, O(1) enqueue/dequeue, không cấp phát thêm |
| SPSC | Single Producer Single Consumer (một bên ghi, một bên đọc), mẫu lock-free chỉ cần volatile vì hai bên ghi vào hai biến khác nhau |
| Capacity chừa trống (capacity slack) | Phần mảng nền dự phòng chưa dùng trong mảng động, lý do ArrayList tốn RAM hơn số phần tử thật |
| modCount | Bộ đếm số lần cấu trúc list thay đổi trong ArrayList; iterator fail-fast dùng nó để phát hiện sửa đổi đồng thời |
| Sentinel node | Node giả (dummy) ở đầu/cuối doubly linked list, giúp code chèn/xoá đơn giản hơn, khỏi kiểm tra null |
| Priority queue | Hàng đợi trả về phần tử có độ ưu tiên cao nhất (min hoặc max), thường cài bằng binary heap |
| Heapify | Xây heap từ array có sẵn trong O(n), nhanh hơn chèn từng phần tử (O(n log n)) |
| Sequence barrier | Cơ chế của Disruptor giữ consumer lại cho đến khi producer publish đủ sequence, không lock, không dùng blocking queue |
Các bẫy hay gặp
Bẫy 1: Dùng LinkedList vì tưởng O(1) insert nhanh hơn ArrayList:
LinkedList.add(0, x) là O(1) nối pointer, nhưng ArrayList.add(0, x) tuy O(n) vì phải dời phần tử, nhưng với n nhỏ thường vẫn nhanh hơn. Lý do: việc dời phần tử là một lệnh copy mảng liên tiếp rất nhanh, còn linked list gây cache miss liên tục khi duyệt. Hãy đo bằng JMH trước khi đổi (ngưỡng "n nhỏ" tuỳ máy).
Bẫy 2: Nhầm capacity với size trong ArrayList:
new ArrayList<>(100) tạo mảng nền kích thước 100 nhưng size = 0. Gọi get(50) sẽ ném IndexOutOfBoundsException. Capacity chỉ quyết định khi nào mảng phải nở thêm, không tạo sẵn phần tử.
Bẫy 3: Tin vào iterator fail-fast trong chương trình đa luồng:
ConcurrentModificationException từ fail-fast chỉ là phát hiện "cố hết sức" (best-effort). Khi nhiều thread chạy mà không có quan hệ happens-before (quy tắc đảm bảo thread này thấy thay đổi của thread kia), modCount có thể chưa hiện ra và lỗi không được ném, khiến iterator trả về kết quả sai mà không báo gì. Hãy dùng CopyOnWriteArrayList hoặc tự đồng bộ hoá khi nhiều thread cùng truy cập.
Bẫy 4: Ring buffer có kích thước không phải luỹ thừa của 2:
Circular buffer dùng head & (N-1) thay modulo chỉ đúng khi N là luỹ thừa của 2. Với N = 100 thì head & 99 cho kết quả sai. Hãy luôn chọn N là luỹ thừa của 2, hoặc dùng modulo % thông thường nếu không chắc.
Bẫy 5: Disruptor ProducerType.SINGLE với nhiều publisher thread:
Chế độ một producer không dùng CAS, nên nhanh hơn nhưng sẽ hỏng dữ liệu mà không báo lỗi nếu nhiều thread cùng gọi ring.next(). Không có exception, chỉ thấy dữ liệu sai ở phía consumer, và thường chỉ lộ ra khi tải thật. Hãy luôn dùng ProducerType.MULTI khi có nhiều thread publish.
Sơ đồ chọn cấu trúc
Tự kiểm tra
Bạn đã đạt module này nếu trả lời được:
- So sánh được array,
ArrayListvàLinkedListtheo truy cập / chèn / xoá và bộ nhớ (Nếu chưa: đọc lại bài 01 và 02) - Cài được stack, queue, deque, circular buffer và hàng đợi ưu tiên bằng pseudocode (Nếu chưa: đọc lại bài 03, 04, 05, 06)
- Giải thích được vì sao cache locality khiến array nhanh hơn
LinkedListdù cùng O(n) (Nếu chưa: đọc lại bài 02 mục "Cache penalty") - Thiết kế được các cấu trúc ghép như LRU cache và ring buffer SPSC (Nếu chưa: đọc lại bài 07 và 08)
Bài tiếp theo
Module này kết thúc khoá Thuật toán Căn bản (tier 1). Bạn đã nắm các cấu trúc dữ liệu tuyến tính cùng cơ chế bộ nhớ bên dưới, đủ nền để hiểu vì sao mỗi thuật toán có độ phức tạp như vậy.
Khoá tiếp theo là Thuật toán Cốt lõi (tier 2), bắt đầu với Module Tìm kiếm nhanh: hash function, binary search, trie, và bloom filter. Các cấu trúc đó đều xây trên kiến thức bạn vừa học.
Thuật toán Cốt lõi — Tìm kiếm nhanh
Tài liệu mở rộng
- OpenJDK 21 — ArrayList.java, mã nguồn của
grow(),modCount,elementData. Đọc cùng cheat sheet để thấy cách cài đặt thật. - LMAX Disruptor paper (2011) — bài báo gốc mô tả ring buffer, sequence barrier và phương pháp benchmark.
- JCTools — Lock-free collections, các queue SPSC, MPSC, SPMC, MPMC, nhẹ hơn Disruptor cho trường hợp đơn giản.
- Effective Java, Item 28 — Prefer lists to arrays, Bloch giải thích array là covariant còn generic list là invariant, và vì sao thường nên chọn list thay array.
- Aleksey Shipilev — JVM performance blog, false sharing, chi phí boxing,
@Contended, cách đo benchmark bằng JMH.
Bài tiếp theo: Thuật toán Cốt lõi — Module Tìm kiếm: tổng quan
Case Study: LMAX Disruptor — Ring buffer thắng BlockingQueue
Khoá tiếp theoThuật toán Cốt lõi — Tìm kiếm, Sắp xếp & Đồ thị
Tìm kiếm nhanh (hashing, BST, cây cân bằng, B-tree, trie, bloom filter), sắp xếp (merge/quick/heap/counting/radix, skip list) và đồ thị (BFS, DFS, topo sort, Dijkstra, Bellman-Ford, Floyd-Warshall, MST, DSU). Dẫn bằng ý tưởng + sơ đồ + độ phức tạp, code pseudocode.
36 bài · ~10.6 giờBài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này