PriorityQueue — Top-K, scheduler, Dijkstra cần queue thứ tự
ArrayList scan max tốn O(n) — bottleneck rõ với 1 triệu task. Bài giới thiệu PriorityQueue, binary heap, sift-up/sift-down O(log n), và pattern top-K.
TL;DR: PriorityQueue không phải FIFO: phần tử có độ ưu tiên (priority) cao nhất (mặc định là giá trị nhỏ nhất) luôn được lấy ra trước, dù insert theo thứ tự nào. Bên dưới là binary heap: cây nhị phân cân bằng hoàn toàn, lưu trong array, mỗi node nhỏ hơn hoặc bằng hai con của nó (min-heap). Hai thao tác sift-up (khi insert) và sift-down (khi lấy phần tử nhỏ nhất ra, extract-min) khôi phục tính chất heap trong O(log n) bằng cách đi dọc theo chiều cao cây. Duyệt qua heap không cho thứ tự đã sắp xếp; muốn có thứ tự phải poll() liên tiếp. Mẫu Top-K: max-heap kích thước K, O(n log k) time, O(k) space.
Task scheduler nhận 1 triệu task với priority từ 1 đến 100. Mỗi khi một worker rảnh, scheduler phải chọn task có priority cao nhất đang chờ. Cách đơn giản nhất là duyệt cả danh sách để tìm max, tốn O(n) mỗi lần: với 1 triệu task thì mỗi lần cỡ 1ms, và 1000 lần chọn mỗi giây đã ngốn hết một giây CPU. Worker phải chờ, throughput tụt.
Ta cần một cấu trúc dữ liệu cho insert O(log n) và lấy ra theo thứ tự ưu tiên O(log n), không phải quét toàn bộ. PriorityQueue trong Java làm đúng việc đó, nhờ binary heap bên dưới: một cây nhị phân cân bằng hoàn toàn, lưu trong array, với tính chất "mỗi node nhỏ hơn hoặc bằng các con" (min-heap).
Bài này giới thiệu PriorityQueue qua cấu trúc binary heap, sift-up/sift-down và các ứng dụng (top-K, Dijkstra, scheduler). Phần chứng minh buildHeap O(n) và heapsort sẽ đào sâu ở Heap & Heapsort của khoá Thuật toán Cốt lõi.
Ôn lại kiến thức nền tảng từ bài array vs arraylist trước khi đi sâu vào nội dung bài học này.
1. Analogy: Phòng khám ưu tiên
Phòng khám có nhiều bệnh nhân đang chờ, mỗi người có mức độ ưu tiên khác nhau: cấp cứu ưu tiên cao nhất, tái khám thông thường ưu tiên thấp. Y tá không gọi theo thứ tự đến, mà luôn gọi bệnh nhân có mức ưu tiên cao nhất.
Y tá không phải quét cả phòng chờ mỗi lần gọi, vì danh sách đã được tổ chức để bệnh nhân ưu tiên cao nhất luôn đứng đầu. Có bệnh nhân mới đến thì chèn họ vào đúng vị trí theo mức ưu tiên.
| Phòng khám | MinHeap |
|---|---|
| Bệnh nhân mới đến đăng ký | offer(x) — thêm vào, O(log n) |
| Y tá gọi bệnh nhân ưu tiên nhất | poll() — lấy và xoá top, O(log n) |
| Nhìn bảng để biết ai kế tiếp | peek() — xem top, không xoá, O(1) |
| Phòng chờ không ai | isEmpty() — kiểm tra rỗng |
| Cấp cứu ưu tiên hơn tái khám | Comparator — định nghĩa thứ tự |
PriorityQueue không phải FIFO: phần tử ưu tiên cao nhất (mặc định là nhỏ nhất) luôn được poll trước, bất kể insert theo thứ tự nào.
2. API và complexity
Muốn dùng PriorityQueue, bạn chưa cần biết binary heap là gì; chỉ cần hiểu bốn thao tác và độ phức tạp của chúng.
| Operation | Method | Complexity | Ghi chú |
|---|---|---|---|
| Thêm | offer(x) | O(log n) | Luôn thành công (PriorityQueue không giới hạn kích thước) |
| Xem top | peek() | O(1) | Trả null nếu rỗng |
| Lấy và xoá top | poll() | O(log n) | Trả null nếu rỗng |
| Duyệt | for each | O(n) | Theo thứ tự trong heap, không phải thứ tự đã sắp xếp |
Ví dụ: offer 3, 1, 2 rồi poll() ba lần sẽ trả lần lượt 1, 2, 3.
Duyệt for each trên heap KHÔNG cho thứ tự đã sắp xếp. Nó đi theo thứ tự nội bộ của heap, nhìn gần như ngẫu nhiên. Muốn có thứ tự sắp xếp, hãy poll() lặp lại.
3. Min-heap vs max-heap và custom comparator
Mặc định là min-heap: phần tử nhỏ nhất theo thứ tự tự nhiên (natural ordering) được poll() trước.
-- Min-heap mặc định (thứ tự tự nhiên, tăng dần):
minHeap <- MinHeap rỗng
minHeap.offer(5); minHeap.offer(1); minHeap.offer(3)
minHeap.poll()  -- trả 1 (nhỏ nhất)

-- Max-heap: đảo comparator
maxHeap <- MaxHeap rỗng  -- comparator đảo ngược
maxHeap.offer(5); maxHeap.offer(1); maxHeap.offer(3)
maxHeap.poll()  -- trả 5 (lớn nhất)
Với object tự định nghĩa, dùng comparator để quy định thứ tự:
-- Task với priority: số nhỏ hơn = cấp bách hơn
Task = { name, priority }

-- Min-heap theo priority (priority 1 chạy trước priority 10):
scheduler <- MinHeap theo Task.priority

scheduler.offer(Task("backup",  priority=10))
scheduler.offer(Task("alert",   priority=1))
scheduler.offer(Task("report",  priority=5))

scheduler.poll()  -- trả Task("alert", 1) -- priority thấp nhất = cấp bách nhất
Comparator dạng (a, b) -> a.priority - b.priority trông gọn nhưng ẩn bug: khi a.priority là MAX_INT và b.priority âm, phép trừ tràn số nguyên (integer overflow), cho ra kết quả âm giả và thứ tự sai hoàn toàn. Dùng Integer.compare(a.priority, b.priority) hoặc Comparator.comparingInt(Task::priority) thay thế.
4. Cấu trúc bên dưới: binary heap và sift mechanism
PriorityQueue lưu dữ liệu trong một array thông thường, nhưng xếp theo cây nhị phân ngầm định (không có pointer, quan hệ cha-con tính bằng index). Với n phần tử, phần tử tại index i có:
- parent tại index
(i - 1) / 2 - left child tại index
2*i + 1 - right child tại index
2*i + 2
Min-heap với các phần tử [1, 3, 2, 7, 5, 4]:

Cây nhị phân:            Array tương ứng:
        1                index: [0, 1, 2, 3, 4, 5]
       / \               value: [1, 3, 2, 7, 5, 4]
      3   2
     / \ /
    7  5 4

Tính chất heap: mỗi node <= cả hai con
=> root luôn là phần tử nhỏ nhất
Tính chất heap (heap property): mỗi node nhỏ hơn hoặc bằng cả hai con, nhờ đó root luôn là phần tử nhỏ nhất. Sau mỗi lần thay đổi, insert và extract-min dùng hai thao tác để khôi phục tính chất này:
4.1 Sift-up: khi insert
-- offer(x): chèn x vào heap
offer(x):
    A.append(x)           -- đặt x ở cuối array (lá mới)
    i <- A.length - 1     -- index của x

    -- Sift-up: so sánh với parent, swap nếu nhỏ hơn
    while i > 0:
        parent <- (i - 1) / 2
        if A[i] < A[parent]:
            swap(A[i], A[parent])
            i <- parent
        else:
            break         -- tính chất heap đã đúng, dừng
Time: O(log n) — số lần swap tối đa bằng chiều cao cây Space: O(1)
Ví dụ sift-up khi offer(0) vào heap [1, 3, 2, 7, 5, 4]:
- Đặt 0 ở index 6 (con của index 2, giá trị 2) → 0 nhỏ hơn 2, swap → 0 lên index 2
- 0 là con của root (index 0, giá trị 1) → 0 nhỏ hơn 1, swap → 0 thành root
- Đúng 2 lần swap.
4.2 Sift-down: khi extract-min
-- poll(): lấy và xoá phần tử nhỏ nhất (root)
poll():
    if A rỗng: return NIL
    result <- A[0]            -- lưu kết quả (root = minimum)
    A[0] <- A[A.length - 1]  -- đưa phần tử cuối lên root
    A.removeLast()

    -- Sift-down: so với con nhỏ hơn, đổi chỗ nếu lớn hơn
    i <- 0
    while true:
        left  <- 2*i + 1
        right <- 2*i + 2
        smallest <- i

        if left < A.length and A[left] < A[smallest]:
            smallest <- left
        if right < A.length and A[right] < A[smallest]:
            smallest <- right

        if smallest = i:
            break             -- không cần swap thêm, dừng
        swap(A[i], A[smallest])
        i <- smallest

    return result
Time: O(log n) Space: O(1)
Ví dụ sift-down khi poll() trên heap [1, 3, 2, 7, 5, 4] (nếu cần ôn cách theo dõi từng bước, xem Bảng trace):
| Bước | Mảng | Ghi chú |
|---|---|---|
| Lấy root | kết quả = 1 | root là nhỏ nhất |
| Đưa phần tử cuối (4) lên root | [4, 3, 2, 7, 5] | vi phạm: 4 lớn hơn con |
| So hai con 3 và 2, chọn nhỏ hơn (2), swap | [2, 3, 4, 7, 5] | 4 xuống index 2 |
| 4 không còn con nào | [2, 3, 4, 7, 5] | dừng, heap hợp lệ |
Vì sao O(log n)? Cả hai thao tác chỉ đi dọc theo chiều cao cây. Heap luôn là cây nhị phân cân bằng hoàn toàn (lấp đầy từ trái sang phải) nên chiều cao bằng log₂(n). Số lần swap tối đa bằng số tầng, tức O(log n). Đó là lý do cốt lõi để MinHeap đạt O(log n) mà không cần quét toàn bộ.
Cấu trúc này lưu trong array, không dùng pointer, nên thân thiện với cache. Phần chứng minh buildHeap O(n) ở bài Heap & Heapsort.
Thử ngẫmsift-down chỉ swap dọc theo chiều cao cây, tức O(log n) tầng. Nếu đổi cách lưu từ array phẳng sang cây dùng con trỏ thật, big-O này còn giữ nguyên không?
5. Sơ đồ sift-up và sift-down
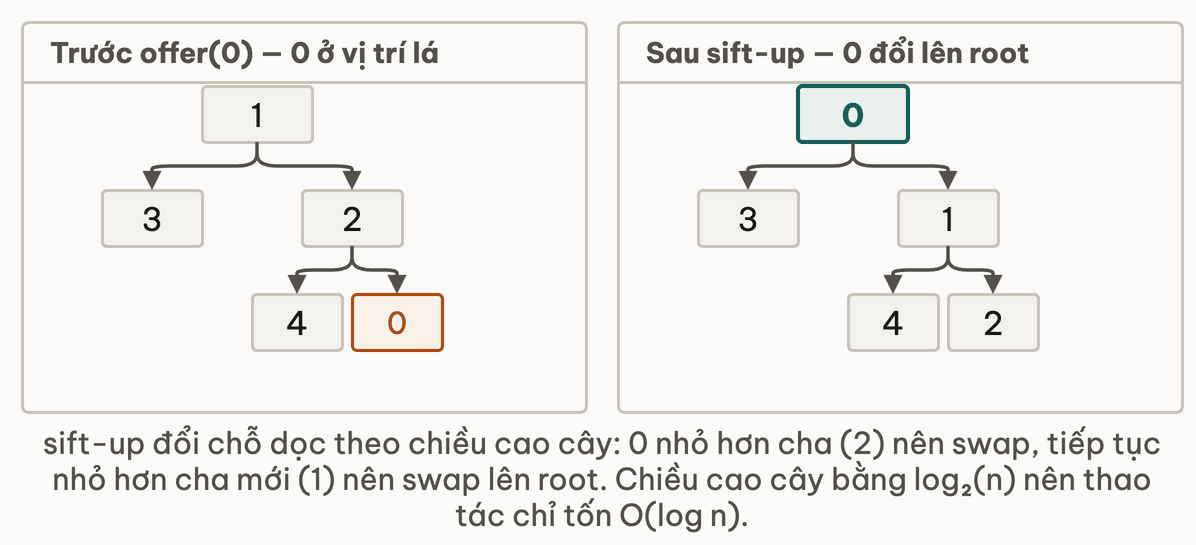
Sift-up: 0 nhỏ hơn parent (2) nên swap; 0 nhỏ hơn parent mới (1) nên swap tiếp lên root. Đúng 2 bước, chiều cao cây là 3.
6. Top-K pattern
Tìm K phần tử nhỏ nhất trong một luồng 1 triệu số nguyên. Đây là bài toán kinh điển, hay gặp trong phỏng vấn và trong phân tích dữ liệu thực tế.
Cách ngây thơ (naive): sắp xếp toàn bộ, tốn O(n log n) time và O(n) space. Không dùng được với dữ liệu dạng luồng (streaming) vì phải nạp hết vào RAM.
Cách dùng heap: dùng max-heap kích thước K.
Ý tưởng: heap luôn giữ K phần tử nhỏ nhất đã gặp cho đến lúc này. Đỉnh của max-heap là phần tử lớn nhất trong nhóm K đó, ta gọi là "ngưỡng" (threshold). Khi có phần tử mới nhỏ hơn ngưỡng, nó đủ điều kiện vào nhóm K: thêm vào heap rồi pop ngưỡng cũ ra.
-- topKSmallest(nums[], k): trả k phần tử nhỏ nhất
topKSmallest(nums, k):
    H <- MaxHeap rỗng   -- top của H là phần tử lớn nhất trong k nhỏ nhất đã thấy

    for each n trong nums:
        H.offer(n)
        if H.size() > k:
            H.poll()    -- bỏ phần tử lớn nhất, vì nó không thuộc top-k

    -- H chứa đúng k phần tử nhỏ nhất
    result <- array[k]
    for i <- k-1 downto 0:
        result[i] <- H.poll()   -- lấy hết ra, theo thứ tự tăng dần
    return result
Time: O(n log k) Space: O(k)
Độ phức tạp: O(n log k) time, vì mỗi trong n phần tử tốn O(log k) để thêm/poll vào heap kích thước K. O(k) space: heap không bao giờ vượt K phần tử, không cần nạp cả n vào RAM. Với n = 1 triệu và k = 10, thực tế gần như O(n) vì log 10 chỉ là hằng số.
Thử ngẫmMaxHeap kích thước K giữ K phần tử nhỏ nhất bằng cách poll phần tử lớn nhất mỗi khi vượt K. Nếu đổi bài toán thành tìm K phần tử lớn nhất, nên thay MaxHeap bằng loại heap nào?
7. Pitfall tổng hợp
Pitfall 1: Iteration không cho sorted output
Xem cảnh báo ở mục 2: for each duyệt mảng nền theo index (ví dụ heap {3, 1, 2} có thể in 1 3 2), muốn đã sắp xếp thì poll() liên tiếp.
Pitfall 2: Comparator trả a - b bị tràn số
Xem cảnh báo ở mục 3: MAX_INT - (-1) tràn thành số âm làm thứ tự sai. Dùng Integer.compare(a, b).
Pitfall 3: Heap không thread-safe
-- SAI: nhiều thread cùng offer/poll sẽ làm hỏng heap
-- Thread 1: H.offer(task1)
-- Thread 2: H.poll()
-- Race condition: array nội bộ rơi vào trạng thái không nhất quán

-- ĐÚNG, cách 1: PriorityBlockingQueue (có chặn, an toàn giữa các thread)
H <- PriorityBlockingQueue rỗng

-- ĐÚNG, cách 2: tự thêm lock bên ngoài, bao quanh mọi thao tác
synchronized(lock):
    H.offer(task)
PriorityBlockingQueue là queue chặn (blocking) không giới hạn kích thước, giữ đúng thứ tự ưu tiên và an toàn giữa các thread. Hàm take() chờ khi queue rỗng. Hợp với task scheduler chạy đa luồng.
8. Ứng dụng thực tế
Dijkstra tìm đường ngắn nhất (khoá Thuật toán Cốt lõi): mỗi đỉnh (vertex) có khoảng cách ước lượng ban đầu là vô cực, trừ điểm xuất phát (source) bằng 0. MinHeap chứa các cặp (distance, vertex); mỗi bước poll ra đỉnh có khoảng cách nhỏ nhất để "relax" (thử cập nhật khoảng cách cho các đỉnh kề, nếu đi qua đỉnh này ngắn hơn). Không dùng heap thì mỗi vòng lặp phải quét cả V đỉnh, tổng O(V²). Dùng heap giảm xuống O((V+E) log V), cải thiện đáng kể với graph thưa.
Task scheduler / cron daemon: các job nằm trong min-heap theo thời điểm cần chạy; peek() cho biết còn chờ bao lâu đến job kế, poll() khi đến giờ, không phải quét cả danh sách.
Mô phỏng theo sự kiện (discrete event simulation) — mọi sự kiện sắp xảy ra được đặt vào min-heap theo thời điểm. Mỗi bước: poll() sự kiện sớm nhất, xử lý, và các sự kiện mới phát sinh từ đó được offer() vào heap. Heap đóng vai "đồng hồ" của cả mô phỏng.
9. Deep Dive
Source code và tài liệu:
- OpenJDK 21 — PriorityQueue.java, Đọc
siftUp(),siftDown(),heapify()để hiểu cơ chế bên dưới API.heapify()chính làbuildHeap O(n), được gọi khi tạo heap từ mộtCollection. - CLRS Chapter 6 — Heapsort, Phân tích
MAX-HEAPIFY,BUILD-MAX-HEAP,HEAPSORT, kèm chứng minhbuildHeap O(n). - Effective Java Item 14 — Consider implementing Comparable, hợp đồng của Comparable. Vi phạm hợp đồng thì heap chạy sai.
Bài liên quan trong khoá học:
- Heap & Heapsort (Thuật toán Cốt lõi): sift-up, sift-down, chứng minh
buildHeap O(n), heapsort. - Dijkstra (Thuật toán Cốt lõi): Dijkstra với MinHeap,
O((V+E) log V).
10. Tóm tắt
- PriorityQueue lấy phần tử ưu tiên nhất ra trước (mặc định là nhỏ nhất). Insert và poll
O(log n), peekO(1). Max-heap dùng comparator đảo ngược. - Binary heap lưu trong array: parent ở
(i-1)/2, con ở2i+1và2i+2. Sift-up (insert) và sift-down (poll) chỉ đổi chỗ dọc một đường nênO(log n). - Duyệt heap không cho thứ tự sắp xếp; muốn thứ tự thì
poll()liên tiếp. - Comparator
a - bcó thể tràn số: dùngInteger.compare. Heap không thread-safe: dùngPriorityBlockingQueuekhi đa luồng. - Mẫu Top-K: max-heap kích thước K,
O(n log k)time,O(k)space.
11. Tự kiểm tra
- Q1Vì sao Java chọn min-heap làm mặc định thay max-heap? Để có max-heap thì làm thế nào?
- Q2Top-K dùng max-heap kích thước K thay vì sắp xếp toàn bộ: đánh đổi cụ thể về time và space là gì?
- Q3Khi duyệt
for eachtrên MinHeap chứa 5, 2, 8, 1, kết quả in ra là gì? Vì sao không phải 1 2 5 8? - Q4Comparator viết (a, b) -> a - b có gì sai? Trường hợp nào gây bug trên môi trường thật?
- Q5Vì sao insert và extract của MinHeap là O(log n) chứ không phải O(n)? Liên hệ với chiều cao cây.
Bài tiếp theo: Mini-challenge: LRU Cache thủ công
Circular buffer — Ring queue cho hot path & log buffer
Bài tiếpMini-challenge — Implement LRU Cache thủ công không dùng LinkedHashMap
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này