Module 2 — Cấu trúc tuyến tính: tổng quan
Array, ArrayList, LinkedList, Stack, Queue, Deque, Circular buffer — khi nào chọn cái nào và vì sao. Bản đồ các bài của module.
TL;DR
Module này trả lời một câu hỏi đơn giản nhưng hay bị trả lời sai: khi nào chọn array, khi nào chọn linked list, khi nào chọn stack/queue? Câu trả lời không nằm ở O(n). Nó nằm ở cache locality (dữ liệu xếp liền nhau thì CPU đọc nhanh), lượng bộ nhớ chiếm dụng và kiểu truy cập dữ liệu. Cùng 10 triệu số nguyên, array nguyên thuỷ tốn 40 MB còn LinkedList tốn 400 MB: khoảng cách 10 lần đến từ cách thiết kế bộ nhớ, không phải từ thuật toán.
Vì sao cần module này
Big-O che giấu hệ số hằng (constant factor), tức thời gian thật của mỗi bước. Tutorial dạy LinkedList.add() là O(1) và ArrayList.add() là amortized O(1) — nghe có vẻ tương đương. Nhưng production Java hầu như không dùng LinkedList vì cache miss khiến việc cộng 10 triệu phần tử qua linked list chậm hơn array 25 lần, dù cùng O(n).
Module này đào sâu cơ chế bên dưới từng cấu trúc: cách xếp dữ liệu trong bộ nhớ, hành vi của cache, cách mảng nở thêm chỗ khi đầy (grow). Nhờ vậy bạn chọn đúng cấu trúc cho bài toán thực tế, không chỉ cho bài thi DSA.
Sau module này bạn sẽ
- Compare mảng tĩnh, mảng động và danh sách liên kết theo truy cập / chèn / xoá và bộ nhớ
- Implement stack, queue, deque, circular buffer và hàng đợi ưu tiên bằng pseudocode
- Explain vì sao cache locality khiến mảng nhanh hơn danh sách liên kết dù cùng O(n)
- Design cấu trúc kết hợp (LRU cache = hash map + danh sách liên kết đôi; ring buffer SPSC)
Bản đồ module
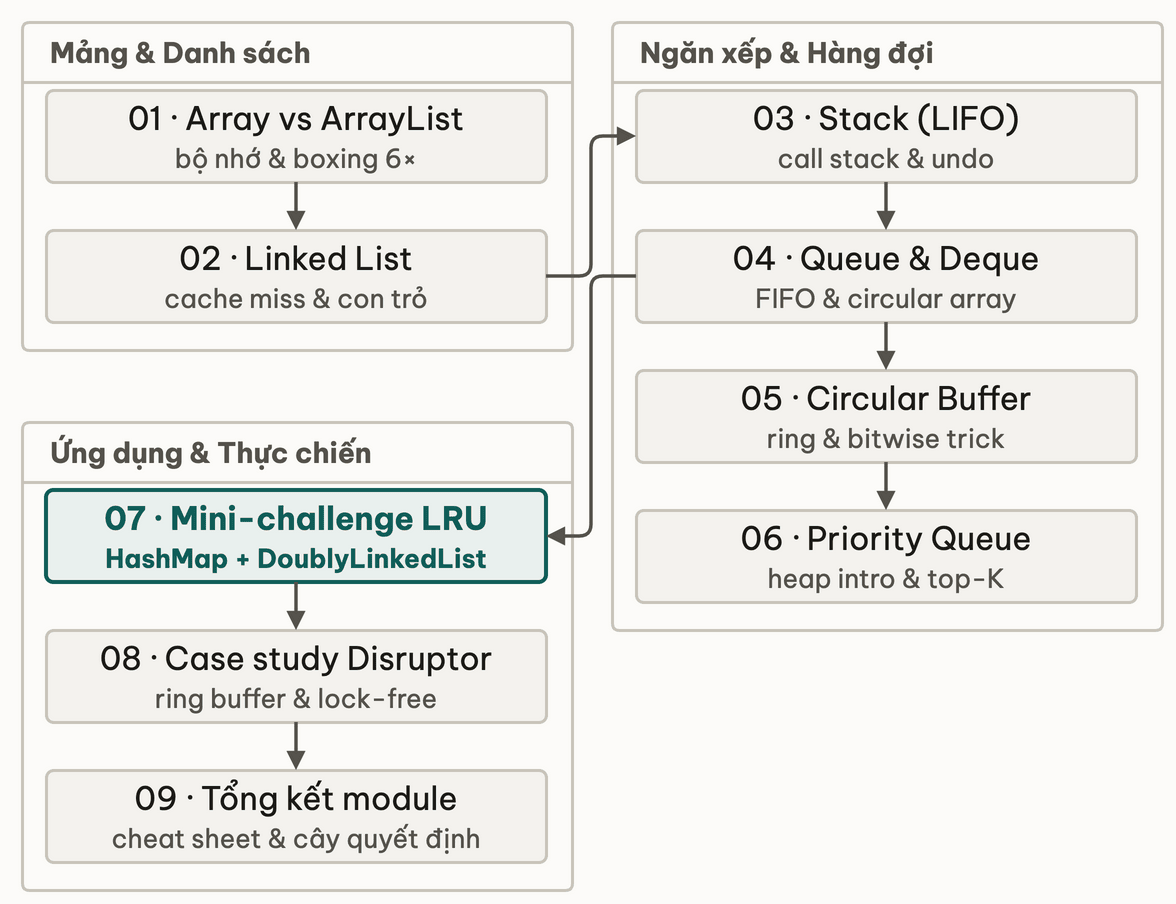
Lộ trình học
| Bài | Chủ đề | Điểm cốt lõi |
|---|---|---|
| 01 | Array vs ArrayList | 40 MB vs 234 MB — boxing overhead, capacity vs size |
| 02 | Linked list | Cache miss 25x — khi nào O(1) insert thực sự quan trọng |
| 03 | Stack | LIFO — call stack, undo, balanced brackets |
| 04 | Queue & Deque | FIFO — BFS, sliding window, monotonic deque |
| 05 | Circular buffer | Ring + modulo trick — O(1) enqueue/dequeue, SPSC lock-free |
| 06 | Priority Queue | Min-heap intro — dijkstra, task scheduling |
| 07 | Mini-challenge LRU | HashMap + DoublyLinkedList — O(1) get & put |
| 08 | Case study Disruptor | Pre-alloc + false sharing padding — 25M+ ops/s |
| 09 | Tổng kết | Cheat sheet, glossary, pitfall, self-assessment |
Cách học hiệu quả
Đọc pseudocode, đừng chạy code. Các bài dùng pseudocode không gắn với ngôn ngữ nào: từ khoá điều khiển bằng tiếng Anh (if / while / for), tên biến tiếng Anh, chú thích tiếng Việt. Mục tiêu là nắm ý tưởng, không phải copy-paste vào IDE.
Tập trung vào "vì sao", không chỉ "cái gì". Mỗi bài đều giải thích cơ chế bên dưới: cách xếp dữ liệu trong bộ nhớ, hành vi của cache, cách mảng nở thêm chỗ. Đây là phần quan trọng nhất, nên đọc kỹ trước khi làm self-check. Nếu các bảng trace từng bước còn lạ, ôn lại Bảng trace trước khi vào bài 03.
Làm mini-challenge trước khi xem lời giải. Bài 07 (LRU Cache) yêu cầu implement đầy đủ. Tự viết pseudocode trước, sau đó so sánh với lời giải để thấy khác biệt ở cách xử lý edge case.
Prerequisites: Module 1 (Big-O, amortized analysis, cache locality) — bài 08 Case Study Disruptor sẽ nhắc lại trực tiếp bài 03 và 04 của Module 1.
Bài tiếp theo: Array vs ArrayList
Module 1 — Tổng kết & cheat sheet: Nền tảng thuật toán
Bài tiếpArray vs ArrayList — Khi nào primitive thắng wrapper
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này