Linked list — Vì sao production Java gần như không dùng LinkedList
LinkedList.add() là O(1) nhưng production Java gần như không dùng. Bài giải thích cơ chế, constant factor cache miss, và khi nào linked list thực sự thắng.
TL;DR: Linked list lưu dữ liệu trong các node rời rạc trên heap, mỗi node chứa dữ liệu và con trỏ đến node kế tiếp. Chèn/xoá ở đầu là O(1), không cần dời phần tử như array. Nhưng Big-O che giấu hệ số hằng (constant factor) quan trọng: mỗi bước duyệt là một cache miss riêng, nên cộng 10 triệu phần tử qua linked list chậm hơn array 25 lần, dù cùng O(n). Mỗi phần tử còn tốn cỡ 40 byte (Node 24 byte cộng Integer 16 byte), gấp 10 lần array nguyên thuỷ. Vì vậy ArrayList và ArrayDeque thắng ở hầu hết trường hợp.
Tutorial DSA kinh điển dạy: LinkedList.add() là O(1), ArrayList.add() là amortized O(1) — nghe có vẻ tương đương. Vậy khi nào dùng cái nào? Hầu hết học viên kết luận: tuỳ.
Nhưng thử grep một codebase Java đang chạy thật: hầu như không có new LinkedList nào. Nếu O(1) ngang nhau, sao không ai chọn LinkedList?
Bài này giải thích cơ chế bên trong của linked list, vì sao Big-O không nói hết câu chuyện, và những trường hợp hiếm hoi linked list đúng là lựa chọn tốt.
1. Định nghĩa và cấu trúc
1.1 Singly linked list
Mỗi node chứa hai thứ: dữ liệu và con trỏ next trỏ đến node kế tiếp. Node cuối cùng có next = null.
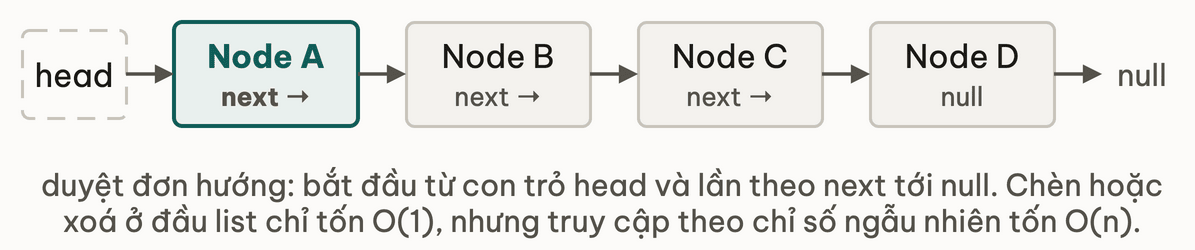
Để duyệt list, bắt đầu từ head và theo next cho đến khi gặp null. Không có cách nào đi ngược lại.
1.2 Doubly linked list
Thêm con trỏ prev để duyệt được hai chiều. Node đầu có prev = null, node cuối có next = null.
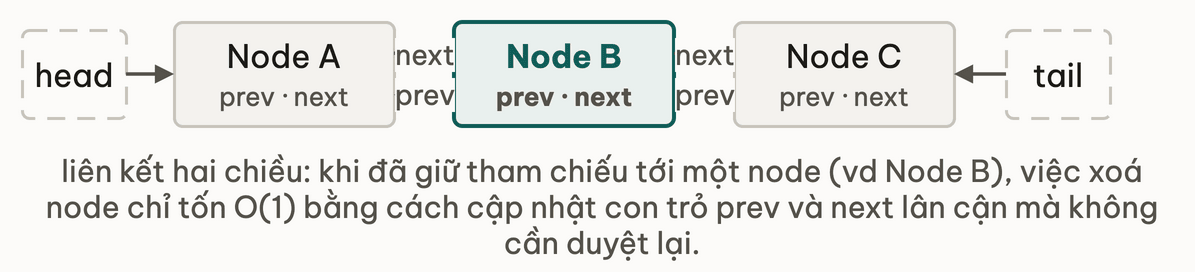
Lợi thế quan trọng: nếu bạn đang giữ tham chiếu (reference) đến một node cụ thể, xoá node đó chỉ tốn O(1): cập nhật prev.next và next.prev mà không cần duyệt từ đầu.
1.3 Pseudocode cấu trúc node
-- Node singly: data, next. Node doubly: thêm prev.
-- Linked list lưu sẵn head, tail, size
LinkedList:
    head   -- node đầu tiên (null nếu rỗng)
    tail   -- node cuối cùng (null nếu rỗng)
    size   -- số phần tử
Lưu sẵn tail là mẹo quan trọng: không có tail, mỗi lần addLast phải duyệt cả list, tốn O(n) thay vì O(1).
2. Operations và complexity
| Operation | Singly | Doubly | Array |
|---|---|---|---|
| Insert head | O(1) | O(1) | O(n) — shift |
| Insert tail (có tail ref) | O(1) | O(1) | amortized O(1) |
| Insert giữa (có node ref) | O(1) | O(1) | O(n) — shift |
| Insert giữa (chỉ có index) | O(n) — phải duyệt tới | O(n) — phải duyệt tới | O(n) — shift |
| Delete head | O(1) | O(1) | O(n) — shift |
| Delete tail | O(n) — phải đi tìm prev | O(1) — có prev ref | O(1) |
| Delete giữa (có node ref) | O(n) — singly cần prev | O(1) | O(n) — shift |
| Random access get(i) | O(n) | O(n) | O(1) |
| Bộ nhớ mỗi phần tử (Java) | ~24 byte node + boxed | ~24 byte node + boxed | 4–16 byte |
Chú ý dòng "delete tail" của singly: dù đã lưu tail, vẫn phải tìm node đứng ngay trước nó, mà không có prev thì phải duyệt từ head. Doubly giải quyết gọn nhờ tail.prev.
3. Pseudocode các operation cốt lõi
3.1 addFirst và addLast
-- addFirst: thêm node mới lên đầu -- O(1)
addFirst(list, data):
    newNode <- Node(data, next=list.head)
    if list.head = null:
        list.head <- newNode      -- list rỗng: head và tail cùng trỏ vào node mới
        list.tail <- newNode
    else:
        newNode.next <- list.head
        list.head <- newNode
    list.size <- list.size + 1
Time: O(1) Space: O(1)
-- addLast: thêm node mới vào cuối -- O(1) vì đã lưu sẵn tail
addLast(list, data):
    newNode <- Node(data, next=null)
    if list.tail = null:
        list.head <- newNode      -- list rỗng
        list.tail <- newNode
    else:
        list.tail.next <- newNode
        list.tail <- newNode
    list.size <- list.size + 1
Time: O(1) Space: O(1)
3.2 removeAfter: vì sao singly list phức tạp hơn
-- Xoá node SAU một node cho trước -- O(1) với singly linked list
-- (cần node đứng trước, không phải node cần xoá)
removeAfter(list, pred):
    if pred = null or pred.next = null: return
    toRemove <- pred.next
    pred.next <- toRemove.next
    if toRemove = list.tail:
        list.tail <- pred         -- cập nhật tail nếu xoá node cuối
    list.size <- list.size - 1

-- Xoá theo giá trị -- O(n) vì phải tìm predecessor trước
remove(list, target):
    if list.head = null: return false
    if list.head.data = target:
        list.head <- list.head.next
        if list.head = null: list.tail <- null
        list.size <- list.size - 1
        return true
    prev <- list.head
    while prev.next != null:
        if prev.next.data = target:
            if prev.next = list.tail: list.tail <- prev
            prev.next <- prev.next.next
            list.size <- list.size - 1
            return true
        prev <- prev.next
    return false
Time: O(n) Space: O(1)
Điểm đáng nhớ: singly linked list không thể xoá một node bất kỳ trong O(1) nếu chỉ có pointer đến chính node đó. Phải biết node đứng trước (prev) để cập nhật prev.next, và nếu không có prev thì phải duyệt từ head để tìm. Doubly linked list giải quyết bằng node.prev.
3.3 Diagram delete node
Trước: [A] --> [B] --> [C] --> [D] --> null
                ^
               pred

Xoá [C]: pred.next = C.next = D
Sau:   [A] --> [B] --> [D] --> null
Thử sắp xếp các bước cập nhật con trỏ khi xoá node toRemove đứng sau pred:
Đưa từng dòng vào khung lời giải rồi xếp cho đúng thứ tự. Kho có thể chứa dòng thừa.
Kho dòng (8)
list.size = list.size - 1pred.next = toRemovepred.next = toRemove.nextif pred == null or pred.next == null: returntoRemove = pred.nextlist.tail = predif toRemove == list.tail:list.tail = toRemove
Lời giải của bạn (0/6)
Chưa có dòng nào. Bấm “Đưa vào” ở trên.
Gợi ý: Nối vòng qua node cần xoá: pred.next trỏ thẳng tới toRemove.next. Nếu node bị xoá là tail thì lùi tail về pred.
Thử ngẫmmục 3.2 vừa chỉ ra xoá C cần pred.next = C.next, nhưng tìm pred mới là phần tốn O(n) ở singly list. tail.prev của doubly xoá bỏ bước tìm đó bằng cách nào?
4. Cache penalty: thứ Big-O không nói
Đây là lý do chính khiến LinkedList ít xuất hiện trong code thật. Bài cache locality ở Module 1 đã đo con số: cộng 10 triệu int qua array nguyên thuỷ mất khoảng 8ms, qua linked list mất khoảng 200ms, chênh 25 lần dù cả hai đều O(n).
Vì sao? Mỗi node trong java.util.LinkedList là một object riêng, được cấp phát trên heap vào lúc add. Theo thời gian, các node nằm rải rác ở những địa chỉ không liền nhau:
Array nguyên thuỷ — nằm liên tiếp trong bộ nhớ:
[1][2][3][4][5][6][7][8]...[16]   -- 1 cache line (64 bytes) = 16 int
  ^-- prefetcher nạp cả khối, 16 phần tử với 1 cache miss

LinkedList<Integer> — nằm rải rác trên heap:
Node@0x1A00 --> Node@0x8F40 --> Node@0x3B80 --> Node@0xC120
   |MISS|           |MISS|           |MISS|           |MISS|
   100ns            100ns            100ns            100ns
Mỗi bước duyệt là một lần lần theo pointer (pointer chase): CPU phải đọc node kế tiếp từ một địa chỉ ngẫu nhiên, không đoán trước được, nên prefetcher của phần cứng bó tay. Mỗi node là một cache miss riêng, thay vì cả 16 phần tử chia nhau một cache miss như array nguyên thuỷ.
Thêm vào đó, java.util.LinkedList.Node chiếm khoảng 24 byte (object header 12 + item 4 + prev 4 + next 4, đã là bội số của 8 nên không cần đệm thêm), cộng Integer boxed 16 byte, tổng 40 byte mỗi phần tử. So với 4 byte của array nguyên thuỷ: gấp 10 lần RAM. 10 triệu phần tử: array nguyên thuỷ khoảng 40 MB, linked list khoảng 400 MB.
Bài cache locality ở Module 1 phân tích đầy đủ phân cấp bộ nhớ, cache line và prefetcher, nếu chưa rõ vì sao lần theo pointer lại đắt thì nên đọc bài đó trước.
5. Các bẫy hay gặp
Bẫy 1: linkedList.add(index, value) không phải O(1):
-- BUG: tưởng "chèn vào linked list là O(1)"
L <- LinkedList với 100.000 phần tử

for i <- 0 đến 999:
    L.add(50000, i)     -- O(n) để duyệt tới index + O(1) để nối pointer = O(n) tổng

-- 1000 lần x O(n) với n = 100.000: cỡ 5x10^7 bước duyệt, và lặp n lần thì thành O(n²)

-- ĐÚNG: dùng ListIterator nếu cần chèn liên tiếp
it <- L.listIterator(50000)
for i <- 0 đến 999:
    it.add(i)           -- O(1) nối pointer, vì iterator đã đứng sẵn ở vị trí đó
Time bug: O(n²) Time correct: O(n + 1000)
LinkedList.add(index, value) gọi method node(index) bên trong: nó duyệt từ head hoặc tail đến vị trí đó, tốn O(n/2). Chỉ bước nối pointer sau đó mới là O(1). Gọi trong vòng lặp n lần thì thành O(n²), rất nguy hiểm với list lớn.
Bẫy 2: list.get(i) trên linked list trông gọn nhưng tốn kém:
Linked list cũng có get(index), và người học hay nhầm nó là O(1) như ArrayList. Đây thực chất là một vòng lặp lồng nhau ngầm: vòng ngoài chạy n lần, mỗi lần get(i) lại tự chạy một vòng duyệt bên trong.
LinkedList<Integer> list = new LinkedList<>();
// ... danh sách chứa 100.000 phần tử ...
long sum = 0;
for (int i = 0; i < list.size(); i++) {
  sum += list.get(i); // <-- Điểm thắt hiệu năng O(n²)
}-- ĐÚNG: dùng for-each (iterator chạy ngầm -- O(1) mỗi bước)
for each item trong L:
process(item)
Time bug: O(n²) Time correct: O(n)
Nếu hay phải truy cập theo index, linked list là lựa chọn sai. ArrayList nằm liên tiếp trong array nên get(i) là O(1) (nhảy thẳng vào ô nhớ), còn linked list phải duyệt từ đầu, tốn O(n).
Bẫy 3: "Linked list không resize nên tốn ít bộ nhớ hơn": nghe có lý, nhưng ngược lại. Với 1 triệu phần tử, ArrayList tốn cỡ 23 MB (kể cả phần chừa trống), còn linked list tốn cỡ 40 MB (Node 24 byte cộng Integer 16 byte), lại thêm nhiều object nhỏ cho GC theo dõi.
6. Khi nào linked list thực sự thắng
Có hai trường hợp linked list là lựa chọn đúng, và đều là cấu trúc xây trên linked list chứ không phải dùng java.util.LinkedList cho mọi thứ.
Trường hợp 1 — Xây LRU cache:
LRU (Least Recently Used, tức bỏ phần tử lâu nhất chưa dùng) cache cần hai thứ: tra cứu O(1) và chèn/xoá O(1) ở hai đầu. Ghép HashMap (tra nhanh) với doubly linked list (đổi thứ tự nhanh): khi một key được truy cập, gỡ node của nó khỏi vị trí hiện tại và đưa lên đầu. Cả hai thao tác đều O(1) vì HashMap trả thẳng reference đến node.
ArrayList không làm được vậy: xoá ở index bất kỳ là O(n) vì phải dời phần tử. Mini-challenge LRU cache ở bài 07 sẽ cài đặt đầy đủ. Trong Java, LinkedHashMap với accessOrder=true chính là HashMap cộng doubly linked list này; cơ chế nằm ở HashMap internals.
Trường hợp 2 — Cấu trúc lớn tự thiết kế:
B+tree nối các node lá bằng linked list để quét theo khoảng (range scan) nhanh. Skip list dùng nhiều tầng linked list để tìm kiếm trung bình O(log n), và Redis ZSET cài bằng skip list. Đây đều là cấu trúc tự thiết kế, không phải java.util.LinkedList.
LinkedList trong Java cũng là một Deque và hay được dùng làm Queue. Nhưng ArrayDeque (circular buffer trên mảng nền) thường thắng nhờ cache locality. Chỉ dùng linked list làm Queue khi cần queue không giới hạn kích thước mà thời gian chèn phải ổn định, hoặc cần xoá phần tử bất kỳ ở giữa.
7. Dùng ở đâu trong thực tế
Linux kernel list.h: kernel Linux dùng doubly linked list rất nhiều (task scheduler, device driver, filesystem). Nhưng đó là C: các struct được cấp phát từ vùng nhớ liền nhau (slab allocator) nên node kề nhau thường gần nhau về địa chỉ, ít đau hơn object rải rác trên heap Java.
ConcurrentLinkedQueue: Queue không dùng lock, cài theo thuật toán Michael-Scott: dùng CAS (Compare-And-Swap, so sánh rồi đổi trong một bước nguyên tử) trên head/tail thay vì lock. Cấu trúc liên kết cho phép nhiều bên đẩy/lấy cùng lúc mà không cần một lock chung. Cơ chế CAS xem ở Atomic và CAS.
8. Đào sâu: tài liệu gốc
Source code và spec:
- OpenJDK 21 — LinkedList.java, Đọc
Nodeinner class,linkFirst()/linkLast()/unlink(), vànode(int index)để thấy cách tối ưu duyệt từ head hoặc từ tail.
Cross-link:
- Chaining trong Hash Table: danh sách liên kết giải quyết va chạm.
- Array vs ArrayList: so sánh truy cập O(1) vs O(n).
- Module 1: Memory model và cache locality: Giải thích đầy đủ phân cấp cache, prefetcher và việc lần theo pointer, làm nền để hiểu vì sao có con số 25 lần.
- Khoá Java — JVM Internals: Object header, compressed OOPs, heap layout, để hiểu vì sao
Nodechiếm 24 byte.
9. Tóm tắt
- Muốn xoá node bất kỳ trong O(1) thì phải có
prev(doubly linked list) và giữ sẵn reference tới node đó; singly list phải đi tìm node đứng trước. LinkedList.add(index, value)vàget(i)đều O(n) vì phải duyệt tới vị trí đó. Chèn hoặc duyệt trong vòng lặp thì dùngListIteratorhoặc for-each, đừng gọi theo index.- Cache miss mỗi node (~100ns) làm linked list duyệt chậm hơn array khoảng 25 lần, và tốn RAM gấp 10 lần (40 byte so với 4 byte mỗi
int). - Linked list chỉ thắng khi cần node reference sẵn: LRU cache (HashMap + doubly linked list), nối list O(1), hoặc cấu trúc tự thiết kế như skip list.
- Mặc định chọn
ArrayListcho list thông thường,ArrayDequecho stack/queue;LinkedListchỉ khi đã đo benchmark.
10. Tự kiểm tra
- Q1Vì sao linkedList.add(index, value) không phải O(1) dù tutorial nói linked list insert là O(1)?
- Q2Singly vs doubly linked list: đánh đổi về bộ nhớ và chi phí thao tác khác nhau thế nào?
- Q3Cache locality khiến LinkedList<Integer> chậm hơn array nguyên thuỷ 25 lần. Con số 25 đến từ đâu?
- Q4Vì sao kernel Linux dùng danh sách liên kết rất nhiều trong code C (list.h), nhưng Java production lại khuyến cáo tránh LinkedList?
- Q5LRU cache cần linked list. Vì sao cấu trúc đó còn cần cả HashMap?
Bài tiếp theo: Stack — LIFO, call stack, undo
Array vs ArrayList — Khi nào primitive thắng wrapper
Bài tiếpStack — LIFO từ chồng đĩa đến JVM call stack
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này