Amortized analysis — ArrayList.add() O(1) dù đôi khi tốn O(n)
ArrayList.add() là O(1) amortized dù đôi khi tốn O(n). Bài giải thích 3 phương pháp phân tích amortized, lý do chọn growth factor 1.5x, và khi nào amortized lừa bạn.
TL;DR: Amortized O(1) nghĩa là trung bình trên cả dãy thao tác (kể cả dãy xấu nhất), mỗi thao tác tốn hằng số thời gian, dù từng lần riêng lẻ đôi khi đắt. ArrayList dùng mảng nội bộ tự mở rộng: mỗi lần đầy thì sao chép toàn bộ sang mảng mới lớn hơn (O(n)), nhưng sau đó có nhiều chỗ trống cho các lần add tiếp theo (O(1)). Tổng n lần add tốn dưới 2n phép tính nên amortized là O(1). Growth factor là đánh đổi giữa số lần resize và RAM thừa; Java chọn 1.5x, và một lập luận về việc allocator tái dùng vùng nhớ cũ (cần factor nhỏ hơn golden ratio ≈ 1.618) thường được nêu như lý do phụ. Amortized không bảo vệ khi workload ép thao tác đắt liên tiếp. Biết trước kích thước thì pre-allocate capacity để khỏi resize.
Bạn benchmark một triệu lần thêm phần tử vào mảng động. Đa số lần chạy chỉ vài chục nano giây. Nhưng cứ thỉnh thoảng (cỡ 30 lần trong cả triệu lần) thời gian nhảy vọt lên hàng nghìn lần. Nhìn vào profiler, bạn thấy đó là các thời điểm mảng nội bộ phải resize.
Vậy hàm add là O(1) hay O(n)?
Câu trả lời là amortized O(1) — nghĩa là trung bình trên toàn bộ dãy thao tác, mỗi lần add tốn hằng số thời gian, dù từng lần riêng lẻ đôi khi tốn O(n). Tài liệu ArrayList ghi rõ: "The add operation runs in amortized constant time."
Bài này giải thích amortized từ gốc: ba phương pháp phân tích, vì sao growth factor là bài toán đánh đổi, và lúc nào amortized giúp bạn, lúc nào nó đánh lừa bạn.
Ôn lại kiến thức nền tảng từ bài big o from essence trước khi đi sâu vào nội dung bài học này.
1. Hình dung: tem bưu điện
Hầu hết các ngày, bạn mua một con tem để gửi thư, tốn 1.000 VND. Thỉnh thoảng bạn mua cả hộp 100 con, tốn 100.000 VND cho một giao dịch.
Giao dịch đó đắt gấp 100 lần mua lẻ. Nhưng nhìn lại 100 lần dán tem kế tiếp, chi phí trung bình mỗi lần vẫn là 1.000 VND, vì hộp tem dùng cho cả 100 lần sau.
Amortized là cách nhìn đó: rải chi phí của một lần đắt ra nhiều lần thao tác rồi lấy trung bình.
| Đời thường | Concept |
|---|---|
| Mỗi lần dán tem | Mỗi lần gọi add() |
| Mua lẻ từng con | Insert bình thường, O(1) |
| Mua hộp 100 con | Resize: sao chép toàn bộ mảng, O(n) |
| Hộp dùng cho 100 lần tiếp theo | Capacity mới đủ cho các add() kế tiếp |
| Chi phí trung bình 1.000 VND/con | Amortized O(1) mỗi lần add() |
Amortized là rải chi phí đắt của một thao tác ra nhiều thao tác rẻ xung quanh. Trung bình trên cả dãy vẫn là hằng số.
2. Ba khái niệm: amortized, average, worst-case
Đây là điểm hay bị nhầm nhất:
Worst-case per operation: chi phí của từng thao tác riêng lẻ trong tình huống xấu nhất. add() worst case là O(n), khi xảy ra resize và phải sao chép n phần tử.
Average case: trung bình trên các input ngẫu nhiên theo một phân bố giả định. Nó phụ thuộc vào việc bạn giả định input đến thế nào, nên nếu giả định sai thì average case vô nghĩa.
Amortized: trung bình trên một dãy thao tác liên tiếp, kể cả dãy xấu nhất, không dựa vào phân bố ngẫu nhiên. Đảm bảo này mạnh hơn average: input xấu cỡ nào thì trung bình cả dãy vẫn là hằng số.
| Khái niệm | Giả định về input | Ví dụ add() | Ví dụ quicksort |
|---|---|---|---|
| Worst-case per op | Không có | O(n) khi resize | O(n²) khi pivot tệ |
| Average case | Input random | O(1) (resize hiếm) | O(n log n) trung bình |
| Amortized | Worst-case sequence | O(1), chứng minh được | Không áp dụng trực tiếp |
Lưu ý: với bảng băm, tài liệu nói "amortized O(1)" nhưng thực ra là average case với giả định hàm hash tốt (bài 01 đã nhắc). Mảng động mới có amortized O(1) theo nghĩa chặt.
3. Ba phương pháp phân tích amortized
3.1 Phương pháp tổng hợp: đếm tổng rồi chia
Cách đơn giản nhất: tính tổng chi phí của n thao tác, chia cho n.
Áp dụng cho mảng động với grow factor 2x, bắt đầu từ capacity 1:
n lần add():
- add() lần 1: capacity = 1, không resize. Chi phí = 1.
- add() lần 2: resize từ 1 lên 2, sao chép 1 phần tử. Chi phí = 1 + 1 = 2.
- add() lần 3: resize từ 2 lên 4, sao chép 2 phần tử. Chi phí = 1 + 2 = 3.
- add() lần 5: resize từ 4 lên 8, sao chép 4 phần tử. Chi phí = 1 + 4 = 5.
- Hầu hết lần add(): không resize. Chi phí = 1.
Tổng chi phí sau n lần add():
- Chi phí sao chép (tổng cộng):
1 + 2 + 4 + 8 + ... + n/2, chuỗi hình học bằngn - 1. - Chi phí insert:
n(mỗi lần add tốn 1). - Tổng:
n + (n - 1) < 2n.
Amortized cost mỗi op: 2n / n = 2 = O(1).
3.2 Phương pháp kế toán: trả trước, rút sau
Mỗi thao tác bị "tính phí" nhiều hơn chi phí thực, phần dư tích vào tài khoản. Khi thao tác đắt xảy ra, ta rút tài khoản để bù.
Với mảng động grow 2x: gán amortized cost = 3 cho mỗi add():
- 1 đơn vị để chạy insert.
- 1 đơn vị trả trước cho chi phí sao chép bản thân khi resize sau này.
- 1 đơn vị trả trước cho sao chép một phần tử cũ khi resize.
Tại sao 3 đơn vị là đủ?

Sau khi resize lên capacity = 2k (từ k):
- Có k phần tử cần sao chép.
- Các add() tiếp theo: k lần add trước khi resize tiếp.
- Mỗi lần add tích 2 đơn vị vào tài khoản -> k * 2 = 2k đơn vị.
- Resize tiếp theo sao chép 2k phần tử: dùng hết 2k đơn vị.
- Tài khoản không bao giờ âm.
Amortized cost = 3 = O(1) mỗi add().
3.3 Phương pháp thế năng: đo "tiềm năng nợ"
Định nghĩa hàm Φ(trạng thái) đo lượng "công nợ tích lũy" trong cấu trúc dữ liệu. Amortized cost được tính:
amortized_cost(op) = actual_cost(op) + ΔΦ
                   = actual_cost(op) + Φ(sau) - Φ(trước)
Với mảng động: Φ = 2 × size - capacity.
- Sau resize:
size = k, capacity = 2k→Φ = 2k - 2k = 0. - Mỗi add() không resize:
sizetăng 1,capacitykhông đổi →ΔΦ = 2. - Amortized cost =
1 (insert) + 2 (ΔΦ) = 3.
Khi resize xảy ra (add vào lúc size = k = capacity, capacity mới là 2k):
actual_cost = k + 1(sao chép k phần tử, rồi insert 1).Φ_trước = 2k - k = k.Φ_sau = 2(k+1) - 2k = 2.ΔΦ = 2 - k.- Amortized cost =
(k + 1) + (2 - k) = 3.
Cả hai trường hợp đều cho amortized cost = 3, tức O(1). Phương pháp thế năng mạnh hơn tổng hợp/kế toán khi cần phân tích cấu trúc dữ liệu phức tạp hơn.
Đây là pseudocode logic grow của mảng động:
-- Mở rộng mảng nội bộ khi đầy.
-- oldCapacity >> 1 là dịch bit phải 1: tương đương chia 2.
-- newCapacity = oldCapacity + oldCapacity/2 = 1.5 * oldCapacity.
grow(A, minCapacity):
    oldCapacity <- A.capacity
    newCapacity <- oldCapacity + (oldCapacity >> 1)   -- factor 1.5x
    newArray <- allocate(newCapacity)
    copy(A.data, newArray, A.size)
    A.data <- newArray
    A.capacity <- newCapacity

Time: O(n)  Space: O(n) -- sao chép n phần tử
Thử ngẫmphương pháp tổng hợp ra dưới 2 đơn vị mỗi add, còn kế toán và thế năng ra 3. Hai con số khác nhau mà cả hai đều đúng. Vì sao không mâu thuẫn?
4. Vì sao 1.5x mà không phải 2x hay 1.1x
Growth factor kéo hai thứ theo hai hướng ngược nhau:
- Factor lớn: ít lần resize, ít sao chép, tốt cho thời gian, nhưng tốn nhiều RAM thừa.
- Factor nhỏ: ít RAM thừa, nhưng resize liên tục nên sao chép nhiều.
2x là lựa chọn kinh điển trong giáo trình, vì phép tính đơn giản cho phân tích tổng hợp. Một số thư viện chuẩn C++ dùng 2x.
1.5x là lựa chọn của Java ArrayList và MSVC, ít RAM thừa hơn 2x.
Ngoài ra còn một lập luận về allocator. Xét dãy capacity 1, r, r², .... Khi cần block mới cỡ r^k, block r^(k-1) vẫn đang được sao chép nên chưa trả lại được. Chỉ các block cũ hơn, tổng 1 + r + ... + r^(k-2), là vùng nhớ trống mà allocator có thể tái dùng. Muốn block mới nằm vừa trong vùng đó thì tổng này phải đạt ít nhất r^k.
- Với
r = 2: tổng các block cũ chỉ là2^(k-1) - 1, chưa bằng nửa block mới nên không bao giờ đủ. - Với
r = 1.5: tổng các block cũ vượt block mới từ block thứ 5 trở đi.
Ngưỡng chia hai trường hợp là golden ratio φ ≈ 1.618: factor nhỏ hơn φ thì vùng nhớ cũ rồi sẽ đủ chứa block mới. Đây là lập luận trên giấy; allocator thật và GC của JVM không nhất thiết tái dùng vùng nhớ theo cách này, nên coi nó là lý do phụ, còn lý do chính vẫn là đánh đổi giữa số lần resize và RAM thừa.
1.1x thì resize quá thường: 1 triệu phần tử cần hàng trăm lần resize thay vì vài chục.
| Growth factor | Số lần resize cho 1 triệu phần tử | RAM waste (worst case) | Ghi chú |
|---|---|---|---|
| 1.1x | ~145 lần | Thấp (~10%) | Resize quá thường xuyên |
| 1.5x | ~34 lần | Trung bình (~50%) | Java ArrayList, cân bằng tốt |
| 2x | ~20 lần | Cao (~100%) | C++ libc++ vector, đơn giản |
Với workload chèn nhiều và RAM dồi dào, 2x ít sao chép hơn. Với môi trường container (giới hạn RAM 512MB, nhiều mảng động nhỏ), 1.5x hiệu quả hơn.
Thử ngẫmserver của bạn chạy trong container giới hạn 512MB, tạo hàng nghìn ArrayList nhỏ. Chọn factor 2x thay vì 1.5x ở đây tốn thêm bao nhiêu RAM, theo bảng trên?
5. Sơ đồ chi phí resize
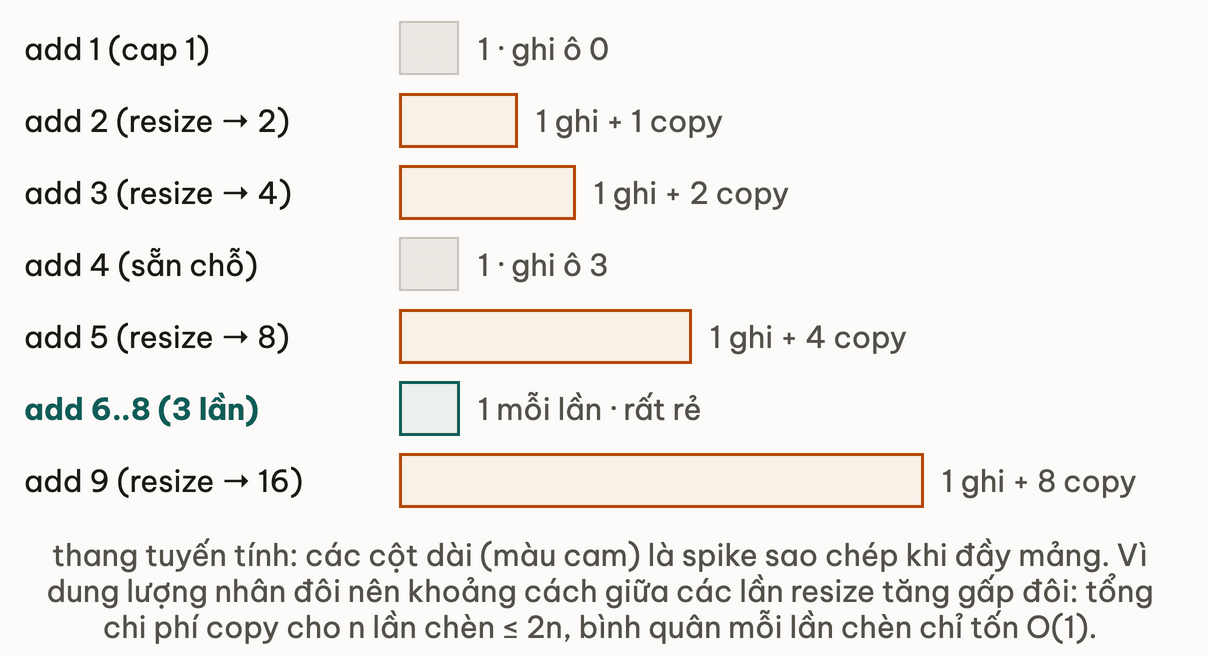
6. Các bẫy: khi amortized không đủ
Bẫy 1: amortized sụp đổ khi bạn ép thao tác đắt liên tiếp.
Giả sử một mảng động vừa tự co lại khi xóa (ArrayList của Java thì không co, nhưng nhiều cài đặt tự viết có). Workload insert tới ngưỡng resize, xóa vài phần tử, insert lại tới ngưỡng, xóa tiếp... thì mỗi vòng đều resize. Amortized O(1) dựa trên việc nhiều thao tác rẻ trước đó đã "trả trước" cho thao tác đắt. Nếu thao tác đắt xảy ra liên tục, giả định đó không còn đúng.
-- Trường hợp bệnh lý (mảng động tự co lại khi xóa): insert đến ngưỡng, remove, insert, remove...
-- Mỗi vòng trigger resize. Đảm bảo amortized KHÔNG giữ.
-- capacity = 8
for round <- 1 đến 1000:
    while list.size < 8: list.add(0)    -- điền đầy đến capacity
    list.remove(list.size - 1)          -- giảm xuống dưới ngưỡng
    list.add(0)                         -- trigger resize mỗi lần
    list.remove(list.size - 1)          -- remove lại
Nếu biết trước size tối đa, dùng new ArrayList<>(initialCapacity) để tránh resize hoàn toàn.
Bẫy 2: code real-time và nhạy latency, nơi worst case quan trọng hơn amortized.
Amortized O(1) nghĩa là trung bình tốt. Nhưng lần tệ nhất vẫn là O(n), và nó sẽ xảy ra. Với:
- UI rendering: resize mảng trong render loop gây frame drop.
- Audio buffer: độ trễ tăng vọt làm vỡ audio stream.
- HFT (giao dịch tần suất cao): resize trong hot path có thể trượt time window.
Trong các trường hợp đó, pre-allocate với capacity đã biết để loại bỏ resize hoàn toàn. Amortized O(1) tốt cho throughput, không tốt cho jitter (độ trễ dao động thất thường).
Thử ngẫmhệ thống audio streaming của bạn dùng ArrayList trong hot path và thỉnh thoảng giật hình. Amortized O(1) có sai lời hứa không, hay bạn đang đo nhầm thứ?
7. Dùng ở đâu trong thực tế
Mảng động trong OpenJDK
Đoạn grow() ở mục 3.3 chính là logic của ArrayList. Phép dịch bit >> 1 tương đương chia 2. Cộng lại: oldCapacity + oldCapacity / 2 = 1.5 × oldCapacity. Xem source ArrayList.java tại GitHub OpenJDK để thấy trường hợp biên khi oldCapacity rất lớn làm tràn số. Muốn biết ArrayList làm gì khi add() khiến mảng đầy, và đo chi phí resize trên số liệu thật, xem ArrayList grow.
StringBuilder
Mảng ký tự bên trong tự mở rộng giống mảng động, thường gấp đôi khi đầy. Vì vậy nối chuỗi bằng StringBuilder trong vòng lặp nhanh hơn dùng toán tử + rất nhiều:
-- O(n²) tổng: mỗi lần + tạo một chuỗi mới, sao chép tất cả ký tự đã có
result <- ""
for i <- 0 đến n-1:
    result <- result + "x"      -- tạo chuỗi mới mỗi lần, sao chép toàn bộ

-- O(n) tổng: StringBuilder tái dùng mảng nội bộ, chỉ sao chép khi resize
sb <- StringBuilder rỗng
for i <- 0 đến n-1:
    sb.append("x")              -- amortized O(1) mỗi lần gọi
result <- sb.toString()         -- một lần sao chép cuối cùng
Nối chuỗi bằng + tạo chuỗi mới mỗi lần, chi phí sao chép tích lũy 1 + 2 + ... + n, tức O(n²) cho n lần ghép. Cấu trúc đó giống một vòng lặp lồng nhau (vòng trong dài dần), nếu chưa quen đếm thì ôn ở Lặp lồng nhau. StringBuilder mở rộng mảng giống mảng động, tổng chi phí O(n).
8. Đào sâu: tài liệu gốc
Spec / reference chính thức:
- CLRS — Introduction to Algorithms, Chapter 17: Amortized Analysis — định nghĩa chặt chẽ 3 phương pháp aggregate, accounting, potential với chứng minh cho dynamic table. Đây là nguồn chuẩn của bài này.
- Tarjan 1985 — "Amortized Computational Complexity" — paper gốc của Tarjan trên SIAM J. Algebraic Discrete Methods giới thiệu potential method. Ít trang nhưng đặc kiến thức, đọc sau khi nắm CLRS Ch.17.
- OpenJDK ArrayList.java — GitHub — source grow() method và comment về 1.5x.
Bài liên quan trong khoá học:
- Array vs ArrayList: chiến lược nhân đôi mảng động.
- ArrayList.grow() trong JDK: hệ số nở 1.5x thực tế.
9. Tóm tắt
Khi gặp một thao tác ghi "amortized O(1)", hãy hỏi:
- Đó là amortized thật (đảm bảo trên mọi dãy thao tác) hay average (cần giả định input ngẫu nhiên, như bảng băm)?
- Có dùng được ở chỗ nhạy latency không? Spike
O(n)vẫn xảy ra, chỉ hiếm. - Có biết trước kích thước không? Nếu có, truyền
initialCapacityđể khỏi resize. - Cần chứng minh? Chọn một trong ba cách: tổng hợp (tổng chia n), kế toán (trả trước), thế năng (hàm Φ).
- Nối chuỗi trong vòng lặp thì dùng StringBuilder, đừng dùng
+.
10. Tự kiểm tra
- Q1Vì sao 1.5x có thể được ưa hơn 2x cho mảng động? Lập luận nào liên quan đến memory allocator, và nó đáng tin tới đâu?
- Q2add() là O(1) amortized, vậy lời khẳng định đó sai khi nào? Mô tả một dãy thao tác cụ thể làm mất đảm bảo amortized.
- Q3Phân biệt amortized vs average vs worst-case bằng một ví dụ cụ thể — dùng mảng động hoặc QuickSort.
- Q4Cho mảng động tùy chỉnh với grow factor 3x (gấp ba khi đầy). Phân tích amortized cost mỗi add() bằng phương pháp tổng hợp.
- Q5Khi nào không nên tin vào amortized analysis trong production? Cho ít nhất hai loại use case cụ thể.
- Q6StringBuilder nhanh hơn nối chuỗi bằng + trong vòng lặp vì sao? Liên hệ với amortized analysis.
Bài tiếp theo: Memory model & cache locality
Recursion & call stack — Khi đệ quy phá vỡ giới hạn ngăn xếp
Bài tiếpCache locality — Vì sao mảng nhanh hơn linked list 25 lần
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Ôn phỏng vấn
Bài này trả lời được các câu phỏng vấn sau — tự trả lời thử trước khi mở đáp án.
Thảo luận & góp ý
Hỏi đáp về bài này