Độ phức tạp Big-O từ bản chất — Theta, Omega, amortized intro
Big-O đo tốc độ tăng trưởng khi n lớn — không phải thời gian tuyệt đối. Bài phân biệt O/Theta/Omega, 7 complexity class, và pitfall khiến O(n log n) chậm hơn O(n²).
TL;DR: Big-O đo tốc độ tăng của số bước chạy khi n lớn, không phải thời gian tuyệt đối. Ta bỏ constant và hạng bậc thấp vì ở n đủ lớn, hạng bậc cao nuốt hết phần còn lại. Ba ký hiệu: O (chặn trên, không tệ hơn), Theta (chặn chặt, đúng bằng), Omega (chặn dưới, không tốt hơn). Có bảy class chuẩn từ O(1) đến O(n!). Bẫy lớn nhất: Big-O thấp hơn chưa chắc nhanh hơn khi n nhỏ. TimSort dùng Insertion Sort cho đoạn ngắn (cỡ vài chục phần tử) vì constant nhỏ hơn, dù Big-O cao hơn.
Bạn nhận một ticket: tính xem danh sách 100.000 user ID có phần tử trùng không. Bạn viết vòng lặp lồng nhau, test vài trăm phần tử — chạy tốt. Deploy lên production với 100.000 bản ghi thật, request đó mất 10 giây. Đồng nghiệp commit một đoạn thay thế chỉ vài dòng, chạy 5 mili giây. Gấp 2.000 lần, cùng kết quả đúng, cùng ngôn ngữ, cùng máy chủ.
Sự chênh lệch đó đến từ chỗ số bước tăng nhanh chậm khác nhau khi n lớn, và đó là thứ Big-O đo.
Bài này giải thích Big-O từ gốc: vì sao bỏ constant vẫn đúng, phân biệt O / Theta / Omega, 7 complexity class kèm pseudocode, và những bẫy khiến dev hiểu nhầm "Big-O thấp hơn là luôn nhanh hơn".
1. Hình dung: tìm tên trong danh bạ điện thoại
Bạn cần tìm số điện thoại của Nguyễn Văn Trung trong cuốn danh bạ 10.000 trang, sắp xếp theo tên.
Cách 1, duyệt tuần tự: lật từng trang từ đầu, đọc tên, so sánh. Xui thì lật hết 10.000 trang. Danh bạ dày gấp đôi → mất gấp đôi thời gian.
Cách 2, chia đôi: mở giữa sách. Trung đứng sau trang giữa → bỏ nửa đầu. Mở giữa nửa còn lại. Tiếp tục. Sau 14 lần chia đôi, tìm thấy (vì 2^14 = 16.384). Danh bạ dày gấp đôi → chỉ cần thêm 1 bước.
| Đời thường | Thuật toán |
|---|---|
| Cuốn danh bạ | Dãy đầu vào kích thước n |
| Lật từng trang | Duyệt tuần tự — O(n) |
| Chia đôi mỗi bước | Tìm kiếm nhị phân — O(log n) |
| Số trang danh bạ | Kích thước đầu vào n |
| Số bước phải chạy | Thời gian chạy T(n) |
| Tăng gấp đôi số trang | Tăng n lên 2n |
Big-O đo tốc độ tăng của số bước khi n tăng — không phải số bước tuyệt đối. Danh bạ 10.000 trang hay 20.000 trang, tìm kiếm nhị phân vẫn chỉ thêm 1 bước.
2. Hai cách giải hasDuplicate — gấp 2.000 lần
Đây là thuật toán gây ra ticket 10 giây ở đầu bài:
-- Kiểm tra có phần tử trùng không -- O(n²)
-- Với mỗi cặp (i, j), so sánh. Tổng: n*(n-1)/2 lần so sánh.
hasDuplicateNaive(A):
    for i <- 0 đến n-1:
        for j <- i+1 đến n-1:
            if A[i] = A[j]: return true
    return false

Time: O(n²)  Space: O(1)
Với n = 100.000, vòng lặp trong chạy tổng cộng 100.000 × 99.999 / 2 ≈ 5 tỷ lần so sánh. Ở tốc độ khoảng 500 triệu phép mỗi giây → 10 giây.
Và đây là thuật toán thay thế chạy trong 5ms:
-- Kiểm tra có phần tử trùng không -- O(n)
-- Một lượt: thêm từng phần tử vào tập đã thấy.
-- Nếu add() trả về false (đã có), tồn tại trùng.
hasDuplicateFast(A):
    seen <- Set rỗng
    for each x trong A:
        if x đã có trong seen: return true
        seen.add(x)
    return false

Time: O(n)  Space: O(n)
Lookup trong Set chạy O(1) amortized (giải thích ở mục 7). Vòng lặp chạy tối đa n lần nên tổng là O(n). Với n = 100.000: 100.000 phép thay vì 5 tỷ, tức 50.000 lần ít hơn.
Thử ngẫmhasDuplicateFast tốn thêm bộ nhớ O(n) cho Set mà hasDuplicateNaive không cần. Nếu n = 100.000 nhưng RAM chỉ đủ cho vài nghìn phần tử, bạn còn đổi được không?
3. Định nghĩa: Big-O, Theta, Omega
3.1 Big-O đo gì
Big-O không đo thời gian chạy tuyệt đối. Nó đo chặn trên của tốc độ tăng (upper bound) khi n lớn dần không giới hạn.
Nói dễ hiểu: dù constant cụ thể là bao nhiêu, khi n đủ lớn thì số bước T(n) không vượt quá một bội số nào đó của f(n).
Nói chính thức: T(n) = O(f(n)) nếu tồn tại hằng số c > 0 và n₀ sao cho với mọi n ≥ n₀, T(n) ≤ c × f(n).
3.2 Tại sao bỏ constants
Xét hàm thực tế: T(n) = 3n² + 100n + 5.
Khi n tăng lên:
n = 10:3×100 + 100×10 + 5 = 1.305. Hạng100nchiếm 76%.n = 1.000:3×1.000.000 + 100.000 + 5 ≈ 3.100.005. Hạng3n²chiếm 97%.n = 1.000.000:3n²chiếm 99,997%.
Ở n lớn, 3n² nuốt các hạng còn lại. Constant 3 cũng mờ dần: phần cứng nhanh gấp đôi thì 3 thành 1.5, nhưng bậc vẫn là n². Phần cứng tốt hơn cải thiện constant, không cải thiện bậc.
Kết quả: T(n) = 3n² + 100n + 5 = O(n²). Ta bỏ hạng bậc thấp và constant của hạng cao nhất.
3.3 Ba ký hiệu — O, Theta, Omega
| Ký hiệu | Ý nghĩa | Mô tả |
|---|---|---|
O(f(n)) | Upper bound (chặn trên) | T(n) không tăng nhanh hơn f(n) |
Ω(f(n)) | Lower bound (chặn dưới) | T(n) không tăng chậm hơn f(n) |
Θ(f(n)) | Tight bound (chặn chặt) | T(n) tăng đúng bằng f(n), cả trên lẫn dưới |
Ví dụ với Merge Sort:
- Best case và worst case đều là
n log n→Θ(n log n). - Viết
O(n log n)vẫn đúng, nhưng lỏng hơn (chỉ nói "không tệ hơn", không nói "chính xác").
Ví dụ với Linear Search:
- Best case: tìm thấy ngay phần tử đầu →
Ω(1). - Worst case: phần tử cuối cùng →
O(n). - Không có
Θđơn giản vì best/worst case khác nhau.
Trong thực tế, dev gần như lúc nào cũng dùng O: ta quan tâm worst case (mức SLA production phải giữ), và "không tệ hơn O(n log n)" an toàn hơn là cam kết một tight bound.
Thử ngẫmtài liệu API bạn đang viết ghi "lookup chạy O(1)". Đây là O, Theta hay Omega, và vì sao chọn đúng ký hiệu lại quan trọng?
4. Bảy complexity class: pseudocode và tốc độ tăng
4.1 O(1): hằng số
Số bước không phụ thuộc n. Lookup trong bảng băm là ví dụ kinh điển:
-- Tra bảng băm: tính hash rồi truy cập ô mảng, không duyệt toàn bộ.
lookup(Map M, key k):
    bucket <- hash(k) mod M.capacity
    return M.buckets[bucket].find(k)

Time: O(1) amortized  Space: O(1)
4.2 O(log n): logarithm
Mỗi bước loại bỏ nửa đầu vào còn lại. Tìm kiếm nhị phân:
-- Tìm kiếm nhị phân trên dãy đã sắp xếp.
-- Mỗi bước thu nhỏ không gian tìm kiếm còn một nửa.
binarySearch(A, target):
    lo <- 0
    hi <- A.length - 1
    while lo <= hi:
        mid <- lo + (hi - lo) / 2      -- tránh tràn số
        if A[mid] = target: return mid
        else if A[mid] < target: lo <- mid + 1
        else: hi <- mid - 1
    return -1                           -- không tìm thấy

Time: O(log n)  Space: O(1)
n = 1.000.000 → tối đa 20 bước (vì log₂(1.000.000) ≈ 20).
4.3 O(n): tuyến tính
Đọc qua từng phần tử một lần:
-- Tính tổng dãy: duyệt đúng một lần, mỗi phần tử được cộng một lần.
sumArray(A):
    total <- 0
    for each x trong A:
        total <- total + x
    return total

Time: O(n)  Space: O(1)
4.4 O(n log n): tuyến tính nhân logarithm
Merge Sort: chia đôi O(log n) lần, mỗi lần gộp mất O(n):
-- Merge Sort: chia đôi đệ quy rồi gộp hai nửa đã sắp xếp.
-- log n cấp chia, mỗi cấp gộp O(n) phần tử.
mergeSort(A, lo, hi):
    if lo >= hi: return
    mid <- (lo + hi) / 2
    mergeSort(A, lo, mid)
    mergeSort(A, mid+1, hi)
    merge(A, lo, mid, hi)           -- gộp hai nửa đã sắp xếp, O(n)

Time: O(n log n)  Space: O(n)
4.5 O(n²): bậc hai
Vòng lặp lồng, mỗi vòng chạy n lần:
-- Bubble Sort: nổi bọt phần tử lớn nhất lên cuối sau mỗi lượt.
bubbleSort(A):
    n <- A.length
    for i <- 0 đến n-2:
        for j <- 0 đến n-i-2:
            if A[j] > A[j+1]:
                swap(A[j], A[j+1])  -- đổi chỗ hai phần tử kề nhau

Time: O(n²)  Space: O(1)
4.6 O(2ⁿ): mũ
Mỗi lần gọi đệ quy sinh ra 2 nhánh con, thành một cây nhị phân:
-- Fibonacci đệ quy thuần túy: mỗi lời gọi sinh ra hai lời gọi con.
-- Cây gọi tăng gấp đôi theo mỗi cấp.
fibNaive(n):
    if n <= 1: return n
    return fibNaive(n-1) + fibNaive(n-2)    -- hai nhánh mỗi cấp

Time: O(2^n)  Space: O(n) -- chiều sâu ngăn xếp
n = 50 → khoảng 40 tỷ lần gọi (con số thật là cỡ 1,6^n, còn 2^n là chặn trên). Với n vừa phải cũng đã không dùng nổi.
4.7 O(n!): giai thừa
Sinh mọi hoán vị:
-- Sinh tất cả hoán vị của dãy: với n phần tử có n! hoán vị.
permute(A, start):
    if start = A.length:
        output(A)           -- in một hoán vị
        return
    for i <- start đến A.length-1:
        swap(A[start], A[i])
        permute(A, start+1)
        swap(A[start], A[i])    -- hoàn tác hoán đổi

Time: O(n!)  Space: O(n) -- chiều sâu đệ quy
Bảng tăng trưởng
| Complexity | n=1 | n=10 | n=100 | n=1.000 | n=1.000.000 |
|---|---|---|---|---|---|
O(1) | 1 | 1 | 1 | 1 | 1 |
O(log n) | 0 | 3 | 7 | 10 | 20 |
O(n) | 1 | 10 | 100 | 1.000 | 1.000.000 |
O(n log n) | 0 | 33 | 664 | 9.966 | 19.931.568 |
O(n²) | 1 | 100 | 10.000 | 1.000.000 | 10^12 |
O(2ⁿ) | 2 | 1.024 | 10^30 | 10^301 | — |
O(n!) | 1 | 3.628.800 | 10^158 | — | — |
Dấu — nghĩa là con số vượt xa khả năng tính toán thực tế.
5. Cơ chế bên dưới: vì sao hạng bậc cao thắng
Ở mục 3.2 bạn đã thấy 100n chỉ còn 3% tổng khi n = 1.000. Lý do: n² so với n hơn nhau đúng n lần, n càng lớn thì khoảng cách càng rộng.
Sơ đồ dưới so sánh các lớp độ phức tạp khi n = 500 theo thang logarit:
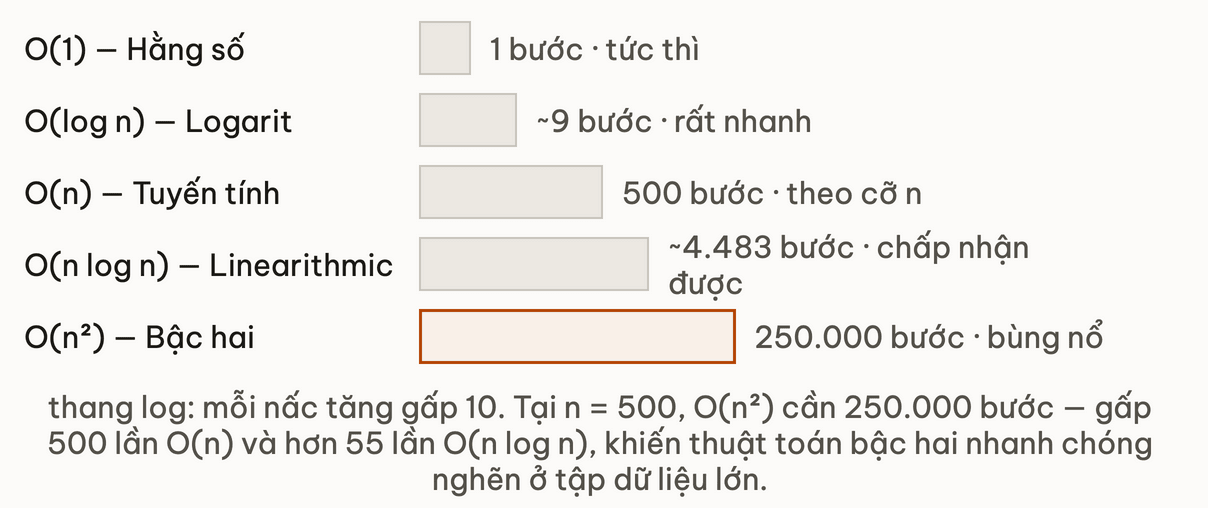
Với bất kỳ đa thức a*n^k + b*n^(k-1) + ... + c: Big-O chỉ giữ hạng bậc cao nhất, bỏ constant. Lý do: tỷ lệ giữa hạng bậc thấp và hạng bậc cao tiến về 0 khi n lớn dần.
6. Các bẫy hay gặp
Bẫy 1: viết O(n) + O(n) = O(2n) rồi dừng ở đó.
-- Hai lượt duyệt tuần tự trên cùng dãy.
-- Tổng: O(n) + O(n) = O(n), KHÔNG phải O(2n).
processTwice(A):
    for each x trong A: print(x)        -- O(n)
    for each x trong A: doSomething(x)  -- O(n)
Hai vòng lặp tuần tự cộng lại thành O(2n), nhưng constant 2 bị bỏ nên tổng là O(n).
Quy tắc: vòng lặp tuần tự thì cộng complexity, nhưng sau đó bỏ constant và hạng thấp.
Bẫy 2: vòng lặp lồng không phải lúc nào cũng O(n²).
-- Outer loop: O(n). Inner loop: tìm kiếm nhị phân O(log n).
-- Tổng: O(n log n), KHÔNG phải O(n²).
findTargets(data, queries):
    sort(data)                              -- O(n log n)
    for each q trong queries:              -- O(n) outer
        binarySearch(data, q)              -- O(log n) inner

Time: O(n log n)
Quy tắc: vòng lặp lồng thì nhân complexity, O(n) × O(log n) = O(n log n). Phân tích từng vòng riêng. Nếu chưa quen đếm số lần chạy của vòng lặp lồng, ôn lại Lặp lồng nhau: bài đó tập đúng việc đếm vòng trong chạy bao nhiêu lần ứng với mỗi vòng ngoài.
Bẫy 3: tin rằng Big-O thấp hơn thì luôn nhanh hơn. Ở n nhỏ, constant quan trọng hơn.
Insertion Sort có O(n²) worst case, Merge Sort có O(n log n). Dễ tưởng Merge Sort luôn thắng. Thực tế:
Insertion Sort có constant rất thấp: ít phép tính, sắp xếp ngay trong mảng gốc nên tận dụng cache tốt, không cần mảng phụ. Merge Sort phải cấp phát mảng phụ và sao chép dữ liệu nhiều lần.
Với đoạn ngắn (cỡ vài chục phần tử), Insertion Sort thường nhanh hơn Merge Sort trong thực đo. Vì vậy TimSort (dùng cho Arrays.sort trên object của Java và list.sort của Python) chia dãy thành các đoạn ngắn, sắp mỗi đoạn bằng Insertion Sort rồi gộp bằng Merge Sort. Ngưỡng đoạn ngắn tuỳ cài đặt (Java dùng 32, Python 32 đến 64).
Quy tắc: Big-O chỉ cho biết thuật toán nào nhanh hơn khi n lớn. Với n nhỏ, hãy đo thực tế và tính cả constant.
Thử ngẫmmột hàm sort chỉ nhận 10 phần tử nhưng dùng đầy đủ Merge Sort. Theo bẫy 3, đổi sang thuật toán nào sẽ chạy nhanh hơn khi đo thực tế?
7. Dùng ở đâu trong thực tế
Hàm sắp xếp trong thư viện chuẩn có cam kết rõ ràng.
Tài liệu ghi O(n log n) nghĩa là sắp xếp một triệu phần tử mất cỡ 20 × 1.000.000 = 20M đơn vị công việc, không phải 10^12. Đừng gọi sort trong vòng lặp nóng nếu dữ liệu đã có thứ tự sẵn.
Tra bảng băm là O(1) amortized, không phải O(1) tuyệt đối.
Bảng băm lưu entry theo hash(key) mod capacity. Nếu hàm hash tốt, mỗi bucket có vài entry — lookup gần như O(1). Nhưng ở worst case, cả n entry rơi vào cùng bucket, phải duyệt danh sách dài n nên mất O(n). Java 8 trở đi "treeify": bucket dài quá ngưỡng thì đổi thành cây đỏ-đen, worst case còn O(log n). Chữ O(1) ở đây nghĩa là trung bình, với giả định hàm hash phân bố đều. Muốn xem treeify chạy thế nào trong Java, đọc HashMap treeify và collision DoS: bài đó chỉ ra ngưỡng chuyển thành cây và vì sao attacker có thể cố ý làm bucket dài.
Query plan của database cho biết O(n) hay O(log n).
Khi thêm WHERE user_id = 123 vào query, có hai kịch bản:
- Không có index: quét toàn bộ bảng
O(n). Bảng 10M hàng → 10M bước. - Có index B-tree: tra theo chiều cao cây,
O(log n). B-tree có fanout lớn (hàng trăm key mỗi node) nên 10M hàng chỉ khoảng 3-4 cấp, ít disk I/O.
Chạy EXPLAIN ANALYZE SELECT ... để thấy plan thật. Cách đọc từng dòng của plan nằm ở định dạng EXPLAIN, đáng đọc nếu bạn chưa quen output này.
8. Đào sâu: tài liệu gốc
Spec / reference chính thức:
- Knuth — "Big Omicron and Big Omega and Big Theta" (1976) — bài báo mà Knuth chuẩn hóa ký hiệu O, Omega, Theta cho khoa học máy tính. Thú vị khi đọc lại vì giải thích vì sao chọn ký hiệu này.
- CLRS — Introduction to Algorithms, Chapter 3: Growth of Functions — định nghĩa toán học đầy đủ O / Omega / Theta / o / omega (small). Giáo trình chuẩn cho mọi thuật toán nghiêm túc.
Bài liên quan trong khoá học:
- Cache locality: vì sao Big-O lý thuyết khác đo đạc thực tế.
- Amortized analysis: chi phí trung bình qua chuỗi thao tác.
- Clock, IPC & Pipeline: ảnh hưởng phần cứng lên hiệu năng.
9. Tóm tắt
Checklist khi bạn đọc hoặc viết một con số Big-O:
- Bỏ constant và hạng bậc thấp, chỉ giữ hạng bậc cao nhất:
3n² + 100n + 5thànhO(n²). - Vòng lặp tuần tự thì cộng rồi bỏ constant. Vòng lặp lồng thì nhân, nhưng phải phân tích từng vòng riêng (vòng trong có thể chỉ là
O(log n)). - Tài liệu API nên ghi
Ocủa worst case. Với bảng băm, nhớ rằngO(1)là amortized và dựa vào hàm hash tốt. - Ở n nhỏ, đo thực tế trước khi kết luận từ Big-O.
- Với database,
EXPLAINcho thấyO(n)(quét toàn bộ) hayO(log n)(dùng index).
10. Tự kiểm tra
- Q1Vì sao Big-O bỏ constants dù trong thực tế constants quan trọng (ví dụ: constant 1000 vs constant 1 ở O(n))?
- Q2Khi nào O(n²) thực tế nhanh hơn O(n log n) — cho ví dụ cụ thể?
- Q3Tra bảng băm được mô tả là O(1) — giả định ngầm nào phải đúng để đảm bảo điều này?
- Q4Đoạn pseudocode sau có Big-O bao nhiêu? Giải thích từng vòng.
for i <- 0 đến n-1: -- outer for j <- 0 đến n-1: -- inner-1 process(A[i][j]) for k <- 0 đến n-1: -- separate log(A[0][k]) - Q5Sự khác biệt giữa O, Theta, Omega — vì sao dev thường chỉ dùng O trong tài liệu?
- Q6Mẹo thực tế: khi nào đáng đánh đổi bộ nhớ lấy thời gian (dùng thêm bộ nhớ để chạy nhanh hơn)?
Bài tiếp theo: Recursion và call stack
Module 1 — Nền tảng: Cách đo và suy nghĩ về thuật toán
Bài tiếpRecursion & call stack — Khi đệ quy phá vỡ giới hạn ngăn xếp
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Ôn phỏng vấn
Bài này trả lời được các câu phỏng vấn sau — tự trả lời thử trước khi mở đáp án.
Thảo luận & góp ý
Hỏi đáp về bài này