EXPLAIN & EXPLAIN ANALYZE — đọc query plan của PostgreSQL
EXPLAIN chỉ hỏi planner, EXPLAIN ANALYZE chạy thật để đo actual time và rows; bài dạy đọc plan tree từ lá lên, hiểu cost, loops và BUFFERS.
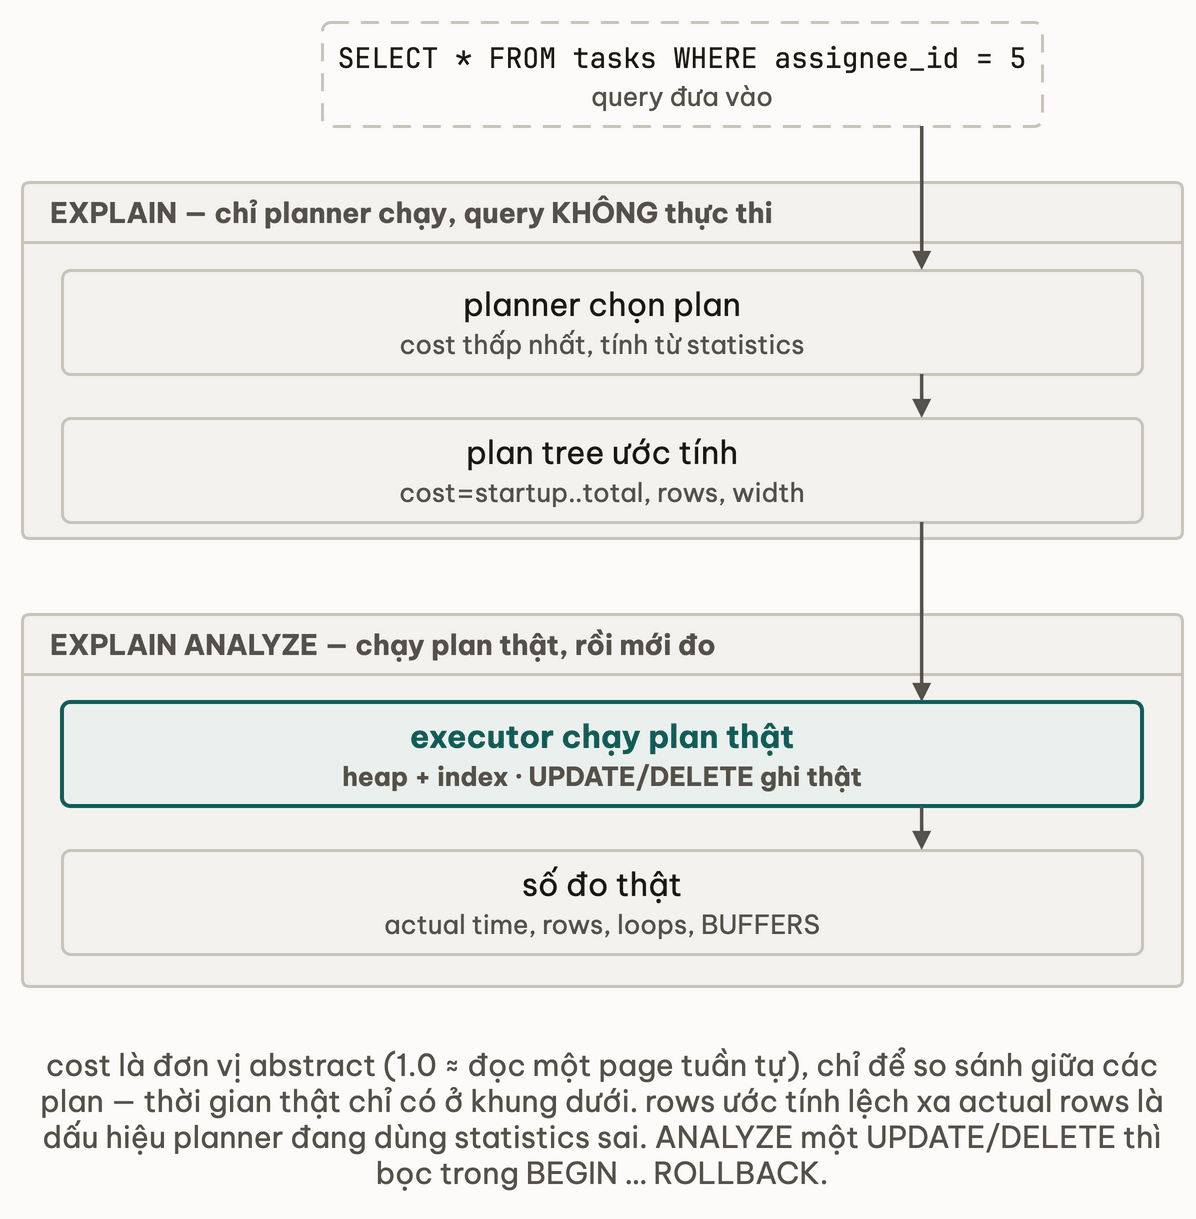
TL;DR: EXPLAIN chỉ hỏi planner "bạn định chạy thế nào?" và in ra plan tree kèm cost ước tính, không đụng vào dữ liệu. EXPLAIN ANALYZE chạy query thật rồi in thêm actual time và rows thực tế của từng node, còn BUFFERS đếm page đọc từ cache hay từ disk. Plan tree đọc từ lá (Seq Scan, Index Scan) lên gốc; cost là đơn vị tương đối, không phải millisecond; actual time của node có loops lớn hơn 1 là thời gian của một lần chạy, phải nhân với loops. Sai lệch lớn giữa rows ước tính và thực tế là dấu hiệu planner đang chọn plan theo statistics cũ.
Query chạy 2 giây. PM hỏi "sao chậm?". Bạn đoán: thiếu index? JOIN sai? Thêm một index thử, vẫn 2 giây. Thêm cái nữa, 1,8 giây. Đoán tiếp.
Đây là cách optimize của đa số developer, và cũng là lý do phần lớn optimization không hiệu quả: đoán mà không nhìn vào bằng chứng. EXPLAIN là cửa sổ để nhìn vào bên trong: planner đang chọn chiến lược gì, ước tính bao nhiêu row, tốn bao nhiêu cost. Trước khi đụng vào bất kỳ index nào, đọc EXPLAIN trước. Bài này dạy bạn đọc plan output từ đầu đến cuối.
1. Analogy — Google Maps route preview vs lái thực tế
Google Maps cho bạn xem route trước khi lái: ước tính 45 phút, 32 km, qua cao tốc. EXPLAIN làm đúng việc đó cho PostgreSQL: cho xem "plan" trước khi query thực sự chạy.
| Google Maps | PostgreSQL EXPLAIN |
|---|---|
| Xem route preview, chưa lái | EXPLAIN — xem plan, không chạy query |
| Lái thật và bấm đồng hồ | EXPLAIN ANALYZE — chạy thật, đo time |
| Thời gian thực tế vs ước tính | actual time vs cost |
| Đếm số km thực tế | actual rows — số row thực tế qua node |
| Đếm số trạm xăng đi qua | BUFFERS — số page đọc từ cache/disk |
EXPLAIN = preview route. EXPLAIN ANALYZE = lái thật + bấm đồng hồ. BUFFERS = đếm trạm xăng. Bạn không thể optimize nếu chưa biết planner chọn đường nào.
2. EXPLAIN và EXPLAIN ANALYZE khác nhau ở đâu?
-- Chi xem plan, khong chay query: an toan voi SELECT/INSERT/UPDATE/DELETE
EXPLAIN SELECT * FROM tasks WHERE assignee_id = 5;

-- Chay query that + do thoi gian thuc te
-- CANH BAO: INSERT/UPDATE/DELETE se thuc su thay doi data!
EXPLAIN ANALYZE SELECT * FROM tasks WHERE assignee_id = 5;

-- Chay that + dem I/O page (shared hit/read)
EXPLAIN (ANALYZE, BUFFERS) SELECT * FROM tasks WHERE assignee_id = 5;
EXPLAIN thuần chỉ chạy planner, query không thực thi, nên an toàn cả với mutation. EXPLAIN ANALYZE chạy query thật để đo actual time và actual rows; với INSERT, UPDATE, DELETE thì mutation xảy ra thật. Muốn xem plan của mutation mà không đổi data, bọc trong transaction rồi rollback:
BEGIN;
EXPLAIN ANALYZE UPDATE tasks SET status = 'done' WHERE id = 1;
ROLLBACK;
-- Mutation da chay (do duoc actual time), nhung transaction rollback
3. Đọc plan tree bottom-up
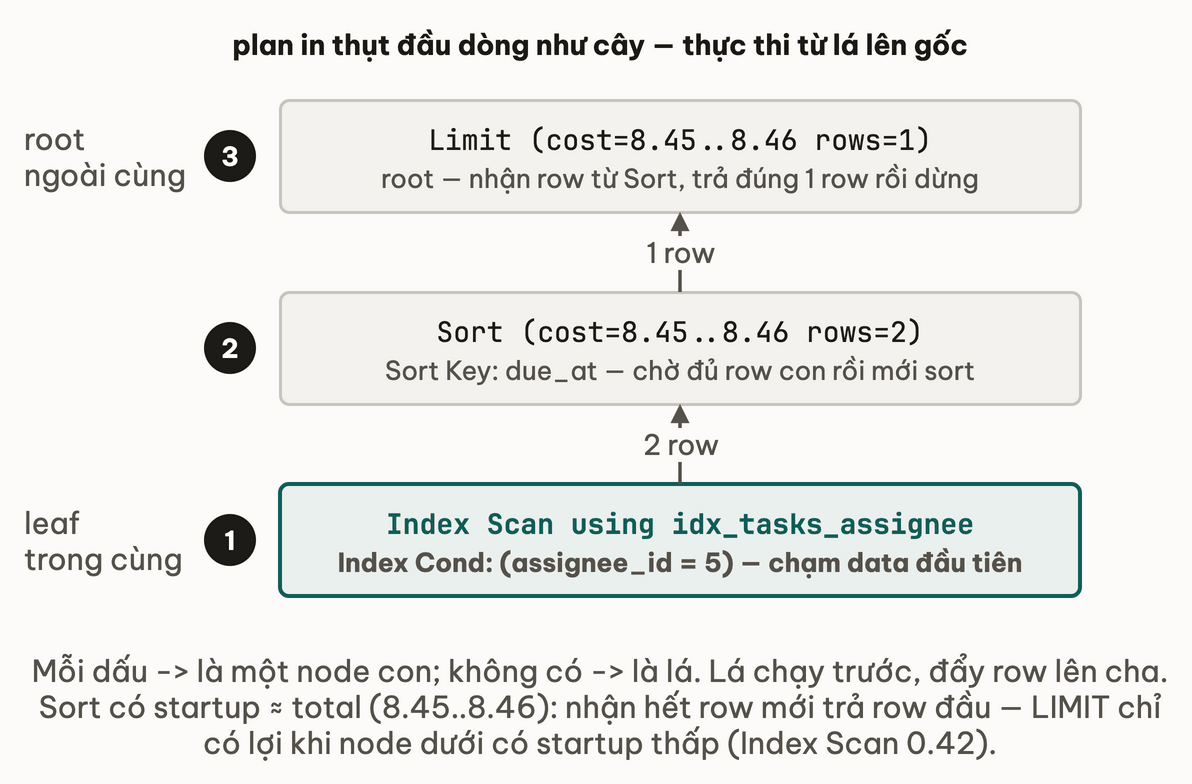
PostgreSQL in plan dưới dạng cây thụt đầu dòng, mỗi cấp indent là một node con. Nguyên tắc đọc: từ trong ra ngoài, từ dưới lên trên, leaf node chạy trước và đẩy kết quả lên node cha.
Limit  (cost=8.45..8.46 rows=1 width=64)
  ->  Sort  (cost=8.45..8.46 rows=2 width=64)
        Sort Key: due_at
        ->  Index Scan using idx_tasks_assignee on tasks  (cost=0.42..8.44 rows=2 width=64)
              Index Cond: (assignee_id = 5)
Thứ tự thực thi: Index Scan (lá) quét idx_tasks_assignee với assignee_id = 5 và trả row lên Sort; Sort sắp theo due_at rồi đẩy lên Limit (gốc), node này trả đúng số row cần. Node không có -> là lá, chính là điểm tiếp xúc với dữ liệu (Seq Scan, Index Scan…).
4. Cost format — startup, total, rows, width
Index Scan using idx_tasks_assignee on tasks (cost=0.42..8.44 rows=2 width=64)
| Field | Giá trị | Ý nghĩa |
|---|---|---|
cost=0.42 | startup cost | Chi phí trước khi trả row đầu tiên |
cost=..8.44 | total cost | Chi phí trả toàn bộ result set |
rows=2 | estimated rows | Planner ước tính bao nhiêu row qua node này |
width=64 | bytes per row | Trung bình số byte mỗi row |
Cost là đơn vị tương đối, không phải millisecond. PostgreSQL định nghĩa 1.0 cost ≈ chi phí đọc một page tuần tự (8 KB); random_page_cost = 4.0 mặc định nghĩa là một page đọc ngẫu nhiên đắt gấp 4 lần page tuần tự. Cost chỉ có nghĩa khi so hai node hoặc hai plan với nhau, không quy ra ms được. Toàn bộ bảng tham số của cost model nằm ở bài statistics & cost model.
Startup cost thấp quan trọng với query có LIMIT: planner ưu tiên plan trả được row đầu tiên sớm khi chỉ cần vài row, nên Index Scan (startup thấp) thường thắng Seq Scan ở query LIMIT 1.
rows ước tính là chỗ hay sai nhất. Planner tính nó từ statistics; statistics cũ hoặc hai cột tương quan làm ước tính lệch xa thực tế, và plan chọn theo ước tính sai thì sai theo.
Thử ngẫmmột query có LIMIT 1 nhưng planner vẫn chọn Seq Scan thay vì Index Scan dù đã có index đúng cột filter. Startup cost của hai plan đó có thể đang nói gì?
5. EXPLAIN ANALYZE — actual time và loops
Thêm ANALYZE bổ sung dòng actual time và rows thực tế sau mỗi node:
Index Scan using idx_tasks_assignee on tasks
    (cost=0.42..8.44 rows=2 width=64)
    (actual time=0.012..0.045 rows=3 loops=1)
actual time=0.012..0.045 là thời gian (ms) tới row đầu tiên và tới row cuối; rows=3 là số row thực tế; loops=1 là số lần node này được chạy. Ước tính 2 row, thực tế 3 row: lệch 1,5 lần, chấp nhận được. Nếu ước tính 1.000.000 mà thực tế 3, planner đang chọn plan dựa trên statistics cũ.
loops lớn hơn 1 xuất hiện ở Nested Loop: node inner chạy lại một lần cho mỗi row của outer.
Trong plan dưới, node tasks in actual time=0.018..0.024 với loops=10. Node đó thật sự tốn bao nhiêu ms trong tổng 2,5 ms của Nested Loop? Viết con số bạn tin trước khi đọc tiếp.
Nested Loop  (cost=0.42..45.32 rows=50 width=72)
             (actual time=0.030..2.500 rows=50 loops=1)
  ->  Index Scan on users  (cost=0.28..8.30 rows=10 width=40)
                           (actual time=0.015..0.080 rows=10 loops=1)
  ->  Index Scan on tasks  (cost=0.42..3.50 rows=5 width=32)
                           (actual time=0.018..0.024 rows=5 loops=10)
Node tasks chạy 10 lần, mỗi lần cho một row từ users. actual time=0.018..0.024 là thời gian của một lần chạy; tổng thời gian thực là 10 × 0.024 ≈ 0.24 ms. Cả rows=5 cũng là số row trung bình mỗi lần. Đọc node có loops lớn hơn 1 mà quên nhân là nhận định sai node nào đang tốn thời gian. Cơ chế của Nested Loop và hai thuật toán join còn lại ở bài join algorithms.
6. BUFFERS — đếm I/O page
Option BUFFERS in số page đọc/ghi qua buffer cache:
Buffers: shared hit=124 read=8 dirtied=0 written=0
| Field | Ý nghĩa | Tín hiệu |
|---|---|---|
shared hit | Page lấy từ buffer cache (RAM) | Tốt, cache warm |
shared read | Page phải đọc từ disk (cache miss) | Cảnh báo, disk I/O chậm hơn RAM hàng chục lần |
dirtied | Page bị sửa trong buffer | Bình thường với DML |
written | Page ghi xuống disk | Thường 0 với SELECT |
shared read cao là nguyên nhân thường gặp của query chậm dù index đúng đã có: dataset lạnh sau restart, hoặc shared_buffers quá nhỏ. Vì sao page cache rẻ hơn disk nhiều bậc: page cache & buffered I/O. BUFFERS của bước thực thi chỉ có khi đi cùng ANALYZE, vì phải chạy thật mới đo được I/O; từ PostgreSQL 13, EXPLAIN (BUFFERS) không ANALYZE in được buffer của riêng bước planning, và từ PG 18 ANALYZE tự bật BUFFERS.
Thử ngẫmhai lần chạy cùng một EXPLAIN (ANALYZE, BUFFERS) cách nhau 5 phút cho ra shared hit/read khác hẳn nhau. Điều gì giữa hai lần chạy đã thay đổi?
7. FORMAT JSON và visualizer
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON) <query>; in plan dạng JSON. Paste toàn bộ JSON (từ [ đến ]) vào explain.dalibo.com: visualizer vẽ cây, tô màu node chậm nhất và đánh dấu đỏ chỗ rows ước tính lệch thực tế. Rất đáng dùng khi plan có từ 5 node trở lên; với plan ngắn, TEXT mặc định (format của mọi ví dụ trong bài) đọc nhanh hơn.
Thử ngẫmbạn EXPLAIN một query dùng prepared statement với tham số $1 và thấy plan khác hẳn khi chạy trực tiếp với literal value. Plan nào mới phản ánh đúng query thật sẽ chạy trong production?
8. Pitfall — hai hiểu lầm khi đọc EXPLAIN
Estimated rows sai xa là root cause, không phải triệu chứng phụ. Thấy rows=1000000 mà actual rows=3 nghĩa là planner đã chọn Seq Scan vì tin rằng phải trả một triệu row; với ước tính đó, Seq Scan là quyết định hợp lý. Fix không phải ép plan mà là làm statistics đúng lại (ANALYZE, extended statistics): bài statistics và bài anti-pattern.
EXPLAIN trên prepared statement có thể là generic plan. Query với placeholder $1 sau vài lần chạy có thể được plan "chung cho mọi giá trị" thay vì cho giá trị cụ thể; plan in ra $1 thay vì literal và không đại diện cho giá trị hiếm. Khi debug, dùng literal để chắc chắn đang xem custom plan.
9. Applied — EXPLAIN ANALYZE BUFFERS trên TaskFlow dashboard query
Query dashboard từ mini-challenge dashboard query của khoá SQL & Database: task active của user 5, group by status. Chạy với (ANALYZE, BUFFERS), giả sử đã có CREATE INDEX idx_tasks_assignee ON tasks(assignee_id):
EXPLAIN (ANALYZE, BUFFERS)
SELECT
  status,
  count(*) FILTER (WHERE due_at < now()) AS overdue_count,
  count(*) FILTER (WHERE due_at >= now() AND due_at < now() + interval '7 days') AS this_week,
  count(*) AS total
FROM tasks
WHERE assignee_id = 5
GROUP BY status;
HashAggregate  (cost=20.45..20.50 rows=4 width=24)
               (actual time=0.350..0.355 rows=3 loops=1)
  Group Key: status
  Batches: 1  Memory Usage: 24kB
  ->  Index Scan using idx_tasks_assignee on tasks
          (cost=0.42..15.44 rows=200 width=12)
          (actual time=0.025..0.180 rows=180 loops=1)
          Index Cond: (assignee_id = 5)
  Buffers: shared hit=24
Planning Time: 0.150 ms
Execution Time: 0.420 ms
Đọc từ trong ra ngoài: Index Scan (lá) dùng idx_tasks_assignee, ước tính 200 row, thực tế 180, lệch 10%, ổn. HashAggregate (gốc) nhận 180 row, group theo status, trả 3 group. Buffers: shared hit=24, không có read: toàn bộ 24 page đang nằm trong RAM. Execution Time: 0.420 ms là con số để so trước/sau mỗi lần thêm index hay sửa query; Planning Time thường nhỏ, chỉ đáng để ý khi lên tới hàng chục ms ở query nhiều JOIN. Nếu ở lá thấy Seq Scan thay vì Index Scan thì đó là tín hiệu cần điều tra: index chưa có, statistics cũ, hay bảng quá nhỏ để index có lợi.
10. Deep Dive
- PostgreSQL Documentation — "Using EXPLAIN" — reference đầy đủ mọi option (ANALYZE, BUFFERS, SETTINGS, WAL, FORMAT) và cách đọc từng loại node. Đọc một lần để nắm hết option, quay lại khi gặp node lạ.
- explain.dalibo.com — visualizer plan tree, chạy hoàn toàn client-side, plan không gửi lên server.
- PostgreSQL 14 Internals — Egor Rogov, Part IV — Query Execution (chương về executor và cost model) — free PDF, đi sâu vào từng loại node và các tham số
seq_page_cost,random_page_cost,cpu_tuple_cost. Đọc sau khi đã quen EXPLAIN cơ bản.
11. Liên hệ các bài khác
- Từ SQL đến kế hoạch thực thi (khoá SQL & Database) — parser → planner → executor ở mức nguyên lý; bài này là cách nhìn output của đúng pipeline đó trong PostgreSQL.
- Scan strategies — bốn loại leaf node bạn sẽ gặp nhiều nhất và vì sao có index vẫn Seq Scan.
- Join algorithms — nơi
loopslớn hơn 1 xuất hiện và cách đọc node Hash/Merge. - Statistics & cost model — vì sao
rowsước tính lệch và các tham số sinh ra con sốcost. - VACUUM & dead tuple — dead tuple làm Seq Scan đọc nhiều page hơn số row còn sống;
BUFFERScao bất thường trên bảng nhỏ thường là bloat.
12. Tóm tắt
- Debug mutation query:
BEGIN; EXPLAIN ANALYZE UPDATE …; ROLLBACK;— có đủ actual time mà data không đổi. - Checklist đọc một plan: tìm lá trong cùng → so
rowsước tính với thực tế ở từng node → nhânactual timevớiloops→ xemshared readcó cao không → node nào chiếm phần lớnExecution Time. - Lệch ước tính 1,5–2 lần là bình thường; lệch hàng trăm, hàng nghìn lần là statistics cũ, chạy
ANALYZEtrước khi nghĩ đến index. - Plan có từ 5 node:
FORMAT JSON+ dalibo nhanh hơn đọc TEXT.
13. Tự kiểm tra
- Q1Plan sau có vấn đề gì?
Seq Scan on tasks (cost=0.00..45000.00 rows=900000 width=64) (actual time=0.010..3.200 rows=5 loops=1)— và hướng điều tra tiếp theo là gì? - Q2Một node trong EXPLAIN ANALYZE output:
(actual time=0.018..0.024 rows=5 loops=10). Total actual time của node này là bao nhiêu? Vì sao loops > 1 xảy ra? - Q3EXPLAIN ANALYZE in
Buffers: shared hit=5 read=200. Con số đó cho biết gì về performance? Có những hướng cải thiện nào? - Q4Vì sao
cost=50000không có nghĩa là query chạy 50.000 millisecond? Cost trong PostgreSQL là đơn vị gì, và đọc thời gian thực như thế nào? - Q5Tại sao
EXPLAIN ANALYZE UPDATE tasks SET status = 'done' WHERE id = 1lại nguy hiểm nếu chạy trực tiếp không wrap transaction? Viết lại cách chạy an toàn.
Bài tiếp theo: Scan strategies — vì sao có index vẫn Seq Scan
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Mini-challenge — race condition khi 2 user cùng assign task
Bài tiếpScan strategies — vì sao có index vẫn Seq Scan
Thảo luận & góp ý
Hỏi đáp về bài này