Statistics & cost model — planner ước tính row count như thế nào
Planner chọn plan từ statistics do ANALYZE lấy mẫu: n_distinct, MCV, histogram. Stats cũ hay hai cột tương quan làm ước tính sai; CREATE STATISTICS sửa.
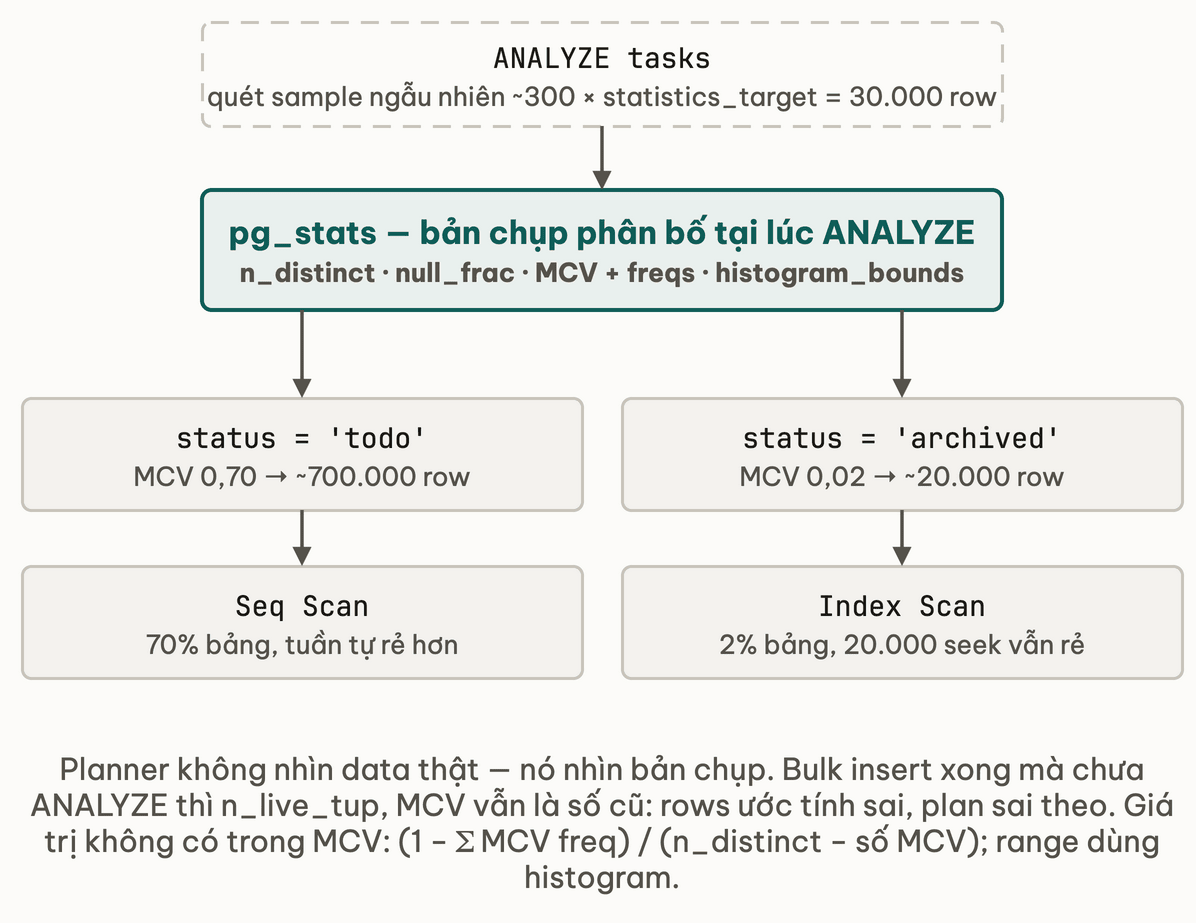
TL;DR: Planner không nhìn dữ liệu thật khi lập plan; nó nhìn statistics, bản chụp phân bố từng cột mà ANALYZE lấy được từ một mẫu khoảng 30.000 row: số giá trị khác nhau (n_distinct), tỷ lệ NULL, danh sách giá trị phổ biến kèm tần suất (MCV) và histogram cho range. Từ đó nó tính selectivity của mỗi điều kiện WHERE, nhân với số row để ra rows ước tính, rồi nhân với các hệ số cost (seq_page_cost, random_page_cost…) để chọn plan rẻ nhất. Ước tính sai khi statistics cũ sau bulk load, khi MCV bỏ sót giá trị hiếm, hoặc khi planner nhân xác suất hai cột tương quan như thể chúng độc lập; ba nguyên nhân đó có ba cách sửa riêng.
Planner không đoán mù, nó tính cost từ statistics. Nhưng statistics chỉ là snapshot tại thời điểm ANALYZE chạy: data đổi nhiều mà statistics chưa cập nhật thì planner vẫn quyết định theo số liệu cũ. Phần lớn ca "tại sao planner chọn plan tệ" có gốc ở đây: planner không sai logic, nó đang dùng thông tin sai.
1. Analogy — bộ phận kế hoạch nhà hàng
Bếp trưởng lập kế hoạch mỗi ngày (bao nhiêu nguyên liệu, mấy đầu bếp, giờ nào tăng cường) dựa trên báo cáo doanh thu, không dựa trên khách đang ngồi trong quán.
| Báo cáo nhà hàng | Statistics trong PostgreSQL |
|---|---|
| Báo cáo doanh thu định kỳ | Kết quả ANALYZE |
| Top 5 món hot và % gọi | MCV: most common values + frequency |
| Phân bố khách theo giờ | Histogram: phân bố giá trị theo range |
| Số món unique trong menu | n_distinct |
| Báo cáo 6 tháng trước, hôm nay đông gấp 3 | Statistics cũ, planner dùng số liệu sai |
Statistics = bản chụp phân bố data tại thời điểm ANALYZE. Planner luôn quyết định theo bản chụp đó, không theo data hiện tại. Statistics mới thì ước tính đúng, ước tính đúng thì plan đúng.
2. ANALYZE — lấy mẫu, không quét hết
ANALYZE quét một mẫu ngẫu nhiên của bảng, tính statistics và lưu vào catalog. Sample size xấp xỉ 300 × default_statistics_target row; với target 100 mặc định là khoảng 30.000 row, đủ cho bảng 1 triệu row phân bố bình thường, có thể thiếu với 100 triệu row nhiều outlier.
ANALYZE tasks;             -- toan bo bang
ANALYZE tasks(status);     -- mot cot
ANALYZE VERBOSE tasks;     -- in so page scanned, so row sampled
Cần ANALYZE tay sau bulk insert/update lớn (autovacuum có độ trễ), sau khi đổi statistics_target, và khi EXPLAIN ANALYZE cho thấy rows ước tính lệch xa thực tế.
3. pg_stats — đọc statistics trực tiếp
pg_stats là view dễ đọc trên catalog pg_statistic, một dòng cho mỗi cột:
SELECT attname, n_distinct, null_frac, most_common_vals, most_common_freqs, histogram_bounds
FROM pg_stats WHERE tablename = 'tasks';
-- tasks.status (4 gia tri, phan bo lech):
-- n_distinct        | 4
-- most_common_vals  | {todo,doing,done,archived}
-- most_common_freqs | {0.70,0.20,0.08,0.02}
-- histogram_bounds  | NULL      <- MCV da cover 100% gia tri

-- tasks.due_at (timestamp, gan nhu unique):
-- n_distinct        | -1        <- am = ty le: -1 la moi gia tri unique
-- null_frac         | 0.05
-- most_common_vals  | NULL
-- histogram_bounds  | {2025-01-01,2025-03-15,...,2026-12-31}   <- 100 bucket cho range query
n_distinct dương là số tuyệt đối, âm là tỷ lệ so với số row (−1 = mọi giá trị unique). most_common_freqs là tần suất của từng giá trị trong MCV, tổng không quá 1. Cột text unique như title có cả MCV lẫn histogram NULL: planner phải rơi về heuristic.
4. Cost model — các hệ số sinh ra con số cost
Planner không tính bằng millisecond. Cost là đơn vị tương đối chuẩn hoá quanh chi phí đọc một page tuần tự 8 KB, và mỗi thao tác được gán một hệ số. GUC (Grand Unified Configuration) là tên PostgreSQL gọi các tham số cấu hình runtime như random_page_cost:
| GUC | Default | Ý nghĩa |
|---|---|---|
seq_page_cost | 1.0 | Đọc 1 page tuần tự, baseline |
random_page_cost | 4.0 | Đọc 1 page ngẫu nhiên (giả định HDD); SSD ~1.1, NVMe 1.0–1.5 |
cpu_tuple_cost | 0.01 | Xử lý 1 row |
cpu_index_tuple_cost | 0.005 | Xử lý 1 index entry |
cpu_operator_cost | 0.0025 | Áp 1 operator (bằng, nhỏ hơn…) |
effective_cache_size | 4 GB | Hint tổng RAM đang cache data (OS + PG), không cấp phát gì |
random_page_cost = 4 là lý do bài scan strategies đặt điểm hoà vốn Index Scan vs Seq Scan ở 5–15% selectivity. Giữ 4.0 trên SSD khiến planner tưởng random I/O đắt hơn thực tế, nên nghiêng quá tay về Seq Scan; hạ xuống 1.1 trong postgresql.conf sau khi đã thử bằng SET random_page_cost = 1.1 trong session và đo EXPLAIN ANALYZE trước/sau.
Thử ngẫmserver production vừa chuyển từ HDD sang NVMe nhưng random_page_cost vẫn giữ 4.0 mặc định. Planner đang định giá random I/O đắt hơn hay rẻ hơn thực tế phần cứng mới?
5. Planner tính selectivity như thế nào?
Selectivity là tỷ lệ row mà planner ước tính sẽ lọt qua một điều kiện. Với cột status ở trên:
WHERE status = 'todo'      -- co trong MCV: freq 0.70 -> 70% -> Seq Scan
WHERE status = 'archived'  -- co trong MCV: freq 0.02 -> 2%  -> Index Scan
WHERE status IN ('todo', 'doing')          -- cong freq: 0.90
-- gia tri KHONG co trong MCV:
--   (1 - tong_MCV_freq) / (n_distinct - so_gia_tri_trong_MCV)

WHERE due_at BETWEEN '2026-01-01' AND '2026-02-01'
-- dem so bucket histogram nam trong [X, Y] / tong so bucket

WHERE LOWER(title) = 'fix login bug'
-- planner KHONG biet phan bo cua LOWER(): hang so ~0.5%
Dòng cuối là bẫy hay gặp: bọc cột trong hàm thì mọi statistics của cột trở nên vô dụng và planner dùng một hằng số, bất kể data thật. Bài anti-pattern mổ pattern này và cách sửa.
6. Khi nào statistics tự cập nhật?
Auto-analyze là một worker của autovacuum daemon (cùng hạ tầng với VACUUM ở bài VACUUM & dead tuple). Nó chạy khi:
n_mod_since_analyze > autovacuum_analyze_threshold + autovacuum_analyze_scale_factor × n_live_tup
                    = 50 + 0.1 × n_live_tup   (mac dinh)
Bảng 1 triệu row: ngưỡng là 100.050 row bị sửa. Bulk insert 200.000 row lúc 3 giờ sáng thì autovacuum sẽ tới, nhưng tuỳ tải có thể lag 10–30 phút, và trong khoảng đó planner dùng statistics của bảng cũ.
SELECT relname, last_analyze, last_autoanalyze, n_mod_since_analyze
FROM pg_stat_user_tables WHERE relname = 'tasks';

ANALYZE tasks;   -- sau bulk load, khong cho autovacuum
Thử ngẫmmột bulk import 200.000 row chạy lúc nửa đêm, autovacuum chưa kịp trigger analyze. Dashboard query đầu giờ sáng dựa trên statistics của thời điểm nào?
7. statistics_target — mua độ chính xác bằng thời gian ANALYZE
default_statistics_target (100) quyết định sample size, số bucket histogram và độ dài MCV. Cột phân bố rất lệch (10% khách hàng chiếm 80% đơn) mà MCV chỉ giữ 100 giá trị thì khách ngoài top 100 rơi vào công thức "phần còn lại", ước tính rất thấp.
ALTER TABLE orders ALTER COLUMN customer_id SET STATISTICS 1000;
ANALYZE orders;   -- bat buoc chay lai, doi target khong tu trigger ANALYZE
| Target | Sample rows | Được | Mất |
|---|---|---|---|
| 100 (default) | ~30.000 | ANALYZE nhanh | Histogram thô, MCV ngắn |
| 500 | ~150.000 | Ước tính chính xác hơn | ANALYZE chậm ~3–5 lần |
| 1000–5000 | ~300k–1,5M | Bắt được outlier, phân bố lệch | ANALYZE rất chậm, planning time tăng nhẹ |
Chỉ tăng cho cột xuất hiện trong WHERE của query quan trọng, không tăng toàn cục.
8. Cross-column correlation — CREATE STATISTICS
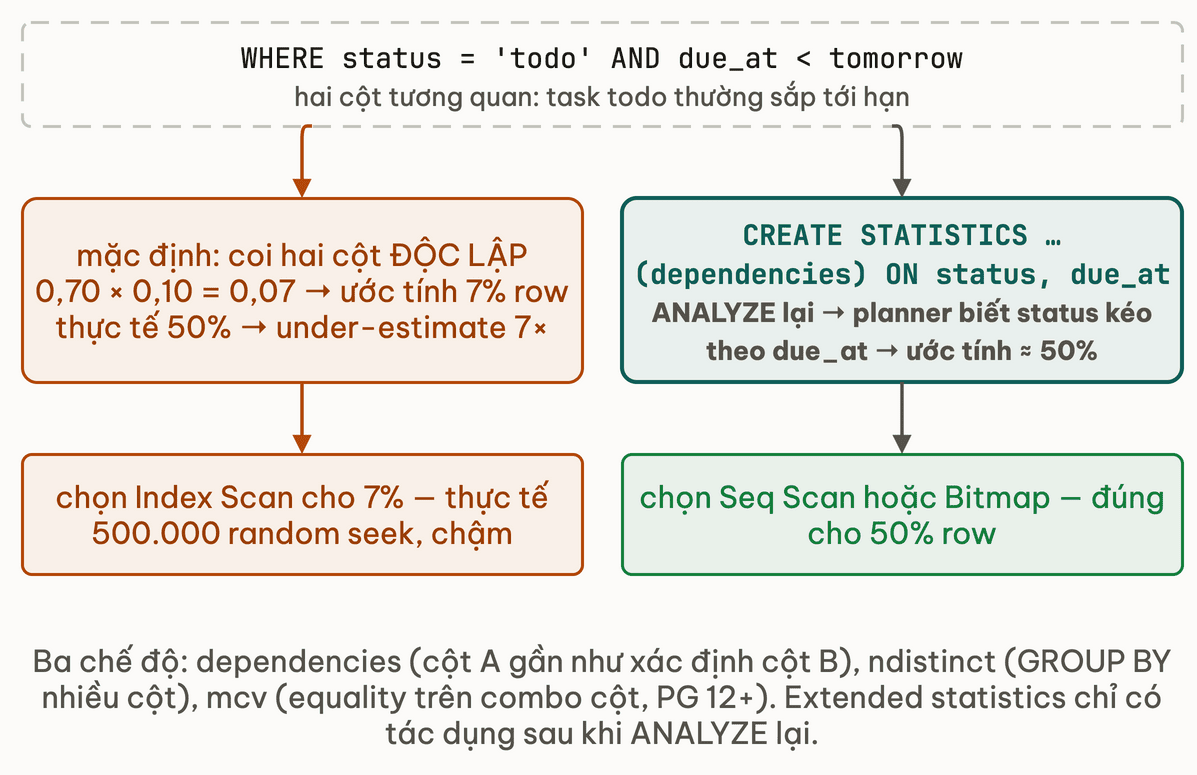
Planner mặc định coi các cột độc lập khi tính selectivity cho điều kiện nhiều cột: nhân xác suất từng điều kiện với nhau. Đúng với nhiều trường hợp, sai khi hai cột tương quan.
Trong TaskFlow, status = 'todo' chiếm 70% row và due_at < tomorrow chiếm 10%. Task todo lại hay có deadline gần. Planner sẽ ước tính bao nhiêu phần trăm row lọt qua WHERE status = 'todo' AND due_at < tomorrow, và con số thật có thể lệch về phía nào? Viết ước tính của bạn trước.
-- Planner assume doc lap:
--   p(status='todo' AND due_at < tomorrow) = 0.70 x 0.10 = 0.07   <- uoc tinh 7%
-- Thuc te (tuong quan cao): ~0.50                                   <- 50%
-- Under-estimate 7x -> chon Index Scan cho 50% bang -> cham

CREATE STATISTICS stats_tasks_status_due (dependencies, ndistinct)
ON status, due_at FROM tasks;
ANALYZE tasks;   -- thu thap extended statistics

SELECT stxname, stxkind FROM pg_statistic_ext WHERE stxrelid = 'tasks'::regclass;
| Mode | Ý nghĩa | Dùng khi |
|---|---|---|
dependencies | Functional dependency giữa các cột | Cột A gần như xác định cột B |
ndistinct | Distinct count cho tổ hợp cột | GROUP BY (a, b) ước tính sai |
mcv | MCV cho tổ hợp cột (PG 12+) | Equality trên nhiều cột phổ biến |
Thử ngẫmhai cột project_id và status trong bảng tasks của bạn có tương quan không? Bạn đo bằng query gì trước khi quyết định tạo CREATE STATISTICS cho chúng?
9. Deep Dive
- PostgreSQL Documentation — "Statistics Used by the Planner" —
pg_stats, MCV, histogram và extended statistics ở mức người dùng. Đọc trước. - PostgreSQL Documentation — "How the Planner Uses Statistics" — công thức selectivity cho từng operator (
=,<,BETWEEN,LIKE) và cách gộp nhiều predicate. - PostgreSQL Documentation — CREATE STATISTICS — syntax, ba mode, ví dụ cho từng loại tương quan.
- PostgreSQL 14 Internals — Egor Rogov, Part IV — Query Execution (chương về statistics và cost estimation) — free PDF, thuật toán lấy mẫu và implementation của extended statistics.
10. Liên hệ các bài khác
- Cost-based optimization (khoá SQL & Database) — nguyên lý optimizer chọn plan theo cost; bài này là các hệ số và statistics cụ thể của PostgreSQL.
- Scan strategies — selectivity tính ở đây quyết định Seq Scan hay Index Scan ở đó.
- Join algorithms — ước tính rows sai ở outer là lý do planner chọn Nested Loop cho một triệu row.
- 5 anti-pattern — hàm bọc cột và cast ngầm là hai cách làm planner mất statistics ngay cả khi stats mới.
- Có index vẫn Seq Scan — ca thật: cột
correlationtrong pg_stats thấp khiến planner bỏ index.
11. Tóm tắt
- Checklist khi
rowsước tính lệch xa thực tế:last_analyzecũ? →ANALYZE; vẫn sai với giá trị hiếm? → tăngstatistics_targetcho cột đó; vẫn sai với điều kiện nhiều cột? →CREATE STATISTICS. - Ca
status+due_atở mục 8: ước tính 7% trong khi thực tế 50% thìCREATE STATISTICS … (dependencies)rồiANALYZE, đừng thêm index. - Hàm bọc cột (
LOWER(email),DATE_TRUNC(...)) làm planner mù, dùng hằng số ~0,5% bất kể data. - Đổi
statistics_targethay tạoCREATE STATISTICSxong đều phảiANALYZElại mới có hiệu lực. effective_cache_sizechỉ là hint cho planner, không cấp RAM; tăng nó làm planner thích Index Scan hơn.
12. Tự kiểm tra
- Q1EXPLAIN ANALYZE cho thấy
rows=500000 actual rows=3trên Seq Scan. Đây là dấu hiệu của vấn đề gì? Các bước diagnose và fix theo thứ tự ưu tiên? - Q2Bảng
orderscócustomer_idvới 10% top customer chiếm 80% order. default_statistics_target=100 — MCV list có đủ không? Khi nào ước tính sẽ sai và fix như thế nào? - Q3
pg_statschotasks.statuscómost_common_freqs = {0.70, 0.20, 0.08, 0.02}. QueryWHERE status = 'doing' AND due_at < now()— planner ước tính selectivity thế nào nếu không có extended statistics? Tại sao ước tính có thể sai? - Q4Sự khác biệt giữa
n_distinct = 4vàn_distinct = -1trongpg_stats? Planner dùng 2 loại này khác nhau thế nào khi ước tính? - Q5Query
WHERE LOWER(email) = '[email protected]'có ước tính kém hơnWHERE email = '[email protected]'rất nhiều. Vì sao? Cách fix đúng là gì?
Bài tiếp theo: 5 anti-pattern khiến planner chọn plan tệ
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Join algorithms — Nested Loop, Hash Join, Merge Join
Bài tiếp5 anti-pattern khiến planner chọn plan tệ
Thảo luận & góp ý
Hỏi đáp về bài này