VACUUM và dead tuple: bảng phình to dù count(*) không tăng
UPDATE và DELETE trong PostgreSQL chỉ đánh dấu tuple cũ; VACUUM dọn chúng vào FSM, autovacuum quyết định lúc nào chạy, và long transaction là thứ chặn cả hai.
TL;DR: Trong PostgreSQL, UPDATE và DELETE không xoá gì trên disk; chúng chỉ gắn xmax lên tuple cũ. Khi không snapshot nào còn cần, tuple đó thành dead tuple và vẫn chiếm chỗ cho tới khi VACUUM đánh dấu slot là tái dùng được trong Free Space Map. VACUUM thường không trả disk về OS và chạy song song với query; VACUUM FULL trả disk nhưng khoá bảng hoàn toàn. Autovacuum tự chạy khi số dead tuple vượt threshold + scale_factor × n_live_tup (mặc định 50 + 20%), quá cao cho bảng lớn heavy-update. Thứ hay phá mọi thứ trên là một transaction để mở hàng giờ: VACUUM không được dọn bất kỳ tuple nào mới hơn snapshot của nó.
TaskFlow chạy 6 tháng. Bảng tasks chiếm 5 GB trên disk, nhưng SELECT count(*) chỉ trả về 50 nghìn row. Mỗi row khoảng 2 KB, tức đáng ra ~100 MB. 4,9 GB còn lại là gì?
Không phải corruption hay log, mà là dead tuple: tàn tích của hàng triệu UPDATE/DELETE mà MVCC (bài 04) giữ lại cho snapshot đang chạy, và chưa ai dọn.
1. Analogy — thùng rác email
Cứ hình dung inbox email của bạn. Bấm "Trash" thì thư biến khỏi inbox nhưng vẫn nằm trong thùng rác và vẫn chiếm dung lượng. "Empty Trash" xoá metadata để chỗ đó dùng lại được, nhưng file mailbox trên disk chưa nhỏ đi; muốn trả disk thật phải "Compact Folders", tức ghi lại cả file từ đầu.
| Hộp thư email | PostgreSQL |
|---|---|
| Bấm "Trash": thư còn trong thùng rác | DELETE/UPDATE chỉ set xmax, tuple vẫn trên heap page |
| Thùng rác đầy dần, disk vẫn bị chiếm | Dead tuple tích luỹ = bloat |
| Empty Trash: slot dùng lại được, disk chưa trả | VACUUM: ghi slot trống vào FSM (Free Space Map) |
| Compact Folders: ghi lại file, trả disk thật | VACUUM FULL: rewrite bảng, cần downtime |
| Auto-archive theo quy tắc | Autovacuum daemon chạy theo công thức dead-tuple |
2. Dead tuple — hệ quả tất yếu của MVCC
Nhắc lại bài 04: UPDATE = set xmax lên tuple cũ + INSERT tuple mới; DELETE = chỉ set xmax. Không gì bị xoá vật lý. Khi xmax đã commit và không snapshot nào còn có thể thấy tuple đó nữa, nó thành dead tuple: chiếm chỗ trên page, không query nào thấy, nhưng slot chưa được tái dùng.
SELECT n_live_tup, n_dead_tup,
       round(n_dead_tup::numeric / nullif(n_live_tup, 0), 1) AS dead_ratio
FROM pg_stat_user_tables WHERE relname = 'tasks';

-- n_live_tup | n_dead_tup | dead_ratio
--      50000 |    2450000 |       49.0    <- 49 dead tren moi 1 live
Đúng tình huống TaskFlow: 50 nghìn task active, nhưng 6 tháng UPDATE assignee_id, status, updated_at đã để lại gần 2,5 triệu dead tuple chưa được dọn. Số này từ stats collector nên chỉ là ước lượng; muốn đo byte-level trên heap thì CREATE EXTENSION pgstattuple rồi SELECT * FROM pgstattuple('tasks'), cột dead_tuple_percent ở đây báo 95% (3% còn lại là free_percent, khoảng trống trong page, nên live data chỉ ~2%, khớp 100 MB trên 5 GB). Nó scan full table, chỉ chạy khi diagnose.
3. VACUUM vs VACUUM FULL — chọn cái nào?
| VACUUM | VACUUM FULL | |
|---|---|---|
| Lock | SHARE UPDATE EXCLUSIVE | ACCESS EXCLUSIVE |
| SELECT/INSERT/UPDATE trong lúc chạy | Cho phép | Bị block |
| Trả disk về OS | Không (ghi FSM) | Có (rewrite, drop file cũ) |
| Disk tạm khi chạy | Gần 0 | ~2× table size |
| Dùng khi | Bảo trì định kỳ | Maintenance window, hoặc thay bằng pg_repack |
VACUUM tasks;              -- chay bat cu luc nao
VACUUM ANALYZE tasks;      -- kem cap nhat statistics cho planner
-- VACUUM FULL tasks;      -- KHONG chay production gio cao diem

-- Theo doi tien trinh VACUUM dang chay:
SELECT phase, heap_blks_scanned, heap_blks_total
FROM pg_stat_progress_vacuum WHERE relid = 'tasks'::regclass;
4. Vì sao VACUUM không trả disk về OS?
Vì co file tốn I/O và INSERT ngay sau đó lại phải nới ra. Thay vào đó VACUUM chỉ cập nhật FSM, một cấu trúc nhỏ ghi page nào còn bao nhiêu chỗ trống; INSERT/UPDATE tiếp theo tra FSM và ghi đè slot cũ trước khi xin page mới. Bảng đang ở trạng thái "đầy dead tuple" sau VACUUM vẫn to y nguyên, nhưng ngừng phình.
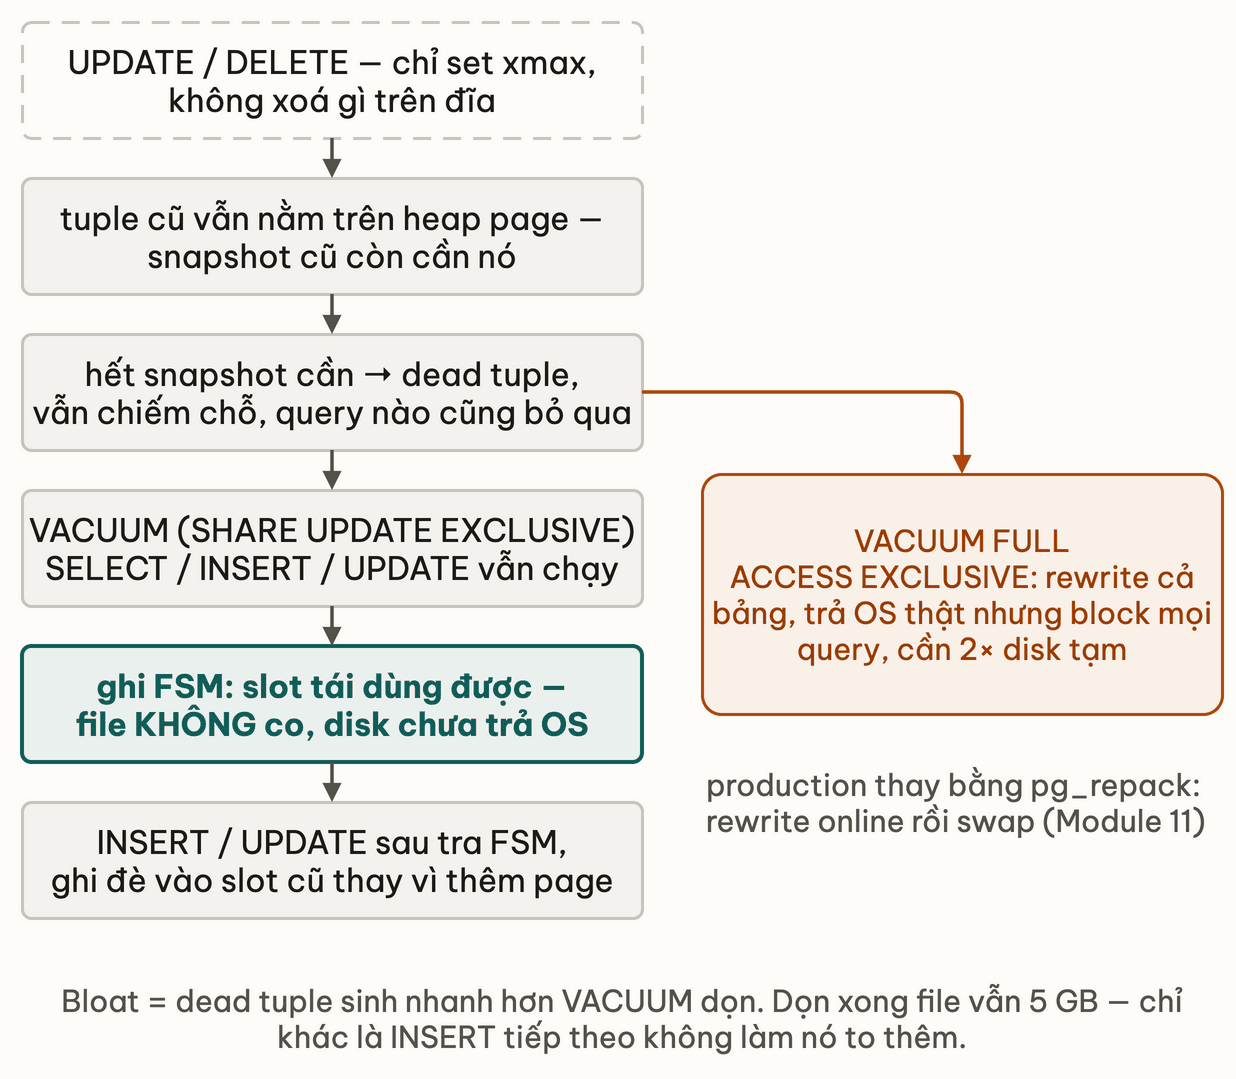
Muốn trả disk thật mà không downtime, production dùng pg_repack: dựng bản copy trong khi bảng vẫn phục vụ traffic rồi swap. Công cụ này thuộc khoá PostgreSQL — Advanced & Scale (module Observability, đang xây).
Thử ngẫmbảng tasks bloat nặng lúc 2 giờ sáng, nhưng maintenance window duy nhất chỉ 10 phút. VACUUM FULL có phải lựa chọn khả thi trong khung giờ đó không?
5. Autovacuum quyết định lúc nào chạy như thế nào?
Autovacuum là daemon nền, định kỳ xét từng bảng theo công thức:
n_dead_tup > autovacuum_vacuum_threshold + autovacuum_vacuum_scale_factor * n_live_tup
Mặc định threshold = 50, scale_factor = 0.2. Bảng 1 triệu row phải tích đủ 200.050 dead tuple mới được dọn. ANALYZE có công thức tương tự với autovacuum_analyze_scale_factor = 0.1. autovacuum_max_workers (mặc định 3) là số bảng được dọn song song; server nhiều bảng heavy-write có thể cần 5–6.
-- Lich su autovacuum tren tung bang
SELECT relname, last_autovacuum, autovacuum_count, n_dead_tup, n_live_tup
FROM pg_stat_user_tables
ORDER BY last_autovacuum DESC NULLS LAST;
6. Per-table tuning — khi 20% là quá cao
20% hợp lý với bảng nhỏ. Với bảng lớn hoặc heavy-update, ngưỡng đó là hàng trăm nghìn dead tuple tích lại trước mỗi lần dọn. Nguyên tắc: bảng càng lớn và càng nhiều UPDATE, hạ scale_factor càng mạnh, và chỉ hạ cho bảng đó chứ không đụng GUC toàn cục.
-- tasks: heavy UPDATE -> don som hon
ALTER TABLE tasks SET (
  autovacuum_vacuum_scale_factor = 0.05,   -- 5% dead thay vi 20%
  autovacuum_vacuum_threshold = 100,
  autovacuum_analyze_scale_factor = 0.02,
  fillfactor = 80                          -- chua cho cho HOT update (xem bai composite index)
);

-- task_history: insert-only, dead tuple gan 0 -> giu gan default
ALTER TABLE task_history SET (autovacuum_vacuum_scale_factor = 0.1);

SELECT reloptions FROM pg_class WHERE relname = 'tasks';   -- xem lai
Sau khi tune, xác nhận bằng last_autovacuum nhích thường xuyên hơn. fillfactor = 80 ở đây liên quan tới HOT update của bài 04 và cách chọn cột index ở bài composite index.
Thử ngẫmtask_history vẫn giữ scale_factor mặc định vì insert-only. Nếu một ngày ai đó thêm job xoá bớt log cũ hàng loạt, con số đó còn hợp lý không?
7. Visibility map và Index Only Scan
Visibility Map (VM) là bitmap đi kèm mỗi heap file: 2 bit cho mỗi page, all-visible (mọi tuple trên page visible với mọi snapshot) và all-frozen. VACUUM set all-visible khi quét xong một page sạch. Ý nghĩa với planner: query chỉ cần cột nằm trong index vẫn phải đọc heap để kiểm xmin/xmax, trừ khi VM nói page đó all-visible, lúc ấy bỏ qua heap hoàn toàn.
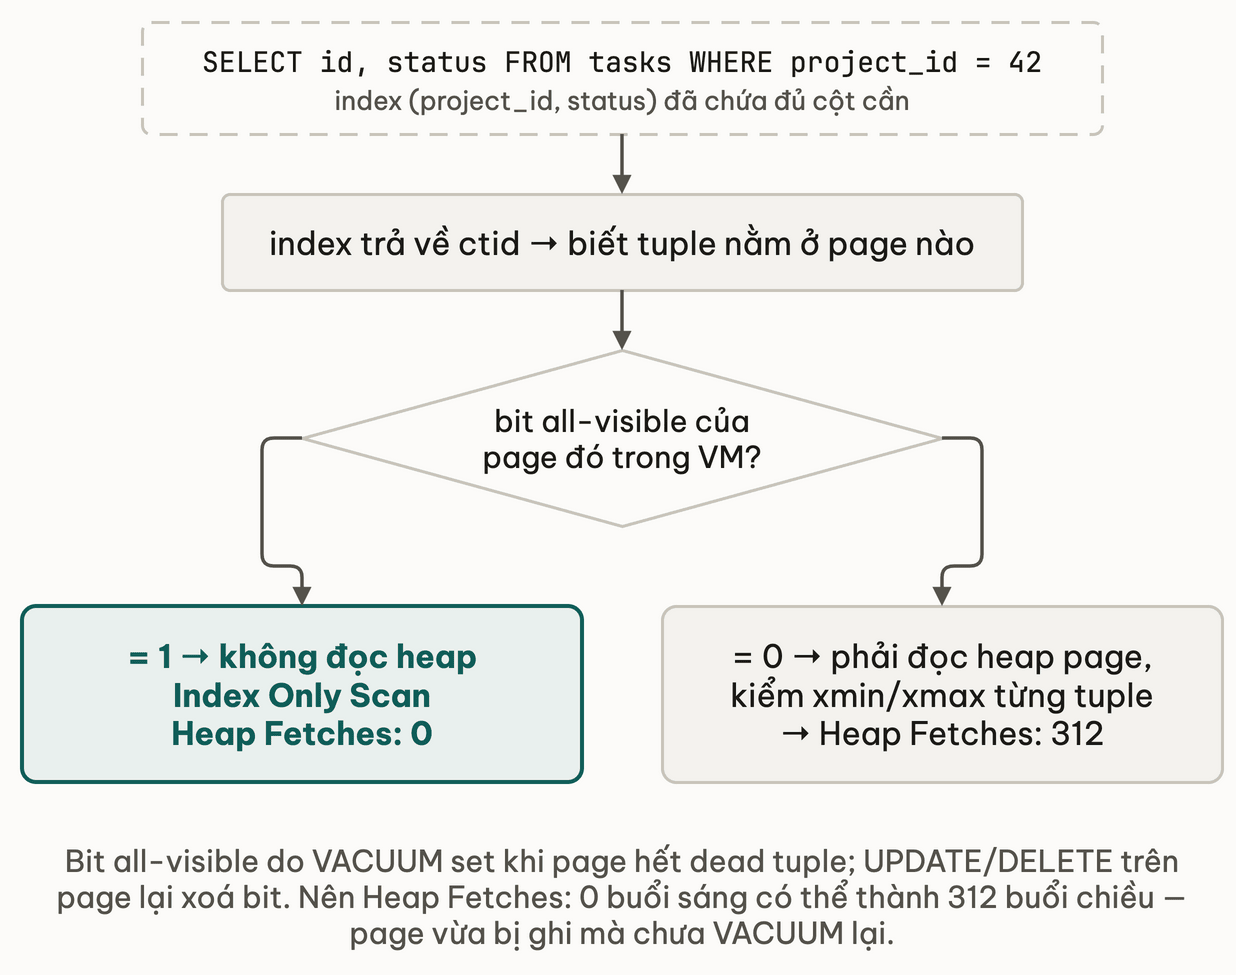
Cùng một query, cùng index (project_id, status), chỉ khác là VACUUM đã chạy hay chưa. Bạn đoán tên node scan trong EXPLAIN có đổi không, và thời gian hai lần chênh cỡ bao nhiêu?
EXPLAIN ANALYZE SELECT id, status FROM tasks WHERE project_id = 42;

-- Sau VACUUM (VM all-visible):
-- Index Only Scan using idx_tasks_project_status on tasks
--   Heap Fetches: 0            <- khong doc heap     Actual: 0.3 ms

-- Truoc VACUUM (VM bit chua set):
-- Index Only Scan using idx_tasks_project_status on tasks
--   Heap Fetches: 312          <- doc heap moi row   Actual: 8.2 ms
Đọc kế hoạch này chi tiết ở bài EXPLAIN và bài scan strategies. Điều kiện để Heap Fetches: 0: index cover đủ cột, và VACUUM đã chạy gần đây.
8. Pitfall — long transaction chặn autovacuum
Transaction đang mở giữ snapshot với xmin = txid lúc BEGIN. Luật của VACUUM: dead tuple chỉ được dọn khi xmax của nó nhỏ hơn xmin của snapshot cũ nhất còn active. Session A BEGIN lúc 9h và không commit tới 11h; trong hai giờ đó tasks nhận 500.000 UPDATE:
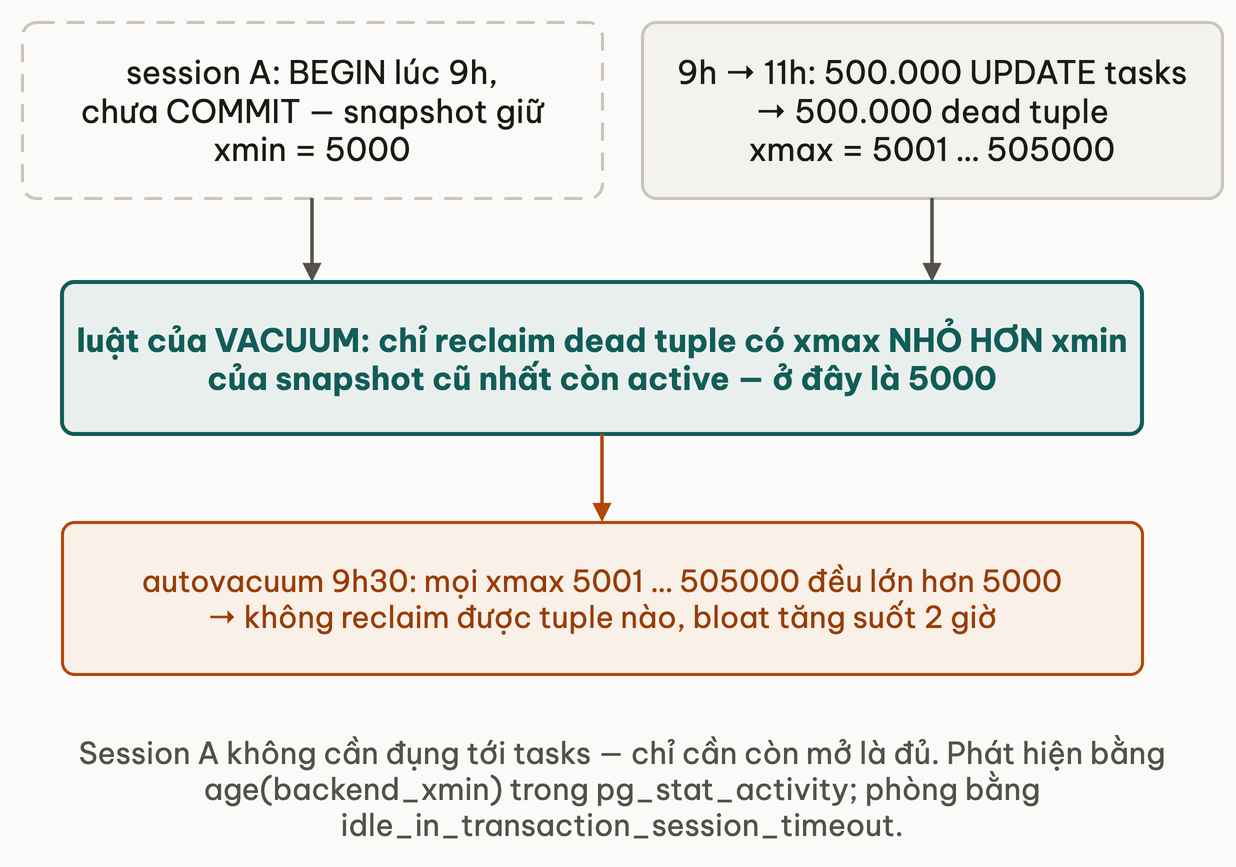
Autovacuum vẫn chạy, log vẫn ghi "vacuumed", nhưng không dọn được tuple nào. Detect và chặn:
-- Ai dang giu snapshot cu?
SELECT pid, now() - xact_start AS duration, age(backend_xmin) AS xmin_age,
       state, left(query, 60) AS query_preview
FROM pg_stat_activity
WHERE backend_xmin IS NOT NULL
ORDER BY age(backend_xmin) DESC LIMIT 5;
-- xmin_age hang tram nghin + state 'idle in transaction' = thu pham

-- Ngat neu la idle-in-transaction: SELECT pg_terminate_backend(<pid>);
-- Phong ngua trong postgresql.conf: idle_in_transaction_session_timeout = '10min'
Hai thứ khác cũng giữ xmin cũ y hệt: replication slot bỏ hoang và prepared transaction treo. Dấu hiệu chung là n_dead_tup không giảm dù last_autovacuum mới cập nhật.
9. Applied — checklist bloat cho TaskFlow
Cho tasks (heavy-update) áp bộ tham số ở mục 6; task_history (insert-only) để gần mặc định. Rồi đặt một query audit chạy hàng tuần:
SELECT relname, n_dead_tup, n_live_tup,
       round(100.0 * n_dead_tup / nullif(n_live_tup, 0), 1) AS dead_pct,
       pg_size_pretty(pg_relation_size(relid))              AS size,
       age(now(), last_autovacuum)                          AS since_last_av
FROM pg_stat_user_tables
WHERE n_dead_tup > 1000
ORDER BY dead_pct DESC NULLS LAST;
-- dead_pct > 20%: xem lai scale_factor
-- dead_pct > 50% va since_last_av > 1h: autovacuum dang bi chan? -> muc 8
Kết quả đo được sau khi áp cho TaskFlow: autovacuum chạy ở ngưỡng 2.600 dead tuple thay vì ~10.000, bloat của tasks giữ dưới 10%, và dashboard query giữ Heap Fetches: 0. Phần 4,9 GB đã phình chỉ mất đi sau một lần pg_repack trong giờ thấp điểm.
Thử ngẫmsáng nay EXPLAIN ANALYZE cho Heap Fetches: 0, chiều nay cùng query lại có Heap Fetches khác 0. Điều gì đã đổi giữa hai lần chạy?
10. Liên hệ các bài khác
- MVCC internals: nguồn gốc dead tuple; đọc lại phần snapshot nếu chưa rõ vì sao "snapshot cũ" ngăn được VACUUM.
- Locks và deadlock: SHARE UPDATE EXCLUSIVE và ACCESS EXCLUSIVE trong bảng mục 3 nằm ở đâu trong 8 lock mode, và vì sao
VACUUM FULLblock cả SELECT. - Composite index và thứ tự cột: covering index là nửa điều kiện của Index Only Scan; VM là nửa còn lại.
- EXPLAIN format: đọc
Heap Fetches,Buffersvà các node scan để biết VACUUM có đang giúp query hay không. - Page cache và buffered I/O: bloat không chỉ tốn disk, nó làm page cache chứa toàn dead tuple; bài này giải thích vì sao điều đó đau.
- PostgreSQL 14 Internals — Egor Rogov (free PDF): chương 6 "Vacuum and Autovacuum" và chương 7 "Freezing" giải thích FSM, VM và cách VACUUM quyết định dọn tuple nào.
- The Internals of PostgreSQL — Hironobu Suzuki, Ch.6 Vacuum Processing: diagram heap page trước/sau VACUUM, FSM và VM cập nhật từng bước.
- PostgreSQL Documentation — Routine Vacuuming: tài liệu chính thức về autovacuum, per-table storage parameter và wraparound; bảng đầy đủ GUC autovacuum nằm ở Automatic Vacuuming.
- PostgreSQL Documentation — pg_stat_all_tables: reference các cột
n_dead_tup,last_autovacuum,n_mod_since_analyzekhi dựng dashboard bloat.
11. Tóm tắt
- Bảng to bất thường:
pg_stat_user_tablesxemn_dead_tup/n_live_tuptrước,pgstattuplekhi cần số chính xác. n_dead_tupkhông giảm dùlast_autovacuummới: tìmage(backend_xmin)lớn trongpg_stat_activity, rồi replication slot và prepared transaction.- Bảng heavy-update:
ALTER TABLE … SET (autovacuum_vacuum_scale_factor = 0.05), đừng chỉnh GUC toàn cục. - Cần trả disk:
pg_repackonline;VACUUM FULLchỉ khi có window và chấp nhận ACCESS EXCLUSIVE. Heap Fetchestăng lại sau một thời gian là VM bị bẩn, tức VACUUM chưa quay lại page đó.
12. Tự kiểm tra
- Q1Vì sao bảng `tasks` chiếm 5 GB dù chỉ có 50 nghìn row active? Vì sao PostgreSQL không xoá dead tuple ngay khi UPDATE/DELETE commit?
- Q2Bảng `tasks` đang bloat nặng trong production giờ cao điểm. Bạn làm gì, và vì sao không phải VACUUM FULL?
- Q3Với `tasks` có 50.000 live row, default autovacuum trigger khi có bao nhiêu dead tuple? Vì sao con số đó là vấn đề cho bảng heavy-update?
- Q4Một analytics query chạy 2 giờ không commit. Điều gì xảy ra với bloat của `tasks`, detect và fix thế nào?
- Q5Điều kiện để `SELECT id, status FROM tasks WHERE project_id = 42` thật sự chạy Index Only Scan với Heap Fetches: 0 là gì?
- Q6Vì sao hạ scale_factor per-table tốt hơn hạ GUC toàn cục, và khi nào KHÔNG nên hạ thấp?
Bài tiếp theo: Locks và deadlock — row lock, table lock, SKIP LOCKED
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
MVCC internals — vì sao SELECT không bao giờ block UPDATE
Bài tiếpLocks và deadlock — row lock, table lock, SKIP LOCKED
Thảo luận & góp ý
Hỏi đáp về bài này