Locks và deadlock — row lock, table lock, SKIP LOCKED
8 lock mode của PostgreSQL, deadlock tái hiện bằng 2 psql session và wait-for graph, pg_blocking_pids tìm ai chặn ai, và SKIP LOCKED cho hàng đợi worker.
TL;DR: MVCC để reader và writer không chặn nhau, nhưng hai UPDATE cùng một row vẫn phải xếp hàng: PostgreSQL giữ row lock cho transaction ghi trước, transaction sau chờ tới khi nó commit hoặc rollback. Bảng có 8 lock mode từ ACCESS SHARE (SELECT) tới ACCESS EXCLUSIVE (ALTER TABLE, VACUUM FULL), mode càng nặng càng conflict nhiều. Deadlock là khi hai transaction chờ nhau thành vòng; sau deadlock_timeout (1 giây) PG dựng wait-for graph, thấy chu trình thì abort một nạn nhân với SQLSTATE 40P01, và app phải retry. Cách tránh rẻ nhất: lock theo cùng thứ tự. pg_blocking_pids cho biết ai chặn ai, lock_timeout để fail nhanh, SKIP LOCKED để N worker chia việc không cần coordinator.
Mở 2 terminal, kết nối vào cùng một database, rồi chạy bốn câu UPDATE dưới theo đúng thứ tự, mỗi session hai câu, cả hai đều chưa COMMIT.
Trước khi chạy: bạn đoán hai session này sẽ ở trạng thái gì sau 5 giây, và nếu có ai đó thoát ra được thì là ai?
-- Session A:
BEGIN;
UPDATE accounts SET balance = balance - 10 WHERE id = 1;

-- Session B:
BEGIN;
UPDATE accounts SET balance = balance + 10 WHERE id = 2;

-- Session A (tiep):
UPDATE accounts SET balance = balance + 10 WHERE id = 2;

-- Session B (tiep):
UPDATE accounts SET balance = balance - 10 WHERE id = 1;
Kết quả, ở session B:
ERROR:  deadlock detected
DETAIL:  Process 12345 waits for ShareLock on transaction 789; blocked by process 12346.
         Process 12346 waits for ShareLock on transaction 788; blocked by process 12345.
HINT:   See server log for query details.
Mã lỗi là SQLSTATE 40P01; psql không in nó ra mặc định, bạn lấy qua err.code phía client hoặc bật \set VERBOSITY verbose.
Hai câu UPDATE sau cùng treo vì mỗi bên chờ row bên kia đang giữ; sau khoảng 1 giây, một transaction bị abort, cái kia đi tiếp. Đó là deadlock, và nó xảy ra bất cứ khi nào hai transaction lock hai tài nguyên theo thứ tự ngược nhau. Nắm được lock giúp bạn tránh deadlock ngay từ khi viết code.
1. Analogy — phòng họp, mỗi ghế một chủ
Một phòng họp lớn, mỗi ghế một chủ, là cách dễ nhớ nhất cho 8 lock mode. Đứng ngoài nhìn qua cửa kính thì không phiền ai; sửa nội thất một ghế thì người khác vẫn dùng ghế còn lại; còn phá trần sửa cả phòng thì phải đuổi hết mọi người, kể cả người chỉ đứng xem. Tám lock mode của PostgreSQL xếp đúng theo mức can thiệp đó:
| Trong phòng họp | Lock mode | Ai lấy |
|---|---|---|
| Đứng ngoài nhìn qua kính | ACCESS SHARE | SELECT |
| Đặt chỗ tạm một ghế | ROW SHARE | SELECT … FOR UPDATE / FOR SHARE |
| Sửa nội thất một ghế | ROW EXCLUSIVE | INSERT / UPDATE / DELETE |
| Thay sàn, người khác vẫn làm việc nhẹ | SHARE UPDATE EXCLUSIVE | VACUUM, ANALYZE, CREATE INDEX CONCURRENTLY |
| Cố định ghế cho hội thảo, không ai xê dịch | SHARE | CREATE INDEX (không CONCURRENTLY) |
| Sắp lại toàn bộ bàn ghế | SHARE ROW EXCLUSIVE | CREATE TRIGGER, ALTER TABLE … ADD FOREIGN KEY |
| Tắt đèn trình chiếu, hầu hết phải ra | EXCLUSIVE | REFRESH MATERIALIZED VIEW CONCURRENTLY |
| Phá trần sửa cả phòng, đuổi cả người xem | ACCESS EXCLUSIVE | ALTER TABLE, DROP, TRUNCATE, VACUUM FULL |
Mode càng nặng càng conflict với nhiều mode khác. Hai ô đáng nhớ nhất: chỉ ACCESS EXCLUSIVE mới chặn được ACCESS SHARE, còn ACCESS EXCLUSIVE thì chặn tất cả, kể cả một SELECT vô hại. Ma trận conflict đầy đủ nằm trong Explicit Locking của PG docs.
2. MVCC đã có rồi, vì sao vẫn cần lock?
Bài 04 cho thấy MVCC giữ nhiều phiên bản của row nên SELECT không chờ UPDATE. Nhưng MVCC không quyết định được chuyện này: T1 và T2 cùng muốn UPDATE tasks.status của id = 42. Không có lock, kết quả phụ thuộc thứ tự commit và một UPDATE bị mất. Vì thế transaction ghi vào row trước giữ row lock, transaction ghi sau chờ tới khi nó commit hoặc rollback rồi mới đánh giá lại điều kiện WHERE trên phiên bản mới.
Lock cấp bảng thì dành cho DDL: ALTER TABLE đổi structure, mọi query đang chạy trên bảng cần structure ổn định, nên ACCESS EXCLUSIVE đảm bảo không ai đang đọc hay ghi khi DDL diễn ra. Hai hệ quả bạn sẽ gặp ngoài đời: ALTER TABLE trên bảng production phải chờ mọi SELECT đang chạy xong, và trong lúc nó chờ, mọi query mới xếp sau nó; còn VACUUM thường (SHARE UPDATE EXCLUSIVE) không chặn DML, đúng như bài 05 đã nói, chỉ VACUUM FULL mới chặn tất cả.
3. SELECT FOR UPDATE / FOR SHARE / SKIP LOCKED / NOWAIT
Khi đọc row với ý định ghi, lock nó ngay lúc đọc để không có khoảng hở giữa đọc và ghi:
-- FOR UPDATE: lock row, tx khac UPDATE/DELETE/FOR UPDATE cung row phai cho
SELECT * FROM tasks WHERE id = 1 FOR UPDATE;

-- FOR SHARE: nhieu tx cung giu duoc, chi chan UPDATE/DELETE
SELECT * FROM tasks WHERE id = 1 FOR SHARE;

-- SKIP LOCKED: bo qua row dang bi lock, lay row ke tiep (queue pattern)
SELECT * FROM tasks WHERE status = 'pending' LIMIT 1 FOR UPDATE SKIP LOCKED;

-- NOWAIT: loi ngay neu phai cho, khong block
SELECT * FROM tasks WHERE id = 1 FOR UPDATE NOWAIT;
-- ERROR: could not obtain lock on row in relation "tasks"
FOR UPDATE khi bạn chắc sẽ ghi sau khi đọc; FOR SHARE khi nhiều reader cùng cần row đứng yên; NOWAIT khi app có việc khác để làm ngay thay vì chờ; SKIP LOCKED là xương sống của hàng đợi worker ở mục 8. Ứng dụng đủ ba pattern vào một race thật nằm ở mini-challenge race condition.
Thử ngẫmmột API dùng SELECT FOR UPDATE NOWAIT để lấy task, nhưng đổi ý muốn worker chờ thay vì fail ngay. Đổi NOWAIT thành gì để có hành vi đó mà không đổi logic ứng dụng?
4. PostgreSQL phát hiện deadlock như thế nào?
Tái hiện chính xác deadlock ở phần mở đầu. Session A lock row 1, session B lock row 2, A với sang row 2 thì treo chờ B, B với sang row 1 thì treo chờ A:
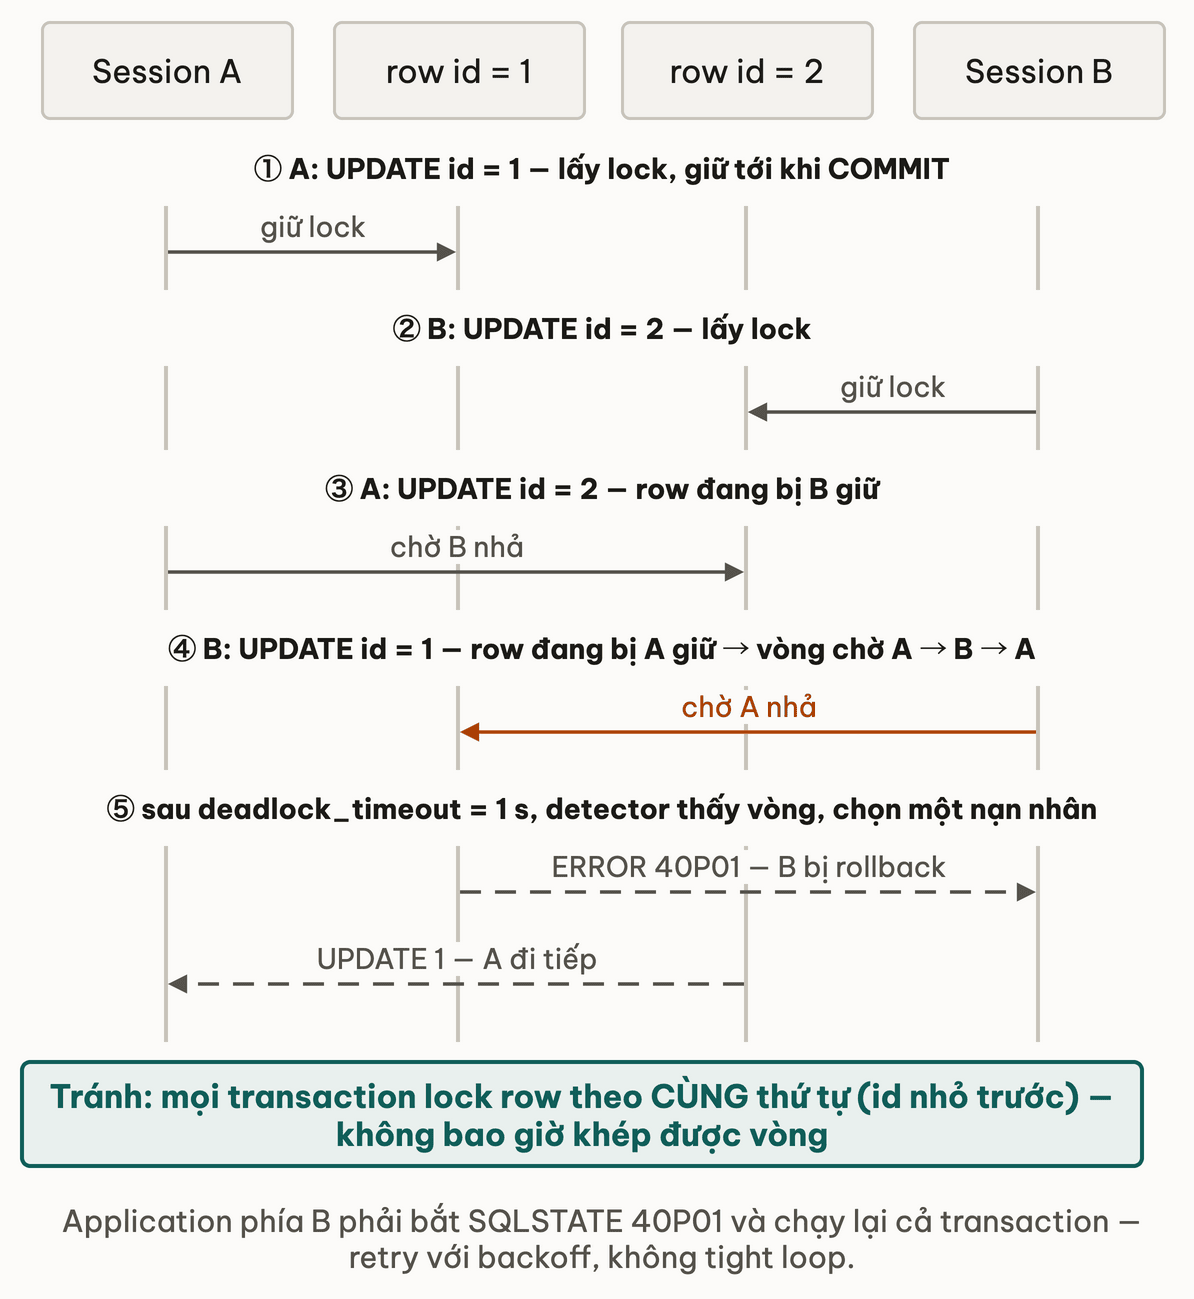
Hai mũi tên chờ chéo nhau trong hình là một wait-for graph: mỗi transaction là một node, và có cạnh từ T tới U khi T đang chờ lock mà U giữ. Deadlock là lúc trong graph có chu trình: A → B → A, không ai có thể đi tiếp vì ai cũng chờ người kia. PostgreSQL không kiểm tra graph mỗi lần ai đó phải chờ, vì dựng graph phải khoá lock table dùng chung và không rẻ. Nó chỉ làm việc đó khi một backend đã chờ quá deadlock_timeout (mặc định 1 giây): backend ấy khoá lock table, đi theo các cạnh chờ, và nếu quay về chính mình thì báo deadlock. Nạn nhân là chính transaction phát hiện ra chu trình. Trong hình, B là người chờ tới hạn trước nên B nhận 40P01 và bị rollback toàn bộ, A tiếp tục với UPDATE 1. App phía B phải catch 40P01 và chạy lại từ đầu.
Cách tránh: mọi transaction lock resource theo cùng một thứ tự. Nếu cả hai session đều UPDATE id = 1 trước rồi id = 2, graph không bao giờ có chu trình. Đây là nguyên tắc số một khi viết code chạm nhiều row trong một transaction.
5. Ai đang chặn ai — pg_blocking_pids
Khi production nghẽn vì lock, một query trả lời được câu hỏi quan trọng nhất:
SELECT pid, pg_blocking_pids(pid) AS blocked_by, state,
       now() - xact_start AS tx_age, left(query, 60) AS query
FROM pg_stat_activity
WHERE cardinality(pg_blocking_pids(pid)) > 0
ORDER BY xact_start;
-- pid   | blocked_by | state  | tx_age   | query
-- 23457 | {23456}    | active | 00:02:11 | UPDATE tasks SET status = ...
Rồi tra pid trong blocked_by: nếu nó ở state = 'idle in transaction' với xact_start cũ, đó là transaction bị bỏ quên (app crash, thiếu COMMIT trong error handler, pool không thu hồi connection). Xử lý: pg_cancel_backend(pid) trước, không đủ thì pg_terminate_backend(pid); rồi tìm vì sao app để lại nó. pg_locks cho chi tiết từng lock (mode, granted, relation::regclass) khi cần biết mode nào đụng mode nào; wait_event_type = 'Lock' xác nhận backend đang chờ lock chứ không phải I/O.
6. lock_timeout, statement_timeout, deadlock_timeout
BEGIN;
SET LOCAL lock_timeout = '1500ms';        -- loi 55P03 neu cho lock qua 1.5s
SET LOCAL statement_timeout = '2000ms';   -- huy statement neu tong thoi gian qua 2s (ke ca cho lock)
-- ... business logic cho API co SLA 2 giay ...
COMMIT;

SHOW deadlock_timeout;   -- 1s, dat trong postgresql.conf, hau nhu khong can doi
lock_timeout để fail nhanh rồi retry thay vì treo vô hạn; statement_timeout là trần tổng cho một statement, gồm cả thời gian chờ lock; deadlock_timeout chỉ là thời điểm PG bắt đầu tìm chu trình, không phải thời gian tối đa được chờ. Đừng hạ nó xuống dưới 1 giây: mỗi lần kiểm tra là một lần khoá lock table, chờ lâu hơn một giây trong đa số hệ thống mới đáng để trả giá đó.
Thử ngẫmstatement_timeout đặt 2000ms nhưng lock_timeout để mặc định không giới hạn. Một UPDATE chờ lock 5 giây rồi mới chạy thật, statement_timeout có cắt được nó không?
7. Pitfall — optimistic hay pessimistic?
Pessimistic (SELECT … FOR UPDATE): lock ngay khi đọc, không ai sửa được row tới khi bạn commit. Hợp khi contention cao, tránh retry liên tục; giá là lock giữ suốt business logic, throughput giảm nếu logic dài.
Optimistic (cột version + compare-and-swap): không lock khi đọc, lúc ghi kiểm tra row còn nguyên không. Hợp khi contention thấp; contention cao thì 20 worker cùng đọc version = 5, chỉ một ghi được, 19 retry rồi lại chỉ một ghi được, throughput gần bằng chạy tuần tự.
-- Optimistic: chi ghi neu version chua doi
UPDATE tasks SET status = 'done', version = version + 1
WHERE id = 42 AND version = 5;
-- rowCount = 0: ai do da sua -> doc lai, retry

-- Pessimistic: giu row tu luc doc toi COMMIT
BEGIN;
SELECT id, status FROM tasks WHERE id = 42 FOR UPDATE;
UPDATE tasks SET status = 'done' WHERE id = 42;
COMMIT;
Cả 40P01 (deadlock) lẫn 40001 (serialization failure ở REPEATABLE READ/SERIALIZABLE) đều cần retry, và retry phải có backoff kèm jitter; nếu 20 client cùng retry đúng một thời điểm thì conflict tái diễn y nguyên:
async function retryOnConflict(fn, maxAttempts = 5) {
  for (let attempt = 0; attempt < maxAttempts; attempt++) {
    try {
      return await fn();
    } catch (err) {
      if (err.code !== '40P01' && err.code !== '40001') throw err;
      if (attempt === maxAttempts - 1) throw new Error('Max retry exceeded');
      // 50, 100, 200, 400ms... cap 2s, cong jitter de cac client khong retry cung luc
      const delay = Math.min(50 * 2 ** attempt, 2000) + Math.random() * 50;
      await new Promise(r => setTimeout(r, delay));
    }
  }
}
Khi nào chọn cái nào với một case check-trùng thật (multi-instance, cả hai hướng), đọc blog Check trùng bằng SELECT trên nhiều instance.
Thử ngẫmpg_blocking_pids cho thấy một session idle in transaction giữ lock 20 phút. lock_timeout của các session khác có giúp gì cho tình huống này không?
8. Applied — hàng đợi worker với SKIP LOCKED
TaskFlow có nhiều worker cùng xử lý tasks. Bài toán kinh điển: N worker cùng pull mà không lấy trùng task và không cần coordinator. SKIP LOCKED giải đúng bài này:
-- Moi worker chay cung mot doan:
BEGIN;
SELECT id, payload FROM tasks
WHERE status = 'pending'
ORDER BY created_at
LIMIT 1
FOR UPDATE SKIP LOCKED;          -- row dang bi worker khac giu -> bo qua, khong cho
UPDATE tasks SET status = 'processing' WHERE id = <id vua lay>;
COMMIT;
-- Khong con row nao: tra ve rong, khong block
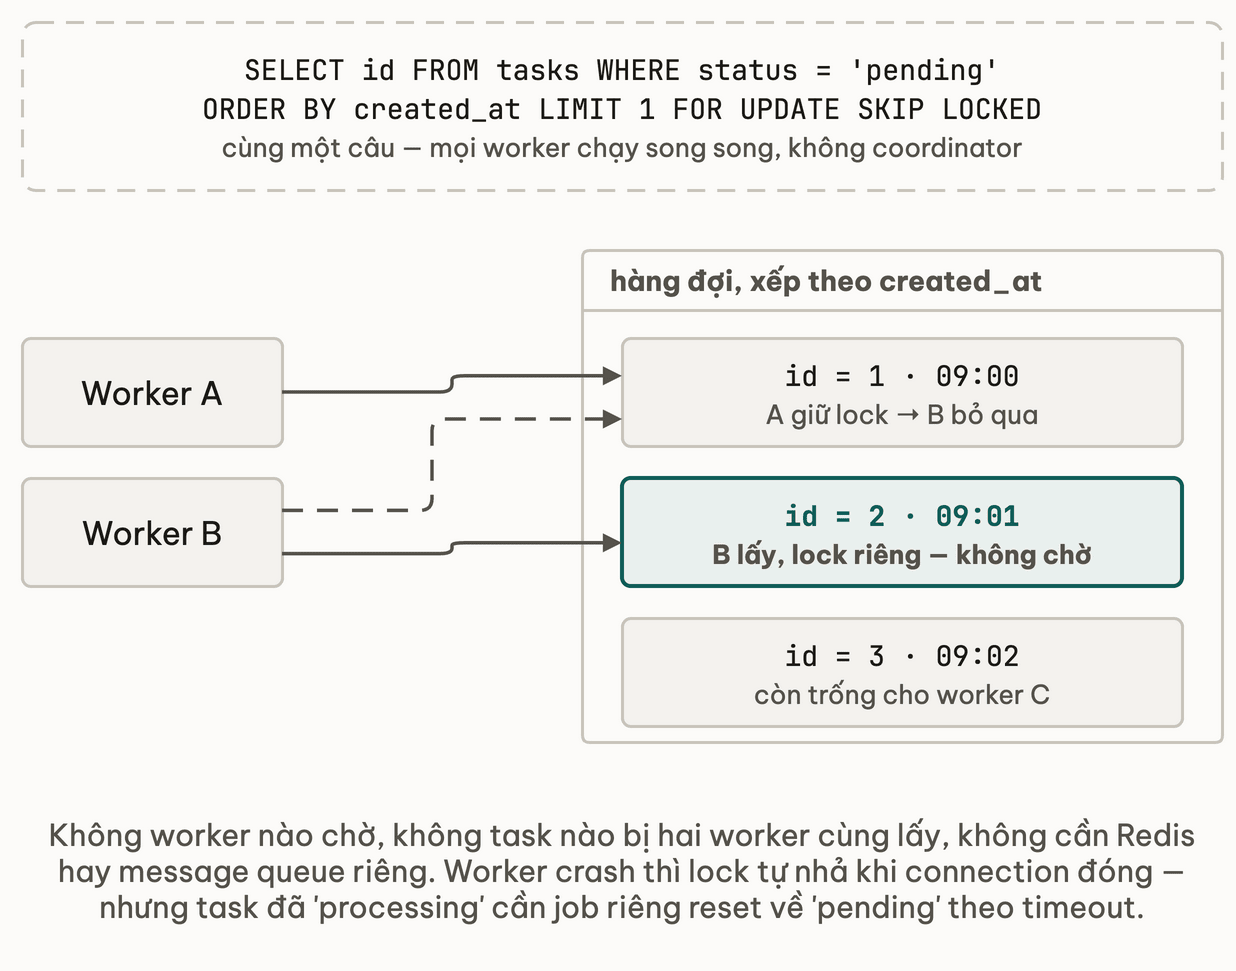
Hai chi tiết để pattern này sống được trong production: ORDER BY created_at giữ FIFO, thiếu nó các worker tranh nhau cùng một nhúm row đầu heap; và worker crash thì lock tự nhả khi connection đóng nhưng task kẹt ở processing, cần một job trả task processing quá 10 phút về pending.
9. Liên hệ các bài khác
- MVCC internals: vì sao reader không cần lock; bài này bắt đầu đúng chỗ MVCC dừng lại.
- VACUUM và dead tuple:
VACUUMvàVACUUM FULLnằm ở hai đầu bảng lock mode, đó là lý do một cái chạy được giờ cao điểm còn cái kia thì không. - Mini-challenge race condition: đo
FOR UPDATE, atomicUPDATE … WHEREvà Serializable + retry trên cùng một race bằng script chạy được. - Isolation level và 4 anomaly: lock là công cụ, còn cần ngăn anomaly nào là câu hỏi của isolation level; đọc trước khi chọn giữa
FOR UPDATEvà nâng mức isolation. - Anomaly và serializability trong hệ phân tán: khi row nằm trên nhiều node, row lock của một PostgreSQL không còn đủ.
- PostgreSQL Documentation — Explicit Locking: 8 lock mode, ma trận conflict, row-level lock, advisory lock và deadlock. Đối chiếu bảng ở mục 1 với ma trận ở đây.
- PostgreSQL 14 Internals — Egor Rogov, Part III "Locks": chương 12–15 đi vào lock manager: relation-level lock, row-level lock, lightweight lock và cách deadlock detector dựng wait-for graph.
10. Tóm tắt
- Lỗi
40P01: đừng chỉ retry, mở server log lấy hai câu query trong DETAIL rồi đổi thứ tự lock cho khớp nhau. - Migration
ALTER TABLEtreo: chạypg_blocking_pidstìm SELECT hay idle-in-transaction đang giữ ACCESS SHARE, và đặtlock_timeoutcho chính câu ALTER để nó không kéo cả hàng đợi theo. - Hàng đợi bằng bảng:
FOR UPDATE SKIP LOCKED+ORDER BY+ job reset taskprocessingquá hạn. - Row bị tranh chấp bởi hàng chục writer:
FOR UPDATEhoặcUPDATE … SET x = x + 1, đừng optimistic. deadlock_timeoutgiữ 1s;lock_timeoutvàstatement_timeoutmới là thứ đặt theo SLA của từng endpoint.
11. Tự kiểm tra
- Q1Vì sao ALTER TABLE trên bảng production lớn có thể treo hàng phút, và vì sao chạy vào giờ thấp điểm vẫn không chắc tránh được?
- Q2Hàm transfer tiền giữa hai account: điều kiện nào tạo deadlock, và hai cách viết code để nó không bao giờ xảy ra?
- Q3Phân biệt SKIP LOCKED và NOWAIT. Mỗi cái hợp use case nào?
- Q4Trong TaskFlow, bảng project_stats được 50 transaction cùng UPDATE khi bulk import hoàn tất. Optimistic locking gặp gì ở đây, và sửa thế nào?
- Q5pg_blocking_pids cho thấy nhiều backend bị chặn bởi cùng một pid. Ba bước tiếp theo để xử lý mà không restart database?
Bài tiếp theo: Mini-challenge — race condition khi 2 user cùng assign task
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
VACUUM và dead tuple: bảng phình to dù count(*) không tăng
Bài tiếpMini-challenge — race condition khi 2 user cùng assign task
Thảo luận & góp ý
Hỏi đáp về bài này