Mini-challenge — race condition khi 2 user cùng assign task
Hai user bấm Assign me cùng lúc: tái hiện race bằng script, rồi fix ba cách (SELECT FOR UPDATE, atomic UPDATE WHERE, Serializable + retry) và so sánh tradeoff.
TaskFlow vừa ra feature "Assign me" — user click nút, hệ thống gán task cho họ nếu task chưa có người nhận. PM nói: "Simple thôi, check assignee_id rồi UPDATE."
Bạn viết 10 dòng code, deploy. Mọi thứ trông ổn. Nhưng một tuần sau có user report: "Mình click Assign me, thấy tên mình hiện lên rồi biến mất." Không error log, không exception, chỉ có dữ liệu sai: kiểu silent failure kinh điển của race condition.
Bài này không có concept mới: bạn tái hiện race, đếm tần suất, rồi fix theo ba cách để thấy tradeoff thực chiến; cuối bài là 4 script chạy được trên một khung đo chung và một bảng so sánh. Ba cách fix dùng đúng ba thứ module này đã dạy: hành vi snapshot của READ COMMITTED ở bài MVCC, SELECT FOR UPDATE và retry ở bài locks, và cái giá của một transaction giữ lock quá lâu ở bài VACUUM. Cùng bài toán này ở góc nhìn nhiều instance app: blog Check trùng bằng SELECT trên nhiều instance.
Setup — schema + dependencies
Schema TaskFlow canonical cho bài này. Task #42 phải tồn tại và có assignee_id = NULL trước mỗi lần chạy:
-- TaskFlow schema (canonical)
CREATE TABLE IF NOT EXISTS users (
  id         BIGSERIAL PRIMARY KEY,
  name       TEXT NOT NULL,
  email      TEXT NOT NULL UNIQUE
);

CREATE TABLE IF NOT EXISTS tasks (
  id           BIGSERIAL PRIMARY KEY,
  project_id   BIGINT NOT NULL,
  assignee_id  BIGINT REFERENCES users(id),  -- nullable: chua assign
  title        TEXT NOT NULL,
  status       TEXT NOT NULL CHECK (status IN ('todo', 'doing', 'done', 'archived')),
  due_at       TIMESTAMPTZ,
  created_at   TIMESTAMPTZ NOT NULL DEFAULT now(),
  updated_at   TIMESTAMPTZ NOT NULL DEFAULT now()
);

-- Seed users va task de demo
INSERT INTO users (id, name, email) VALUES
  (1, 'Alice', '[email protected]'),
  (2, 'Bob',   '[email protected]')
ON CONFLICT (id) DO NOTHING;

INSERT INTO tasks (id, project_id, assignee_id, title, status)
VALUES (42, 1, NULL, 'Design login page', 'todo')
ON CONFLICT (id) DO UPDATE SET assignee_id = NULL;

-- Reset task ve unassigned truoc moi lan chay
UPDATE tasks SET assignee_id = NULL WHERE id = 42;
Cài node-postgres nếu chưa có:
# Cai node-postgres neu chua co
npm install pg
Mỗi script đọc DATABASE_URL từ environment và dùng chung một khung đo harness.js: reset task, cho hai user chạy song song, đếm số vòng mà cả hai cùng tin là mình assign được:
export DATABASE_URL="postgresql://user:password@localhost:5432/taskflow"
// harness.js -- khung chung cho ca 4 script
import pg from 'pg';
export const pool = new pg.Pool({ connectionString: process.env.DATABASE_URL });

export async function measure(assignFn, taskId = 42, rounds = 100) {
  let raceCount = 0;
  for (let i = 0; i < rounds; i++) {
    await pool.query('UPDATE tasks SET assignee_id = NULL WHERE id = $1', [taskId]);
    const [a, b] = await Promise.all([assignFn(1, taskId), assignFn(2, taskId)]);
    if (a && b) raceCount++;
  }
  console.log(`Race rate: ${raceCount}/${rounds}`);
  await pool.end();
}
Step 1 — Vì sao naive SELECT-then-UPDATE sinh race?
Naive code nhìn đúng về logic, sai về concurrency: giữa SELECT và UPDATE là hai statement độc lập, không gì bảo vệ khoảng hở ở giữa.
Trước khi chạy: với 2 user và delay 5 ms, bạn đoán trong 100 vòng có bao nhiêu vòng mà cả hai cùng nhận true? Ghi con số ra rồi mới đọc tiếp.
// race-repro.js
import { pool, measure } from './harness.js';

async function naiveAssign(userId, taskId) {
  const { rows } = await pool.query('SELECT assignee_id FROM tasks WHERE id = $1', [taskId]);
  if (rows[0].assignee_id !== null) return false;
  await new Promise(r => setTimeout(r, 5));   // simulate app-side latency
  await pool.query('UPDATE tasks SET assignee_id = $1 WHERE id = $2', [userId, taskId]);
  return true;
}

await measure(naiveAssign);
Cách chạy:
node race-repro.js
Expected output:
Race rate: 80-95/100
Cả hai SELECT thấy NULL, cả hai UPDATE "thành công", user ghi sau đè lên user ghi trước (last write wins), và user ghi trước tưởng mình giữ task. Race rate cao (80–95%) vì delay 5 ms cố ý làm hai cửa sổ chồng lên nhau. Production không có delay này nhưng race vẫn xảy ra, chỉ hiếm hơn và khó debug hơn, và vì không ai thấy lỗi nên chẳng ai biết nó đang xảy ra.
Default isolation level của PostgreSQL là Read Committed. Ở RC, mỗi statement chụp snapshot mới tại thời điểm nó chạy (bài MVCC, mục 5). SELECT và UPDATE là hai statement tách biệt, không gì đảm bảo state đứng yên giữa hai câu. Bọc chúng trong một transaction ở RC chỉ giúp rollback khi có lỗi, nó không ngăn race giữa các statement.
Đề bài: viết lại naiveAssign (giữ nguyên harness.js) để Race rate: 0/100, bằng công cụ bạn đã học ở bài 04–06 để đóng khoảng hở giữa đọc và ghi. Có ít nhất ba cách; hãy tự chọn một, chạy 100 vòng, rồi mới mở lời giải bên dưới để đối chiếu.
Step 2 — Fix 1: SELECT FOR UPDATE + check + UPDATE
SELECT FOR UPDATE lấy row-level lock ngay khi SELECT. Transaction thứ 2 cố SELECT FOR UPDATE cùng row sẽ bị block cho đến khi transaction thứ 1 COMMIT hoặc ROLLBACK. Tx 1 commit xong, tx 2 mới đọc được row, thấy assignee_id đã có người nhận, điều kiện IS NULL sai nên hàm trả false.
Gợi ý: khoá row trước khi kiểm tra, trong cùng một transaction.
Thay hàm này vào khung chung:
import { pool, measure } from './harness.js';

async function safeAssign(userId, taskId) {
  const client = await pool.connect();
  try {
    await client.query('BEGIN');
    // FOR UPDATE: tx thu 2 block o day cho den khi tx 1 COMMIT hoac ROLLBACK
    const { rows } = await client.query(
      'SELECT assignee_id FROM tasks WHERE id = $1 FOR UPDATE', [taskId]);
    const free = rows[0].assignee_id === null;
    if (free) {
      await new Promise(r => setTimeout(r, 5));   // simulate work, lock van giu
      await client.query('UPDATE tasks SET assignee_id = $1 WHERE id = $2', [userId, taskId]);
    }
    await client.query('COMMIT');
    return free;
  } catch (err) { await client.query('ROLLBACK'); throw err; }
  finally { client.release(); }
}

await measure(safeAssign);
Cách chạy:
node fix1-for-update.js
Expected output:
Race rate: 0/100
Vì sao ra 0 race? FOR UPDATE xếp hàng mọi truy cập vào cùng một row, nên transaction sau phải đợi. Timeline thực tế:
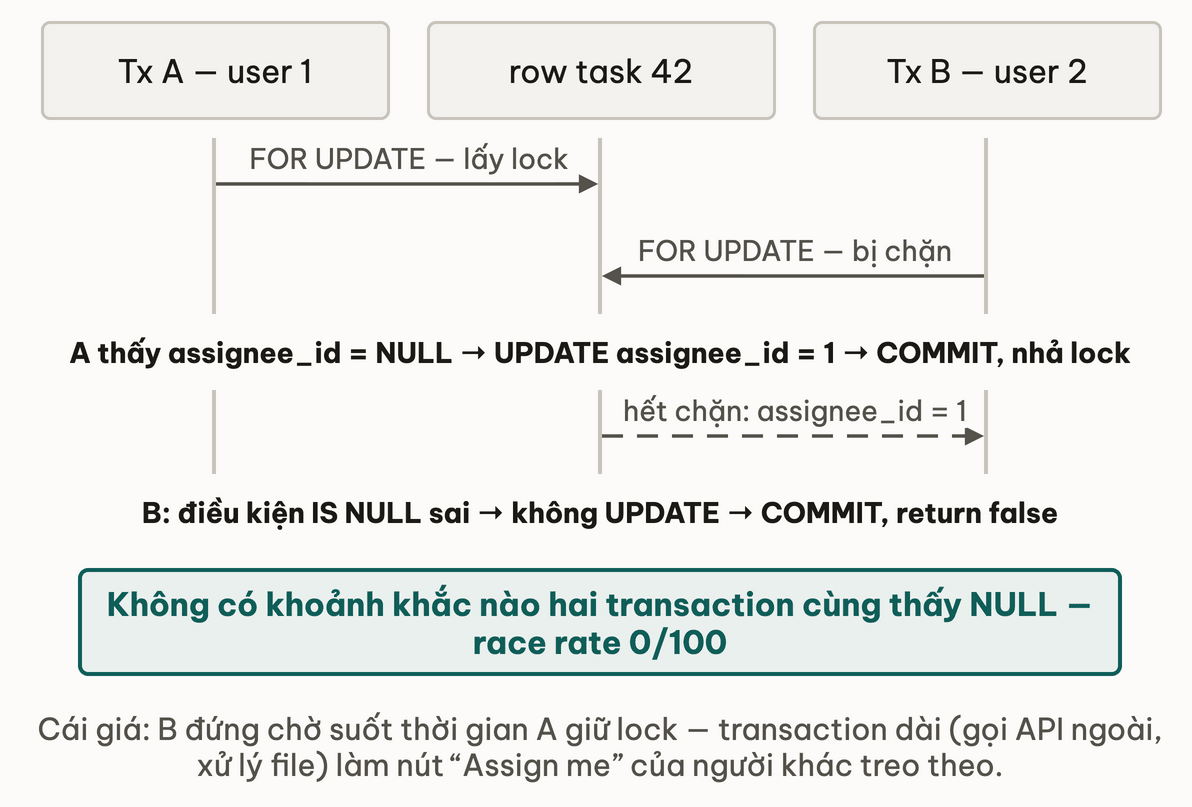
Tx B không bao giờ thấy NULL sau khi Tx A commit, nên không thể gán trùng.
FOR UPDATE lock row từ SELECT đến COMMIT. Nếu transaction còn làm nhiều việc khác (gọi API bên ngoài, xử lý file, v.v.) sau SELECT FOR UPDATE, lock giữ trong suốt thời gian đó. User khác bấm "Assign me" thì phải đứng chờ, giao diện đơ theo. App crash giữa chừng mà chưa ROLLBACK thì lock nằm đó cho tới khi TCP keepalive phát hiện connection chết (có thể hàng giờ), trừ khi bạn đã đặt idle_in_transaction_session_timeout / statement_timeout để cắt nó. Dùng FOR UPDATE phù hợp khi transaction ngắn và toàn bộ logic nằm trong DB transaction.
Step 3 — Fix 2: UPDATE ... WHERE ... RETURNING (atomic conditional)
Thay vì SELECT-then-UPDATE, gộp luôn điều kiện kiểm tra vào câu UPDATE. Một câu UPDATE là nguyên tử, giữa lúc kiểm tra và lúc ghi không có khe hở nào. Tx thứ 2 chạy sau khi Tx 1 commit thì thấy assignee_id IS NOT NULL, mệnh đề WHERE không khớp dòng nào, rowCount = 0, hàm trả false.
Gợi ý: gộp kiểm tra và ghi vào một câu lệnh duy nhất.
Thay hàm này vào khung chung:
import { pool, measure } from './harness.js';

async function atomicAssign(userId, taskId) {
  // Mot statement duy nhat: kiem tra va ghi khong co khoang ho, khong can BEGIN/COMMIT
  const { rowCount } = await pool.query(
    `UPDATE tasks SET assignee_id = $1
     WHERE id = $2 AND assignee_id IS NULL
     RETURNING id`,
    [userId, taskId]
  );
  return rowCount === 1;   // 1: ta thang race; 0: da co nguoi khac assign
}

await measure(atomicAssign);
Cách chạy:
node fix2-conditional-update.js
Expected output:
Race rate: 0/100
So sánh với Fix 1: đơn giản hơn hẳn: không cần BEGIN/COMMIT, không cần explicit lock, không cần checkout client riêng từ pool. Row lock vẫn có, nhưng PG lấy và nhả nó trong cùng một statement. Tx thứ 2 chờ ở UPDATE, và khi Tx 1 commit, ở READ COMMITTED nó đánh giá lại WHERE trên phiên bản mới: assignee_id IS NULL không còn đúng, 0 row.
RETURNING id không bắt buộc về correctness nhưng hữu ích: cho phép phân biệt "gán thành công" (rowCount = 1) với "đã có người nhận" (rowCount = 0) mà khỏi query thêm. Pattern này cũng hoạt động đúng với autocommit (default trong node-postgres pool).
Thử ngẫmbusiness rule đổi thành "chỉ assign nếu chưa có ai VÀ user đó còn dưới 5 task đang mở". Fix 2 atomic UPDATE WHERE còn viết được gọn như cũ không?
Step 4 — Fix 3: Serializable isolation + retry on 40001
Ở REPEATABLE READ và SERIALIZABLE, transaction giữ một snapshot cố định từ lúc bắt đầu. Khi Tx B cố UPDATE một row mà Tx A đã UPDATE và commit trong lúc B đang chờ, PG không cho B ghi đè lên phiên bản B chưa từng thấy: B nhận 40001 (serialization_failure, "could not serialize access due to concurrent update") ngay tại câu UPDATE, không đợi tới COMMIT. Luật này tên first-updater-wins, có ngay từ REPEATABLE READ.
SERIALIZABLE bổ sung SSI (Serializable Snapshot Isolation): mỗi lần transaction đọc, PG để lại một SIREAD lock, dấu vết "tx này đã đọc row/range này" dùng để phát hiện phụ thuộc chéo giữa các transaction; nhờ đó nó bắt được cả write skew, tình huống hai transaction cùng đọc một điều kiện rồi mỗi bên ghi một row khác nhau khiến điều kiện chung bị vi phạm (hai bác sĩ cùng thấy "còn 2 người trực" rồi cùng xin nghỉ). Loại conflict đó do SSI phát hiện, có thể ngay giữa transaction hoặc lúc COMMIT; với ví dụ một row này, first-updater-wins là đòn quyết định. Bốn anomaly và mức isolation nào chặn được gì: Isolation level và 4 anomaly.
Gợi ý: để PostgreSQL tự phát hiện xung đột ở mức isolation cao nhất, và chuẩn bị chạy lại khi nó báo.
Hai mảnh: một retry helper (dùng lại được cho 40P01 của bài locks) và hàm assign chạy ở SERIALIZABLE.
// 40001 = serialization_failure (first-updater-wins tai UPDATE, hoac SSI tai COMMIT)
async function retryOnSerializationFail(fn, maxAttempts = 5) {
  for (let attempt = 0; attempt < maxAttempts; attempt++) {
    try {
      return await fn();
    } catch (err) {
      if (err.code !== '40001') throw err;
      if (attempt === maxAttempts - 1) throw new Error('Max retry exceeded');
      const delay = Math.min(50 * 2 ** attempt, 500) + Math.random() * 50;   // backoff + jitter
      await new Promise(r => setTimeout(r, delay));
    }
  }
}
import { pool, measure } from './harness.js';

async function ssiAssign(userId, taskId) {
  return retryOnSerializationFail(async () => {
    const client = await pool.connect();
    try {
      await client.query('BEGIN ISOLATION LEVEL SERIALIZABLE');
      const { rows } = await client.query('SELECT assignee_id FROM tasks WHERE id = $1', [taskId]);
      const free = rows[0].assignee_id === null;
      // Tx kia da UPDATE + commit trong luc ta cho lock -> UPDATE nay nem 40001 (first-updater-wins)
      if (free) await client.query('UPDATE tasks SET assignee_id = $1 WHERE id = $2', [userId, taskId]);
      await client.query('COMMIT');   // chi nem 40001 cho conflict SSI cheo row
      return free;
    } catch (err) { await client.query('ROLLBACK').catch(() => {}); throw err; }
    finally { client.release(); }
  });
}

await measure(ssiAssign);   // 1 tx nhan 40001, retry, SELECT lai thay da co nguoi -> false
Cách chạy:
node fix3-serializable-retry.js
Expected output:
Race rate: 0/100
Tại sao cần retry ở Fix 3 mà Fix 1 và Fix 2 không cần? Ở READ COMMITTED (Fix 1, Fix 2), transaction thứ 2 chờ rồi đánh giá lại trên phiên bản mới và đi tiếp, không có lỗi. Ở SERIALIZABLE, snapshot của Tx B đã cố định từ lúc BEGIN; khi A commit, B không được phép "đọc lại" mà bị abort với 40001, và mọi conflict SSI chéo row cũng kết thúc bằng cùng mã lỗi. Caller phải bắt và chạy lại từ đầu. Đó là tradeoff của optimistic concurrency: ít conflict thì không ai phải chờ ai, có conflict thì trả giá bằng một vòng retry.
So sánh 3 cách — tradeoff
| Cách | Cú pháp | Lock | Cần retry? | Độ phức tạp | Nên dùng khi |
|---|---|---|---|---|---|
| Fix 1 — FOR UPDATE | BEGIN + SELECT FOR UPDATE + UPDATE + COMMIT | Row-level explicit (pessimistic) | Không | Trung bình | Transaction có nhiều bước phụ thuộc state đã đọc |
| Fix 2 — Atomic UPDATE WHERE | 1 statement duy nhất | Implicit row write lock | Không | Đơn giản nhất | Decision logic có thể encode vào WHERE clause |
| Fix 3 — Serializable + retry | BEGIN ISOLATION LEVEL SERIALIZABLE + retry helper | Snapshot cố định + SIREAD (optimistic) | Có (40001) | Cao nhất | Workflow phức tạp đa table, không thể atomic 1 statement |
Với bài toán assign task:
Chọn Fix 2: luật "chỉ assign nếu chưa có ai" nhét gọn vào WHERE assignee_id IS NULL, khỏi BEGIN, khỏi lock tường minh, khỏi retry.
Dùng Fix 1 — FOR UPDATE khi transaction cần làm nhiều bước phụ thuộc: ví dụ "check assignee → insert audit log → send notification → update task" trong cùng một transaction. FOR UPDATE đảm bảo state không thay đổi giữa các bước.
Dùng Fix 3 — Serializable cho workflow phức tạp chạm nhiều bảng, nơi xung đột đọc-ghi chéo bảng và không gom được vào một câu lệnh. Bạn trả bằng chi phí retry, đổi lại được mức đảm bảo chặt nhất.
Thử ngẫmworkflow đổi thành "assign task + insert audit log + gửi notification". Cách nào trong ba cách hợp nhất, và bước gửi notification nên nằm trong hay ngoài transaction?
- PostgreSQL Documentation — SELECT FOR UPDATE / FOR SHARE: tra cứu đầy đủ các lock mode, cùng tuỳ chọn NOWAIT và SKIP LOCKED.
- PostgreSQL Documentation — Serializable Isolation Level: cơ chế SSI, SIREAD locks, serialization_failure và retry pattern.
- PostgreSQL Documentation — Explicit Locking: row-level vs table-level locks, deadlock detection, advisory locks.
Bài tiếp theo: EXPLAIN — đọc kế hoạch thực thi
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Locks và deadlock — row lock, table lock, SKIP LOCKED
Bài tiếp EXPLAIN & query optimizationEXPLAIN & EXPLAIN ANALYZE — đọc query plan của PostgreSQL
Thảo luận & góp ý
Hỏi đáp về bài này