MVCC internals — vì sao SELECT không bao giờ block UPDATE
PostgreSQL giữ nhiều phiên bản của một row với xmin/xmax; mỗi transaction đọc theo snapshot riêng nên SELECT không chờ UPDATE, đổi lại phải VACUUM.
TL;DR: PostgreSQL không sửa row tại chỗ. Mỗi UPDATE ghi một tuple mới và chỉ đánh dấu tuple cũ bằng xmax (transaction nào thay nó); mỗi tuple mang xmin (transaction nào tạo nó). Một transaction đọc dữ liệu qua snapshot, tức danh sách những transaction đã xong tại thời điểm chụp, và chỉ thấy tuple mà xmin đã xong còn xmax thì chưa. Vì phiên bản cũ vẫn nằm trên heap, SELECT không cần chờ UPDATE và ngược lại. Cái giá là dead tuple tích lại phải có VACUUM dọn, và xid 32-bit phải được freeze trước khi wraparound.
Bạn mở hai psql session. Session A chạy UPDATE tasks SET title = 'X' WHERE id = 1 rồi để đó, chưa COMMIT. Session B chạy SELECT title FROM tasks WHERE id = 1 ngay lúc ấy và có kết quả tức thì, không phải chờ và cũng không thấy dữ liệu nửa chừng. Làm sao một SELECT đọc được row đang bị UPDATE mà vẫn nhất quán?
Câu trả lời là MVCC (Multi-Version Concurrency Control). Không có lock nào bảo vệ reader khỏi writer. PostgreSQL lưu nhiều phiên bản của cùng một row trên heap page, mỗi phiên bản ghi rõ transaction nào tạo ra nó và transaction nào thay thế nó. Reader chọn phiên bản đúng với "thời điểm logic" của mình (gọi là snapshot) mà không cần chạm vào writer.
1. Analogy — thư viện không bao giờ bỏ bản in cũ
Một thư viện không bao giờ bỏ bản in cũ: mỗi lần sách được sửa, thủ thư in bản mới và giữ nguyên bản cũ trên kệ. Bạn vào thư viện lúc 9h thì nhận phiếu "9h" và chỉ được đọc những bản in xong trước 9h; ai đó in bản mới lúc 9h30 không ảnh hưởng gì tới bạn.
| Thư viện | PostgreSQL MVCC |
|---|---|
| Mỗi bản in ghi "in lúc nào, bị thay lúc nào" | Tuple có xmin (tx tạo) và xmax (tx thay thế) |
| Phiếu "9h" khi bước vào | Snapshot ở statement đầu tiên (hoặc ở mỗi statement) |
| Chỉ đọc bản in xong trước 9h | Chỉ thấy tuple có xmin đã commit trước snapshot |
| Thủ thư định kỳ dọn bản không ai cần | VACUUM dọn dead tuple (bài 05) |
2. xmin, xmax, ctid — cột ẩn trên mỗi tuple
Ở database dùng khoá (lock-based), SELECT và UPDATE chặn lẫn nhau. PostgreSQL chọn hướng khác từ đầu: metadata MVCC nằm ngay trong header của từng tuple trên heap page, và reader tự chọn phiên bản:
| Column | Kiểu | Ý nghĩa |
|---|---|---|
xmin | xid (32-bit) | txid của transaction đã INSERT tuple này |
xmax | xid | txid của transaction đã DELETE/UPDATE tuple này (0 nếu chưa) |
cmin | cid | thứ tự command trong transaction tạo tuple |
ctid | tid | vị trí vật lý (page, offset) |
Gọi thẳng tên chúng trong SELECT:
SELECT xmin, xmax, ctid, id, title FROM tasks WHERE id IN (1, 2);

-- xmin | xmax | ctid  | id | title
--  100 |    0 | (0,1) |  1 | Deploy API
--  100 |    0 | (0,2) |  2 | Write docs
-- xmax = 0: chua ai delete hoac update
Giờ session A (txid 101) UPDATE row 1 và chưa commit; session B đọc lại cột ẩn:
-- Session B, trong khi A chua COMMIT:
SELECT xmin, xmax, ctid, id, title FROM tasks WHERE id = 1;
-- xmin | xmax | ctid  | id | title
--  100 |  101 | (0,1) |  1 | Deploy API      <- tuple cu, xmax=101 nhung 101 chua commit

-- Sau khi A COMMIT, B doc lai:
-- xmin | xmax | ctid  | id | title
--  101 |    0 | (0,3) |  1 | Deploy API v2   <- tuple moi o slot khac
-- Tuple cu (xmin=100, xmax=101) van nam tren heap: dead tuple, doi VACUUM
3. UPDATE không sửa tại chỗ thì nó làm gì?
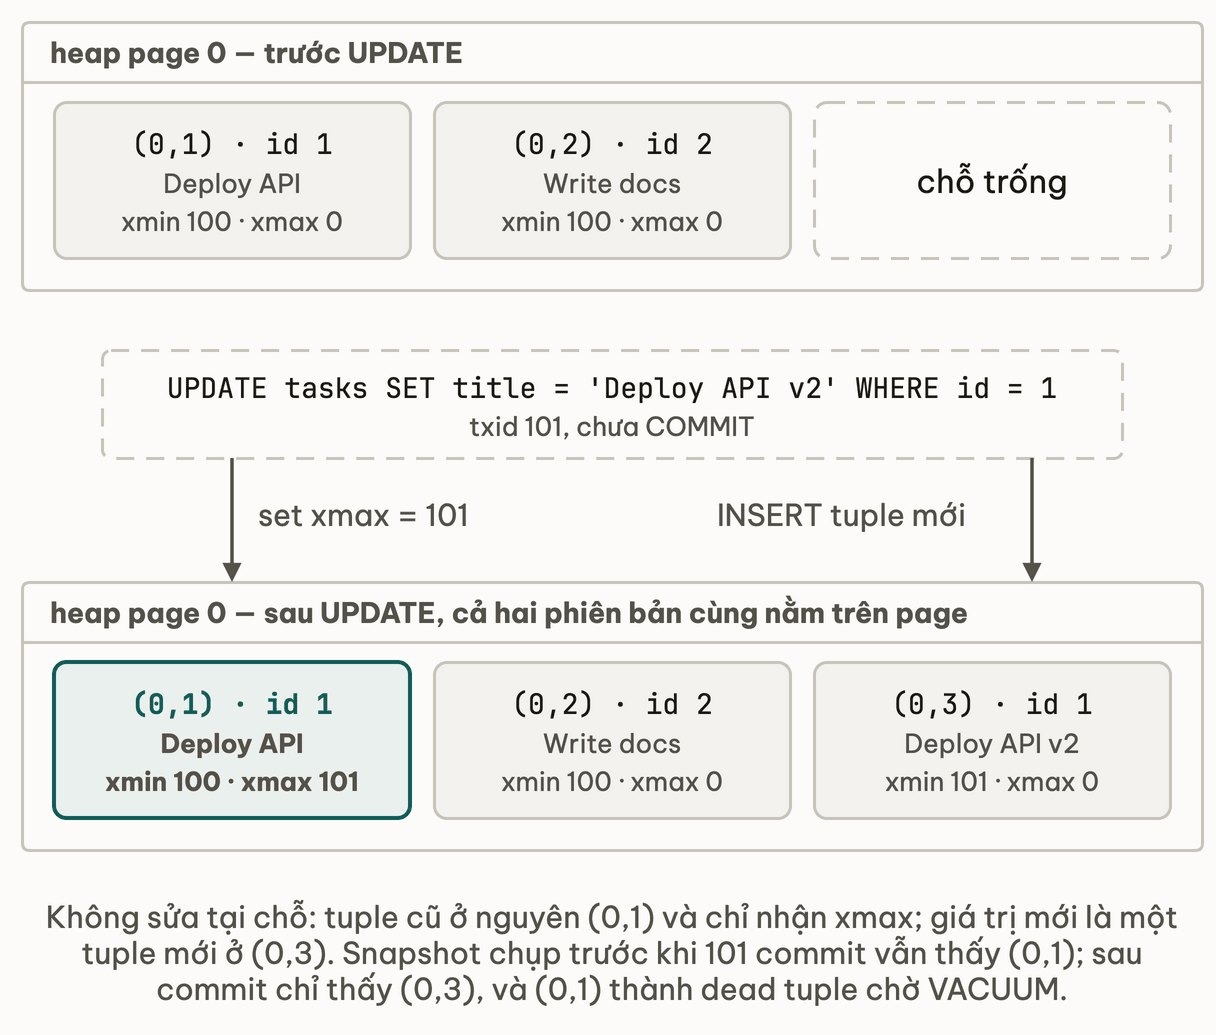
UPDATE tasks SET title = 'X' WHERE id = 1 thật ra là hai việc nguyên tử: set xmax lên tuple cũ = txid hiện tại, rồi INSERT một tuple mới với xmin = txid hiện tại và xmax = 0. Trong lúc transaction chưa commit, cả hai phiên bản cùng nằm trên page; snapshot chụp trước khi txid 101 commit chỉ thấy v1, snapshot sau đó chỉ thấy v2:
Ở bài B-tree internals bạn đã thấy mỗi entry index trỏ tới một ctid trên heap. Vậy tuple mới ở (0,3) có buộc mọi index phải ghi thêm entry không? Không, nếu HOT update (Heap-Only Tuple) áp dụng được: cột có index không đổi và cùng page còn chỗ. Khi đó tuple mới nằm cùng page, index vẫn trỏ tới tuple cũ, và tuple cũ dùng t_ctid chỉ sang tuple mới:
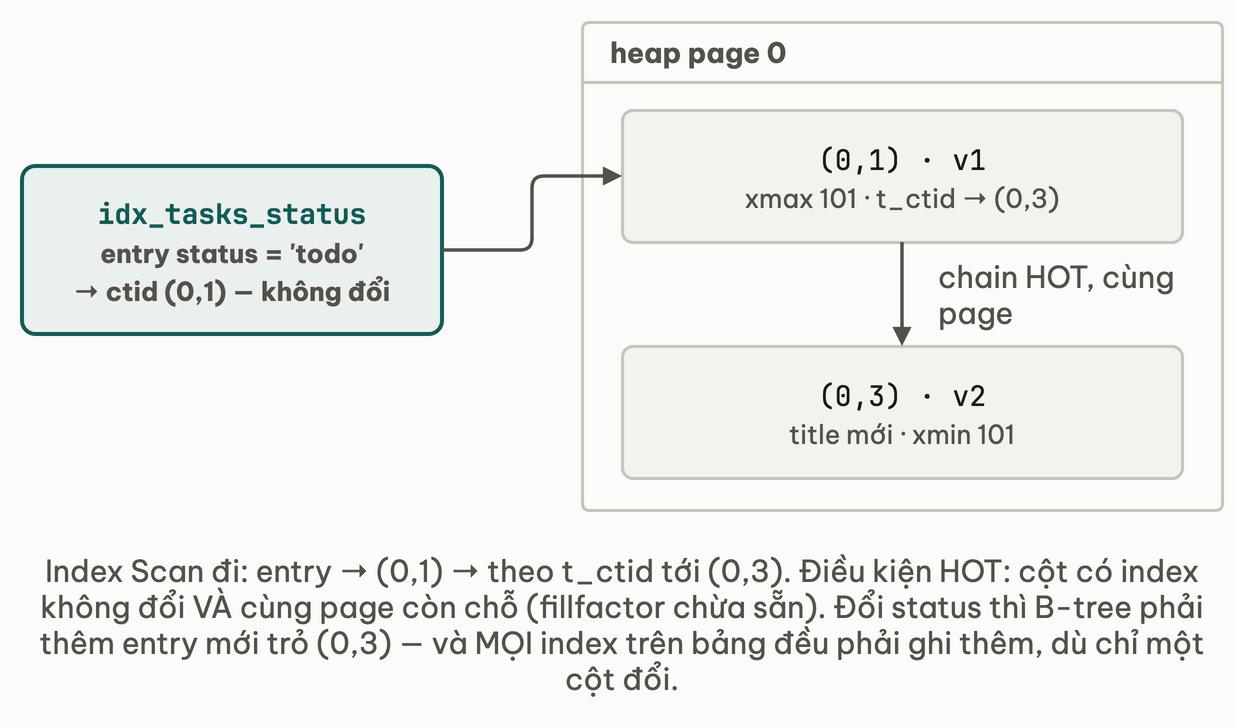
Với bảng nhiều index, HOT là khoản tiết kiệm lớn nhất của một UPDATE; fillfactor (tỷ lệ page được lấp khi INSERT, phần còn lại chừa cho UPDATE sau, xem bài B-tree) đặt dưới 100 là để chừa chỗ cho nó.
Thử ngẫmnếu UPDATE đổi đúng cột status đang có index thì HOT còn áp dụng được không, và chain t_ctid trên page lúc đó đi về đâu?
4. Snapshot quyết định phiên bản nào visible như thế nào?
Ở statement đầu tiên của transaction (BEGIN tự nó chưa chụp gì), hoặc ở mỗi statement nếu là READ COMMITTED, PostgreSQL chụp một snapshot:
Snapshot = (snap_xmin, snap_xmax, xip_list)

- snap_xmin: txid nho nhat con dang chay luc chup.
             Moi txid < snap_xmin chac chan da ket thuc.
- snap_xmax: txid ke tiep se duoc cap. Moi txid >= snap_xmax
             la "tuong lai" -- chua ton tai theo snapshot nay.
- xip_list:  cac txid dang chay luc chup (nam giua snap_xmin va snap_xmax).
Gọi một txid T là thuộc quá khứ của snapshot S khi T đã commit và (T < snap_xmin, hoặc snap_xmin ≤ T < snap_xmax mà T không nằm trong xip_list). T ≥ snap_xmax hoặc T trong xip_list thì không thuộc quá khứ, dù lúc kiểm tra nó đã commit xong.
Một tuple (xmin, xmax) visible với S khi và chỉ khi:
xminthuộc quá khứ củaS(tuple đã được tạo xong trước khiSchụp), vàxmax = 0, hoặcxmaxkhông thuộc quá khứ củaS(transaction xoá nó đang chạy, ở tương lai, hoặc đã abort).
Ví dụ: snap_xmin = 99, xip_list = [100], snap_xmax = 105. Tuple (xmin=100, xmax=0) có xmin nằm trong xip_list nên điều kiện 1 hỏng: invisible. Đúng, đó là row của UPDATE chưa commit. Tuple (xmin=106, xmax=0) cũng invisible dù 106 có thể đã commit lúc bạn kiểm tra, vì nó ở tương lai của snapshot.
Thử ngẫmtxid nằm giữa snap_xmin và snap_xmax nhưng không có trong xip_list thì đã commit hay đã abort? Snapshot cần thêm gì để phân biệt hai trường hợp đó?
5. Timeline T1/T2 — REPEATABLE READ giữ snapshot, READ COMMITTED chụp lại
T1 (txid 100) update row id 1; T2 (txid 101, REPEATABLE READ) đọc hai lần, trước và sau khi T1 commit. Áp luật trên vào hai phiên bản tuple:
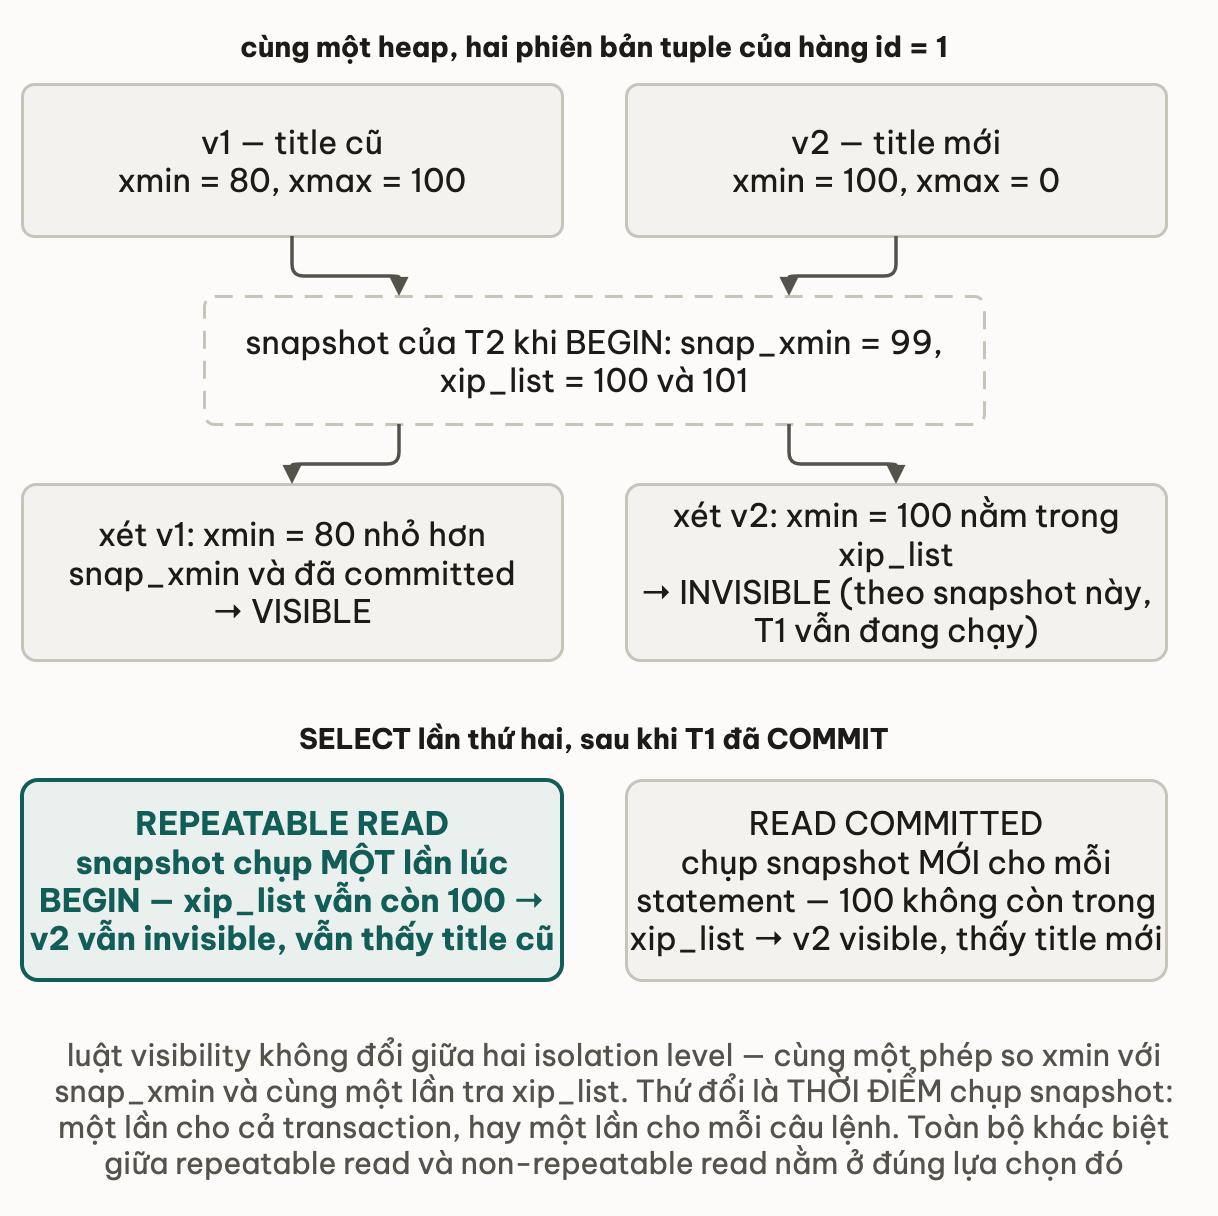
Ở REPEATABLE READ, snapshot chụp một lần ở statement đầu tiên sau BEGIN và giữ nguyên tới hết transaction; T1 có commit giữa chừng thì với T2 txid 100 vẫn "đang chạy", nên lần đọc thứ hai vẫn ra title cũ. Ở READ COMMITTED (mặc định), mỗi statement chụp snapshot mới, nên lần đọc thứ hai không còn 100 trong xip_list và thấy title mới. Đó là non-repeatable read, hợp lệ ở RC và bị cấm ở RR. Anomaly nào được phép ở mức nào, xem Isolation level và 4 anomaly ở khoá SQL & Database; một case RC làm báo cáo lệch số ngoài đời ở blog Read Committed và bài báo cáo lệch.
6. Hint bits và CLOG — vì sao SELECT thứ hai nhanh hơn lần đầu?
Mỗi lần kiểm tra visibility, PostgreSQL cần biết xmin/xmax đã commit chưa. Câu trả lời nằm trong CLOG (thư mục pg_xact/, tên cũ pg_clog): 2 bit cho mỗi txid, encode bốn trạng thái in-progress / committed / aborted / sub-committed, mỗi segment 256 KB chứa ~1 triệu txid. Tra CLOG cho từng tuple thì đắt, nên sau lần tra đầu PG ghi kết quả ngay lên header tuple bằng hint bits (HEAP_XMIN_COMMITTED, HEAP_XMIN_INVALID, HEAP_XMAX_COMMITTED, HEAP_XMAX_INVALID). Ghi này best-effort, không qua WAL. Lần sau chỉ đọc flag, không tra CLOG nữa.
Bạn vừa INSERT 1 triệu row rồi chạy SELECT count(*) FROM tasks hai lần liên tiếp, không có gì khác chạy song song. Bạn đoán hai lần chênh nhau bao nhiêu, và lần nào nhanh hơn?
INSERT INTO tasks (project_id, title, status)
SELECT 1, 'Task ' || g, 'todo' FROM generate_series(1, 1000000) g;

\timing on
SELECT count(*) FROM tasks;   -- Time: 320 ms  (tra CLOG + set hint bit cho ~1M tuple)
SELECT count(*) FROM tasks;   -- Time:  95 ms  (chi doc hint bit)
7. Pitfall — txid wraparound và long transaction
Pitfall 1 — txid wraparound. xid là số 32-bit, quay vòng sau ~4 tỷ và chỉ nửa vòng (~2 tỷ) được coi là "quá khứ". Nếu tuple cũ không được freeze (gắn cờ "cũ hơn mọi snapshot"), sau khi counter quay vòng chúng sẽ thành "tương lai" và biến mất khỏi mọi snapshot. Autovacuum tự chạy anti-wraparound VACUUM cho bất kỳ bảng nào có age vượt autovacuum_freeze_max_age (mặc định 200 triệu), kể cả khi autovacuum bị tắt. Nếu nó vẫn không freeze được (long transaction, replication slot bỏ hoang, prepared transaction treo), PG bắt đầu WARNING khi còn cách giới hạn 40 triệu xid và từ chối cấp XID mới khi còn dưới 3 triệu; lúc đó bạn phải VACUUM tay database đó.
SELECT datname, age(datfrozenxid) AS xid_age
FROM pg_database ORDER BY xid_age DESC;
-- xid_age    | datname
-- 1800000000 | taskflow   <-- da vuot 200M tu lau: freeze dang bi chan boi thu gi do
Pitfall 2 — long transaction chặn VACUUM. Transaction chạy lâu giữ snapshot có xmin thấp; VACUUM không được dọn dead tuple có xmax lớn hơn xmin đó, dù chúng bị thay từ lâu. Query phát hiện qua age(backend_xmin) trong pg_stat_activity và cách chặn bằng idle_in_transaction_session_timeout nằm ở bài 05.
Thử ngẫmmột dashboard TaskFlow mở transaction REPEATABLE READ rồi treo 20 phút để user đọc chậm. Trong lúc đó VACUUM ở một bảng khác có bị ảnh hưởng gì không?
8. Applied — dashboard TaskFlow cần hai con số cùng một thời điểm
Dashboard hiển thị tổng task và số task đã done để tính phần trăm tiến độ. Hai query chạy rời ở READ COMMITTED thì giữa hai lần chụp snapshot, một user khác có thể commit thêm task mới và đổi một task sang done: mẫu số 100 thuộc thời điểm cũ, tử số 51 thuộc thời điểm mới, tỉ lệ sai. Bọc cả hai trong một transaction REPEATABLE READ là cả hai dùng chung một snapshot:
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT count(*) AS total_tasks FROM tasks WHERE project_id = 42;
SELECT count(*) AS done_tasks  FROM tasks WHERE project_id = 42 AND status = 'done';
COMMIT;
-- Cung snapshot -> hai con so thuoc cung mot thoi diem logic
Không có lock nào trên tasks; writer vẫn ghi bình thường, chỉ là phiên bản họ tạo nằm ngoài snapshot của dashboard.
9. Liên hệ các bài khác
- VACUUM và dead tuple: mặt trái của mọi thứ bài này vừa nói: ai dọn tuple cũ, dọn lúc nào, và vì sao long transaction làm bảng phình.
- Locks và deadlock: MVCC lo read-write, nhưng hai
UPDATEcùng row vẫn phải xếp hàng; bài đó nói cơ chế xếp hàng ấy. - B-tree internals: index trỏ tới
ctid, nên hiểu HOT update cần hình dung entry index trỏ vào đâu. - Isolation level và 4 anomaly: snapshot là cơ chế, isolation level là hợp đồng; đọc để biết RR/Serializable hứa gì thêm.
- Anomaly và serializability trong hệ phân tán: khi snapshot phải nhất quán qua nhiều node, bài toán khó hơn nhiều.
- PostgreSQL 14 Internals — Egor Rogov (free PDF): Part I "Isolation and MVCC" là nguồn chi tiết nhất về tuple visibility, snapshot, hint bits và CLOG; phần lớn bài này rút từ đó.
- The Internals of PostgreSQL — Hironobu Suzuki, Ch.5 Concurrency Control: diagram heap page nhiều phiên bản tuple và visibility rule từng bước.
- PostgreSQL Documentation — Concurrency Control: tài liệu chính thức về MVCC model và hành vi từng isolation level.
- PostgreSQL Documentation — Routine Vacuuming: cơ chế freeze,
autovacuum_freeze_max_age,vacuum_freeze_min_age,vacuum_freeze_table_agevà cách tránh wraparound.
10. Tóm tắt
- Muốn biết row đang bị ai sửa:
SELECT xmin, xmax, ctid, * FROM t WHERE …;xmaxkhác 0 mà row vẫn thấy được nghĩa là transaction đó chưa commit. - Bảng nhiều index mà UPDATE chậm: kiểm cột đổi có nằm trong index không và
fillfactorcó chừa chỗ cho HOT không (pg_stat_user_tables.n_tup_hot_upd). - Hai số liệu cần cùng thời điểm: một transaction
REPEATABLE READ, không cần lock. - Query đầu tiên sau bulk load chậm gấp 3: chi phí hint bits, không phải index hỏng.
- Ba con số cần alert:
age(datfrozenxid)tiến gần 200 triệu,age(backend_xmin)hàng trăm nghìn, và "3 triệu xid còn lại" là lúc database ngừng nhận ghi.
11. Tự kiểm tra
- Q1Khi bạn chạy
UPDATE tasks SET title = 'X' WHERE id = 1, PostgreSQL làm gì với dữ liệu vật lý trên heap page? Vì sao cả hai phiên bản phải cùng tồn tại một thời gian? - Q2Snapshot có
snap_xmin = 99,xip_list = [100, 102],snap_xmax = 105. Tuple nào visible: (A) xmin=95 xmax=0, (B) xmin=100 xmax=0, (C) xmin=98 xmax=100, (D) xmin=103 xmax=0, (E) xmin=106 xmax=0? - Q3Vì sao
SELECT count(*) FROM taskslần đầu sau bulk INSERT 1 triệu row chậm hơn lần thứ hai đáng kể? - Q4T1 update và commit trong khi T2 đang chạy. Kết quả T2 khác nhau thế nào giữa READ COMMITTED và REPEATABLE READ, và ví dụ nào cho thấy khác biệt đó ảnh hưởng kết quả?
- Q5Vì sao một transaction chạy lâu gây heap bloat dù số row thật không tăng? Cơ chế nào ngăn VACUUM?
- Q6MySQL InnoDB cũng có MVCC nhưng sửa row tại chỗ và ghi bản cũ vào undo log. Trade-off so với cách PostgreSQL giữ mọi phiên bản trên heap là gì?
Bài tiếp theo: VACUUM và dead tuple — bảng phình to dù count(*) không tăng
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
WAL trong PostgreSQL — vì sao COMMIT chỉ cần ghi log
Bài tiếpVACUUM và dead tuple: bảng phình to dù count(*) không tăng
Ôn phỏng vấn
Bài này trả lời được các câu phỏng vấn sau — tự trả lời thử trước khi mở đáp án.
Thảo luận & góp ý
Hỏi đáp về bài này