Scan strategies — vì sao có index vẫn Seq Scan
PostgreSQL có 4 cách đọc bảng: Seq Scan, Index Scan, Index Only Scan, Bitmap Heap Scan. Planner chọn theo selectivity, random_page_cost và visibility map.
TL;DR: PostgreSQL có bốn cách đọc một bảng: Seq Scan quét tuần tự toàn bộ heap, Index Scan tra B-tree rồi nhảy ngẫu nhiên vào heap từng row, Index Only Scan lấy dữ liệu ngay từ index nếu index chứa đủ cột và visibility map còn tươi, Bitmap Heap Scan gom vị trí row từ một hoặc nhiều index rồi đọc heap theo thứ tự page. Planner chọn bằng cost: một page đọc ngẫu nhiên đắt gấp random_page_cost (mặc định 4) lần page tuần tự, nên query trả về hơn 5–15% bảng thì Seq Scan rẻ hơn dù index có sẵn. Có index mà planner không dùng thường là planner đúng, không phải index hỏng.
Thêm index không phải lúc nào cũng giúp. Bài này mở bằng một plan phản trực giác mà gần như ai làm PostgreSQL cũng gặp: index vừa tạo xong, EXPLAIN vẫn in Seq Scan. Hiểu vì sao planner làm vậy là bước đầu tiên để optimize đúng chỗ, thay vì thêm index vô tội vạ.
1. Analogy — tìm sách trong thư viện 1 triệu cuốn
Thư viện có 1 triệu cuốn trên 10.000 kệ. Thủ thư có bốn cách tìm sách tuỳ bạn cần gì:
| Chiến lược thủ thư | Scan strategy | Dùng khi |
|---|---|---|
| Đi từ kệ đầu đến kệ cuối, xem từng cuốn | Seq Scan | Cần nhiều cuốn (trên 10% tổng), hoặc thư viện nhỏ |
| Tra mục lục rồi nhảy đến từng kệ lấy cuốn | Index Scan | Cần rất ít cuốn (dưới 1%), mục lục đủ chính xác |
| Tra mục lục, thấy mục lục đã có đủ thông tin cần | Index Only Scan | Mục lục chứa cả nội dung cần, không phải lấy sách |
| Tra nhiều mục lục, ghi số kệ, đi một vòng theo thứ tự kệ | Bitmap Heap Scan | Ghép hai tiêu chí từ hai mục lục, giảm số lần đi lại |
Thêm index = tạo mục lục mới. Nhưng nếu cần lấy 700.000 cuốn trong 1 triệu, tra mục lục rồi chạy qua chạy lại 700.000 lần còn chậm hơn đi một vòng tuần tự. Planner tính cost cả hai và chọn cái rẻ hơn.
2. Vì sao có 4 strategy — tradeoff sequential vs random I/O
Planner không chọn tuỳ tiện, nó tính cost trên một tradeoff I/O cơ bản: đọc các page liền nhau (sequential) thì prefetch được, HDD đạt ~100 MB/s; đọc page rải rác (random) thì HDD mất ~10 ms mỗi seek, SSD ~0,1 ms. Vì sao hai kiểu đọc chênh nhau nhiều bậc như vậy ở tầng thiết bị: tuần tự vs ngẫu nhiên. PostgreSQL mã hoá tradeoff này bằng một tham số:
SHOW random_page_cost;
-- 4 (default): 1 random page read = cost cua 4 sequential page read
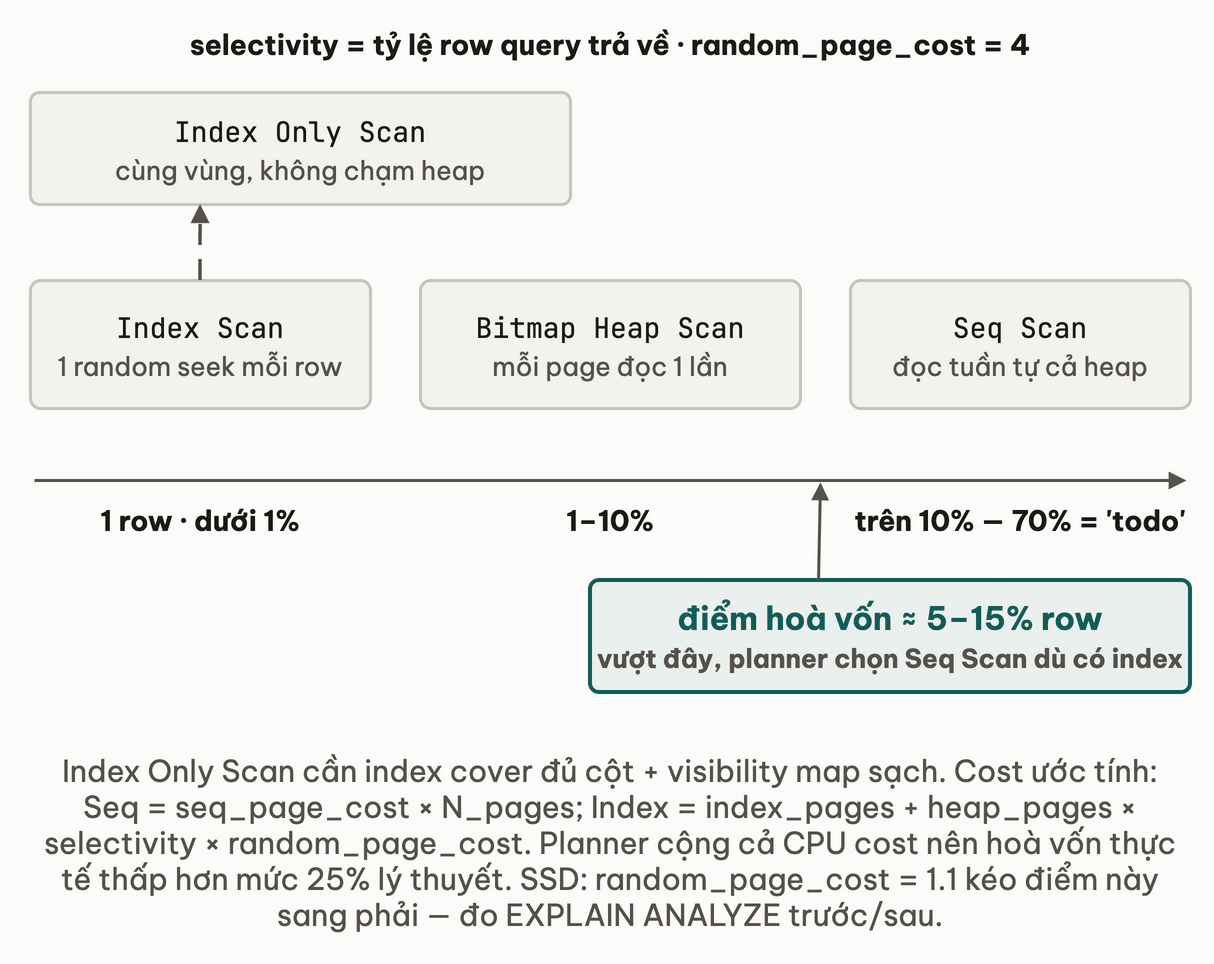
Index Scan là nhiều lần truy cập heap ngẫu nhiên (một seek cho mỗi row khớp); Seq Scan là đọc tuần tự toàn bộ heap. Khi query trả về hơn 5–10% row, tổng random seek của Index Scan vượt cost của Seq Scan và planner chọn Seq Scan.
Cost model (đơn giản hoá):
  Seq Scan cost   = seq_page_cost × N_pages
  Index Scan cost = index_pages + heap_pages × selectivity × random_page_cost
Breakeven: khi heap_pages × selectivity × 4 vượt N_pages, tức selectivity vượt 25%, Seq Scan rẻ hơn. Thực tế planner còn tính CPU cost nên điểm hoà vốn thường rơi vào 5–15%. Trên SSD có thể hạ random_page_cost xuống 1.1 để planner ưu tiên index hơn, nhưng luôn đo EXPLAIN ANALYZE trước và sau.
3. Vì sao có index trên status mà planner vẫn Seq Scan?
Bảng tasks 1 triệu row đã có CREATE INDEX idx_tasks_status ON tasks(status).
Planner sẽ chọn Index Scan hay Seq Scan cho WHERE status = 'todo'? Viết đáp án và lý do của bạn trước khi xem plan.
EXPLAIN ANALYZE SELECT * FROM tasks WHERE status = 'todo';
Seq Scan on tasks  (cost=0.00..18334.00 rows=700000 width=64)
                   (actual time=0.020..125.500 rows=700000 loops=1)
  Filter: (status = 'todo'::text)
  Rows Removed by Filter: 300000
Planning Time: 0.8 ms
Execution Time: 128.3 ms
status = 'todo' chiếm 70% row, nên Seq Scan thắng dù index có sẵn: đọc tuần tự toàn bộ heap rẻ hơn 700.000 lần nhảy ngẫu nhiên. Seq Scan cũng là lựa chọn đúng khi bảng chỉ vài trăm row (overhead tra index không đáng), hoặc không có index nào khớp WHERE.
Khi thấy Seq Scan trên bảng lớn, câu hỏi đúng không phải "thêm index ngay" mà là: selectivity của query này là bao nhiêu? Trường hợp có index, selectivity thấp mà vẫn Seq Scan (correlation của cột với thứ tự vật lý) được phân tích ở blog Postgres có index vẫn Seq Scan.
4. Index Scan — selective lookup với random heap access
Index Scan dùng khi query rất selective. Planner đi từ root xuống leaf của B-tree để tìm key, đọc CTID (page_number, offset) từ leaf, random seek vào đúng heap page, rồi kiểm tra visibility của tuple theo snapshot hiện tại (xmin/xmax, cơ chế ở bài MVCC internals) trước khi trả row.
EXPLAIN ANALYZE SELECT * FROM tasks WHERE id = 42;
Index Scan using tasks_pkey on tasks  (cost=0.42..8.44 rows=1 width=64)
                                      (actual time=0.025..0.027 rows=1 loops=1)
  Index Cond: (id = 42)
Execution Time: 0.1 ms
Mỗi row khớp là một random heap access: 1 row thì một seek, cực nhanh; 50.000 row thì 50.000 seek, chậm hơn Seq Scan. Index Scan tốt khi selectivity dưới 1–5%: point lookup (WHERE id = 42, WHERE email = …) hoặc range hẹp.
Thử ngẫmquery WHERE id = 42 dùng Index Scan cực nhanh. Nếu đổi thành WHERE id IN (danh sách 50.000 id), Index Scan có còn thắng Seq Scan không?
5. Index Only Scan — covering index, tránh heap hoàn toàn
Index Only Scan là chiến lược nhanh nhất khi khả thi: không chạm heap page. Hai điều kiện: index phải chứa mọi cột query cần (covering index) và visibility map (VM) của heap phải còn tươi.
-- Query chi can id va status -> INCLUDE status vao index
CREATE INDEX idx_tasks_assignee_cover ON tasks(assignee_id) INCLUDE (status);

EXPLAIN (ANALYZE, BUFFERS) SELECT id, status FROM tasks WHERE assignee_id = 5;
Index Only Scan using idx_tasks_assignee_cover on tasks
  (cost=0.42..6.44 rows=2 width=12)
  (actual time=0.020..0.025 rows=2 loops=1)
  Heap Fetches: 0
  Buffers: shared hit=4
Execution Time: 0.1 ms
Heap Fetches: 0 là dấu hiệu thành công. Cột INCLUDE không tham gia thứ tự B-tree, chỉ nằm ở leaf để cover SELECT; chọn INCLUDE hay đưa vào composite key: bài composite index.
Vì sao cần VM. Index không biết tuple còn sống hay đã bị UPDATE/DELETE. VM là bitmap 2 bit mỗi heap page: all-visible (mọi tuple trên page committed và visible với mọi snapshot) và all-frozen. Index Only Scan hỏi VM trước khi trả row: page all-visible thì tin index, bỏ qua heap; page chưa all-visible thì phải mở heap page để kiểm tra, và Heap Fetches tăng.
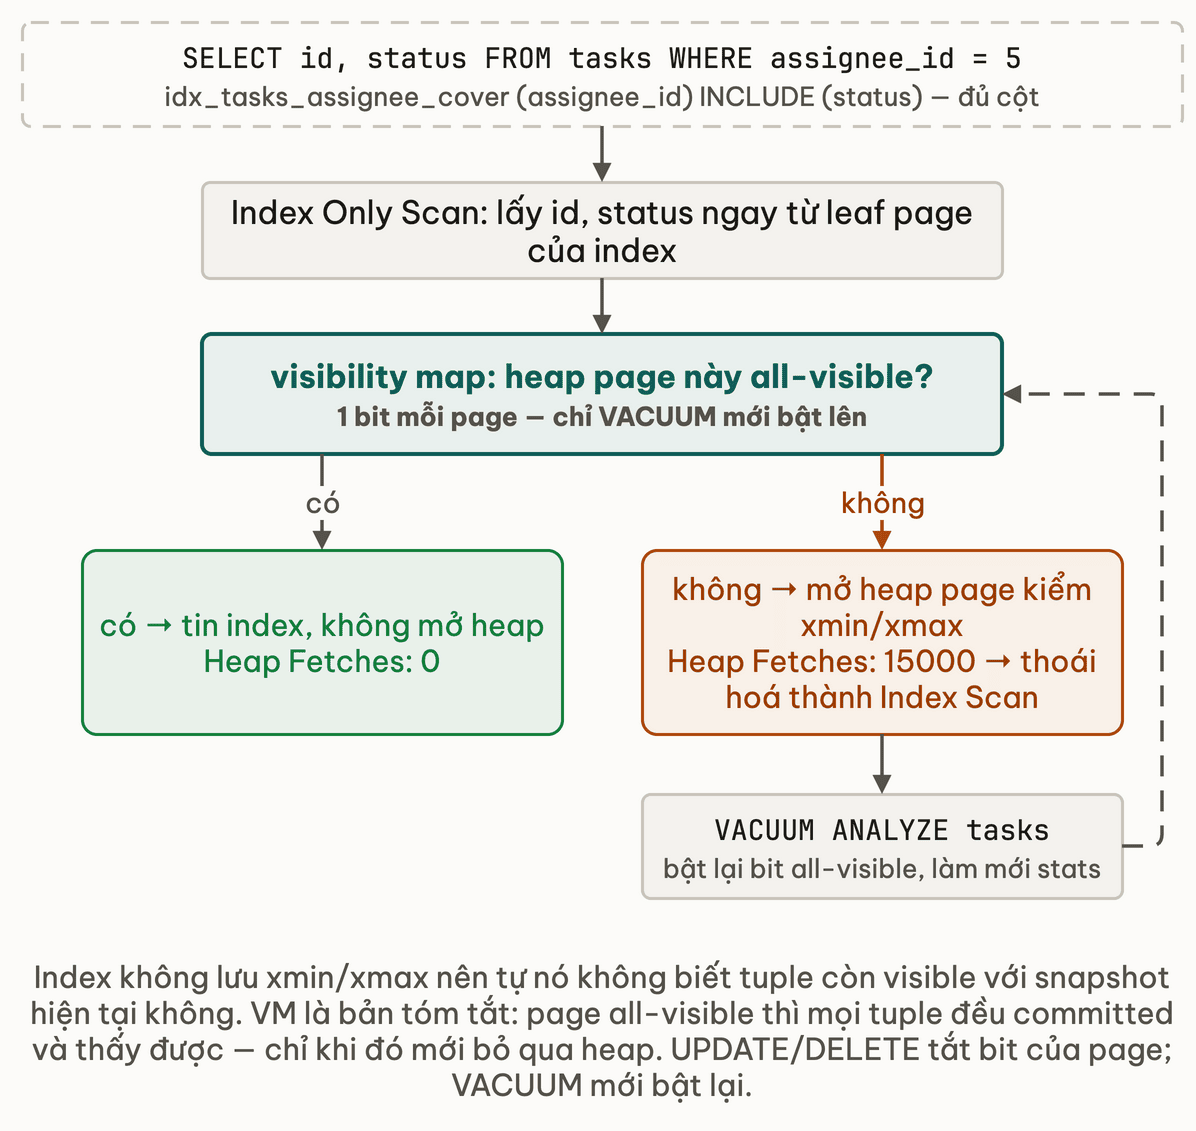
VACUUM là thứ bật bit all-visible (cơ chế ở bài VACUUM & dead tuple). Thấy Heap Fetches lớn hơn 0 sau nhiều UPDATE: chạy VACUUM ANALYZE tasks; rồi EXPLAIN lại.
Thử ngẫmsáng nay idx_tasks_dashboard_cover đạt Heap Fetches: 0 sau VACUUM ANALYZE, rồi 3000 task đổi status liên tục trong một giờ. Heap Fetches có còn 0 không?
6. Bitmap Heap Scan — gom rồi đọc heap một lần
Bitmap Heap Scan giải bài toán ở giữa: hai điều kiện trên hai cột, mỗi cột có index riêng, selectivity mỗi điều kiện trung bình (1–10%). Index Scan riêng lẻ thì quá nhiều random seek, Seq Scan thì lãng phí.
CREATE INDEX idx_tasks_status ON tasks(status);
CREATE INDEX idx_tasks_due ON tasks(due_at);

EXPLAIN ANALYZE
SELECT * FROM tasks
WHERE status = 'doing' OR due_at < now() - interval '7 days';
Bitmap Heap Scan on tasks  (cost=125.45..2500.50 rows=15000 width=64)
                           (actual time=12.500..45.000 rows=15234 loops=1)
  Recheck Cond: (status = 'doing' OR due_at < now() - '7 days'::interval)
  Heap Blocks: exact=850
  ->  BitmapOr  (cost=125.00..125.00 rows=15000 width=0)
        ->  Bitmap Index Scan on idx_tasks_status
              Index Cond: (status = 'doing')
        ->  Bitmap Index Scan on idx_tasks_due
              Index Cond: (due_at < now() - '7 days'::interval)
Execution Time: 47.3 ms
Mỗi Bitmap Index Scan quét một index và ghi vị trí row khớp vào một bitmap; BitmapOr hợp hai bitmap (OR) hoặc BitmapAnd giao (AND); bitmap được sắp theo số page vật lý; rồi Bitmap Heap Scan duyệt heap một lượt theo thứ tự page, mỗi page đọc đúng một lần dù có nhiều row khớp trên đó. Với 15.000 row khớp nằm trên 850 page: Index Scan thuần trả 15.000 random access, Bitmap Heap Scan trả 850 lần đọc gần tuần tự.
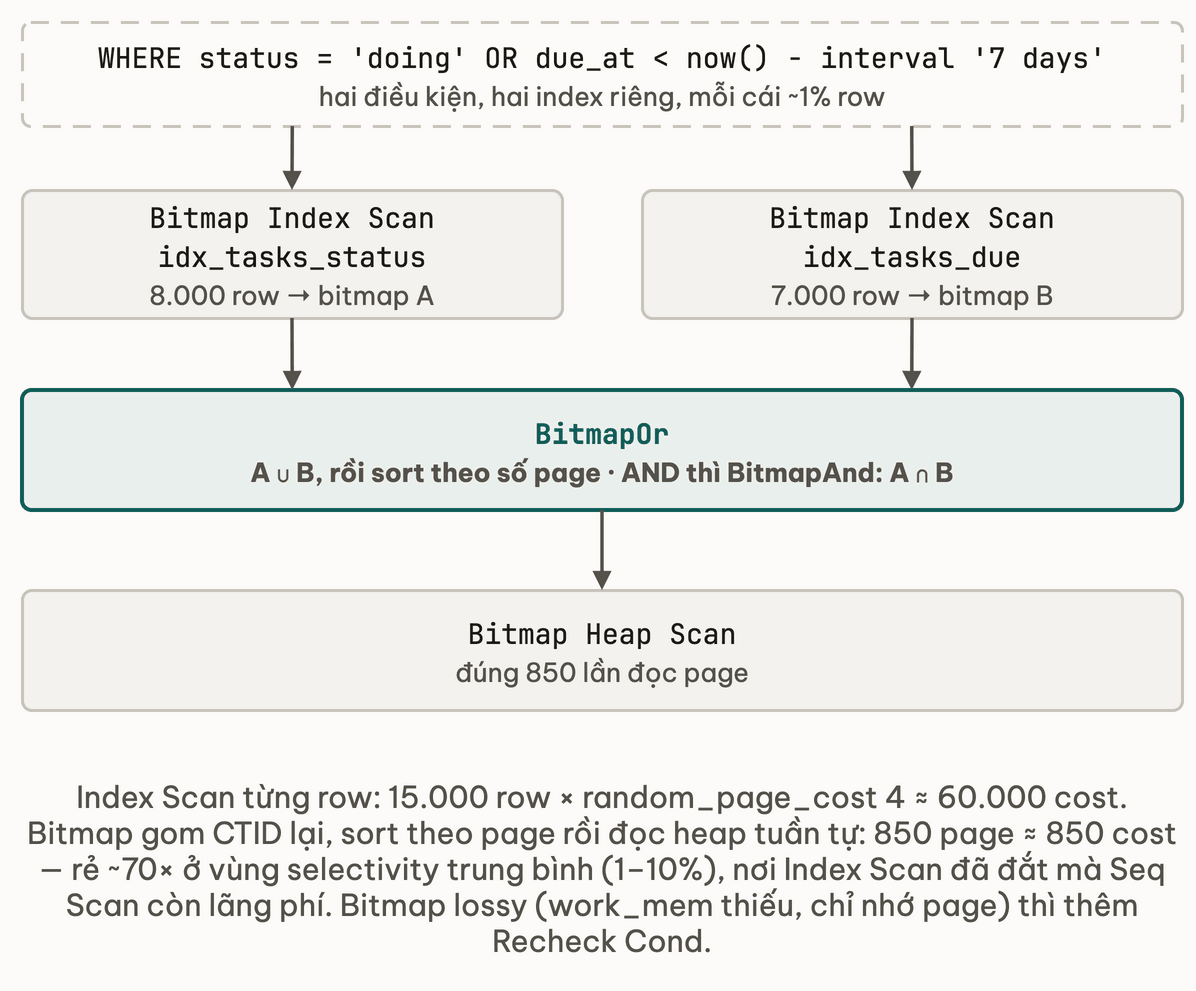
Recheck Cond có mặt vì bitmap có thể rơi vào lossy mode: khi bitmap row-level vượt work_mem, PostgreSQL chuyển sang lưu một bit mỗi page (Heap Blocks: lossy=…), và khi đọc page phải kiểm tra lại điều kiện trên từng row để loại false positive.
Thử ngẫmhai Bitmap Index Scan build xong, work_mem không đủ chứa bitmap row-level nên rơi vào lossy mode. Recheck Cond khi đó đang bù đắp cho thiếu sót gì?
7. Pitfall — index không được dùng, statistics cũ
Thêm index nhưng planner vẫn Seq Scan. Hướng sửa là partial index cho subset thật sự cần (bài specialized index):
-- Partial index chi chua row chua hoan thanh (30% data)
CREATE INDEX idx_tasks_active ON tasks(status) WHERE status IN ('todo', 'doing');
Statistics cũ sau bulk insert. Bulk insert 1 triệu row mà statistics vẫn của bảng 100.000 row, planner ước tính rows=2 trong khi thực tế 2.000, chọn sai strategy. Autovacuum sẽ ANALYZE nhưng có độ trễ; chạy ANALYZE tasks; ngay sau bulk load.
8. Applied — TaskFlow dashboard với covering index
Dashboard TaskFlow liệt kê task theo assignee, chạy hàng nghìn lần mỗi phút. Mục tiêu: Index Only Scan với Heap Fetches: 0.
-- Dashboard query, plan ban dau khong co index phu hop:
SELECT id, status, due_at FROM tasks WHERE assignee_id = 5;
--  Seq Scan on tasks  (cost=0.00..18334.00 rows=200 width=28)
--                     (actual time=0.020..95.000 rows=200 loops=1)
--    Rows Removed by Filter: 999800
--  Execution Time: 97.4 ms

-- Covering index: assignee_id la search key, INCLUDE cac cot SELECT
CREATE INDEX idx_tasks_dashboard_cover
ON tasks(assignee_id) INCLUDE (status, due_at);

VACUUM ANALYZE tasks;   -- cap nhat VM + stats

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, status, due_at FROM tasks WHERE assignee_id = 5;
--  Index Only Scan using idx_tasks_dashboard_cover on tasks
--    (cost=0.42..6.85 rows=200 width=28)
--    (actual time=0.018..0.380 rows=200 loops=1)
--    Heap Fetches: 0
--    Buffers: shared hit=6
--  Execution Time: 0.4 ms
97 ms xuống 0,4 ms (~240 lần): mọi dữ liệu lấy từ 6 index page, không chạm heap. Bước VACUUM ANALYZE không phải thừa: thiếu nó, VM chưa đánh dấu all-visible và plan vẫn là Index Only Scan nhưng Heap Fetches bằng số row.
9. Deep Dive
- Use The Index, Luke — "Slow Indexes" — Markus Winand, trực giác vì sao index lookup có thể chậm hơn full scan. Đọc trước.
- PostgreSQL 14 Internals — Egor Rogov, Part IV — Query Execution (chương về scan node và visibility map) — free PDF, implementation của scan node, bitmap và tương tác VM với Index Only Scan.
- PostgreSQL Documentation — "Statistics Used by the Planner" —
pg_stats, MCV, histogram: cơ sở để planner ước tính rows và chọn strategy.
10. Liên hệ các bài khác
- Tại sao cần index (khoá SQL & Database) — nguyên lý index vs full scan; bài này là phiên bản PostgreSQL với cost model thật.
- Composite index & INCLUDE — khi nào cột nên vào key, khi nào chỉ INCLUDE để Index Only Scan.
- VACUUM & dead tuple — ai cập nhật visibility map; đọc để hiểu vì sao Heap Fetches tăng sau nhiều UPDATE.
- Statistics & cost model — selectivity mà planner dùng để chọn scan đến từ đâu, và vì sao nó có thể sai.
- Page cache & buffered I/O — vì sao
shared readđắt hơnshared hitnhiều bậc.
11. Tóm tắt
- Checklist khi thấy Seq Scan trên bảng lớn: selectivity bao nhiêu → có index khớp không → statistics có cũ không (
n_mod_since_analyze) → rồi mới nghĩ đến index. - Hoà vốn lý thuyết là 25% (khi
4 × selectivityvượt 1), thực tế rơi vào 5–15% vì còn CPU cost; đo bằngEXPLAIN ANALYZEthay vì tin con số. Heap Blocks: lossytrong Bitmap Heap Scan: bitmap trànwork_mem, tăngwork_memcho session hoặc thu hẹp điều kiện.
12. Tự kiểm tra
- Q1Tại sao query
WHERE status = 'todo'trả về 70% row vẫn dùng Seq Scan dù có index trênstatus? Giải thích theo cost model và random_page_cost. - Q2Index Only Scan trả về
Heap Fetches: 15000thay vì 0. Nguyên nhân là gì? Các bước debug và fix cụ thể? - Q3Bitmap Heap Scan có bước 'Recheck Cond'. Khi nào Recheck cần thiết? Lossy mode là gì và tại sao xảy ra?
- Q4random_page_cost mặc định là 4.0 nhưng server dùng NVMe SSD. Nên set bao nhiêu? Thay đổi này ảnh hưởng đến plan như thế nào?
- Q5Bulk insert 5 triệu row vào table
taskslúc 3 giờ sáng xong. Dashboard queryWHERE assignee_id = ?sáng hôm sau chạy chậm hơn bình thường. Diagnose và fix.
Bài tiếp theo: Join algorithms — Nested Loop, Hash Join, Merge Join
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
EXPLAIN & EXPLAIN ANALYZE — đọc query plan của PostgreSQL
Bài tiếpJoin algorithms — Nested Loop, Hash Join, Merge Join
Ôn phỏng vấn
Bài này trả lời được các câu phỏng vấn sau — tự trả lời thử trước khi mở đáp án.
Thảo luận & góp ý
Hỏi đáp về bài này