5 anti-pattern khiến planner chọn plan tệ
Hàm bọc cột, literal sai kiểu, OR, wildcard đầu và generic plan của prepared statement: năm cách viết query làm index có sẵn thành vô dụng, kèm EXPLAIN trước/sau khi sửa.
TL;DR: Index đúng đã có mà EXPLAIN vẫn in Seq Scan với Filter thay vì Index Cond thì gần như chắc query đang mắc một trong năm anti-pattern: bọc cột trong hàm (LOWER(email)), literal sai kiểu khiến PostgreSQL cast chính cột (bigint_col = 5.0), điều kiện OR mà composite index không phủ, LIKE '%…' với wildcard ở đầu, và prepared statement bị cache generic plan sau năm lần chạy. Bốn pattern đầu làm planner không match được index; pattern thứ năm vẫn match nhưng plan bị chọn theo selectivity trung bình. Mỗi pattern có một cách sửa riêng, và không cách nào là "thêm index nữa".
Query chạy chậm, bạn EXPLAIN ANALYZE và thấy Seq Scan dù index đã có. Index tồn tại nhưng planner vẫn không dùng, hoặc dùng sai cách. Có năm cách viết query khiến index nằm đó mà không ai dùng, và bốn lỗi đầu đều để lại dấu trong EXPLAIN: một dòng Filter đứng chỗ lẽ ra là Index Cond, còn lỗi thứ năm lộ ra qua $1 trong điều kiện. Bài đi qua từng pattern theo cùng một nhịp: nhận diện, EXPLAIN trước, fix, EXPLAIN sau.
1. Analogy — năm lỗi bài thi ai cũng mắc
Giáo viên chấm hàng nghìn bài thi mỗi năm và nhận ra năm lỗi lặp đi lặp lại, cộng lại chiếm phần lớn điểm mất. Học sinh giỏi không nhất thiết biết nhiều hơn, họ chỉ biết năm lỗi đó và tránh được.
| Lỗi bài thi | Anti-pattern query |
|---|---|
| Nhớ sai dạng công thức | Bọc cột trong hàm |
| Đổi đơn vị sai chiều | Literal sai kiểu, cột bị cast |
| Trả lời "hoặc A hoặc B", giám khảo cho nửa điểm | OR predicate |
| Điền form từ cuối lên đầu | Wildcard ở đầu LIKE |
| Học thuộc bài mẫu, đề thi đổi số | Generic plan của prepared statement |
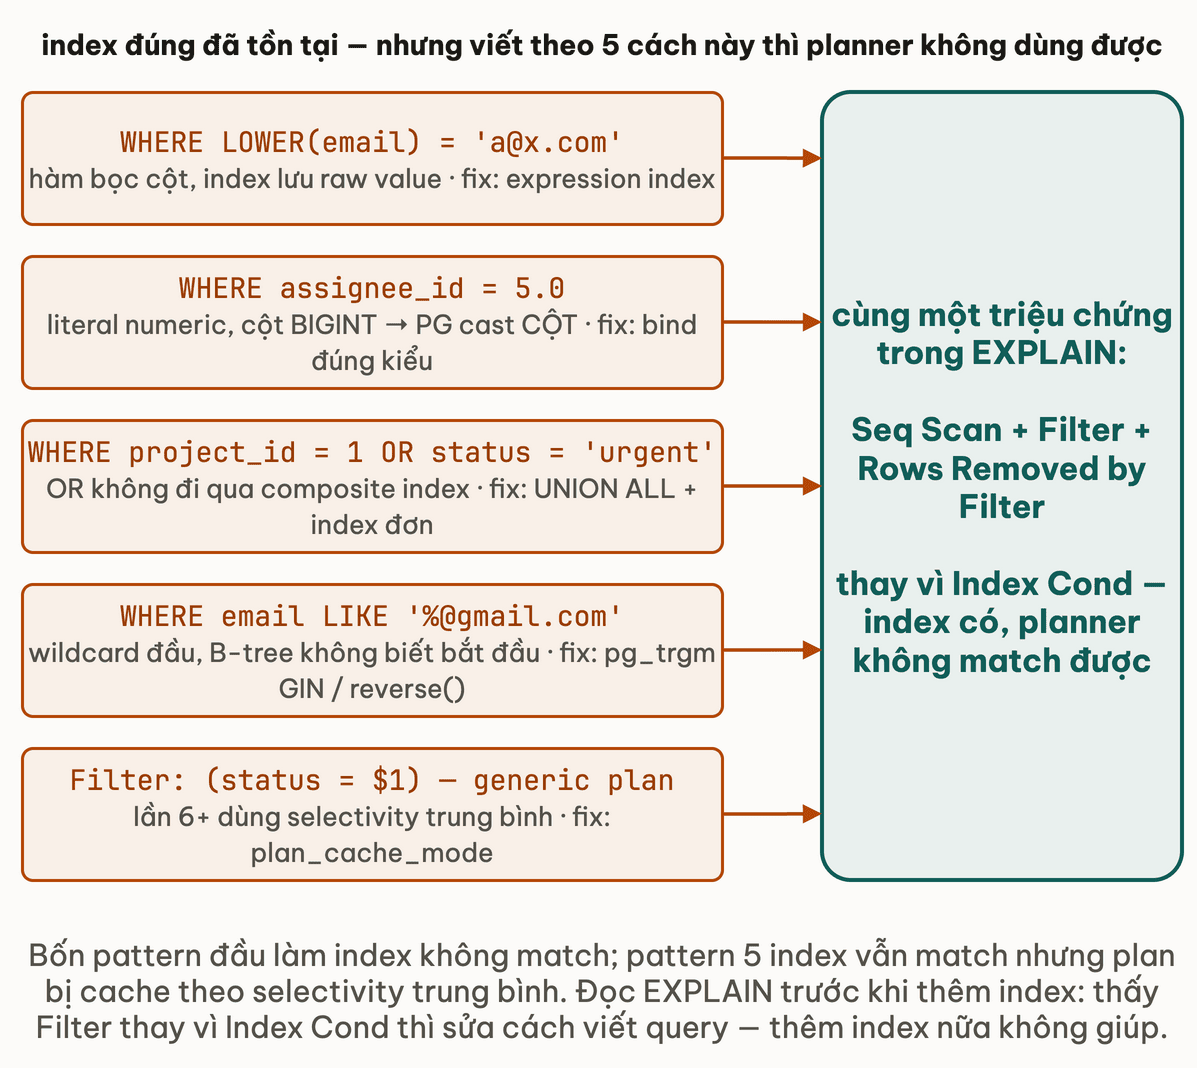
2. Pattern 1 — bọc cột trong hàm
Index lưu raw value của cột. Query so sánh kết quả hàm trên cột thì planner không có cách nào dùng index đó ngoài quét hết:
CREATE INDEX idx_users_email ON users(email);

EXPLAIN ANALYZE SELECT * FROM users WHERE LOWER(email) = '[email protected]';
--  Seq Scan on users  (cost=0.00..2500.00 rows=50 width=100)
--                     (actual time=0.025..18.340 rows=1 loops=1)
--    Filter: (lower(email) = '[email protected]'::text)
--    Rows Removed by Filter: 49999
--  Execution Time: 18.380 ms
Fix 1, expression index lưu sẵn LOWER(email), planner match trực tiếp:
CREATE INDEX idx_users_email_lower ON users(LOWER(email));

EXPLAIN ANALYZE SELECT * FROM users WHERE LOWER(email) = '[email protected]';
--  Index Scan using idx_users_email_lower on users
--    Index Cond: (lower(email) = '[email protected]'::text)
--  Execution Time: 0.055 ms
Fix 2, normalize tại INSERT (VALUES (lower($1), …)) rồi query WHERE email = '[email protected]' bằng index gốc, không tốn thêm index nhưng mọi code path ghi phải nhất quán. Hệ thống mới thì Fix 2, hệ thống cũ data hỗn hợp thì Fix 1. Họ hàng cùng lỗi: DATE_TRUNC('day', created_at) = '2026-01-15' và EXTRACT(year FROM created_at) = 2026, cả hai sửa bằng range created_at >= X AND created_at < Y.
3. Pattern 2 — vì sao assignee_id = 5.0 không dùng index còn = 5 thì dùng?
Khi hai vế khác kiểu, PostgreSQL phải cast một vế. Literal string '5' so với cột BIGINT được cast trên literal ('5'::bigint), index vẫn dùng được. Nhưng literal numeric so với cột bigint thì PostgreSQL chọn operator numeric = numeric và cast chính cột:
CREATE INDEX idx_tasks_assignee ON tasks(assignee_id);   -- BIGINT

-- ORM bind BigDecimal/double -> literal numeric 5.0
EXPLAIN ANALYZE SELECT * FROM tasks WHERE assignee_id = 5.0;
--  Seq Scan on tasks  (cost=0.00..21084.00 rows=5000 width=120)
--                     (actual time=0.020..142.150 rows=2 loops=1)
--    Filter: ((assignee_id)::numeric = 5.0)
--    Rows Removed by Filter: 999998
--  Execution Time: 142.200 ms

EXPLAIN ANALYZE SELECT * FROM tasks WHERE assignee_id = 5;
--  Index Scan using idx_tasks_assignee on tasks
--    Index Cond: (assignee_id = 5)
--  Execution Time: 0.045 ms
(assignee_id)::numeric là một hàm trên cột, giống hệt Pattern 1. Fix là bind đúng kiểu: literal integer, hoặc trong JDBC setLong(1, 5L) thay vì setBigDecimal/setDouble. Lỗi này hay đến từ ORM tự suy kiểu tham số từ kiểu trong code (double, BigDecimal, float).
Khác MySQL, PostgreSQL không tự coerce text sang số: WHERE phone = 904123456 với phone VARCHAR không chạy chậm mà ném ERROR: operator does not exist: character varying = integer. Cast ngầm phá index chỉ xảy ra giữa các kiểu số với nhau (bigint/integer vs numeric/double).
Thử ngẫmmột ORM bind userId kiểu int cho cột assignee_id BIGINT. EXPLAIN cho thấy Index Cond: (assignee_id = $1) không có cast nào. Đây có phải Pattern 2 không?
4. Pattern 3 — OR không đi qua composite index
Composite index (project_id, status) phục vụ a = 1 AND b = 2, không phục vụ a = 1 OR b = 2. Với OR, planner chỉ dùng được index khi mọi nhánh đều có index (BitmapOr gom bitmap từ từng nhánh); nhánh status không có index đơn thì cả query rơi về Seq Scan với Filter OR, dù nhánh project_id có index:
CREATE INDEX idx_tasks_proj_status ON tasks(project_id, status);

EXPLAIN ANALYZE SELECT * FROM tasks WHERE project_id = 1 OR status = 'urgent';
--  Seq Scan on tasks  (cost=0.00..21084.00 rows=1250 width=120)
--                     (actual time=0.018..142.320 rows=1180 loops=1)
--    Filter: ((project_id = 1) OR (status = 'urgent'::text))
--    Rows Removed by Filter: 998820
--  Execution Time: 142.520 ms
Fix: UNION ALL, mỗi nhánh dùng index riêng; điều kiện project_id != 1 ở nhánh hai loại row trùng:
SELECT * FROM tasks WHERE project_id = 1
UNION ALL
SELECT * FROM tasks WHERE status = 'urgent' AND project_id != 1;
--  Append  (actual time=0.025..1.840 rows=1180 loops=1)
--    ->  Index Scan using idx_tasks_proj_status on tasks  Index Cond: (project_id = 1)
--    ->  Index Scan using idx_tasks_status on tasks       Index Cond: (status = 'urgent'::text)
--                                                          Filter: (project_id <> 1)
--  Execution Time: 1.920 ms
Fix này cần index đơn trên từng cột của mỗi nhánh (idx_tasks_status ở trên), không chỉ composite. Có đủ index đơn thì planner cũng tự dùng BitmapOr cho OR (bài scan strategies); UNION ALL vẫn đáng khi từng nhánh selective và muốn Index Scan thẳng.
5. Pattern 4 — wildcard ở đầu LIKE
B-tree lưu giá trị theo thứ tự chữ cái và tìm bằng binary search, nên cần biết prefix để biết bắt đầu từ đâu. LIKE 'user%' có prefix, dùng được index; LIKE '%@gmail.com' thì không:
EXPLAIN ANALYZE SELECT * FROM users WHERE email LIKE '%@gmail.com';
--  Seq Scan on users  (actual time=0.018..14.520 rows=8420 loops=1)
--    Filter: ((email)::text ~~ '%@gmail.com'::text)
--    Rows Removed by Filter: 41580
--  Execution Time: 14.880 ms
Fix 1, GIN trigram (pg_trgm, mổ ở bài specialized index) chia string thành các bộ ba ký tự và index tất cả, nên pattern ở bất kỳ vị trí nào cũng tra được:
CREATE EXTENSION IF NOT EXISTS pg_trgm;
CREATE INDEX idx_users_email_trgm ON users USING gin(email gin_trgm_ops);

EXPLAIN ANALYZE SELECT * FROM users WHERE email LIKE '%@gmail.com';
--  Bitmap Heap Scan on users  (actual time=0.380..1.240 rows=8420 loops=1)
--    ->  Bitmap Index Scan on idx_users_email_trgm
--          Index Cond: ((email)::text ~~ '%@gmail.com'::text)
--  Execution Time: 1.580 ms
Fix 2, index trên reverse(email) rồi query WHERE reverse(email) LIKE reverse('%@gmail.com'), tức LIKE 'moc.liamg@%', prefix cố định, B-tree tìm được. Nhẹ hơn GIN nhưng chỉ cho suffix search; contains search ('%foo%') và ILIKE thì cần pg_trgm.
Thử ngẫmbảng users vừa thêm idx_users_email_trgm và write throughput giảm rõ. GIN trigram đang đánh đổi điều gì để đổi lấy tốc độ đọc đó?
6. Pattern 5 — vì sao prepared statement nhanh 5 lần đầu rồi chậm hẳn?
Với prepared statement, năm lần EXECUTE đầu PostgreSQL lập custom plan theo giá trị tham số thật. Từ lần thứ sáu nó so cost trung bình của custom plan với generic plan (lập cho $1 bất kỳ, dùng selectivity trung bình) và nếu generic không đắt hơn đáng kể thì cache generic plan cho mọi lần sau.
-- status: todo 70%, doing 20%, done 8%, archived 2%
PREPARE q(text) AS SELECT * FROM tasks WHERE status = $1;

EXPLAIN EXECUTE q('archived');   -- lan 1..5: custom plan
--  Index Scan using idx_tasks_status on tasks
--    Index Cond: (status = 'archived'::text)        <- gia tri that, 2% -> Index Scan dung
Lần thứ sáu EXPLAIN EXECUTE q('archived') sẽ in Index Scan hay Seq Scan, và dòng điều kiện sẽ ghi 'archived' hay $1? Quyết định rồi mới đọc.
EXPLAIN EXECUTE q('archived');   -- lan 6+
--  Seq Scan on tasks  (cost=0.00..3125.00 rows=12500 width=120)
--    Filter: ((status)::text = $1)                   <- $1 = generic plan
-- Generic plan uoc tinh selectivity trung binh ~25% -> Seq Scan
-- Nhung 'archived' chi 2% -> Index Scan nhanh hon ~10x
Dấu hiệu nhận biết là $1 trong Filter/Index Cond thay vì giá trị thật. Ba cách sửa:
| Fix | Overhead | Phù hợp khi |
|---|---|---|
SET plan_cache_mode = force_custom_plan | Re-plan mỗi lần (~0,1–5 ms) | Session/endpoint có tham số phân bố lệch |
DEALLOCATE q; PREPARE q … | Re-plan 5 lần đầu | Reset định kỳ trên connection pool |
| Dùng literal, bỏ prepared statement | Re-plan mỗi lần | Query ít gọi, chấp nhận planning overhead |
Thử ngẫmdashboard_q đã force_custom_plan cho riêng session dashboard. Một endpoint khác dùng chung connection pool có tự động thừa hưởng setting đó không?
7. Pitfall — tune mù không EXPLAIN trước
Workflow đúng: reproduce slow query với data đại diện → EXPLAIN (ANALYZE, BUFFERS) làm baseline → tìm node tốn nhất (actual time, rows lệch, read cao) → đặt giả thuyết theo 5 pattern → áp một fix → EXPLAIN lại và so actual time. Tăng work_mem không sửa được OR hay wildcard; SET enable_seqscan = off ép Index Scan bất kể cost và có thể chậm hơn. Baseline EXPLAIN là bằng chứng; actual time không giảm nghĩa là fix sai target.
8. Applied — audit dashboard query qua 5 pattern
Query dashboard từ mini-challenge dashboard query của khoá SQL & Database:
PREPARE dashboard_q(bigint) AS
  SELECT status, count(*) FROM tasks
  WHERE assignee_id = $1 AND status != 'archived'
  GROUP BY status;
Soi từng pattern: (1) hàm bọc cột: không, assignee_id và status dùng trực tiếp. (2) kiểu tham số: $1 khai bigint, ORM phải bind setLong; EXPLAIN phải in Index Cond: (assignee_id = $1) không kèm ::numeric. (3) OR: không có. (4) LIKE: không có. (5) generic plan: có, vì assignee_id phân bố lệch (manager 5.000 task, đa số dưới 10) nên sau 6 lần chạy cần kiểm tra:
DO $$ BEGIN FOR i IN 1..6 LOOP EXECUTE 'EXECUTE dashboard_q(5)'; END LOOP; END $$;

EXPLAIN EXECUTE dashboard_q(5);
-- "Index Cond: (assignee_id = $1)" -> generic plan, can theo doi
-- "Index Cond: (assignee_id = 5)"  -> custom plan, OK
-- Neu generic plan te: SET plan_cache_mode = force_custom_plan; cho session dashboard
Kết luận audit: pattern 1, 3, 4 sạch; pattern 2 kiểm tra kiểu bind của ORM; pattern 5 theo dõi sau khi deploy.
9. Deep Dive
- Use The Index, Luke — "The Where Clause" — Markus Winand, vì sao B-tree không xử lý được wildcard đầu, cast ngầm và hàm bọc cột, có hình B-tree trực quan. Đọc chương "Functions" trước.
- Use The Index, Luke — "Parameterized Queries" — bind parameter ảnh hưởng optimizer thế nào và khi nào literal tốt hơn, so sánh nhiều database.
- PostgreSQL 14 Internals — Egor Rogov, Part IV — Query Execution (chương về planner và plan cache) — free PDF, cơ chế chọn plan theo cost và cách executor dùng expression index.
10. Liên hệ các bài khác
- Statistics & cost model — vì sao hàm bọc cột làm planner rơi về hằng số ~0,5% và generic plan dùng selectivity trung bình.
- Scan strategies — đọc
FiltervsIndex Condvà Bitmap OR trong output của các pattern trên. - Specialized index: GIN, BRIN, partial — cơ chế trigram GIN đứng sau fix của Pattern 4.
- Pattern matching (khoá SQL & Database) — ngữ nghĩa LIKE/ILIKE trước khi nói đến index cho chúng.
- Tuning toolbox — thứ tự áp fix sau khi đã biết pattern nào đang mắc.
11. Tóm tắt
- Checklist đọc EXPLAIN: thấy
Filterthay vìIndex Condtrên cột đã có index → soi WHERE theo thứ tự hàm bọc cột → kiểu literal → OR → LIKE '%…' →$1trong điều kiện. - Suffix search: index trên
reverse(col); contains search hoặc ILIKE:pg_trgmGIN, chấp nhận write cost. - Mọi fix đều phải có EXPLAIN sau để so actual time với baseline.
12. Tự kiểm tra
- Q1Query
WHERE LOWER(username) = 'john_doe'không dùng index trênusername. Giải thích tại sao B-tree index trênusernamekhông apply, và viết 2 cách fix khác nhau với tradeoff của mỗi cách. - Q2Bảng
orderscóorder_id BIGINTvới index. ORM bind tham số kiểu BigDecimal nên query thànhWHERE order_id = 12345.0và chạy Seq Scan. Giải thích cơ chế cast của PostgreSQL, và điều gì xảy ra nếu thay vào đó cột là VARCHAR và literal là số không quote. - Q3Giải thích tại sao
LIKE '%@gmail.com'không dùng được B-tree index nhưngLIKE 'user%'(trailing wildcard) dùng được. Điều kiện gì cần đúng để B-tree apply cho LIKE? - Q4Prepared statement
PREPARE q(text) AS SELECT * FROM tasks WHERE status = $1đã chạy 10 lần. EXPLAIN EXECUTE q('archived') cho thấyFilter: (status = $1)thay vìIndex Cond: (status = 'archived'). Dòng đó báo hiệu gì, và với giá trị 'archived' thì nguy hiểm ở đâu? - Q5Team dev nói 'query chậm, thêm index là xong'. Bạn phản biện bằng cách nào để thuyết phục họ chạy EXPLAIN trước? Liệt kê ít nhất 3 tình huống mà thêm index không giải quyết được vấn đề.
Bài tiếp theo: Tuning toolbox — 6 cách fix theo hierarchy chi phí thấp → cao
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Statistics & cost model — planner ước tính row count như thế nào
Bài tiếpTuning toolbox — 6 tier fix từ rẻ đến đắt
Thảo luận & góp ý
Hỏi đáp về bài này