Mini-challenge — Dashboard 2,1 s → 50 ms trên 5 triệu task
Bài seed 5 triệu task, đo baseline 2,1 giây rồi áp ba fix (partial covering index, keyset pagination, extended statistics) và đo cải thiện sau mỗi bước.
Dashboard TaskFlow từ mini-challenge dashboard query của khoá SQL & Database đang chạy 2,1 giây trên production, dataset đã lên 5 triệu task. PM yêu cầu dưới 50 ms trước sprint kế tiếp, tức nhanh hơn 40 lần. Sau cost model, scan strategy và tuning toolbox, bạn đã có đủ công cụ.
Bài này tổng hợp cả module qua ba fix tăng dần trên dataset 5 triệu row: composite partial covering index, keyset pagination thay OFFSET, và extended statistics cho hai cột tương quan. Cuối bài là bốn EXPLAIN output và bảng so sánh.
Trước khi đọc lời giải: seed dataset theo mục Setup, chạy EXPLAIN baseline ở Step 1, rồi tự đề xuất ba fix theo thang tier của bài 06 và dự đoán tỷ lệ cải thiện của từng fix. Ghi lại dự đoán để đối chiếu với bảng cuối bài.
Setup — 5M dataset script
Truncate sạch và seed 5 triệu task với phân bố realistic: 1000 project, 10.000 user (10% unassigned), 4 status, due_at trải ±100 ngày.
TRUNCATE tasks RESTART IDENTITY CASCADE;

INSERT INTO tasks (project_id, assignee_id, title, status, due_at, created_at, updated_at)
SELECT
  (random() * 1000)::int + 1,                               -- 1000 project
  CASE WHEN random() < 0.1 THEN NULL                        -- 10% unassigned
       ELSE (random() * 10000)::int + 1 END,                -- 10000 user
  'Task ' || gs::text,
  (ARRAY['todo','doing','done','archived'])[floor(random() * 4) + 1],
  now() + (random() * 365 - 100) * interval '1 day',        -- +/-100 ngay
  now() - random() * interval '180 days',
  now() - random() * interval '90 days'
FROM generate_series(1, 5000000) gs;
-- Khoang 5-10 phut tuy toc do disk

ANALYZE tasks;   -- ngay sau seed, khong doi autovacuum
Phân bố sau seed: mỗi user ~450 task (5M × 90% / 10.000); mỗi status ~25%, tức ~1,25 triệu row archived; một user có ~340 task chưa archived.
Step 1 — Baseline EXPLAIN ANALYZE
Query dashboard: task chưa archived của một assignee, sắp theo due_at, trang 20, join projects:
EXPLAIN (ANALYZE, BUFFERS)
SELECT t.id, t.title, t.due_at, p.name AS project_name
FROM tasks t
JOIN projects p ON p.id = t.project_id
WHERE t.assignee_id = 5
  AND t.status != 'archived'
ORDER BY t.due_at
OFFSET 0 LIMIT 20;
Bảng chưa có index nào ngoài primary key. Trước khi chạy: planner sẽ đọc tasks bằng cách nào, node Sort sẽ sort bao nhiêu row trước khi Limit lấy 20, và Sort đó nằm trong RAM hay tràn ra disk? Viết ba con số bạn tin rồi mới chạy.
Output baseline (tham khảo, số thực tế dao động theo hardware):
Limit  (cost=177154.20..177154.25 rows=20 width=72)
       (actual time=2051.234..2051.239 rows=20 loops=1)
  ->  Sort  (cost=177154.20..177155.05 rows=338 width=72)
            (actual time=2051.232..2051.236 rows=20 loops=1)
        Sort Key: t.due_at
        Sort Method: top-N heapsort  Memory: 28kB
        ->  Hash Join  (cost=28.50..177140.12 rows=338 width=72)
                       (actual time=1.843..2050.910 rows=341 loops=1)
              Hash Cond: (t.project_id = p.id)
              Buffers: shared hit=8821 read=33412
              ->  Seq Scan on tasks t
                    (cost=0.00..177081.00 rows=338 width=60)
                    (actual time=0.041..2049.870 rows=341 loops=1)
                    Filter: ((assignee_id = 5) AND (status <> 'archived'))
                    Rows Removed by Filter: 4999659
                    Buffers: shared hit=8765 read=33219
              ->  Hash  (cost=16.00..16.00 rows=1000 width=20)
                    ->  Seq Scan on projects p
Planning Time: 1.234 ms
Execution Time: 2054.891 ms
Ba issue đọc ra từ plan:
Issue 1, Seq Scan toàn bảng. Planner đọc hết tasks (42.000 buffer, trong đó 33.000 từ disk), lọc bỏ 4.999.659 row để giữ 341 row của assignee 5. Không có index nào cho (assignee_id, status). Ước tính rows=338 sát thực tế: statistics đúng, planner không có lựa chọn nào tốt hơn.
Issue 2, Sort chặn Limit. 341 row sort trong RAM chỉ tốn 28 kB, nhưng Sort là node blocking: Limit không nhận được row nào cho tới khi Sort xong, và Sort không xong cho tới khi Seq Scan quét hết 5 triệu row. LIMIT 20 không giúp gì. Có index sắp theo due_at thì node Sort biến mất và Limit đọc đúng 20 entry đầu.
Issue 3, OFFSET sâu là O(n). OFFSET 0 chưa lộ, nhưng OFFSET 300 (trang 16) buộc executor sinh 320 row rồi vứt 300; trên listing rộng hơn (feed toàn công ty), OFFSET 100.000 là hàng trăm ms. Cần keyset pagination.
Step 2 — Fix 1: composite partial covering index
Gợi ý trước khi mở lời giải: WHERE lọc hai cột nào và ORDER BY cần thứ tự nào, cột nào nên vào key theo quy tắc equality trước range sau, cột nào chỉ cần INCLUDE để tránh heap fetch, và điều kiện nào của query có thể thành điều kiện partial? Sau khi tạo index, còn thiếu bước gì để có Heap Fetches: 0?
Index composite (assignee_id, status, due_at, id), partial WHERE status != 'archived', INCLUDE các cột SELECT và JOIN cần:
CREATE INDEX idx_tasks_dashboard
ON tasks(assignee_id, status, due_at, id)
INCLUDE (project_id, title)          -- covering: tranh heap fetch cho SELECT + JOIN key
WHERE status != 'archived';          -- partial: bo qua 1.25M row archived

VACUUM ANALYZE tasks;   -- cap nhat visibility map cho Index Only Scan
Vì sao thứ tự cột này: assignee_id equality trước, thu từ 5 triệu xuống ~450 row; status equality tiếp; due_at range sau để index đã sắp theo due_at trong mỗi assignee (bài composite index); id đứng cuối key làm tie-breaker, vì Fix 2 sẽ sort và lọc theo (due_at, id) và điều kiện đó chỉ đi vào Index Cond khi cả hai cột nằm trong key. Partial bỏ 1,25 triệu row archived, index nhỏ hơn ~25%. INCLUDE (project_id, title) cover phần còn lại của SELECT và JOIN key.
Chạy lại EXPLAIN với cùng query:
Limit  (cost=0.56..42.18 rows=20 width=72)
       (actual time=0.612..4.787 rows=20 loops=1)
  ->  Nested Loop  (cost=0.56..712.34 rows=338 width=72)
                   (actual time=0.611..4.781 rows=20 loops=1)
        ->  Index Only Scan using idx_tasks_dashboard on tasks t
              (cost=0.56..534.21 rows=338 width=52)
              (actual time=0.389..4.121 rows=20 loops=1)
              Index Cond: ((assignee_id = 5) AND (status <> 'archived'))
              Heap Fetches: 0
              Buffers: shared hit=8
        ->  Index Scan on projects p
              (cost=0.00..0.43 rows=1 width=20)
              (actual time=0.031..0.031 rows=1 loops=20)
              Index Cond: (id = t.project_id)
Planning Time: 0.856 ms
Execution Time: 4.921 ms
2054 ms → 4,9 ms, khoảng 420 lần. Index Only Scan với Heap Fetches: 0: toàn bộ dữ liệu lấy từ 8 index page. Node Sort biến mất vì index đã sắp theo due_at, nên Limit dừng sau 20 entry. Hash Join thành Nested Loop vì chỉ còn 20 row cần ghép.
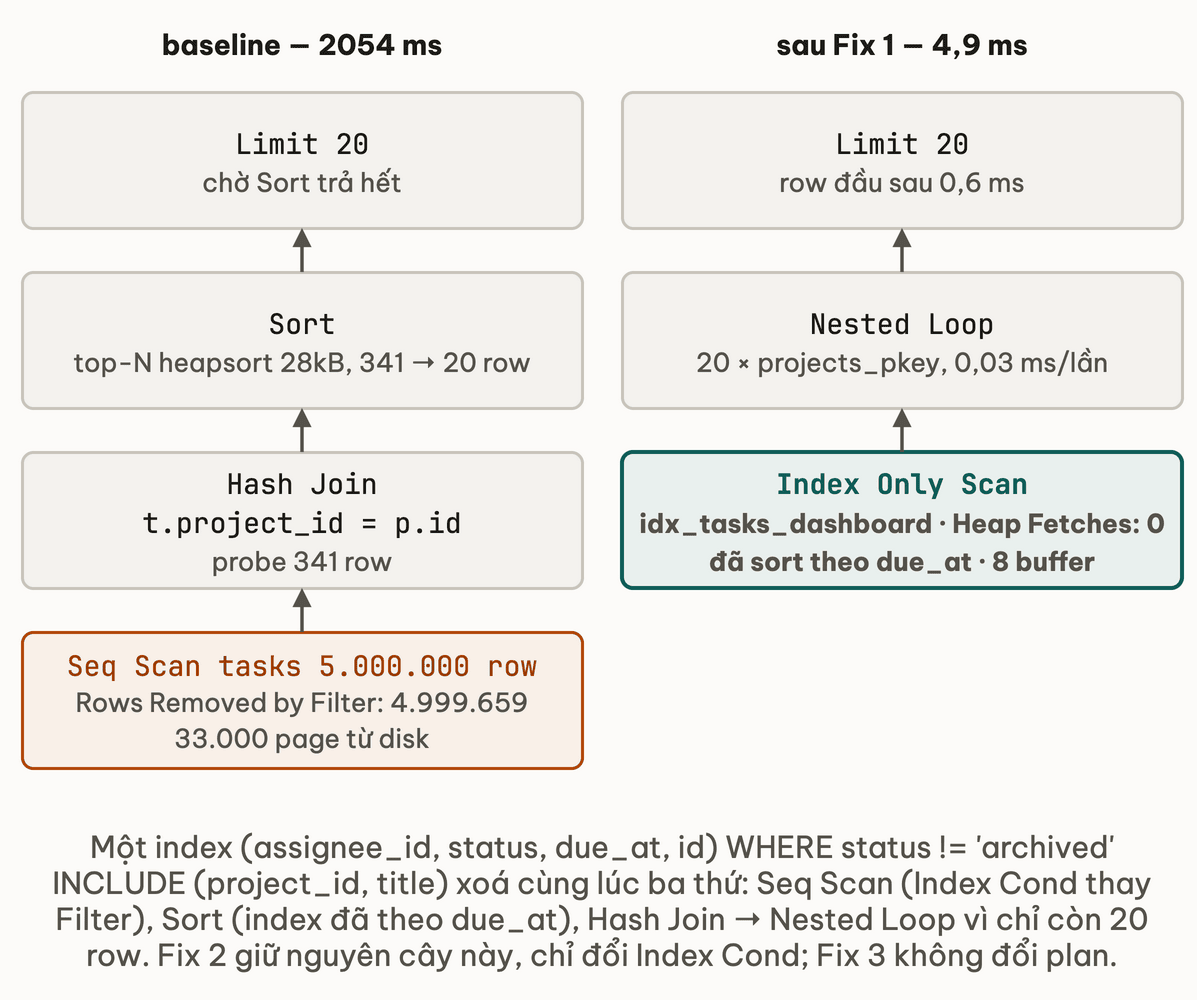
Step 3 — Fix 2: keyset pagination thay OFFSET
Trang đầu đã ổn, nhưng OFFSET n vẫn buộc executor sinh n + 20 row rồi vứt n. Keyset dùng cursor từ row cuối trang trước để Index range scan nhảy thẳng tới vị trí cần (cơ chế ở bài ORDER BY & pagination).
Gợi ý: trang trước kết thúc ở row nào, và điều kiện WHERE nào diễn tả "mọi row đứng sau row đó theo thứ tự ORDER BY"? ORDER BY cần thêm cột gì để hai row cùng due_at không làm cursor mơ hồ?
-- Cursor (due_at, id) lay tu row cuoi cua trang truoc
EXPLAIN (ANALYZE, BUFFERS)
SELECT t.id, t.title, t.due_at, p.name AS project_name
FROM tasks t
JOIN projects p ON p.id = t.project_id
WHERE t.assignee_id = 5
  AND t.status != 'archived'
  AND (t.due_at, t.id) > ('2026-06-15', 12345)
ORDER BY t.due_at, t.id
LIMIT 20;
ORDER BY phải kèm id để cursor unique khi nhiều row cùng due_at; client lưu (due_at, id) của row cuối làm cursor cho request kế; keyset chỉ cho next/previous, không nhảy tới trang tuỳ ý.
Output ở trang gần cuối (tương đương OFFSET 300):
Limit  (cost=0.56..41.94 rows=20 width=76)
       (actual time=0.298..2.041 rows=20 loops=1)
  ->  Nested Loop  (cost=0.56..248.12 rows=113 width=76)
                   (actual time=0.297..2.036 rows=20 loops=1)
        ->  Index Only Scan using idx_tasks_dashboard on tasks t
              (cost=0.56..196.78 rows=113 width=56)
              (actual time=0.241..1.512 rows=20 loops=1)
              Index Cond: ((assignee_id = 5) AND (status <> 'archived')
                           AND ((due_at, id) > ('2026-06-15'::timestamptz, 12345)))
              Heap Fetches: 0
              Buffers: shared hit=6
        ->  Index Scan on projects p  (actual time=0.025..0.025 rows=1 loops=20)
Execution Time: 2.134 ms
Cùng trang đó bằng OFFSET 300 (ước tính từ plan trên, không kèm EXPLAIN): Index Only Scan phải sinh 320 entry, Nested Loop probe projects 320 lần rồi Limit vứt 300, khoảng 9 ms. Keyset: 2,1 ms. Chênh lệch tuyệt đối nhỏ vì assignee 5 chỉ có 341 row; cái đáng nhớ là dạng chi phí: OFFSET là O(n) theo độ sâu trang, keyset là O(log n + 20) ở mọi trang, và trên listing 3,75 triệu row active toàn hệ thống, OFFSET 100000 là ~400 ms còn keyset vẫn ~2 ms.
Step 4 — Fix 3: extended statistics cho hai cột tương quan
Planner ước tính selectivity của status và due_at như hai cột độc lập. Query dashboard không bị ảnh hưởng (ước tính 338 vs thực tế 341, vì assignee_id và status thật sự độc lập), nên Fix 3 không đổi plan của query này; nó nhắm vào họ query lọc cả status lẫn due_at trong data thật của TaskFlow, nơi task todo hay có due_at sắp tới còn task done có due_at cũ.
Gợi ý: cặp cột nào của bảng có khả năng phụ thuộc nhau, lệnh nào nói cho planner biết điều đó, và sau lệnh đó còn thiếu bước gì để statistics mới thật sự được thu thập?
CREATE STATISTICS stats_tasks_status_due (dependencies, ndistinct)
ON status, due_at FROM tasks;

ANALYZE tasks;   -- BAT BUOC de thu thap extended statistics

SELECT stxname, stxkeys, stxdependencies
FROM pg_statistic_ext
JOIN pg_statistic_ext_data ON pg_statistic_ext.oid = pg_statistic_ext_data.stxoid
WHERE stxrelid = 'tasks'::regclass;
Chạy lại query keyset của Step 3: plan y hệt Step 3, cùng rows=113, thời gian dao động 1,5–2,1 ms giữa các lần chạy là nhiễu đo, không phải cải thiện. Chỗ để thấy effect là query corner case:
EXPLAIN SELECT count(*) FROM tasks WHERE status = 'todo' AND due_at < now();
-- Truoc CREATE STATISTICS, planner nhan doc lap:
--   sel(status='todo') x sel(due_at < now()) = 0.25 x 0.27 = 6.8% -> rows=340000
Trên dataset seed, status và due_at được random độc lập nên ước tính 340.000 gần đúng và stxdependencies thu được rất thấp: Fix 3 không đổi gì ở đây, và đó là điều đúng. Trên data thật, tổ hợp "todo mà đã quá hạn" hiếm hơn nhiều so với tích hai xác suất; không có dependencies, planner ước tính vượt thực tế hàng chục lần và chọn Hash Join hoặc Seq Scan cho họ query đó; có dependencies thì ước tính về gần thực tế. Muốn kiểm, chạy đúng câu EXPLAIN ở trên trước và sau khi tạo statistics, trên bản sao production.
So sánh 4 plan
| Plan | Time (ms) | Cost ước tính | Buffer | Strategy chính |
|---|---|---|---|---|
| Baseline | 2054 | 177.154 | 42.233 | Seq Scan 5M row + Sort chặn Limit |
| Fix 1: covering partial index | 4,9 | 42 | 8 | Index Only Scan, Heap Fetches 0, không Sort |
| Fix 1+2: keyset trang cuối | 2,1 | 42 | 6 | Index range scan từ cursor (OFFSET 300 tương đương: ~9 ms) |
| Fix 1+2+3: extended stats | 2,1 | 42 | 6 | Plan dashboard không đổi; effect ở query lọc status × due_at trên data thật |
Trong ba fix, chỉ Fix 1 làm đổi plan; Fix 2 và Fix 3 mua bảo hiểm cho trang sâu và cho họ query khác trên cùng cặp cột.
Thử ngẫmidx_tasks_dashboard có điều kiện partial WHERE status != 'archived'. Một query chỉ có WHERE assignee_id = 5, không nhắc status, có được planner cho dùng index này không, và vì sao?
Deliverable
Tạo file explain_challenge.sql ghi lại 4 EXPLAIN output kèm comment insight:
-- Mini-challenge: Dashboard 2s -> 50ms; dataset 5M tasks, 1000 projects, 10000 users
-- Section 0: Setup (seed + ANALYZE)
-- Section 1: Baseline EXPLAIN
--   Record: Seq Scan 5M row, Rows Removed 4.999.659, Sort chan Limit, ~2054ms
-- Section 2: Fix 1 - composite partial covering index + VACUUM ANALYZE
--   Record: Index Only Scan, Heap Fetches: 0, ~4.9ms (420x)
-- Section 3: Fix 2 - keyset pagination
--   Record: ~2.1ms trang cuoi; OFFSET 300 tuong duong ~9ms; O(n) -> O(log n)
-- Section 4: Fix 3 - CREATE STATISTICS + ANALYZE
--   Record: plan dashboard khong doi; EXPLAIN corner case status='todo' AND due_at < now() truoc/sau
-- Section 5: Ratio summary
--   Baseline 2054 ms (1x) -> Fix 1 4.9 ms (420x) -> Fix 2 trang cuoi 9 ms -> 2.1 ms -> Fix 3 khong doi plan
--   Insight: fix nao dong gop nhieu nhat va vi sao covering partial index la fix dau tien
Kèm comment cuối file: insight nào bất ngờ nhất so với dự đoán bạn ghi ở đầu bài.
Forward — auto_explain và pg_stat_statements
Bài này bạn biết query nào cần tune vì PM báo. Trong production với hàng trăm query, hai extension giúp tự phát hiện:
-- auto_explain: ghi EXPLAIN cua moi query cham hon nguong vao server log
-- postgresql.conf / ALTER SYSTEM:
--   auto_explain.log_min_duration = 200    -- ms
--   auto_explain.log_analyze = on
--   auto_explain.log_buffers = on

-- pg_stat_statements: top query theo tong thoi gian tren toan workload
-- CREATE EXTENSION pg_stat_statements;
SELECT query, calls, mean_exec_time, total_exec_time
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 10;
pg_stat_statements cho biết query nào tốn nhiều thời gian nhất trên toàn bộ workload, không chỉ query bạn đang debug. Cấu hình đầy đủ, tune ngưỡng và kết hợp với pg_stat_user_indexes để audit index thuộc module Observability của khoá PostgreSQL — Advanced & Scale (đang xây).
- PostgreSQL Documentation — auto_explain: các GUC, log format, nested statement logging. Đọc "Configuration Parameters" trước khi bật trong production.
- PostgreSQL Documentation — pg_stat_statements: schema của view,
pg_stat_statements_reset(), normalization query text. - PostgreSQL Documentation — CREATE STATISTICS:
dependencies,ndistinct,mcv, cách đọcpg_statistic_ext_data.
Thử ngẫmpg_stat_statements xếp một query lên top 10 theo total_exec_time nhưng mean_exec_time của nó lại thấp. Điều gì khiến một query nhanh vẫn leo lên đầu danh sách cần ưu tiên?
Bài tiếp theo: Bạn đã hoàn thành PostgreSQL — Schema, Index & Internals. Tiếp tục với khoá PostgreSQL — Advanced & Scale ở JSONB vs JSON vs TEXT, hoặc ôn lại pattern truy vấn nâng cao ở Subquery, CTE, LATERAL.
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Tuning toolbox — 6 tier fix từ rẻ đến đắt
Khoá tiếp theoPostgreSQL — Advanced & Scale
Course tier 3 của track SQL & PostgreSQL. Bắt đầu với dữ liệu bán cấu trúc và tìm kiếm: JSONB (binary, operator, path query, GIN index, hybrid schema), full-text search tiếng Việt với unaccent, pgvector cho RAG. Các module scaling/replication/multi-tenant RLS, observability/operations và capstone TaskFlow Analytics 10M+ rows đang được viết. Pattern truy vấn nâng cao (CTE, window, UPSERT, MERGE) đã nằm ở khoá SQL & Database.
7 bài · ~1.7 giờThảo luận & góp ý
Hỏi đáp về bài này