ORDER BY + pagination — vì sao OFFSET 100k chậm 200 lần
OFFSET cost tỷ lệ skip rows. Keyset pagination O(1). NULL ordering. Stable sort cần tiebreaker. Pattern infinite scroll dashboard.
Dashboard TaskFlow hiển thị danh sách task theo thời gian tạo. Page 1 trả về trong 12ms. Page 100 (OFFSET 1000 LIMIT 10): 250ms. Page 5000 (OFFSET 50000): 4 giây. Schema không thay đổi, không có thêm query nào khác, chỉ số trang tăng dần — nhưng app ngày càng chậm khi người dùng cuộn thêm. Vì sao OFFSET càng cao càng chậm, và keyset pagination vẫn chỉ vài ms dù đang ở page 10000?
Bài này giải thích cơ chế OFFSET cost, NULL ordering trap, stable sort tiebreaker, và pattern keyset pagination cho production infinite scroll.
1. Analogy — OFFSET vs keyset
Hình dung thư viện có một cuốn sách dày 500.000 trang, được đánh số trang liên tục. Bạn muốn đọc 10 trang bắt đầu từ trang 100.001.
Cách A (OFFSET): Mở từ trang 1, đếm và lật qua 100.000 trang, rồi đọc 10 trang tiếp theo. Trang 200.001 thì lật qua 200.000 trang. Càng đọc sâu, càng mất công lật.
Cách B (keyset): Bạn đã đánh dấu trang 100.000 bằng bookmark. Mở thẳng bookmark đó, đọc 10 trang tiếp theo. Không cần lật bất kỳ trang nào trước đó — dù bookmark ở trang 1 hay trang 499.000, chi phí như nhau.
| Thư viện | SQL pagination |
|---|---|
| Lật qua 100k trang | Skip 100k rows với OFFSET |
| Đọc 10 trang sau đó | Fetch 10 rows với LIMIT |
| Càng sâu càng tốn công lật | OFFSET cost tăng tuyến tính |
| Bookmark trang bất kỳ | Cursor (last seen row value) |
| Mở thẳng bookmark | Index seek đến cursor row |
| Chi phí không đổi dù bookmark ở đâu | Keyset: O(log N) bất kể page |
OFFSET = đọc sách từ đầu rồi skip. Keyset = mở thẳng bookmark. Thư viện với sách 500k trang — bookmark luôn thắng.
2. ORDER BY cú pháp + NULL ordering
Cú pháp đầy đủ và các pattern thường gặp:
-- Single column, ascending (default)
SELECT * FROM tasks
ORDER BY created_at;       -- ASC la default

-- Multi-column sort: priority truoc, sau do due_at, sau do tiebreaker id
SELECT * FROM tasks
ORDER BY status, due_at NULLS LAST, id;

-- Explicit NULL position (portable cross-engine)
SELECT * FROM tasks
ORDER BY due_at ASC NULLS LAST,     -- NULL xuat hien cuoi
         created_at DESC NULLS FIRST;  -- NULL xuat hien dau
NULL ordering mặc định theo hệ quản trị:
| Direction | PostgreSQL default | MySQL/SQLite default | Ý nghĩa khi explicit |
|---|---|---|---|
ASC | NULLS LAST | NULL xếp đầu (nhỏ nhất) | ASC NULLS LAST — NULL sau mọi giá trị |
DESC | NULLS FIRST | NULL xếp đầu (nhỏ nhất) | DESC NULLS FIRST — NULL trước mọi giá trị |
Default NULL ordering khác nhau giữa engine — để code portable và intent rõ ràng, luôn viết explicit NULLS FIRST / NULLS LAST. ASC NULLS LAST đặt "chưa có hạn" sau task có hạn; DESC NULLS FIRST đặt "chưa xác định" trước.
NULLS FIRST / NULLS LAST là cú pháp ANSI SQL:2003, được hỗ trợ bởi PostgreSQL, Oracle, DB2, và SQLite 3.30+. MySQL chưa hỗ trợ trực tiếp — workaround phổ biến là ORDER BY col IS NULL ASC, col ASC (NULL được xem là giá trị 0/false trong biểu thức boolean, xếp đầu) hoặc ORDER BY ISNULL(col), col.
Stable sort và tiebreaker:
Khi nhiều row có cùng giá trị ở column sort, thứ tự trả về là nondeterministic — hệ quản trị không cam kết thứ tự giữa các row tied. Hai lần chạy cùng query có thể trả về thứ tự khác nhau. Fix: thêm column unique làm tiebreaker cuối cùng.
-- Khong stable: cac task cung status, due_at co the doi thu tu giua 2 query
SELECT * FROM tasks
ORDER BY status, due_at NULLS LAST;

-- Stable: id la primary key, unique, dam bao thu tu quyet dinh
SELECT * FROM tasks
ORDER BY status, due_at NULLS LAST, id;
3. OFFSET cơ chế — vì sao chậm
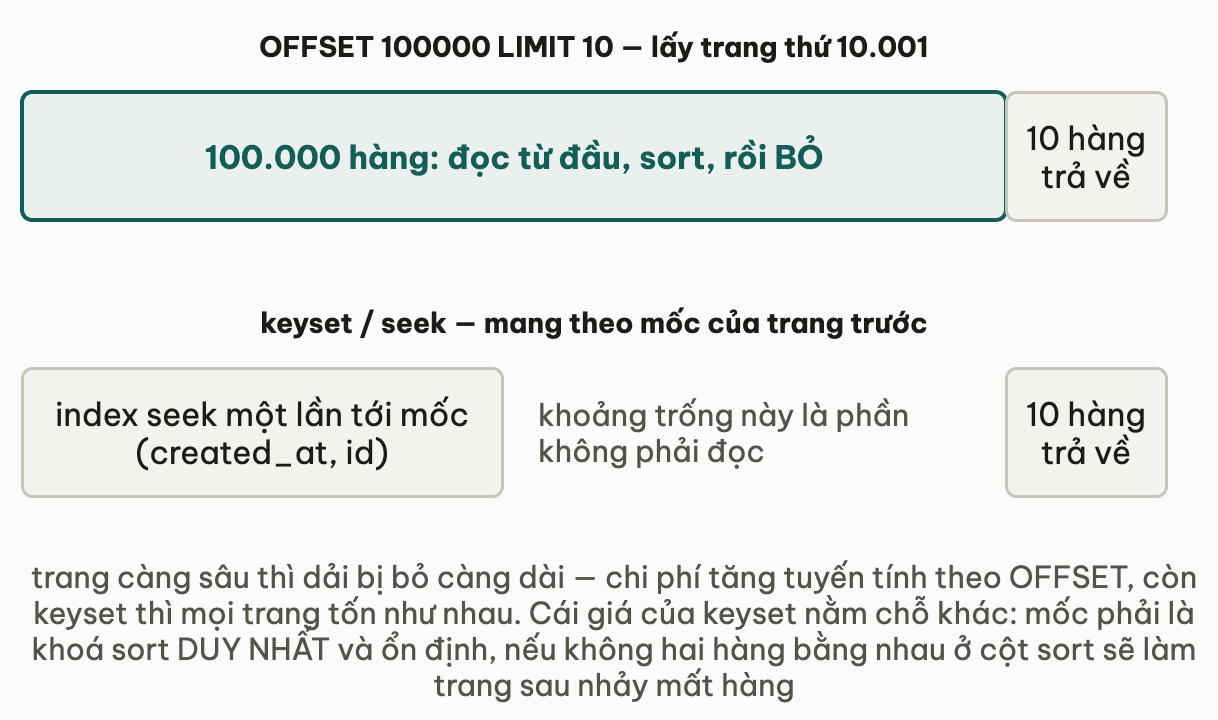
Hệ quản trị xử lý LIMIT 10 OFFSET 100000 theo ba bước:
- Scan + sort rows theo ORDER BY clause.
- Đếm và skip 100.000 rows đầu tiên.
- Return 10 rows tiếp theo.
Bước 2 là vấn đề: database phải thực sự đọc và xử lý 100.000 rows đó, chỉ để bỏ đi. Cost tỷ lệ thuận với OFFSET + LIMIT. Gấp đôi offset = gấp đôi thời gian.
-- Bang tasks voi 5 trieu row
-- Execution plan cho thay: Limit -> Sort -> Seq Scan
SELECT * FROM tasks
ORDER BY created_at DESC
LIMIT 10 OFFSET 100000;
-- actual time: ~850ms (phai xu ly 100010 rows)

SELECT * FROM tasks
ORDER BY created_at DESC
LIMIT 10 OFFSET 1000000;
-- actual time: ~8500ms (10x worse -- 10x offset = 10x cost)
Nếu column sort có index: database dùng index scan thay vì seq scan + sort, nhưng vẫn phải traverse 100k index entries để đếm và skip — chậm tuyến tính với offset.
Module 6 — Storage & indexing sẽ đi sâu vào cách đọc execution plan và nhận biết bước nào gây chậm.
Thử ngẫmdashboard TaskFlow thêm nút "Trang cuối". Nút đó tương đương OFFSET bằng gần hết số row trong bảng — chi phí của một cú click đó lớn cỡ nào so với trang 2?
4. Keyset pagination — O(1) per page
Thay vì "skip N rows đầu tiên", keyset pagination dùng giá trị của row cuối cùng đã thấy làm cursor — chỉ lấy rows đứng sau cursor đó.
-- Page 1: khong co cursor
SELECT id, title, created_at
FROM tasks
ORDER BY created_at DESC, id DESC
LIMIT 10;
-- Tra ve 10 rows, row cuoi co: created_at = '2026-05-04 10:00:00', id = 9991

-- Page 2: dung (created_at, id) cua row cuoi lam cursor
SELECT id, title, created_at
FROM tasks
WHERE (created_at, id) < ('2026-05-04 10:00:00', 9991)
ORDER BY created_at DESC, id DESC
LIMIT 10;
-- Plan: Limit -> Index Scan Backward on (created_at DESC, id DESC)
-- actual time: ~4ms -- bat ke page nao
Với B-tree composite index trên (created_at DESC, id DESC), database thực hiện index seek trực tiếp đến cursor thay vì scan từ đầu. Cost là O(log N) cho seek + O(LIMIT) để fetch — bất kể page nào.
Tradeoff keyset vs OFFSET:
| Keyset | OFFSET | |
|---|---|---|
| Cost per page | O(log N) — hằng số | O(offset + limit) — tuyến tính |
| Scale với deep page | Tốt | Xấu |
| Jump to page N trực tiếp | Không hỗ trợ | Hỗ trợ |
| Consistency khi insert mới | Row mới không shift page | Row mới có thể shift toàn bộ page |
| Cursor encoding | Cần (base64 JSON) | Chỉ cần số trang |
| Phù hợp | Infinite scroll, feed | Admin panel jump-to-page |
5. Tuple comparison — cú pháp (a, b) < (x, y)
ANSI SQL hỗ trợ tuple comparison (row value comparison) — so sánh nhiều column cùng lúc theo lexicographic order:
-- Tuong duong: created_at < '2026-05-04' OR (created_at = '2026-05-04' AND id < 9991)
WHERE (created_at, id) < ('2026-05-04 10:00:00', 9991)
Cú pháp này ngắn gọn hơn điều kiện AND/OR tương đương, và query planner của nhiều hệ quản trị nhận biết được để tối ưu với composite B-tree index.
Row value comparison (a, b) < (x, y) được định nghĩa trong ANSI SQL:1999. PostgreSQL, MySQL 8.0+, và SQLite hỗ trợ đầy đủ. SQL Server không hỗ trợ cú pháp này — phải viết dạng AND/OR tương đương: (a < x OR (a = x AND b < y)).
Nếu cursor column có thể chứa NULL, tuple comparison (a, b) < (x, y) không hoạt động đúng — NULL không so sánh được bằng toán tử thông thường. Khi due_at có NULL và bạn dùng nó làm cursor column, phải tách điều kiện hoặc dùng COALESCE để thay NULL bằng sentinel value. Module 6 — Storage & indexing sẽ phân tích composite index và NULL handling chi tiết hơn.
Thử ngẫmbạn đổi cursor sort key từ created_at sang due_at — cột vốn cho phép NULL với nhiều task "chưa có hạn". Pitfall vừa nêu ở trên áp dụng ngay, hay còn điều kiện nào khác nữa?
6. Pitfall — pagination không có ORDER BY
-- SAI: page 1 va page 2 co the overlap hoac miss rows
SELECT id, title FROM tasks LIMIT 10 OFFSET 0;
SELECT id, title FROM tasks LIMIT 10 OFFSET 10;

-- Khong co ORDER BY: thu tu row phu thuoc vao execution plan (nondeterministic).
-- Planner co the chon seq scan, index scan, hoac plan khac
-- tuy thuoc vao statistics va cache -- thu tu row co the doi.

-- DUNG: luon co ORDER BY
SELECT id, title FROM tasks ORDER BY id LIMIT 10 OFFSET 0;
SELECT id, title FROM tasks ORDER BY id LIMIT 10 OFFSET 10;
Không có ORDER BY, hệ quản trị tự do chọn bất kỳ thứ tự nào phụ thuộc vào execution plan. Giữa hai query liên tiếp, nếu plan thay đổi (do statistics update, plan cache miss), page 2 có thể chứa rows đã hiển thị ở page 1, hoặc miss một số rows hoàn toàn. SQL chuẩn không cam kết thứ tự trả về khi không có ORDER BY. Luôn thêm ORDER BY khi dùng LIMIT/OFFSET.
7. Khi nào OFFSET vẫn ổn
OFFSET không phải luôn sai — context quyết định:
| Tình huống | Nên dùng | Lý do |
|---|---|---|
| Public infinite scroll feed | Keyset | OFFSET chậm ở deep page, data shift khi insert mới |
| Admin panel jump-to-page, table nhỏ dưới 10k row | OFFSET ổn | Table nhỏ, OFFSET cost chấp nhận được |
| Real-time feed (Twitter-style) | Keyset bắt buộc | Insert liên tục làm OFFSET shift mạnh |
| Internal report, 1-2 người dùng | OFFSET ổn | Traffic thấp, page thường nhỏ |
| Page 1-10 trên bất kỳ table | OFFSET ổn | Offset nhỏ, cost không đáng kể |
| Analytics dashboard phân trang sâu | Keyset | OFFSET 50k+ row = vài giây per query |
Pattern quyết định nhanh: nếu user có thể scroll/page sâu tùy ý, hoặc nếu data liên tục insert mới — chọn keyset. Nếu dataset nhỏ và UI có jump-to-page cố định — OFFSET ổn.
Thử ngẫmadmin panel nội bộ chỉ 3000 row hôm nay đang dùng OFFSET ổn thoả. Đội sales muốn export toàn bộ lịch sử — bảng đó sẽ chạm mốc nào để bạn phải đổi sang keyset?
8. Applied — TaskFlow infinite scroll
Frontend hiển thị task feed 20 task/lần, scroll tự động load thêm. API design:
// Request 1 -- page dau tien
GET /api/tasks?limit=20

// Response
{
  "items": [...],
  "next_cursor": "eyJjcmVhdGVkX2F0IjoiMjAyNi0wNS0wNCAxMDowMDowMCIsImlkIjo5OTkxfQ=="
}

// Request 2 -- dung cursor tu response truoc
GET /api/tasks?limit=20&cursor=eyJjcmVhdGVkX2F0IjoiMjAyNi0wNS0wNCAxMDowMDowMCIsImlkIjo5OTkxfQ==
Backend node-postgres:
// Decode cursor tu base64 JSON
const cursor = req.query.cursor
  ? JSON.parse(Buffer.from(String(req.query.cursor), 'base64').toString())
  : null;

// Build query dua vao cursor
const { rows } = cursor
  ? await pool.query(
      `SELECT id, title, created_at FROM tasks
       WHERE (created_at, id) < ($1, $2)
       ORDER BY created_at DESC, id DESC
       LIMIT $3`,
      [cursor.created_at, cursor.id, limit]
    )
  : await pool.query(
      `SELECT id, title, created_at FROM tasks
       ORDER BY created_at DESC, id DESC
       LIMIT $1`,
      [limit]
    );

// Encode cursor tu row cuoi cung
const lastRow = rows[rows.length - 1];
const nextCursor = lastRow
  ? Buffer.from(JSON.stringify({ created_at: lastRow.created_at, id: lastRow.id })).toString('base64')
  : null;
Index cần thiết cho keyset query trên:
-- Composite index phai match thu tu ORDER BY
CREATE INDEX idx_tasks_created_at_id ON tasks (created_at DESC, id DESC);
9. Deep Dive — Pagination performance
- Use The Index, Luke — "We Need Tool Support for Keyset Pagination" — Markus Winand giải thích tại sao OFFSET không scale, keyset pagination hoạt động thế nào, cross-vendor syntax. Free web. Đọc đây trước — agnostic, trình bày rõ và có visual.
- Modern SQL — Keyset Pagination — chi tiết cú pháp keyset trên PostgreSQL, MySQL, Oracle, SQL Server với ví dụ row value comparison và workaround cho engine không hỗ trợ.
- PostgreSQL Documentation 7.5 "Sorting Rows" — official syntax cho ORDER BY, NULLS FIRST/LAST, multiple sort keys (tham khảo khi dùng PostgreSQL).
Ghi chú: Use The Index Luke cho intuition + perf rationale agnostic. Modern SQL cho cross-vendor keyset syntax. PG docs cho cú pháp chính xác trên PostgreSQL.
10. Liên hệ các bài khác
- Bài 02 — WHERE + NULL three-valued logic: NULL ordering (
NULLS FIRST/LAST) là hệ quả trực tiếp của three-valued logic — NULL không so sánh được nên cần vị trí tường minh. - Bài 04 — DISTINCT vs GROUP BY: GROUP BY cũng cần tiebreaker khi nhiều row tied — cùng nguyên lý stable sort.
- Bài 07 — Mini-challenge dashboard: keyset pagination được áp dụng trực tiếp trong bài challenge — ôn tập toàn bộ phần này.
- Module 6 — Storage & indexing: composite B-tree index cho keyset query — tại sao index seek đến cursor O(log N) thay vì full scan.
11. Tóm tắt
- ORDER BY cần explicit NULL position (
NULLS FIRST/NULLS LAST) để portable và intent rõ ràng — default NULL ordering khác nhau giữa engine. - Stable sort cần tiebreaker — thêm column unique (
, id) ở cuối ORDER BY để tránh nondeterministic order khi có tied rows. - OFFSET cost = O(offset + limit) — database phải đọc và bỏ toàn bộ rows trước cursor. Tăng tuyến tính, không scale với deep page.
- Keyset pagination = O(log N) + O(LIMIT) — seek trực tiếp đến cursor qua B-tree index. Cost không đổi dù page 1 hay page 10000.
- Tuple comparison
(a, b) < (x, y)là cú pháp keyset chuẩn — ngắn hơn AND/OR tương đương và planner tối ưu được với composite index. - LIMIT/OFFSET không có ORDER BY = nondeterministic — page overlap hoặc miss rows, tùy execution plan.
- Keyset không hỗ trợ jump-to-page trực tiếp — dùng OFFSET khi cần tính năng đó và table đủ nhỏ.
- Forward links: Module 6 — Storage & indexing (composite B-tree index cho keyset, execution plan đọc OFFSET cost).
12. Tự kiểm tra
- Q1Vì sao OFFSET 100000 chậm hơn OFFSET 100 khoảng 1000 lần — cơ chế executor diễn ra thế nào?
- Q2Phân biệt khi nào dùng keyset pagination thay vì OFFSET, và khi nào OFFSET vẫn chấp nhận được. Cho 2 ví dụ cụ thể cho mỗi loại.
- Q3Bạn dùng keyset với `WHERE (created_at, id) < ($1, $2)`. Cursor column `created_at` có thể NULL — vấn đề gì xảy ra? Cách handle?
- Q4Bạn chạy `SELECT id, title FROM tasks LIMIT 10 OFFSET 10` hai lần liên tiếp mà không có ORDER BY. Kết quả có thể khác nhau dù không có insert/update giữa hai lần chạy — vì sao?
- Q5Frontend infinite scroll Twitter-style cho TaskFlow. Backend nên dùng pagination kiểu nào? Vì sao? Cần index gì?
Bài tiếp theo: DISTINCT vs GROUP BY — khi nào dùng cái nào
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên