Denormalization tradeoff — khi nào break 3NF có chủ đích
Read vs write amplification. 3 pattern: cached column, counter table, materialized view. Sync bằng trigger/app/CDC. Khi nào nên break 3NF — nguyên lý agnostic.
TL;DR: Denormalize = đánh đổi write cost (phải sync nhiều nơi) để lấy read speed (no JOIN, no aggregate) — giống cache ở tầng schema, và mọi rule của cache đều áp dụng. 3 pattern: cached column (copy FK label như project name), counter table (precomputed COUNT), materialized view (precomputed aggregate). Sync bằng trigger (atomic, ẩn), app-level (explicit, dễ miss), hoặc CDC (scale tốt, eventual consistency). Quy tắc: normalize trước, đo query chậm bằng query profiling, denormalize có evidence — premature denormalize là tech debt. Nguyên lý agnostic, đúng ở mọi RDBMS.
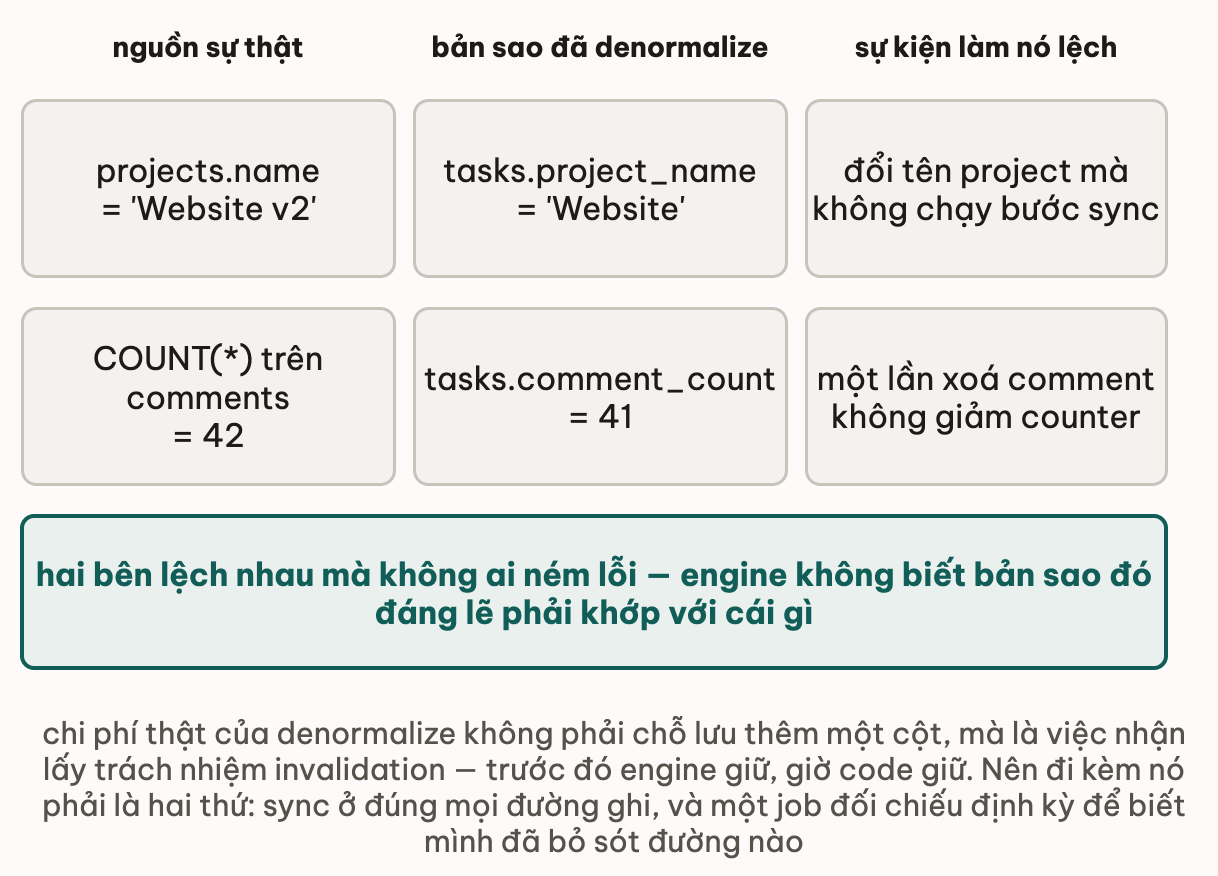
Dashboard TaskFlow cần hiển thị 200 task mỗi trang, mỗi task kèm tên project và số comment. Query chuẩn 3NF join 8 bảng, chạy 800ms. Người dùng rời trang sau 2 giây. Sau khi denormalize tasks.project_name (copy từ projects.name) và tasks.comment_count (precomputed), cùng query chạy 50ms — nhanh hơn 16 lần. Nhưng đêm hôm đó, một project đổi tên. Mọi task của project đó vẫn hiển thị tên cũ — cho đến khi sync chạy.
Đây là tradeoff cốt lõi của denormalization: đánh đổi write cost (phải sync nhiều nơi) để lấy read speed (không cần JOIN, không cần aggregate). Bài này map 3 pattern denormalize phổ biến, cơ chế sync, và decision matrix để biết khi nào nên — và khi nào không nên — break 3NF.
1. Analogy — Cache local vs nguồn chính
Denormalization giống cache: bạn lưu một bản sao dữ liệu gần hơn với người dùng, để đọc nhanh hơn. Nguồn chính (bảng gốc, normalized) vẫn tồn tại — bản sao chỉ để tăng tốc read. Nhưng mỗi khi nguồn chính thay đổi, bản sao phải được sync — đây là write overhead.
| Cache concept | DB denormalization |
|---|---|
| Cache server (Redis, Memcached) | Column denormalized (project_name trong tasks) |
| Nguồn chính (database gốc) | Bảng normalize gốc (projects.name) |
| Cache miss → fetch từ nguồn | JOIN → fetch từ bảng gốc |
| Cache invalidation khi nguồn thay đổi | Sync column/counter khi parent update |
| Stale cache = dữ liệu cũ được đọc | Stale column = label cũ hiển thị trên UI |
| TTL: chấp nhận lag nhất định | Refresh interval: materialized view lag |
| Cache stampede nếu không có lock | Counter drift nếu sync bỏ sót event |
Denormalize = cache ở tầng schema. Mọi rule của cache đều áp dụng: nhanh hơn khi đọc, đắt hơn khi write, và bạn phải chủ động handle invalidation — DB không làm thay bạn trừ khi bạn setup trigger.
Trước khi chọn pattern, cần thấy hình dạng của thứ sẽ hỏng. Denormalize không hỏng lúc thiết kế — nó hỏng lúc bản sao lệch khỏi nguồn:
2. Read vs write amplification — tradeoff cơ bản
| Pattern | Read cost | Write cost | Consistency risk |
|---|---|---|---|
| Pure normalize | Cao (multi-JOIN) | Thấp (1 source of truth) | Thấp |
| Cached column | Thấp (no JOIN) | Trung bình (sync khi parent thay đổi) | Trung bình (stale window) |
| Counter table | Thấp (single row) | Cao (mỗi event update counter) | Trung bình |
| Materialized view | Thấp (precomputed) | Schedule cost (refresh) | Cao (refresh lag) |
Decision criteria:
- Read-heavy (analytics dashboard, public-facing): denormalize
- Write-heavy OLTP: normalize
- Real-time consistency bắt buộc (financial, audit): normalize
- Eventual consistency chấp nhận được: denormalize tier
Nguyên tắc thực chiến: bắt đầu normalize hoàn toàn, đo đạc query chậm bằng công cụ phân tích plan/profiling của engine (mọi RDBMS đều có cách xem query plan), rồi mới denormalize có mục tiêu. Premature denormalization = tech debt không có measurement để justify.
3. Pattern 1 — Cached column (denormalized FK label)
Use case: dashboard cần hiển thị label của parent entity (project name, user display name) kèm mỗi row child — thay vì JOIN mỗi request.
-- Normalize: phai JOIN moi query
SELECT t.id, t.title, p.name AS project_name
FROM tasks t
INNER JOIN projects p ON t.project_id = p.id;

-- Denormalize: them cached column
ALTER TABLE tasks ADD COLUMN project_name VARCHAR(200);
UPDATE tasks
SET project_name = (SELECT name FROM projects WHERE id = tasks.project_id);

-- Read: khong JOIN
SELECT id, title, project_name FROM tasks;
Ba cơ chế sync khi projects.name thay đổi:
-- A. Trigger tren projects: automatic, atomic
-- Trigger la chuan SQL; ngon ngu viet body trigger la dialect.
-- Y tuong: AFTER UPDATE name ON projects -> chay lenh dong bo:
--   UPDATE tasks SET project_name = <ten moi> WHERE project_id = <id project>;
CREATE TRIGGER trg_sync_project_name
  AFTER UPDATE OF name ON projects
  FOR EACH ROW
  -- body trigger goi logic update tasks (cu phap cu the tuy engine)
  EXECUTE FUNCTION sync_project_name();
-- B. App-level: explicit, de debug, de miss
BEGIN;
  UPDATE projects SET name = $1 WHERE id = $2;
  UPDATE tasks SET project_name = $1 WHERE project_id = $2;
COMMIT;
-- Nho them: bat ky noi nao update projects.name deu phai sync
-- C. CDC (Change Data Capture)
-- Doc change log cua DB (transaction/commit log) -> push event -> consumer update tasks
-- Eventual consistency: co lag, khong atomic voi update goc
-- Scale tot nhat nhung infra phuc tap nhat
-- (CDC framework cu the la dialect/he sinh thai - khong gan engine)
Tradeoff mỗi cơ chế sync:
| Cơ chế | Ưu | Nhược |
|---|---|---|
| Trigger | Atomic với parent update, tự động | Overhead mỗi write, logic ẩn khó debug |
| App-level | Explicit, dễ test | Dev phải nhớ sync mọi nơi update parent |
| CDC | Scale tốt, không coupling | Eventual consistency, infra phức tạp |
4. Pattern 2 — Counter table (precomputed COUNT)
Use case: profile page hiển thị "user X có 42 task" — không cần COUNT(*) mỗi request.
ALTER TABLE users ADD COLUMN task_count INTEGER NOT NULL DEFAULT 0;

-- Backfill: tinh lai tu dau
UPDATE users u
SET task_count = (SELECT COUNT(*) FROM tasks WHERE assignee_id = u.id);
Trigger sync khi tasks thay đổi — logic (ngôn ngữ viết body trigger là dialect):
-- AFTER INSERT OR UPDATE OR DELETE ON tasks, FOR EACH ROW:
--   INSERT row moi  -> task_count + 1 cho assignee moi
--   DELETE row      -> task_count - 1 cho assignee cu
--   UPDATE doi assignee -> task_count - 1 cho assignee cu, + 1 cho assignee moi
CREATE TRIGGER trg_user_task_count
  AFTER INSERT OR UPDATE OR DELETE ON tasks
  FOR EACH ROW
  EXECUTE FUNCTION update_user_task_count();  -- body chua logic tren (cu phap tuy engine)
Counter drift là rủi ro thực tế: bug trong trigger, bulk import không qua trigger, hoặc direct SQL update bypass trigger — counter lệch so với thực tế. Cần periodic reconciliation:
-- Reconcile: recompute counter tu source of truth
UPDATE users u
SET task_count = (SELECT COUNT(*) FROM tasks WHERE assignee_id = u.id);
-- Chay via cron job (hang dem hoac hang tuan tuy muc do chap nhan drift)
Counter table không tự heal. Nếu một event bị bỏ sót (trigger disable tạm thời để bulk import, bulk DELETE trực tiếp không qua app), counter lệch dần — không có cơ chế auto-detect. Production pattern: chạy reconciliation script định kỳ + alert khi counter lệch vượt ngưỡng so với COUNT(*) thực tế.
Real-world reference: Wikipedia denormalize page view counter, Twitter denormalize follower count, Reddit denormalize karma score — tất cả đều dùng periodic reconciliation để correct drift.
Thử ngẫmusers.task_count đã có trigger sync nhưng team vừa chạy một bulk import task thẳng vào DB, bỏ qua ORM. Điều gì xảy ra với counter, và làm sao phát hiện sớm?
5. Pattern 3 — Materialized view (precomputed aggregate)
Cho complex aggregate cần nhiều bảng và tính toán phức tạp — analytics dashboard chấp nhận staleness.
-- "Moi project: tong task, so task done, completion %"
CREATE MATERIALIZED VIEW mv_project_stats AS
SELECT
  p.id          AS project_id,
  p.name,
  COUNT(*)      AS total,
  COUNT(*) FILTER (WHERE t.status = 'done')    AS done,
  ROUND(
    COUNT(*) FILTER (WHERE t.status = 'done') * 100.0
    / NULLIF(COUNT(*), 0),
    2
  )             AS completion_pct
FROM projects p
LEFT JOIN tasks t ON t.project_id = p.id
GROUP BY p.id, p.name;

-- Unique index tren khoa cua view: can cho refresh non-blocking o nhieu engine
CREATE UNIQUE INDEX ON mv_project_stats(project_id);

-- Read: instant, khong JOIN, khong aggregate per request
SELECT * FROM mv_project_stats WHERE project_id = $1;
Refresh schedule (cú pháp refresh và scheduler là dialect):
-- Refresh tinh lai du lieu view tu bang goc:
REFRESH MATERIALIZED VIEW mv_project_stats;

-- Nhieu engine ho tro che do refresh KHONG block read (can unique index):
-- vi du REFRESH MATERIALIZED VIEW CONCURRENTLY mv_project_stats; (dialect)

-- Chay dinh ky: dung scheduler cua engine hoac cron ngoai (vd moi 5 phut).
-- Lap lich trong DB la dialect (mot so engine co extension scheduler).
Tradeoff materialized view:
- Freshness: stale theo refresh interval (5 phút, 1 giờ, 1 ngày)
- Cost refresh: thường linear với data size; refresh incremental là tính năng dialect
- Storage: tăng theo size aggregate
- Non-blocking refresh: nhiều engine cần unique index, chạy lâu hơn nhưng không block read
Use case phù hợp: analytics dashboard chấp nhận 1 giờ lag, OLAP report. Không phù hợp: OLTP cần data real-time (dùng normalize + index thay thế).
Forward: bài 06 — Schema migration và Module 6 (storage & indexing) của khoá này bàn thêm về vận hành schema/index ở production.
6. Pitfall — denormalize không có sync
-- BUG: denormalize nhung quen setup sync
ALTER TABLE tasks ADD COLUMN project_name VARCHAR(200);

-- Backfill 1 lan duy nhat
UPDATE tasks
SET project_name = (SELECT name FROM projects WHERE id = tasks.project_id);

-- 6 thang sau: project "Alpha" doi ten thanh "Alpha v2"
UPDATE projects SET name = 'Alpha v2' WHERE id = 5;
-- tasks.project_name van la 'Alpha' voi moi task thuoc project 5
-- Dashboard show 'Alpha' trong 6 thang -> silent wrong data

-- Fix options:
-- 1. Them trigger sync ngay khi alter (truoc khi deploy)
-- 2. Chap nhan stale va document ro trong code + README
-- 3. Periodic reconciliation script + monitoring alert
Silent wrong data nguy hiểm hơn error rõ ràng. Nếu denormalize mà không setup sync, column sẽ drift dần mà không có error nào báo — chỉ phát hiện khi user report hoặc audit. Nguyên tắc: không bao giờ để denormalized column mà không có ít nhất một trong ba: trigger sync, reconciliation job định kỳ, hoặc comment code rõ ràng về intentional staleness và refresh policy.
Thử ngẫmtasks.project_name bị stale 6 tháng trước khi ai đó phát hiện. Ngoài thêm trigger, cách nào rẻ hơn để bắt ra sai lệch này sớm hơn?
7. Decision matrix — khi nào denormalize
                  Read frequency
                  Thấp         Cao
Write    Thấp  |  Normalize  | Cached column (label ít thay đổi)
freq     Cao   |  Normalize  | Counter table + Materialized view
Rules of thumb:
- Read nhiều hơn write khoảng 100 lần và query chậm có bằng chứng đo được? Cân nhắc denormalize.
- Real-time consistency bắt buộc (financial, security, audit)? Normalize, không exception.
- Parent label thay đổi hiếm (project name, category name)? Cached column với trigger OK.
- Event-driven counter (page view, comment count, task count)? Counter table với trigger + reconciliation.
- Aggregate phức tạp nhiều bảng, dashboard analytics chấp nhận lag? Materialized view.
- Chưa đo được query chậm? Normalize trước, đo sau, denormalize khi có evidence.
8. Applied — TaskFlow denormalization candidates
| Candidate | Pattern | Lý do |
|---|---|---|
tasks.project_name | Cached column | Dashboard mỗi task cần project name — JOIN tốn kém khi 10k task/trang |
users.task_count | Counter table | Profile page show "42 task" — COUNT toàn bảng tasks chậm |
users.last_activity_at | Cached column | Sort user by recency — không cần aggregate, cập nhật khi user action |
projects.completion_pct | Materialized view | Analytics dashboard, refresh hourly — phức tạp quá cho trigger |
tasks.comment_count | Counter table | Hiển thị "5 comment" mà không COUNT(*) per task per request |
Best practice áp dụng ngay: bắt đầu với schema fully normalized từ Bài 03 — Normalization. Khi dashboard TaskFlow chậm, xem query plan bằng công cụ của engine (Module 6 — Storage & indexing mổ index và cách đọc plan), tìm sequential scan + expensive join, rồi chọn đúng pattern denormalize cho bottleneck đó.
9. Deep Dive — Denormalization
- Designing Data-Intensive Applications (Kleppmann) Ch.3 + Ch.11 — Ch.3: storage engine và data model, denormalization qua read-optimized structure. Ch.11: stream processing và CDC — cơ chế sync denormalized data ở scale lớn.
- Martin Fowler — "Denormalization" — short canonical reference cho decision criteria: khi nào denormalize là intentional design, khi nào là anti-pattern.
Ghi chú: DDIA Ch.3 cho foundation lý thuyết (tại sao read-optimized structure tồn tại), Ch.11 cho production sync pattern qua event stream. Fowler cho decision framework nhanh khi đang code review và thấy denormalized column — liệu có intentional hay không.
10. Liên hệ các bài khác
- Bài 03 — Normalization 1NF→3NF: denormalize là cố ý break các dạng chuẩn đã học ở đây — đọc trước để biết mình đang đánh đổi gì.
- Bài 02 — Constraints: cached column/counter dễ drift; trigger và constraint là công cụ giữ chúng đồng bộ.
- Bài 06 — Schema migration: thêm denormalized column + backfill + bật sync trên bảng production cần expand-contract.
- Module 6 — Storage & indexing: nhiều bottleneck "giải bằng denormalize" thực ra chỉ cần index đúng — đọc trước khi denormalize.
11. Tóm tắt
- Denormalize = đánh đổi write cost (sync overhead) để lấy read speed (no JOIN, no aggregate).
- 3 pattern: cached column (FK label copy), counter table (precomputed COUNT), materialized view (precomputed aggregate).
- Sync mechanism: trigger (atomic, ẩn), app-level (explicit, dễ miss), CDC (scale tốt, eventual consistency).
- Counter table cần periodic reconciliation tránh drift sau bug hoặc bulk operation bypass trigger.
- Materialized view: nhiều engine có chế độ refresh không block read (cần unique index) — chế độ refresh và scheduler là dialect.
- Decision: normalize trước, denormalize có measurement — premature denormalize là tech debt không justify được.
- Nguyên lý agnostic, đúng ở mọi RDBMS. Forward: Bài 06 — Schema migration, Module 6 (index để loại bottleneck trước khi denormalize).
12. Tự kiểm tra
- Q1Vì sao denormalize tăng write cost? Cho ví dụ cụ thể với tasks.project_name cached column trong TaskFlow.
- Q2Phân biệt 3 sync mechanism (trigger, app-level, CDC). Khi nào nên chọn cái nào?
- Q3Counter table drift sau bug. Cách reconcile? Tradeoff giữa precomputed counter và recompute mỗi request?
- Q4Materialized view: chế độ refresh không block read thường cần unique index — vì sao? Hậu quả nếu không có?
- Q5"Premature denormalize" là anti-pattern. Khi nào "measured denormalize" worth?
Bài tiếp theo: Surrogate vs natural key — UUID vs serial vs UUIDv7
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên